托管 Prometheus
托管 Prometheus


文档指南

请输入


- 文档首页
 托管 Prometheus接入指南云服务接入容器服务接入容器集群接入
 复制全文
 下载 pdf
容器集群接入
 文档反馈
 问问助手
云原生观测服务能够提供免运维、高性能、高稳定的集群观测与告警服务。本文为您介绍如何开启集群中的云原生观测功能。
背景信息
云原生可观测功能基于托管 Prometheus 服务实现,使用 prometheus-agent 组件实现集群中的基础资源观测。因此,开启云原生可观测功能时,首先需要创建托管 Prometheus 工作区,并在集群中安装 prometheus-agent 组件。
采集器
云原生可观测使用 prometheus-agent 组件作为集群基础资源观测使用的采集器,当您在集群中安装 prometheus-agent 组件时,会同时安装 vm-agent、vmoperator、kube-state-metrics 和 node-exporter 组件。每个组件的名称、类型和作用如下表所示。
推荐规格
prometheus-agent 组件允许您自定义其资源和分片数,组件的分片数和规格与集群规模相关,您可以基于集群规模,配置组件的初始(最小)分片数。
vm-agent 采集器和 kube-state-metrics 组件在不同规模集群中的推荐初始(最小)分片数如下表所示。
集群规模 | vm-agent 初始(最小)分片数 | kube-state-metrics 初始(最小)分片数 |
10 Node,500 Pod | 1 | 1 |
100 Node,5000 Pod | 2 | 2 |
200 Node,10000 Pod | 4 | 4 |
500 Node,25000 Pod | 10 | 10 |
前提条件
- 已创建集群,详情请参见 创建集群。
- 已创建托管 Prometheus 工作区,详情请参见 创建工作区。
操作步骤
步骤一:集群绑定工作区
- 登录 容器服务控制台。
- 在顶部导航栏,选择您业务所在地域。
- 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
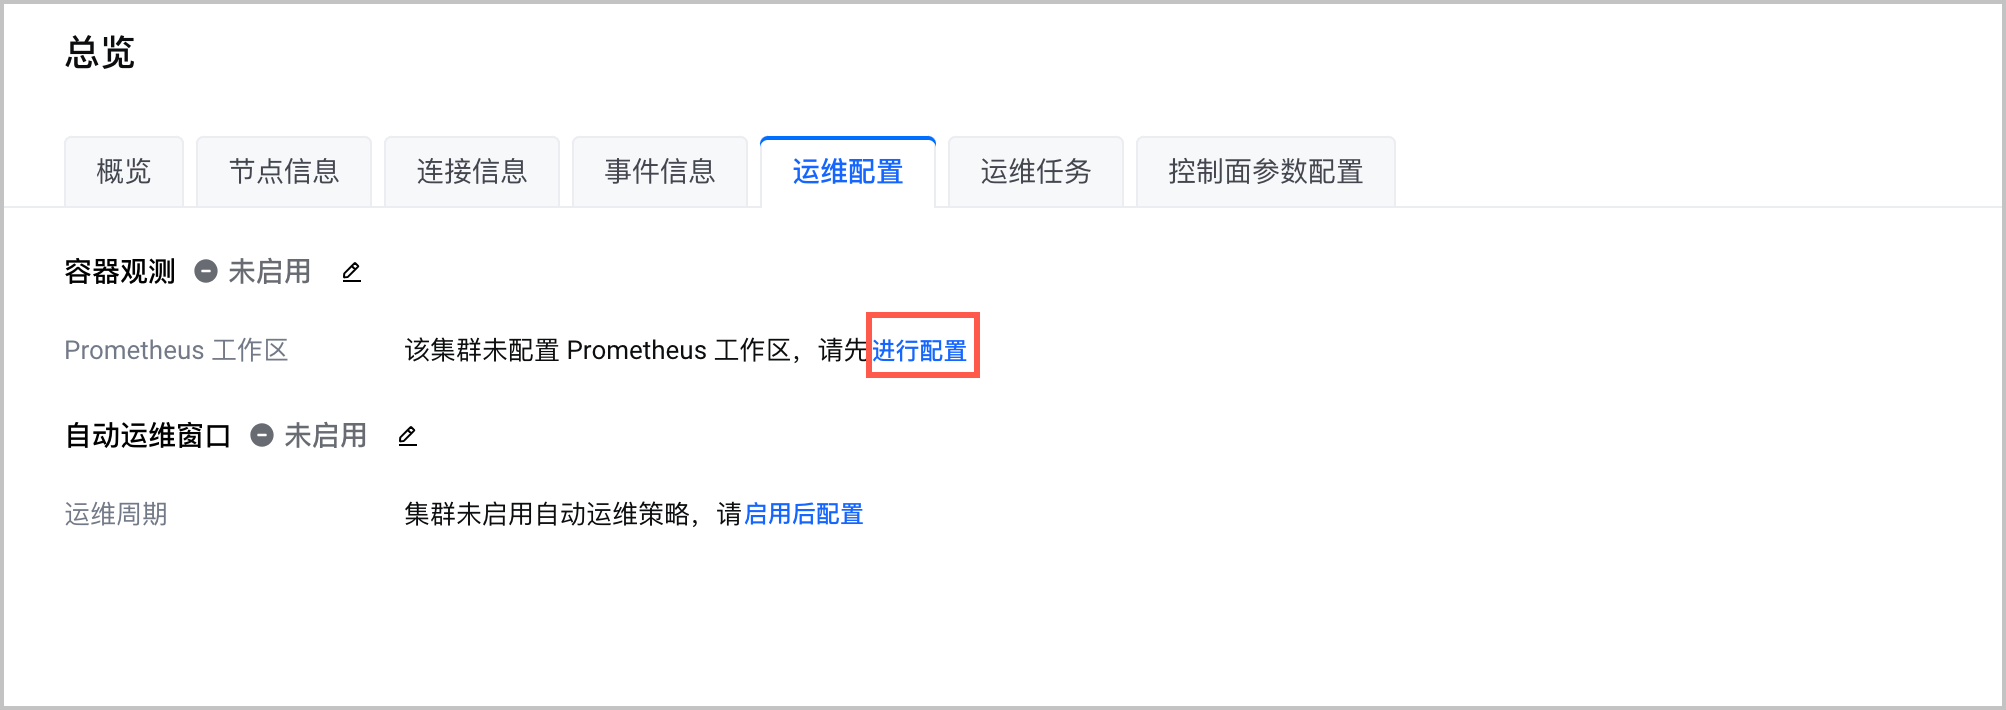
- 在左侧导航栏单击 总览,并选择 运维配置 页签。在配置页面中单击 进行配置 链接。
-
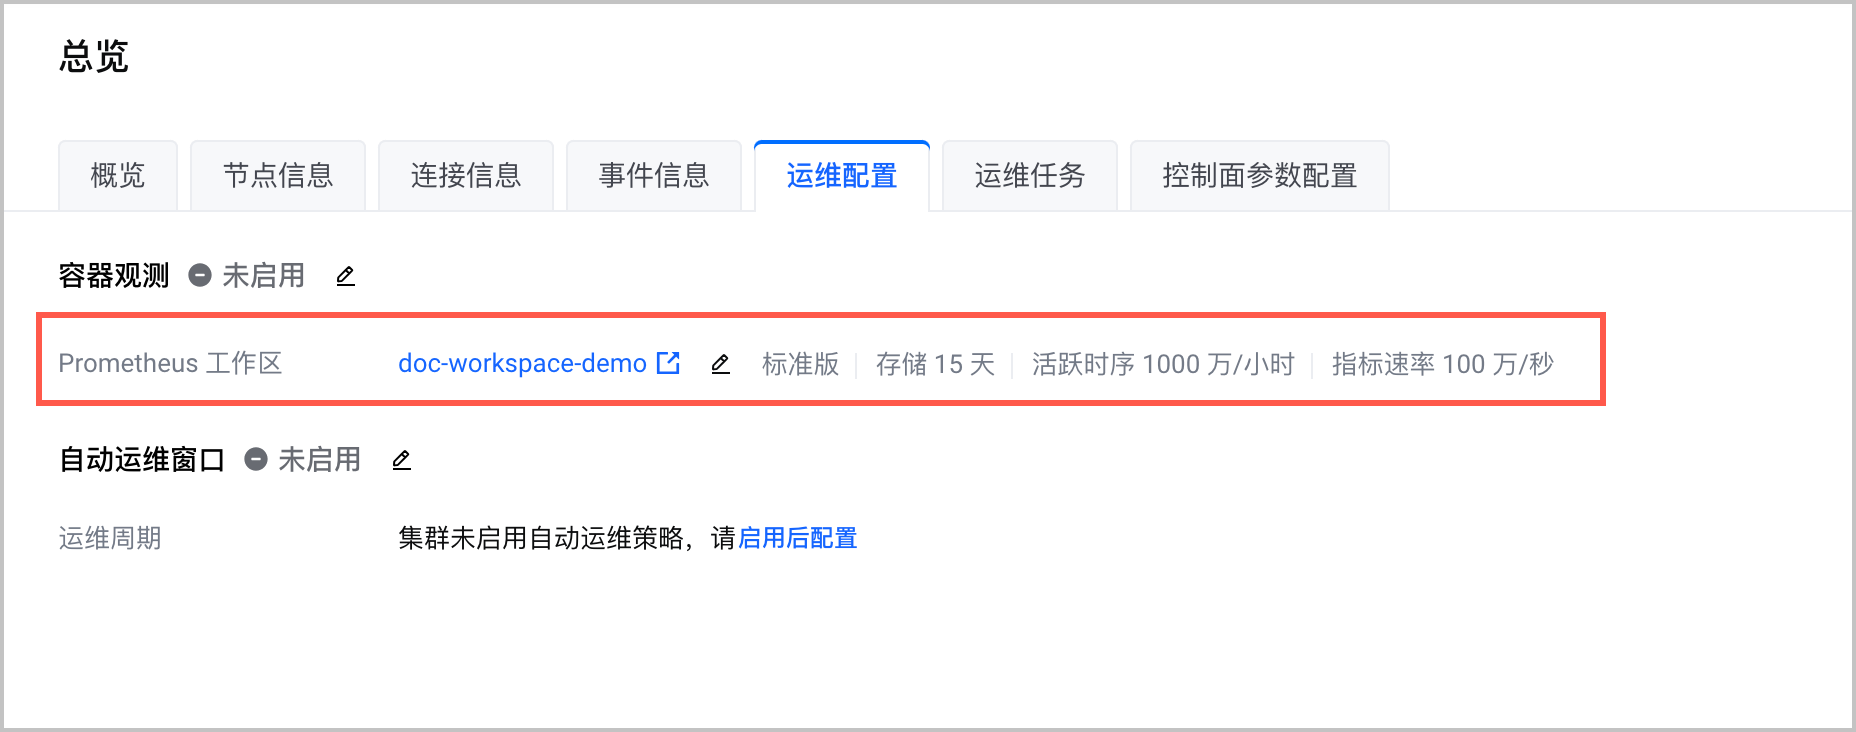
- 在弹出的配置框内,选择与集群绑定的托管 Prometheus 工作区。
-
说明
步骤二:部署采集器
- 在左侧导航栏中,选择 组件管理。
- 选择 监控 页签,找到 prometheus-agent 组件,选择该组件右上角的 ... > 安装。
-

- 配置组件参数。
- 配置组件资源需求。
-

- 参数描述部署方式组件的部署方式。当前该参数已固定,不可配置。部署形态容器网络模型为 VPC-CNI 的集群显示该参数。部署组件的节点类型,有如下两种方式:
- 云服务器部署:表示在集群中的云服务器节点(Node)上部署该组件。
- 弹性容器部署:表示在集群中的弹性容器实例(VCI),即虚拟节点(VirtualNode)上部署该组件。在弹性容器实例上部署组件,会产生费用,详细的费用说明,请参见 弹性容器实例产品计费。
vm-agent 资源配置 vm-agent 采集器的默认资源配置,包括:CPU 请求、CPU 上限、内存请求、内存上限。kube-state-metrics 资源配置配置 kube-state-metrics 组件的默认资源配置,包括:CPU 请求、CPU 上限、内存请求、内存上限。说明由于 kube-state-metrics 组件本身存在的限制(例如:每个组件实例允许采集的 Target 数量有限),在大规模集群中,建议优先使用增加分片数的方式,提升 kube-state-metrics 组件的指标采集能力。
- 配置组件的初始分片数和扩缩容。
-

- 参数描述vm-agent 初始分片数配置 vm-agent 采集器的初始分片数。kube-state-metrics 初始分片数配置 kube-state-metrics 组件的初始分片数。组件扩缩容配置是否开启 vm-agent 采集器和 kube-state-metrics 组件的自动扩缩容功能。
- 不开启:组件的分片数为配置的初始分片数。不会随着资源占用率的提升而自动扩容。
- 开启:需要配置组件的最大分片数。组件会基于资源占用率自动扩缩容,具体逻辑如下:
- vm-agent 扩容:任一资源(CPU 或内存)使用率 > 70% 时,自动扩容。
- vm-agent 缩容:全部资源(CPU 和内存)使用率均 < 30% 时,自动缩容。
- kube-state-metrics 扩容:任一资源(CPU 或内存)使用率 > 70% 时,自动扩容。
- kube-state-metrics 缩容:全部资源(CPU 和内存)使用率均 < 70% 时,自动缩容。
注意- vm-agent 扩缩容冷却时间为 30 分钟。kube-state-metrics 基于 HPA 进行扩缩容量。
- 配置组件自动扩缩容功能后,请保证集群资源充足,否则可能由于资源不足,导致组件扩容失败。
- vm-agent 采集器和 kube-state-metrics 组件扩容时,为保证均衡负载,建议配置 kube-state-metrics 组件的分片数为 vm-agent 采集器分片数的整数倍,例如:kube-state-metrics 组件分片数:vm-agent 采集器分片数 为 1:1 或 2:1 等。
部署插件配置是否同步安装 node-exporter 插件,默认安装插件。该插件用于采集节点操作系统的各项软硬件指标;如果不安装,则无法监控节点指标。建议您保持默认值。说明
注意
- 当 Prometheus-agent 组件为 v2.0.1 及以前 版本时,您还需要配置组件的托管 Prometheus 工作区,并配置工作区的认证用户名和密码。
- 当您配置组件的工作区时,需要保证配置的工作区与集群绑定的工作区一致。否则将无法在 Prometheus 监控 页面中,查看集群监控的指标和大盘。
- 高级配置(需要升级 Prometheus-agent 版本至 v2.10.0 及以上)
-

- 参数描述Discovery Role配置使用 Endpoints 或 EndpointSlices 服务发现方式。由于默认单个 Endpoints 只能支持最大 1K 的后端个数, 在 Kubernetes 1.21 版本之后,引入了 EndpointSlices 资源规避了该问题,所以在 Prometheus 中也同步支持了 EndpointSlices 的 服务发现方式。默认为 EndpointSlices,如果 Kubernetes 版本小于 v1.21,会自动使用 Endpoints 方式。全局 Labels采集 Prometheus-agent 默认给所有的采集指标添加的固定 Labels。注意
- 只对由 Prometheus-agent 采集的指标生效,容器服控制面组件(例如:kube-apiserver 等)指标是由组件自行上报,不会被修改。
- 如果新增或者修改全局 Labels,会导致活跃时序数增多(1小时内),如果指标规模较大,需要评估是否会达到活跃时序的限制。详情请参考 工作区规格。
警告- 默认自动添加的额外 Label 为cluster:<集群 ID>。该 Label 为系统保留字段,一般不建议覆盖。
- 如果希望添加集群名称等,建议填写类似cluster_name的 Label。
- 如果填写 cluster Label,会覆盖系统保留字段,造成的影响有:
- 容器服务的监控看板里,可能存在部分面板无法展示指标。
- 基于某些告警模版创建的告警规则会失效(由于其中cluster=~"$Cluster"的 Label 变动)。
Secret 权限kube-state-metrics 需要在 ClusterRole 里包含 Secret 权限才能生成相关指标。
- 单击 确定,完成配置。
步骤三:开启云原生观测
- 在集群管理页面的左侧导航栏中,选择 云原生观测 > 概览,进入服务开通页面。
- 单击 开启基础观测,开启云原生观测服务。
-
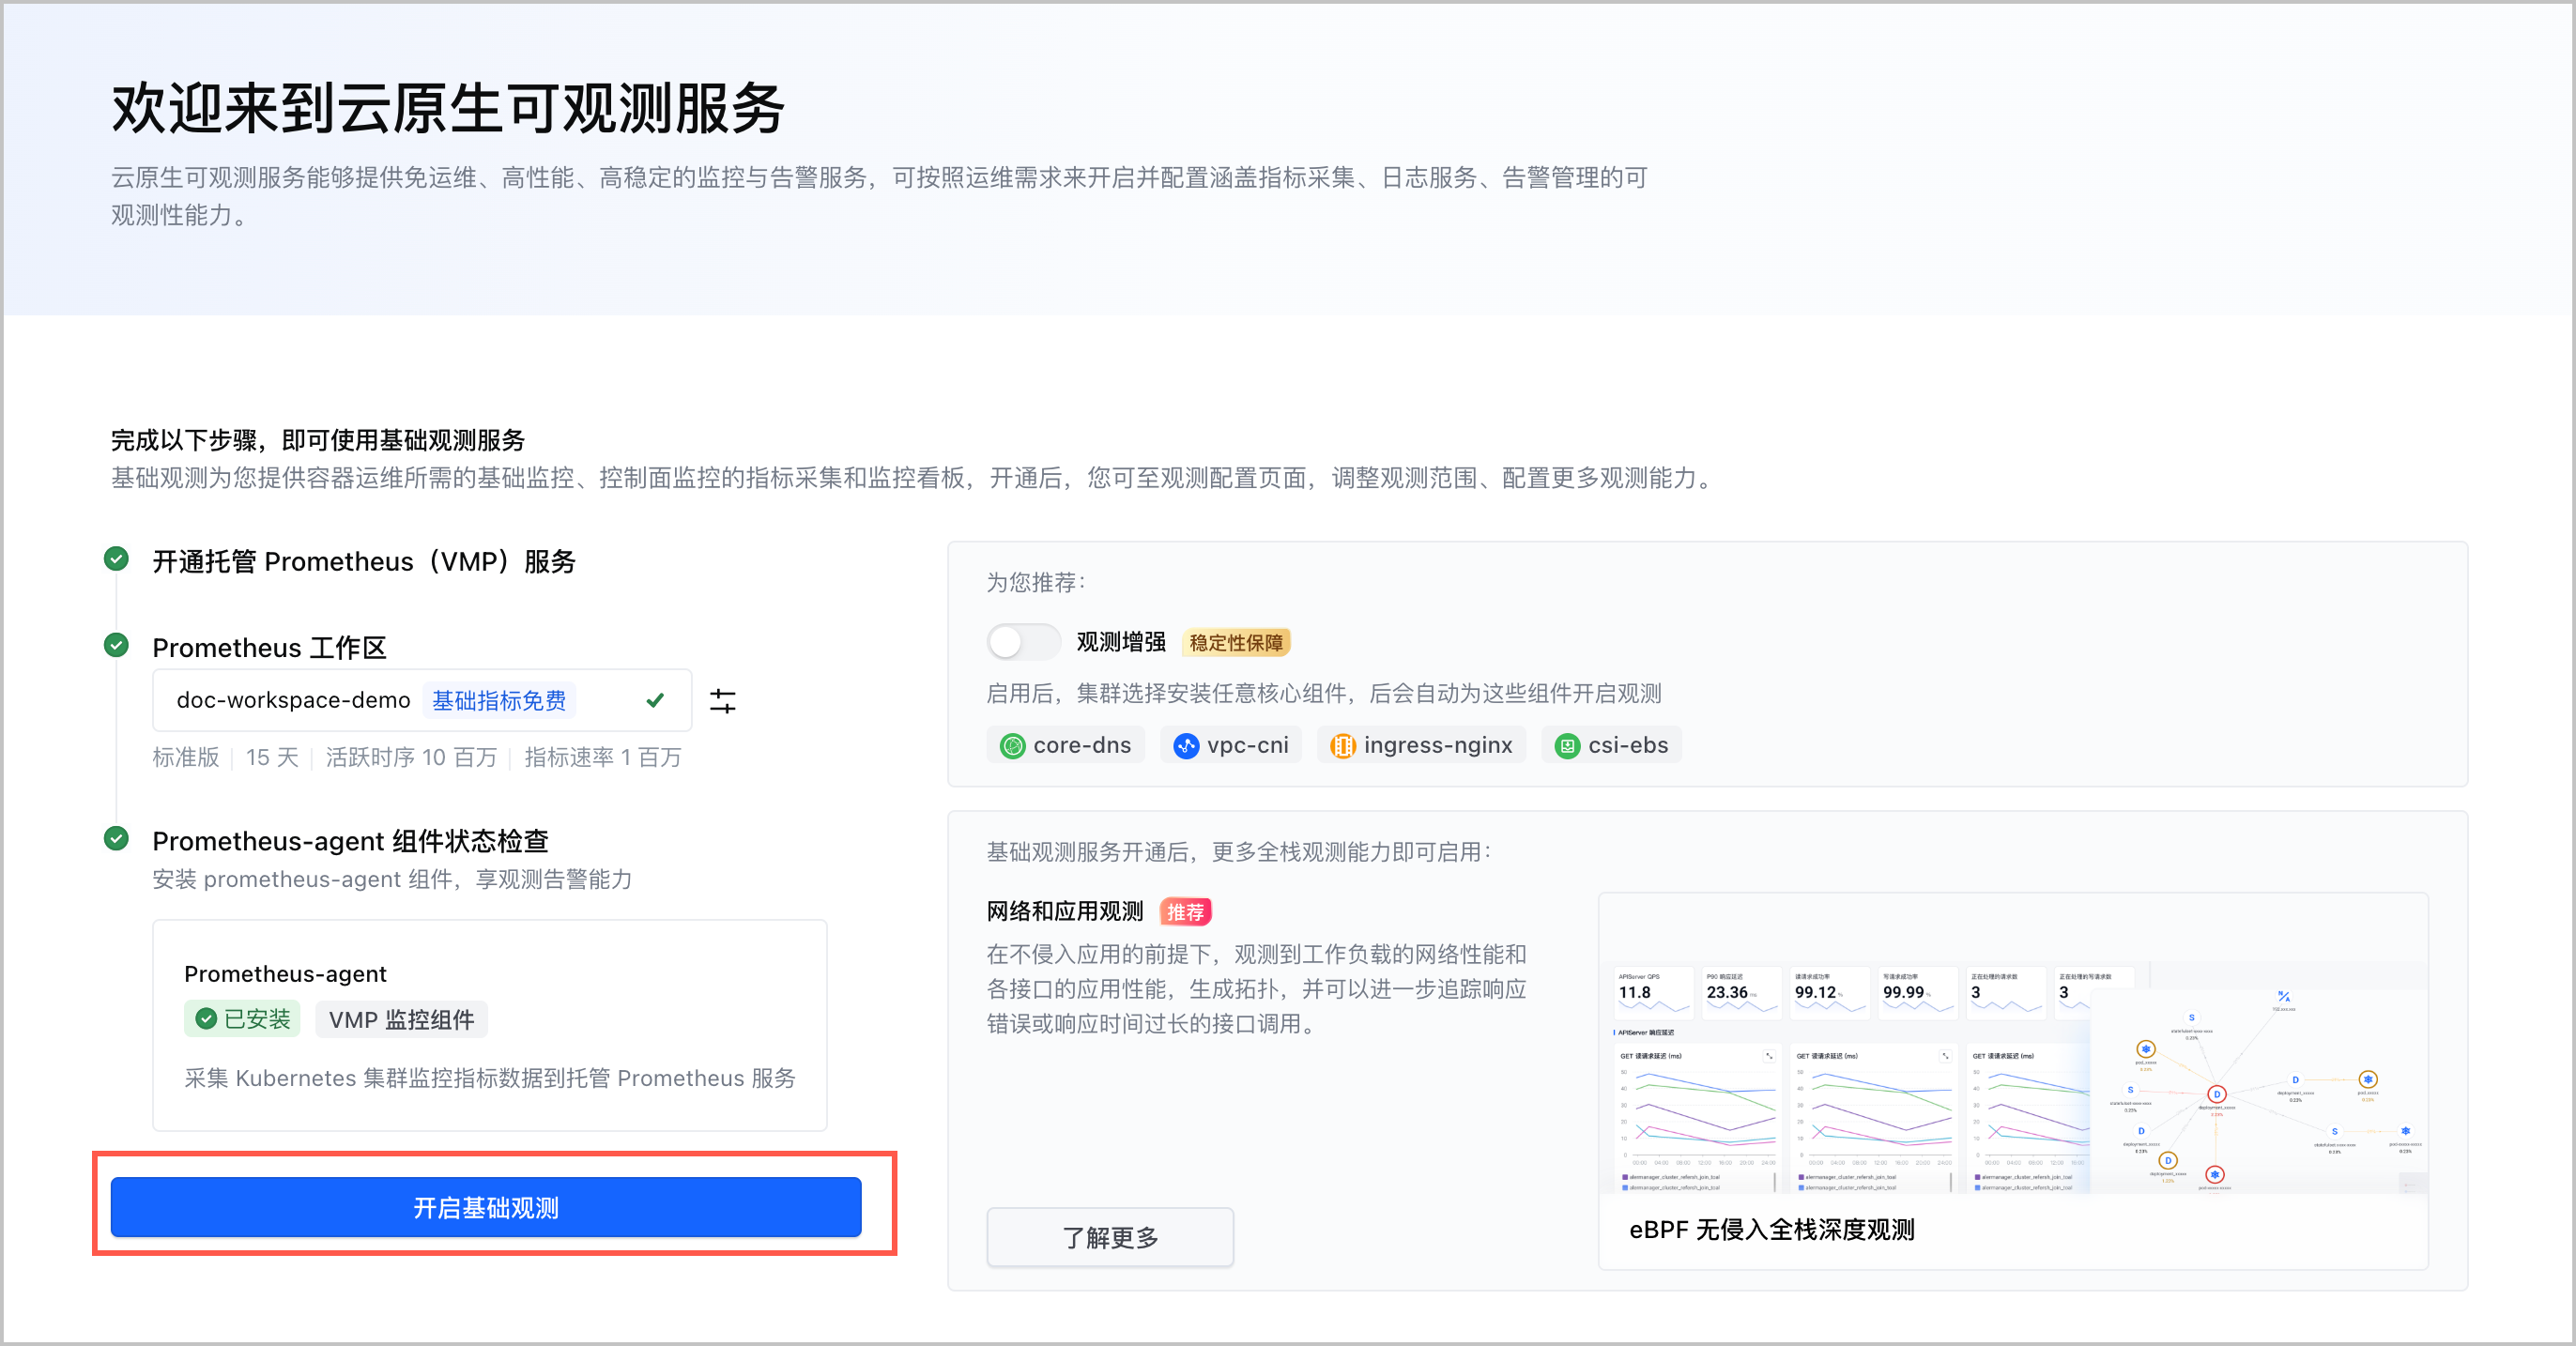
- (可选)观测增强。允许一键开启集群中主要组件的观测,包括:core-dns、vpc-cni、ingress-nginx 等。也支持按需单独开启单个组件的观测,详情请参见 基础观测。
- (可选)网络和应用观测。支持在不侵入应用的前提下,观测工作负载的网络性能和各接口的应用性能,生成拓扑。并且可以进一步追踪响应错误或响应时间过长的接口调用。详情请参见 网络和应用观测。
结果验证
查看观测配置
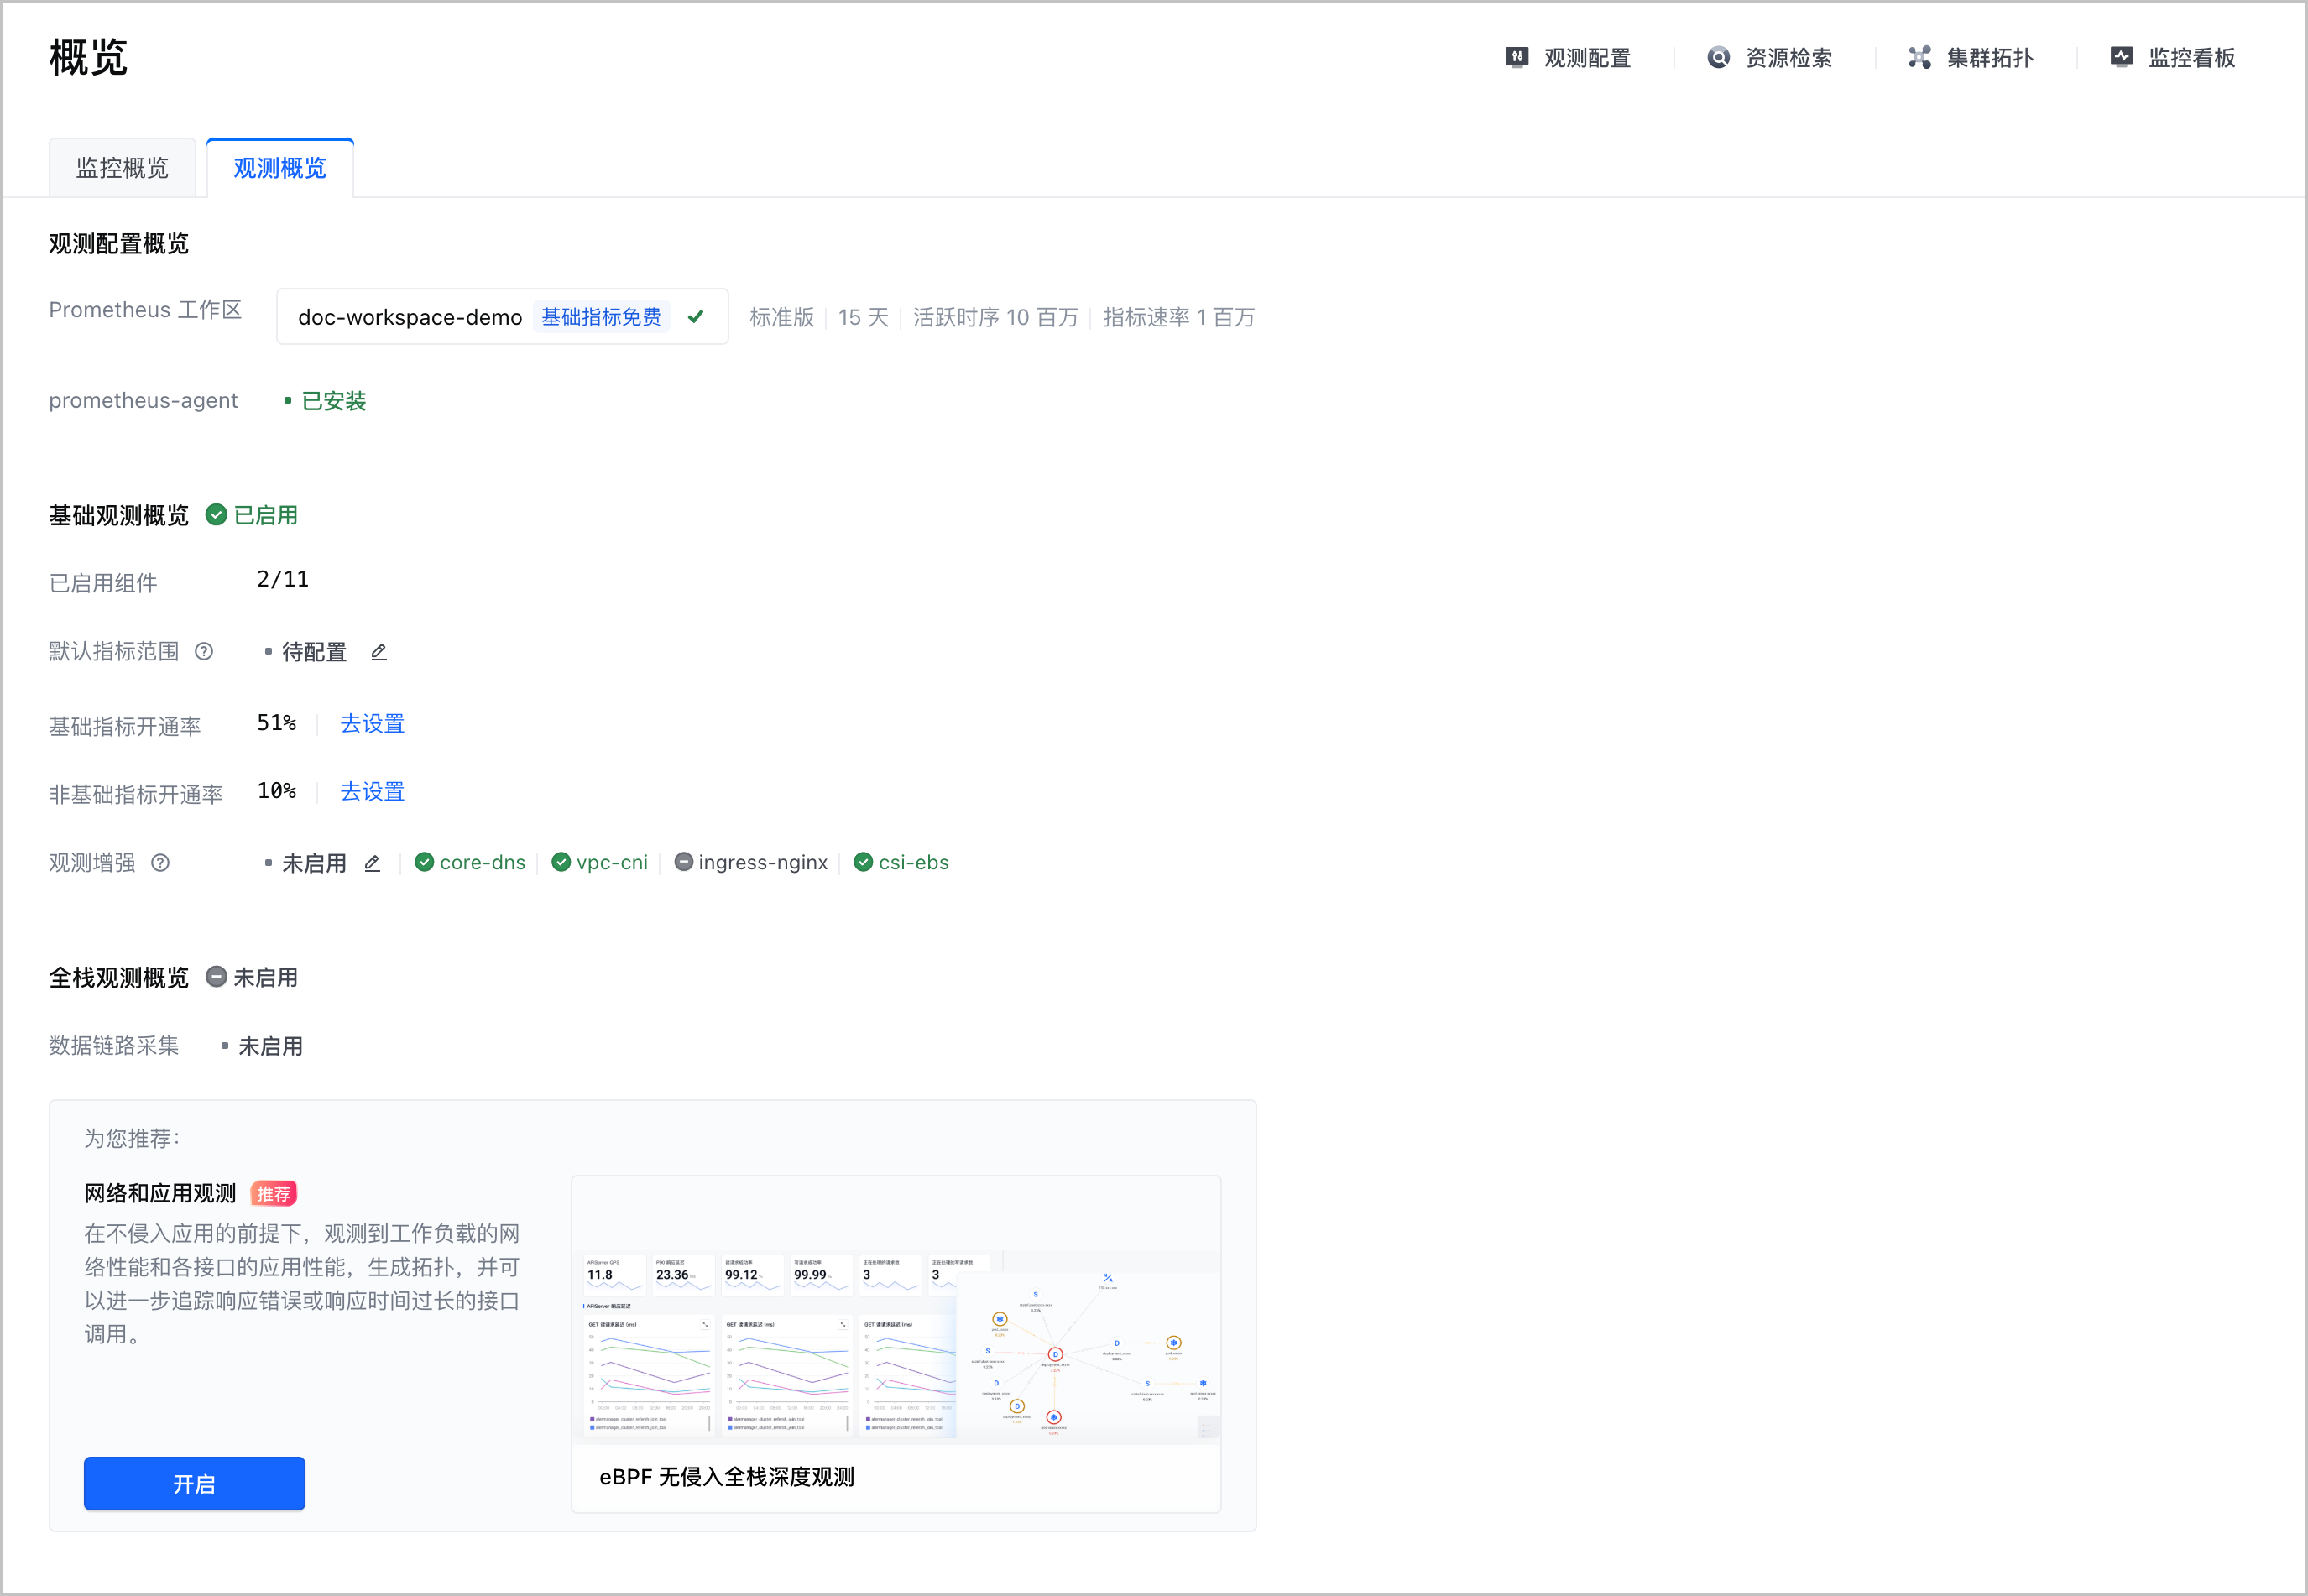
开启云原生观测功能后,选择 观测概览 页签,支持查看集群观测概览信息,包括:
- 观测配置概览:展示了集群绑定的托管 Prometheus 工作区和采集组件状态。
- 基础观测概览:展示了集群中已开启基础观测的组件比例和指标范围。具体说明,如下表所示。
配置项 | 说明 |
默认指标范围 | 配置集群中的观测指标范围,包括:
说明
|
基础指标开通率 | |
非基础指标开通率 | |
观测增强 | 观测增强功能状态。支持单击  ,一键开启或关闭集群中主要组件的观测,包括:core-dns、vpc-cni、ingress-nginx 等。也支持按需单独开启单个组件的观测,详情请参见 基础观测。 说明 控制台中绿色标记的组件,比如  ,表示该组件在集群中已安装。 |
- 全栈观测概览:展示全栈观测功能状态,支持单击 开启,配置全栈观测功能。详情请参见 开启全栈观测。
查看集群概况
开启云原生观测功能后,支持查看集群概况信息,包括:节点运行情况和工作负载应用性能概况。
节点运行情况
节点运行情况提供了集群中所有节点的状态信息和资源使用信息。
- 节点状态信息:展示当前集群节点统计信息,包括:Ready 状态、非 Ready 状态、磁盘可用量低、内存可用量低、进程过多、网络不可用等状态的节点总数。
- 资源使用信息:展示了当前集群所有节点中,CPU 使用率、内存使用率、网络流入流量、网络流出流量、磁盘使用率、磁盘 IO 饱和度、文件描述符饱和度、inodes 饱和度等指标的 Top5 列表。
- 在集群管理页面的左侧导航栏中,选择 云原生观测 > 概览 页面,选择 监控概览 页签。
- 在 节点运行情况 中,查看集群节点的监控信息。
-

工作负载应用性能概况
工作负载应用性能概况提供了集群中所有工作负载的性能信息,包括:错误率、响应时间(P90)等。
- 在集群管理页面的左侧导航栏中,云原生观测 > 概览 页面,选择 监控概览 页签。
- 在 工作负载应用性能情况 中,查看集群工作负载的性能监控信息。
最近更新时间:2025.09.03 15:13:01
这个页面对您有帮助吗?
有用
有用
无用
无用