持续交付
持续交付


文档指南

请输入


- 文档首页
 持续交付用户指南AI 应用LLaMA一键部署 LLaMA Factory 大语言模型微调服务
 复制全文
 下载 pdf
一键部署 LLaMA Factory 大语言模型微调服务
 文档反馈
 问问助手
AI 应用是针对大模型在线推理场景推出的一站式开发部署运维平台。本文为您介绍如何通过模板快速部署一个 LLaMA Factory 服务,用于大语言模型微调。
应用介绍
LLaMA Factory 是一个开源的 LLMs 微调的框架,支持通过 Web UI 界面微调大模型。它提供了一套完整的工具和接口,旨在简化大型语言模型的微调过程,使得用户能够轻松地对预训练的模型进行定制化的训练和调整,以适应特定的应用场景。
- 支持多种模型,包括 LLaMA、BLOOM、Mistral、Baichuan、Qwen 和 ChatGLM 等,这些模型涵盖了自然语言处理领域的多个应用场景。
- 支持多种微调技术,包括增量预训练、指令监督微调、奖励模型训练、PPO 训练、DPO 训练和 ORPO 训练等。
- 支持多种精度调整,如 32 比特全参数微调、16 比特冻结微调、16 比特 LoRA 微调和基于 AQLM/AWQ/GPTQ/LLM.int8 的 2/4/8 比特 QLoRA 微调。
- 集成了多种先进算法,如 GaLore、DoRA、LongLoRA、LLaMA Pro、LoRA+、LoftQ 和 Agent 微调等。
使用说明
前提条件
- 容器服务 VKE
- 已创建 VKE 集群,具体操作可参见 创建集群。
- (可选)如需挂载对象存储 TOS,请提前安装 csi-tos 组件。具体操作请参见 安装组件。
- (可选)如需以弹性容器实例方式部署,仅适用于网络模型为 VPC-CNI 的 VKE 集群,且集群中需提前安装 vci-virtual-kubelet 组件。具体操作请参见 安装组件。
- (可选)如需使用 GPU 资源,请提前安装 nvidia-device-plugin 组件。具体操作请参见 安装组件。
- 持续交付 CP
- 已接入部署资源。部署资源必须为容器服务 VKE 集群。具体操作请参见 接入部署资源。
- (可选)如需挂载模型文件,请完成以下准备工作,任选一种存储即可。
- 对象存储 TOS
- 已将模型上传至 TOS Bucket 存储。具体操作请参见 对象存储快速入门。
- 已获取当前账号的访问密钥 AK & SK。建议使用最小化授权的 IAM 用户的访问密钥,要求已授权对应文件的访问权限。
- 文件存储 NAS
- 已将模型上传至 NAS 存储,要求 NAS 与待部署的 VKE 集群处于相同的 VPC。具体操作请参见 文件存储快速入门。
- 制品仓库
- 已将模型上传至制品仓库存储。具体操作请参见 上传和下载 AI 格式制品快速入门。
- 已获取当前账号的访问密钥 AK & SK。建议使用最小化授权的 IAM 用户的访问密钥,要求该 IAM 用户已授权仓库挂载权限。
- (可选)如需配置外部访问方式,请完成以下准备工作,任选一种方式即可。
- API 网关:已创建网关实例,要求网关实例与待部署的 VKE 集群处于相同的 VPC。具体操作请参见 创建实例。
- 负载均衡 CLB:已创建负载均衡实例,要求负载均衡实例与待部署的 VKE 集群处于相同的 VPC。具体操作请参见 创建负载均衡实例。
操作步骤
- 登录 持续交付控制台。
- 在左侧导航栏选择 AI 应用。
- 在 AI 应用页面,单击 创建应用。
- 选择 基于框架创建 > LLaMA Factory 大语言模型微调,单击 部署。
-
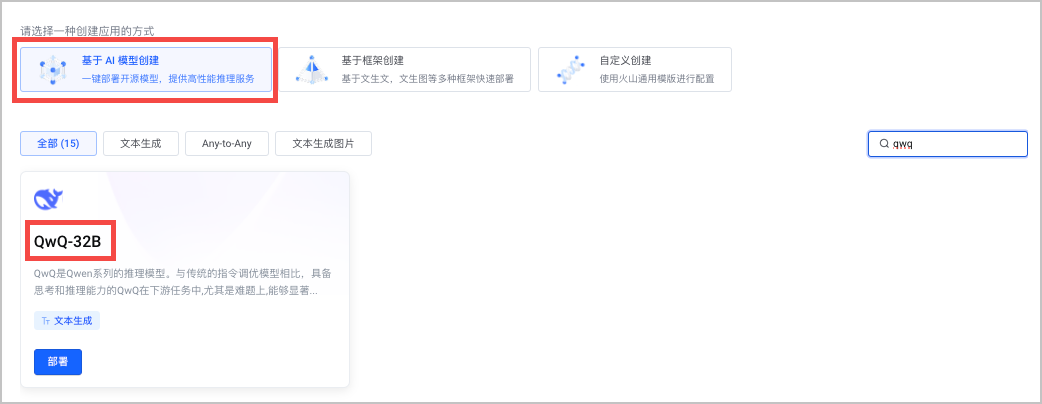
- 按要求填写应用的相关配置信息。配置完成后单击 确定,应用将开始创建并部署。
- 基本信息
- 配置项说明应用标识根据界面提示填写应用标识。应用标识是应用的唯一标识,创建后不可更改。应用显示名自定义应用的显示名称。描述填写当前应用的备注信息,可以为空。
- 部署集群
- 配置项说明部署资源选择前提条件中接入的 VKE 部署集群。注意如需以弹性容器实例方式部署,仅适用于网络模型为 VPC-CNI 的 VKE 集群,且集群中需提前安装 vci-virtual-kubelet 组件。命名空间选择或输入要部署的命名空间。输入的命名空间不存在时会自动创建。环境标识自定义当前环境的唯一标识。环境标识创建成功后不支持修改。
- 模型配置
- 配置项说明镜像选择本模板使用预置镜像 Llama factory。模型支持 官方模型 和 自持模型,请按需选择。
- 官方模型:内置 LLaMA Factory 常用官方模型,帮助您快速拉起服务。
- 自持模型:支持通过以下方式配置您自己的模型文件,请按需选择。
- TOS 挂载:通过火山引擎对象存储 TOS 挂载模型文件。
- 选择模型文件所在的 地域,Bucket,并填写具体 路径。
- AK & SK:输入当前账号的访问密钥 AccessKey ID(AK)和 Secret Access Key(SK)。建议使用最小化授权的 IAM 用户的访问密钥,要求已授权对应文件的访问权限。
- 制品库挂载:通过火山引擎制品仓库挂载模型文件。
- 制品库:选择模型文件所在的 地域、实例、仓库、命名空间、模型名称、版本。仅支持选择 AI 制品仓库。
- AK & SK:输入当前账号的访问密钥 AccessKey ID(AK)和 Secret Access Key(SK)。建议使用最小化授权的 IAM 用户的访问密钥,要求该 IAM 用户已授权仓库挂载权限。
- NAS 挂载:通过火山引擎文件存储 NAS 挂载模型文件。
- 文件系统类型:选择文件系统类型,支持 极速型 和 容量型。要求 NAS 与待部署的 VKE 集群处于相同的 VPC。
- 挂载点:选择要挂载的 文件系统 和 挂载点。
- 子目录:输入待挂载的文件系统的子目录信息,默认为根目录/。
- 挂载路径:挂载到 LLaMA Factory 中的目标路径。请根据实际业务配置模型的挂载路径。
数据集可选配置。将微调应用需要用到的数据集挂载到服务中。支持以下挂载方式,请按需选择。一个服务可添加多个数据集。- TOS 挂载:通过火山引擎对象存储 TOS 挂载数据集。
- 选择数据集所在的 地域,Bucket,并填写具体 路径。
- AK & SK:输入当前账号的访问密钥 AccessKey ID(AK)和 Secret Access Key(SK)。建议使用最小化授权的 IAM 用户的访问密钥,要求已授权对应文件的访问权限。
- NAS 挂载:通过火山引擎文件存储 NAS 挂载数据集。
- 文件系统类型:选择文件系统类型,支持 极速型 和 容量型。要求 NAS 与待部署的 VKE 集群处于相同的 VPC。
- 挂载点:选择要挂载的 文件系统 和 挂载点。
- 子目录:输入待挂载的文件系统的子目录信息,默认为根目录/。
- 挂载路径:挂载到 LLaMA Factory 中的目标路径。请根据实际业务需求配置数据集的挂载路径。
模型输出位置如果您希望对输出的模型进行持久化存储,需要对模型输出目录进行挂载。支持以下挂载方式,请按需选择。- TOS 挂载:通过火山引擎对象存储 TOS 挂载模型输出目录。
- 选择模型输出目录所在的 地域,Bucket,并填写具体 路径。
- AK & SK:输入当前账号的访问密钥 AccessKey ID(AK)和 Secret Access Key(SK)。建议使用最小化授权的 IAM 用户的访问密钥。
- NAS 挂载:通过火山引擎文件存储 NAS 挂载模型输出目录。
- 文件系统类型:选择文件系统类型,支持 极速型 和 容量型。要求 NAS 与待部署的 VKE 集群处于相同的 VPC。
- 挂载点:选择要挂载的 文件系统 和 挂载点。
- 子目录:输入待挂载的文件系统的子目录信息,默认为根目录/。
- 挂载路径:挂载到 LLaMA Factory 中的目标路径。请根据实际业务需求配置模型输出的挂载路径。
HF Token可选配置。如需下载 Hugging Face 模型,需在此处配置 HF Token。启动命令设置应用的启动命令和监听的容器端口。默认为llamafactory-cli webui,支持根据业务需求修改启动命令。
- 服务规格
- 勾选 以弹性容器实例方式部署
-
- 不勾选 以弹性容器实例方式部署
-
- 访问配置(可选)
- 配置 AI 应用的访问方式。详细内容可参见 访问设置。
结果验证
- 验证应用是否部署成功
- 在应用的 基本信息 > 资源配置 页签,查看应用的部署进度。支持通过实例的 运行状态、实时日志 和 事件,查看应用详细的启动和运行信息。
-
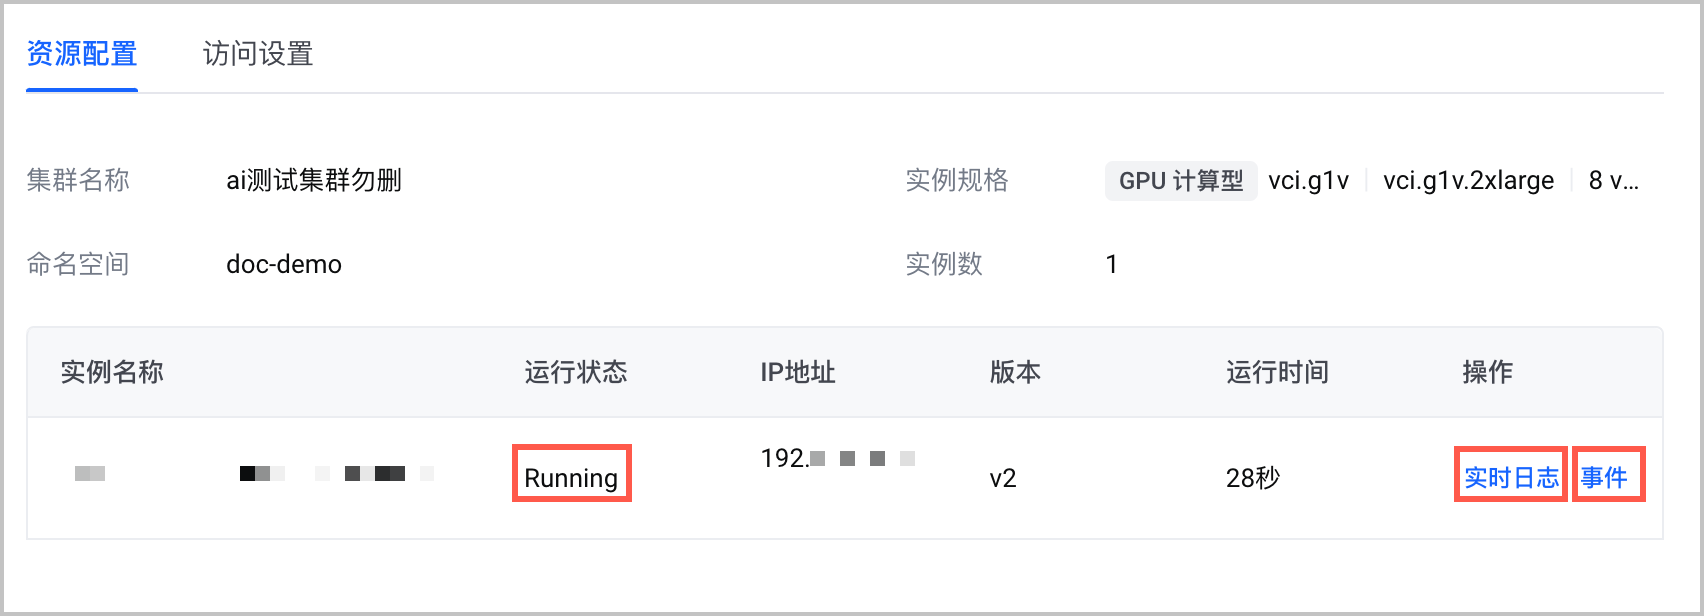
- 查看实时日志:单击 实时日志,可查看应用的运行信息,方便运维和排障。
- 查看事件:单击 事件,可查看应用的启动信息。最多可查看最近 1 小时内发生的事件信息。
- 访问 LLaMA Factory
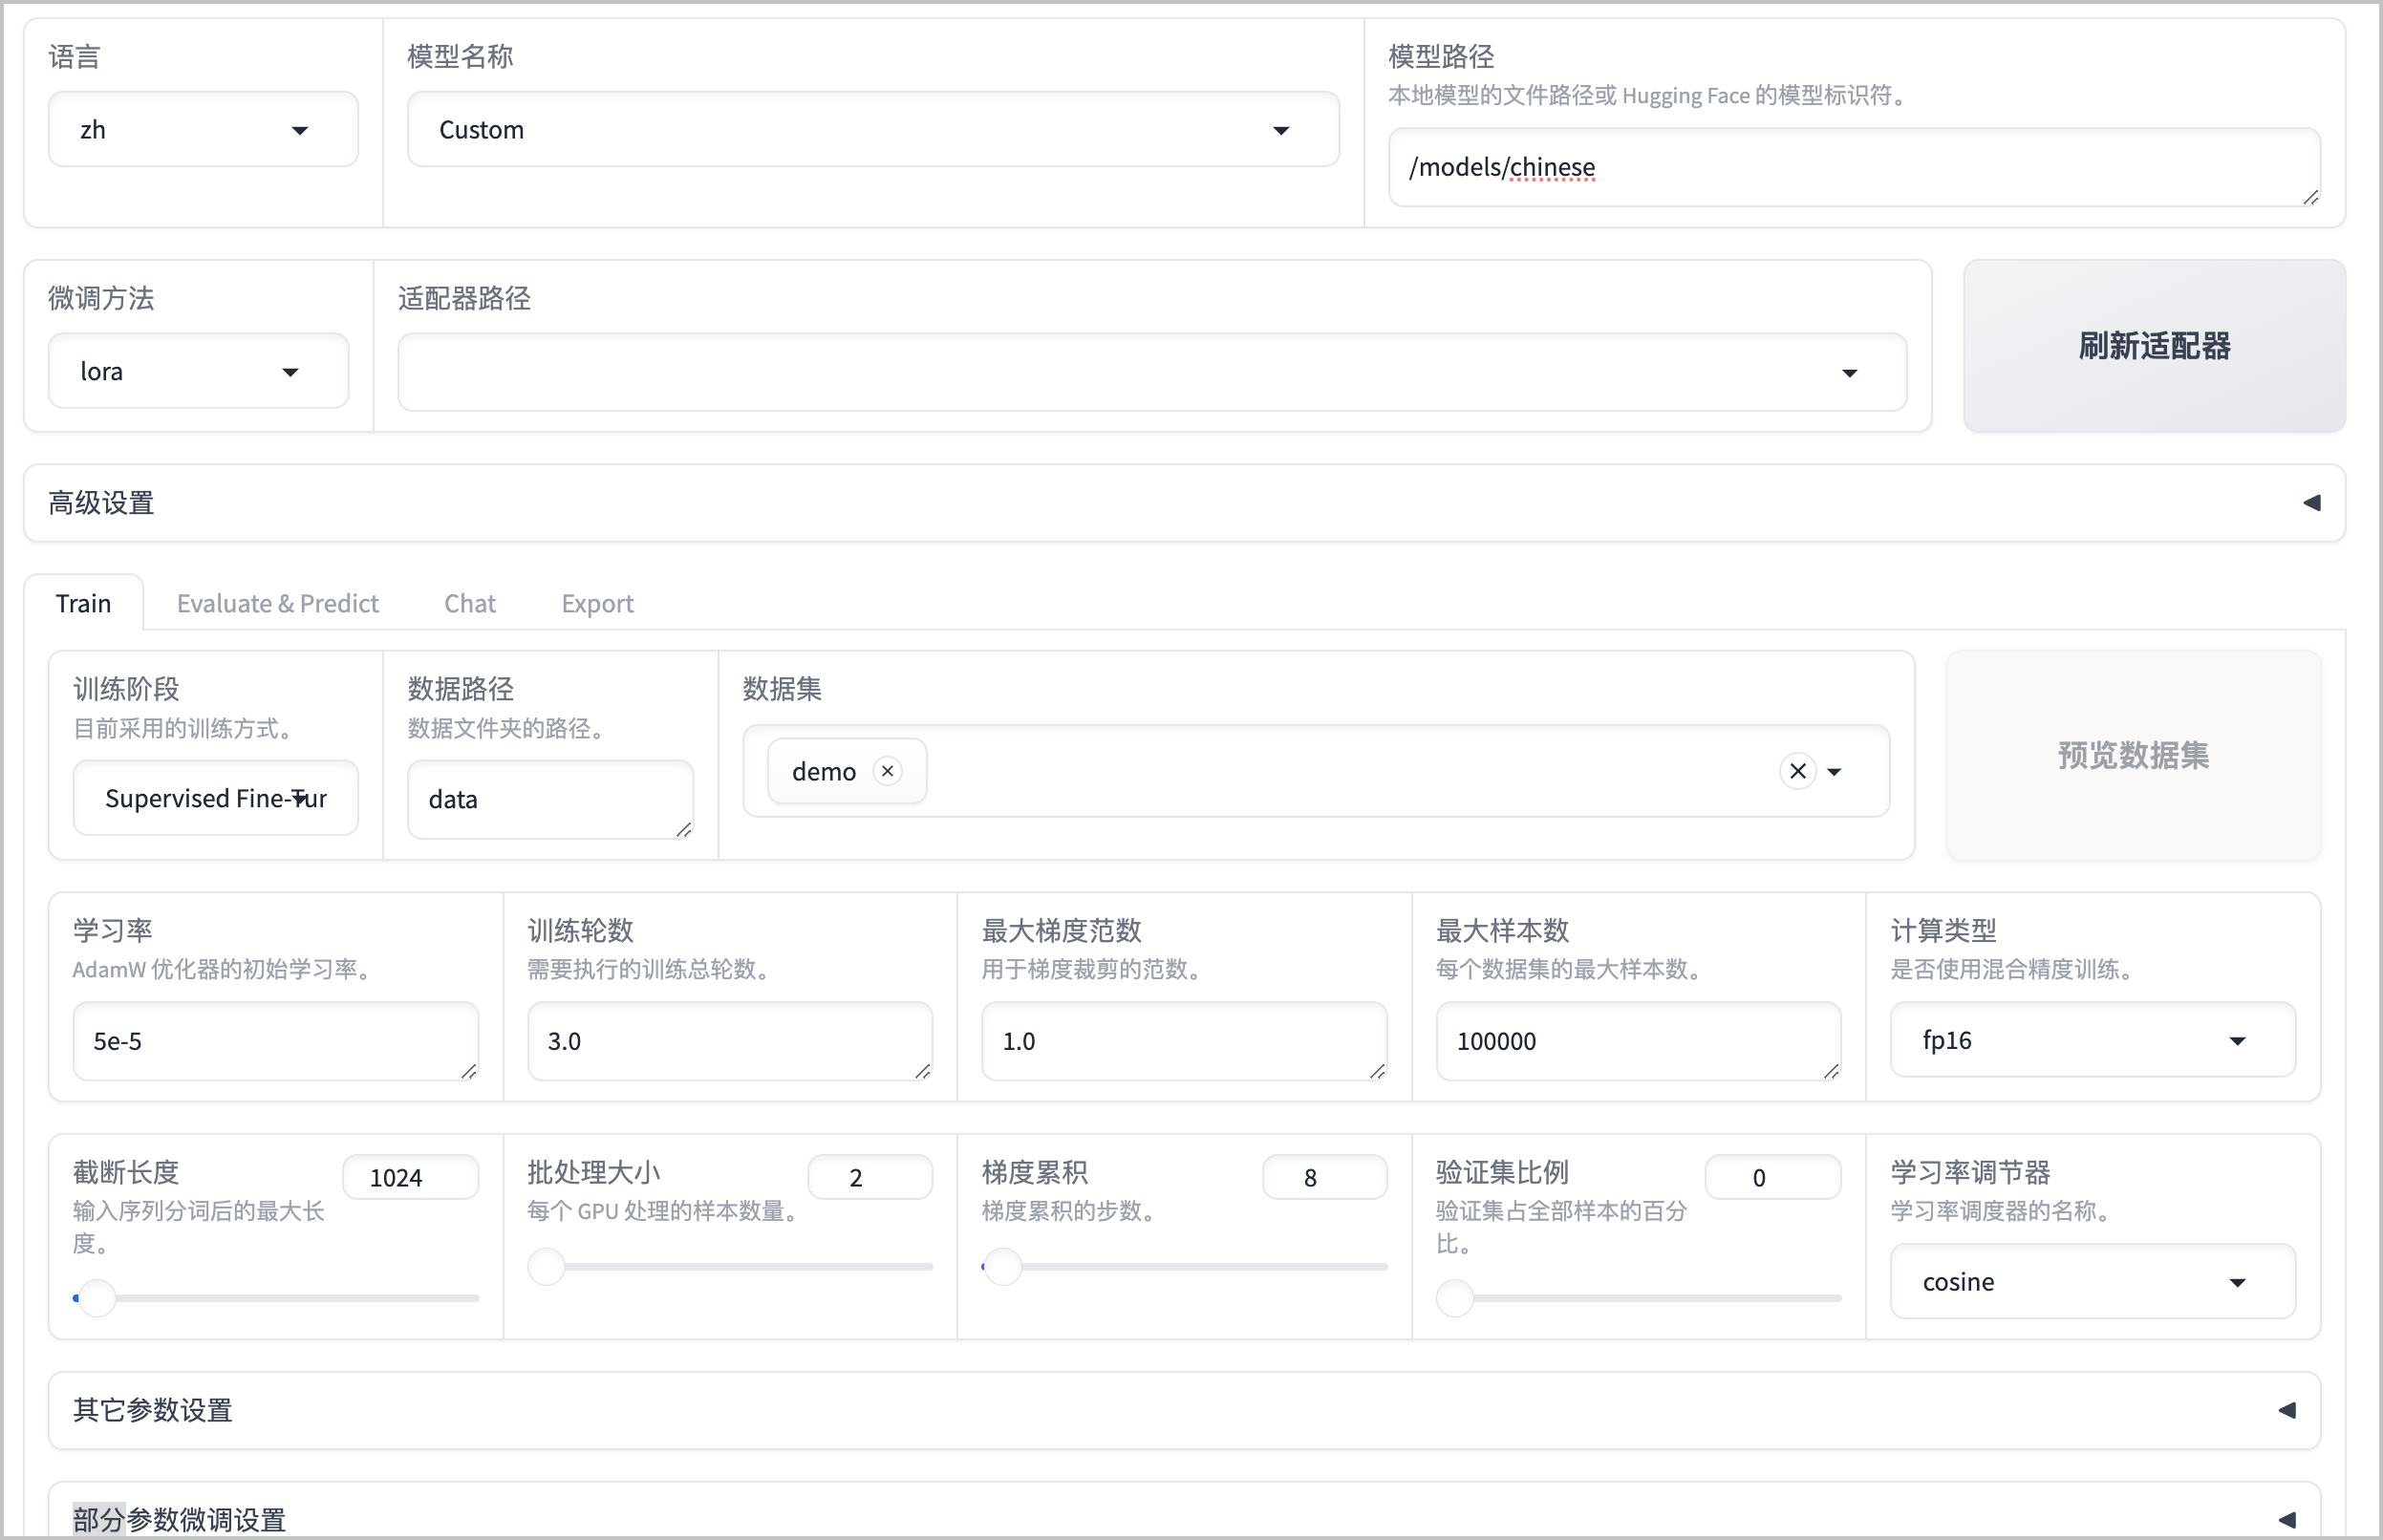
- 应用部署成功后,可在 访问设置 区域复制应用的访问地址。通过该地址去访问 LLaMA Factory Web UI。
- 配置参数,开始模型微调。
-
最近更新时间:2026.06.17 16:50:41
这个页面对您有帮助吗?
有用
有用
无用
无用