持续交付
持续交付


文档指南

请输入


- 文档首页
 持续交付用户指南AI 应用DeepSeek快速部署 DeepSeek-R1-Distill 模型
 复制全文
 下载 pdf
快速部署 DeepSeek-R1-Distill 模型
 文档反馈
 问问助手
本文介绍如何在火山引擎容器服务集群中,快速部署 DeepSeek-R1-Distill 模型推理服务,满足您的业务需求。
背景信息
DeepSeek-R1-Distill:基于 DeepSeek-R1 生成的 800K 样本对原开源模型进行微调得到的新模型,旨在以更小参数规模保留 DeepSeek-R1 发现的强大推理能力。
使用说明
前提条件
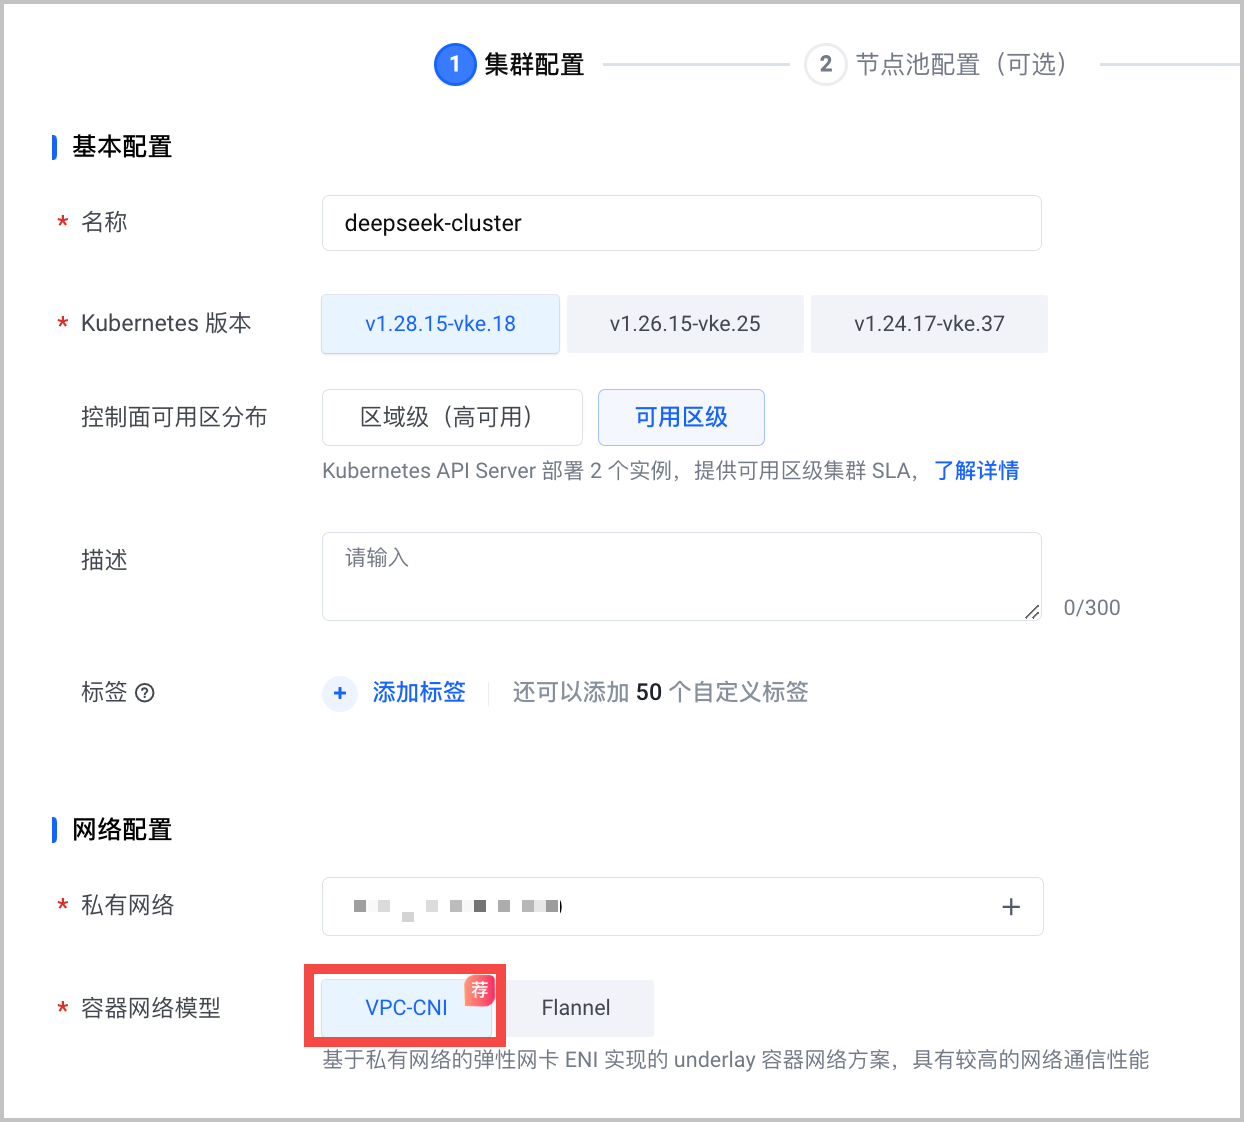
- 容器网络模型:选择 VPC-CNI。
-
- 计算规格:推荐使用不同的机型部署不同的模型,以发挥最大性价比。以下为常用的蒸馏模型机型配置推荐,请供参考。
-
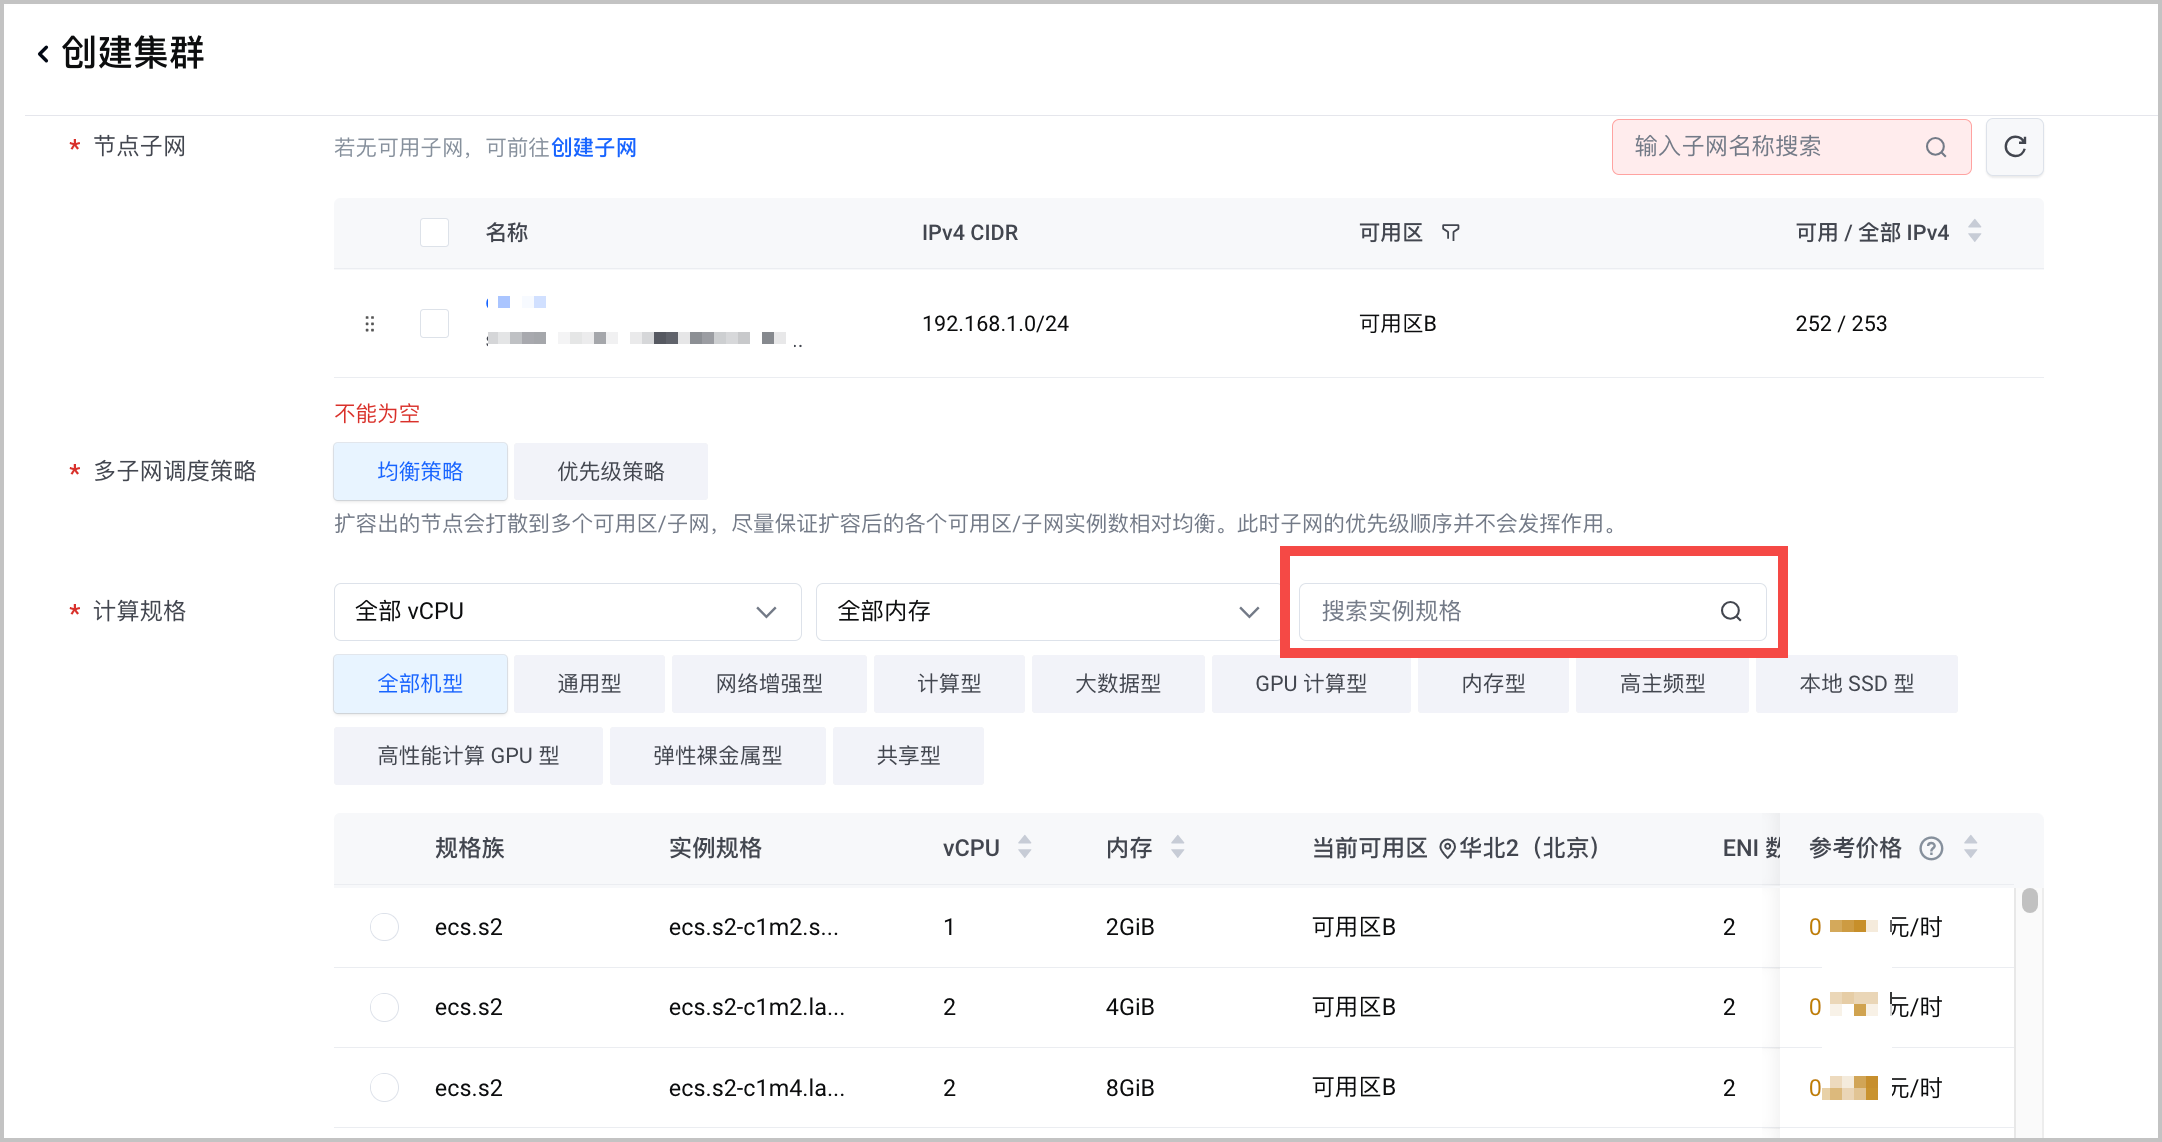
- 模型名称参数量基础模型上下文窗口机型推荐DeepSeek-R1-Distill-Qwen-7B7BQwen2.5-Math-7B32kecs.xni3c.5xlargeecs.gni3cg.5xlarge/ecs.gni3cl.5xlargeDeepSeek-R1-Distill-Qwen-32B32BQwen2.5-32B32kecs.pni3l.11xlargeecs.gni3cg.22xlarge/ecs.gni3cl.22xlargeecs.xni3c.22xlargeDeepSeek-R1-Distill-Llama-70B70BLlama-3.3-70B-Instruct32kecs.pni3l.11xlargeecs.pni3l.22xlarge
- 组件配置:安装 csi-tos 和 nvidia-device-plugin 两个组件。
操作步骤
本文介绍通过火山引擎持续交付产品,完成 DeepSeek-R1-Distill 在已创建的容器服务中的快速部署。
第一步:创建部署集群
将已创建的 VKE 集群接入持续交付平台。
- 登录 持续交付控制台。
- 在左侧导航栏选择 资源管理。
- 在资源管理页面,切换至 部署资源 页签。
- 在 部署资源 页签,单击 创建部署资源 。
- 在 创建部署资源 对话框,按要求配置部署资源信息。重点注意以下参数配置,其他参数说明参见 接入 VKE 集群。
-
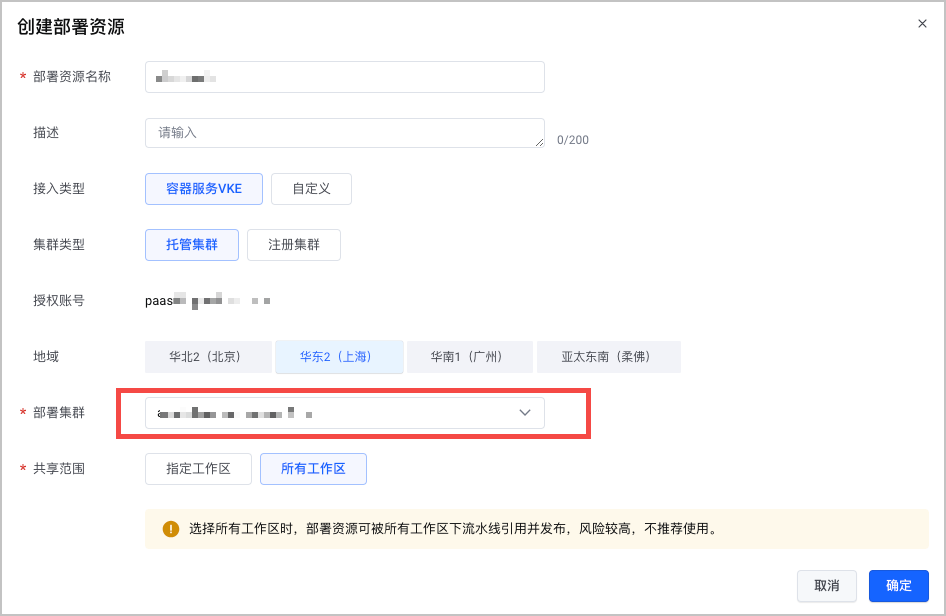
- 配置项说明接入类型选择 容器服务 VKE。地域选择已创建容器服务集群所在的地域。共享范围选择 所有工作区。
第二步:创建 AI 应用
在持续交付的 AI 应用 模块,部署大模型应用。
- 登录 持续交付控制台。
- 在左侧导航栏选择 AI 应用。
- 在 AI 应用页面,单击 创建应用。
- 选择 基于 AI 模型创建 > DeepSeek-R1,单击 部署。
-

- 按要求填写应用的相关配置信息。配置完成后单击 创建,应用将开始创建并部署。重点注意以下参数配置,其他参数说明参见 创建和部署 AI 应用(自定义创建)。
- 模型配置
-

-
- 部署集群
-
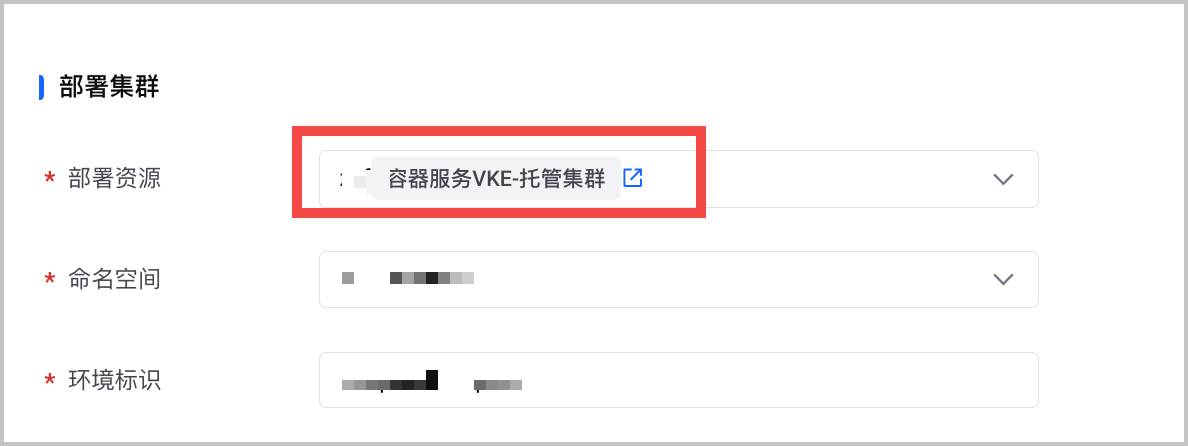
- 配置项说明部署资源选择已创建的容器服务集群。
- 推理服务规格
-
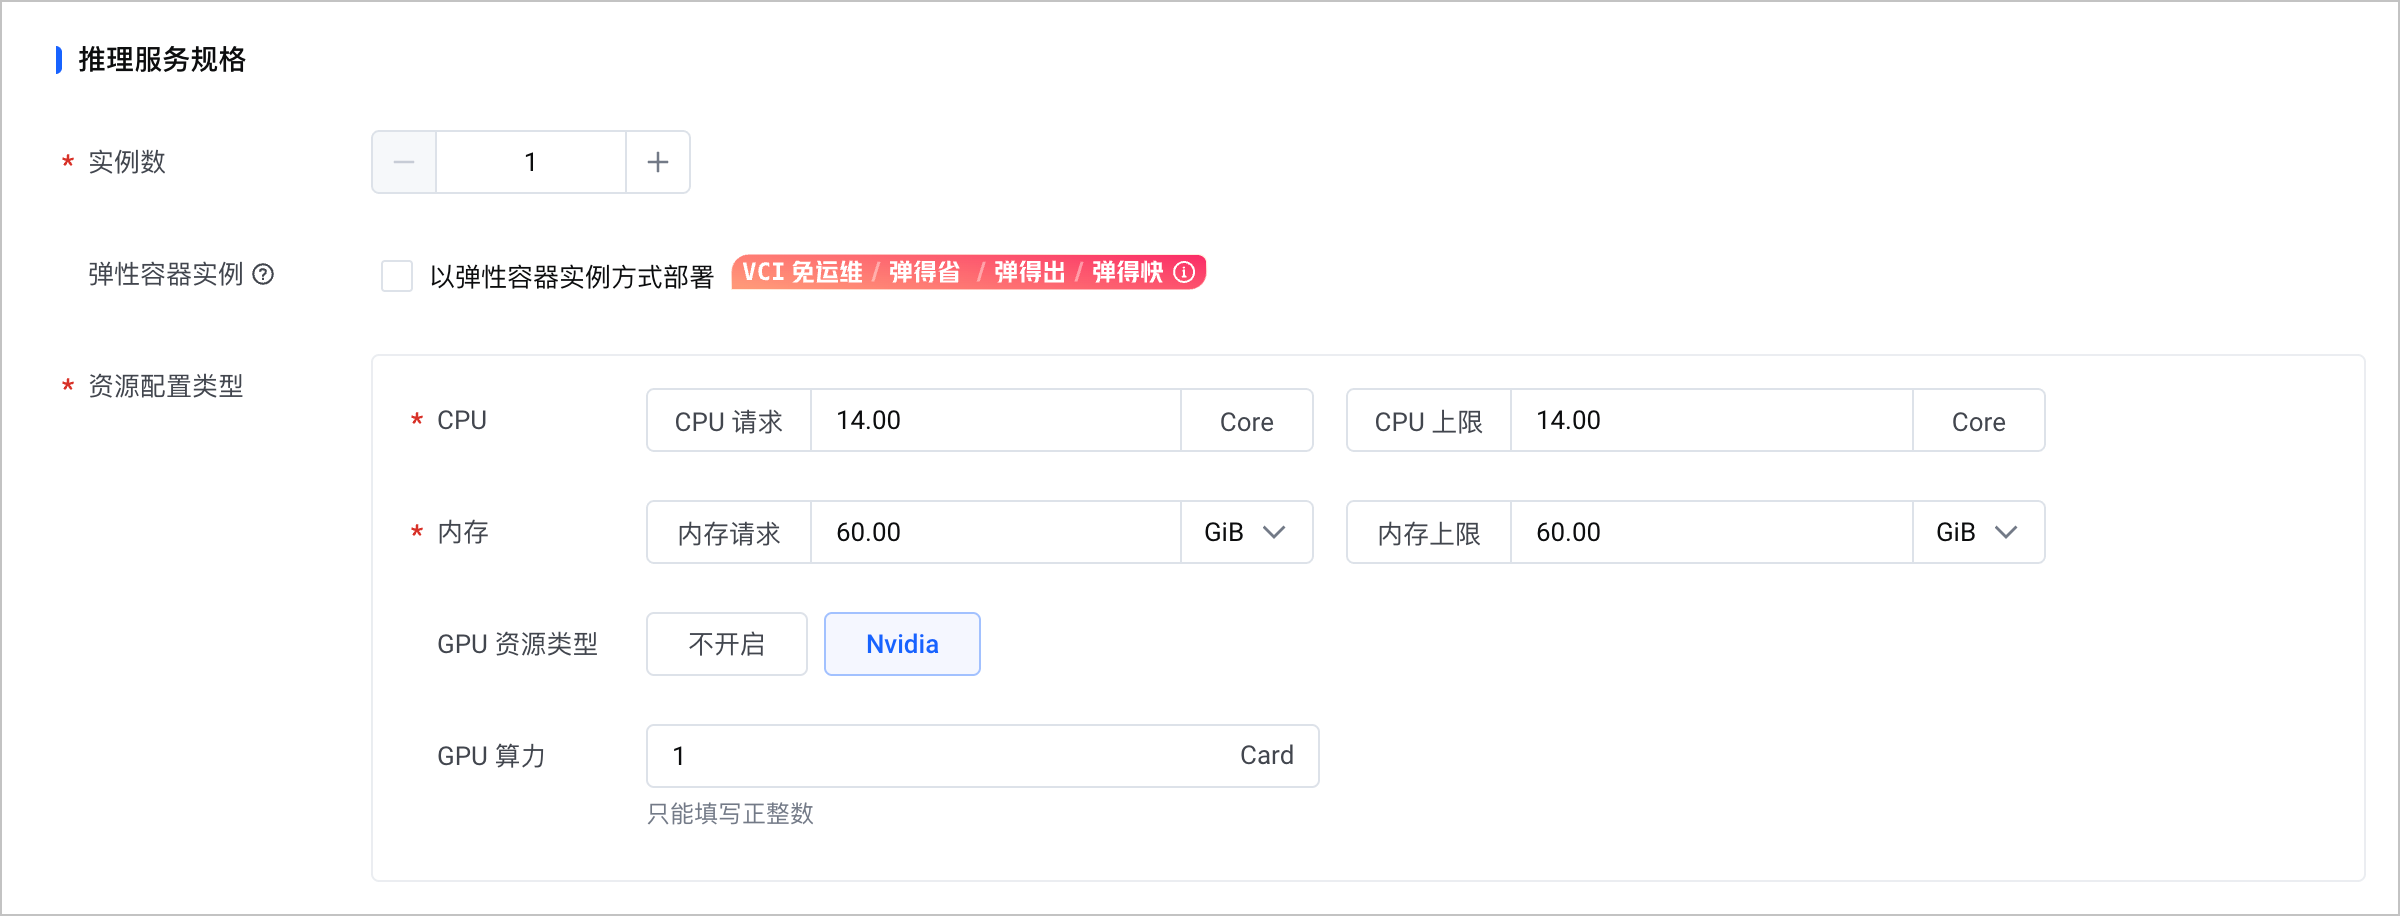
- 配置项说明实例数选择 1。弹性容器实例本示例不选择该功能。资源配置类型根据不同的 DeepSeek-R1-Distill 模型,参考下表选择相应配置。
- 模型名称CPU 请求/上限内存请求/上限DeepSeek-R1-Distill-Qwen-1.5B12Core60GiBDeepSeek-R1-Distill-Qwen-7B14Core60GiBDeepSeek-R1-Distill-Qwen-32B20Core110GiBDeepSeek-R1-Distill-Llama-70B40Core220GiB
第三步:创建负载均衡
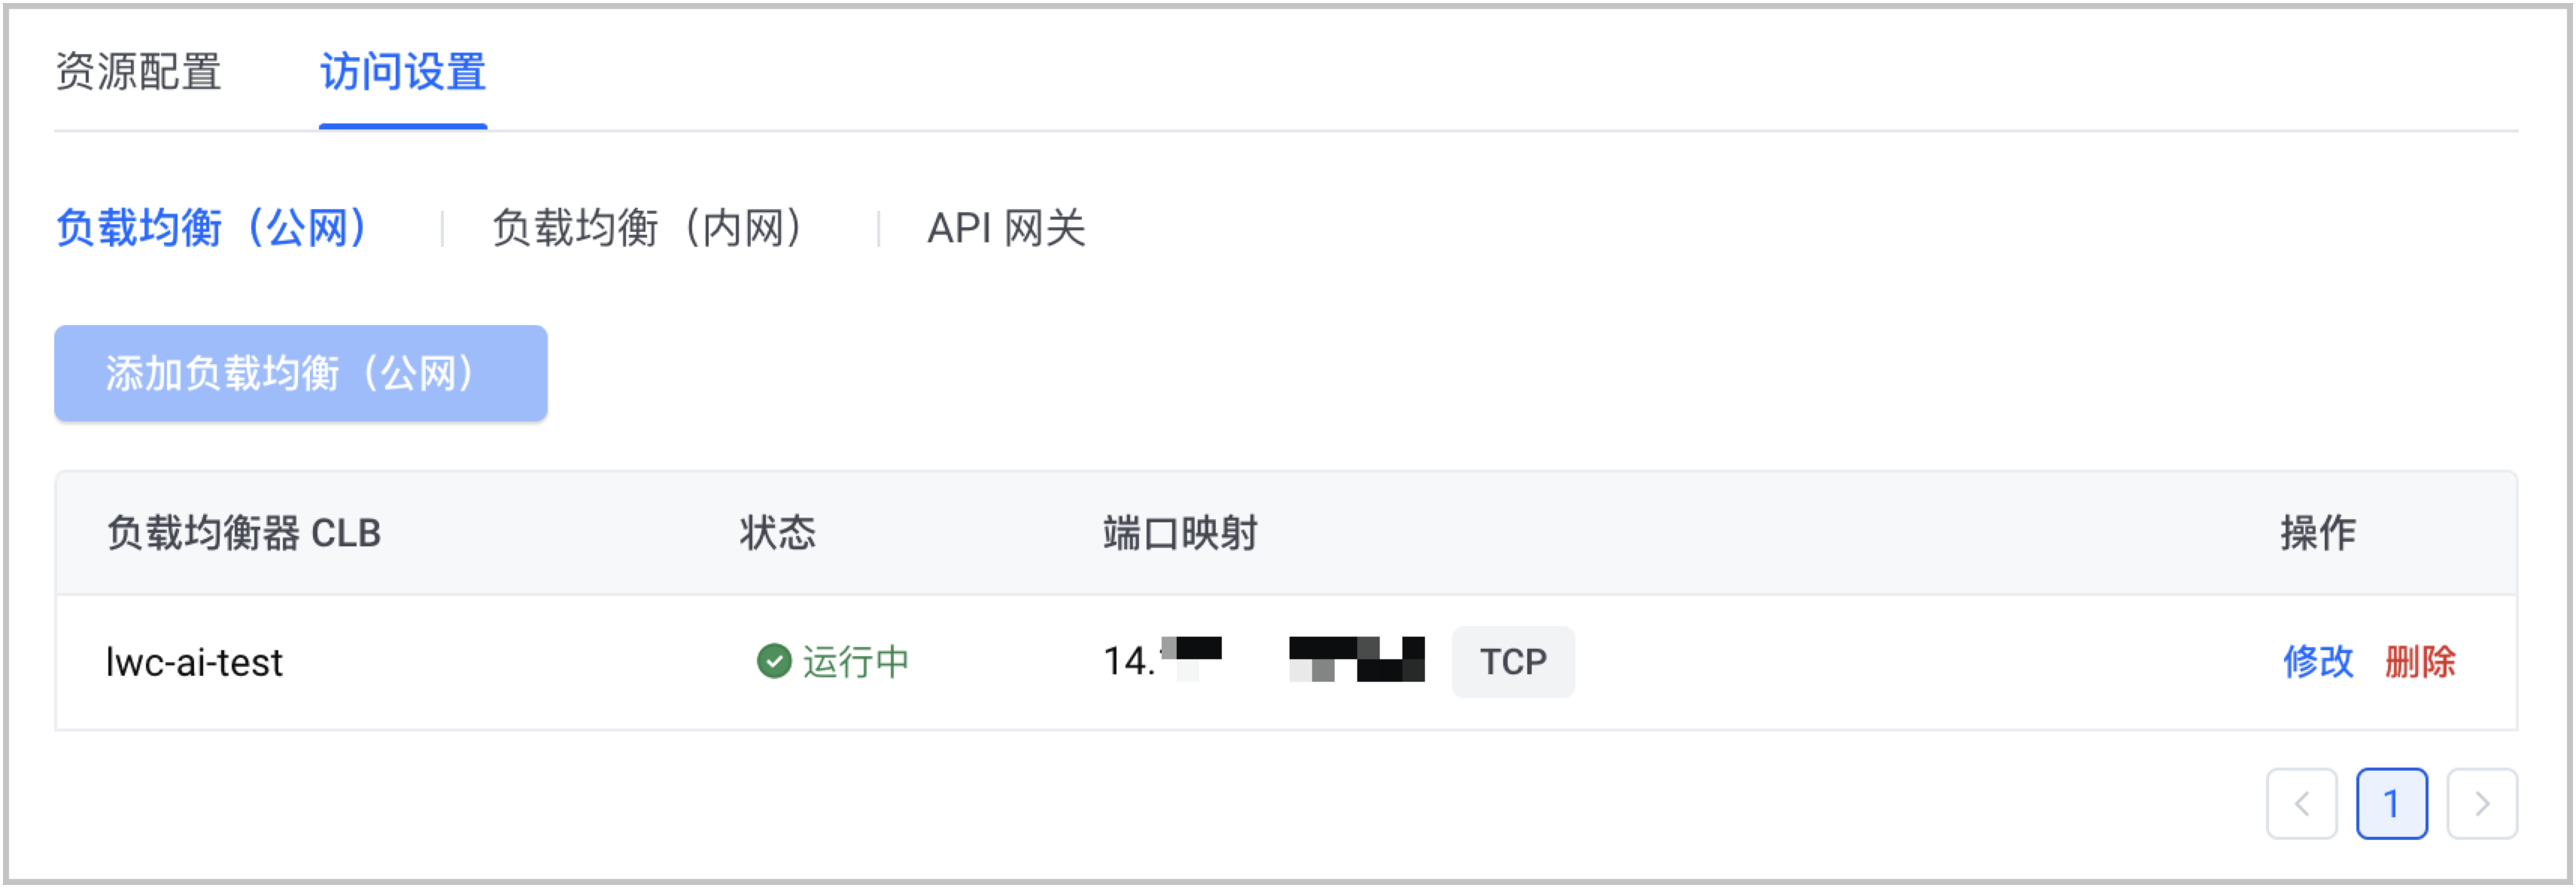
部署完成后,创建工作负载以支持应用在私网和公网中的访问。创建完成后支持通过负载均衡 IP 地址调用大模型。
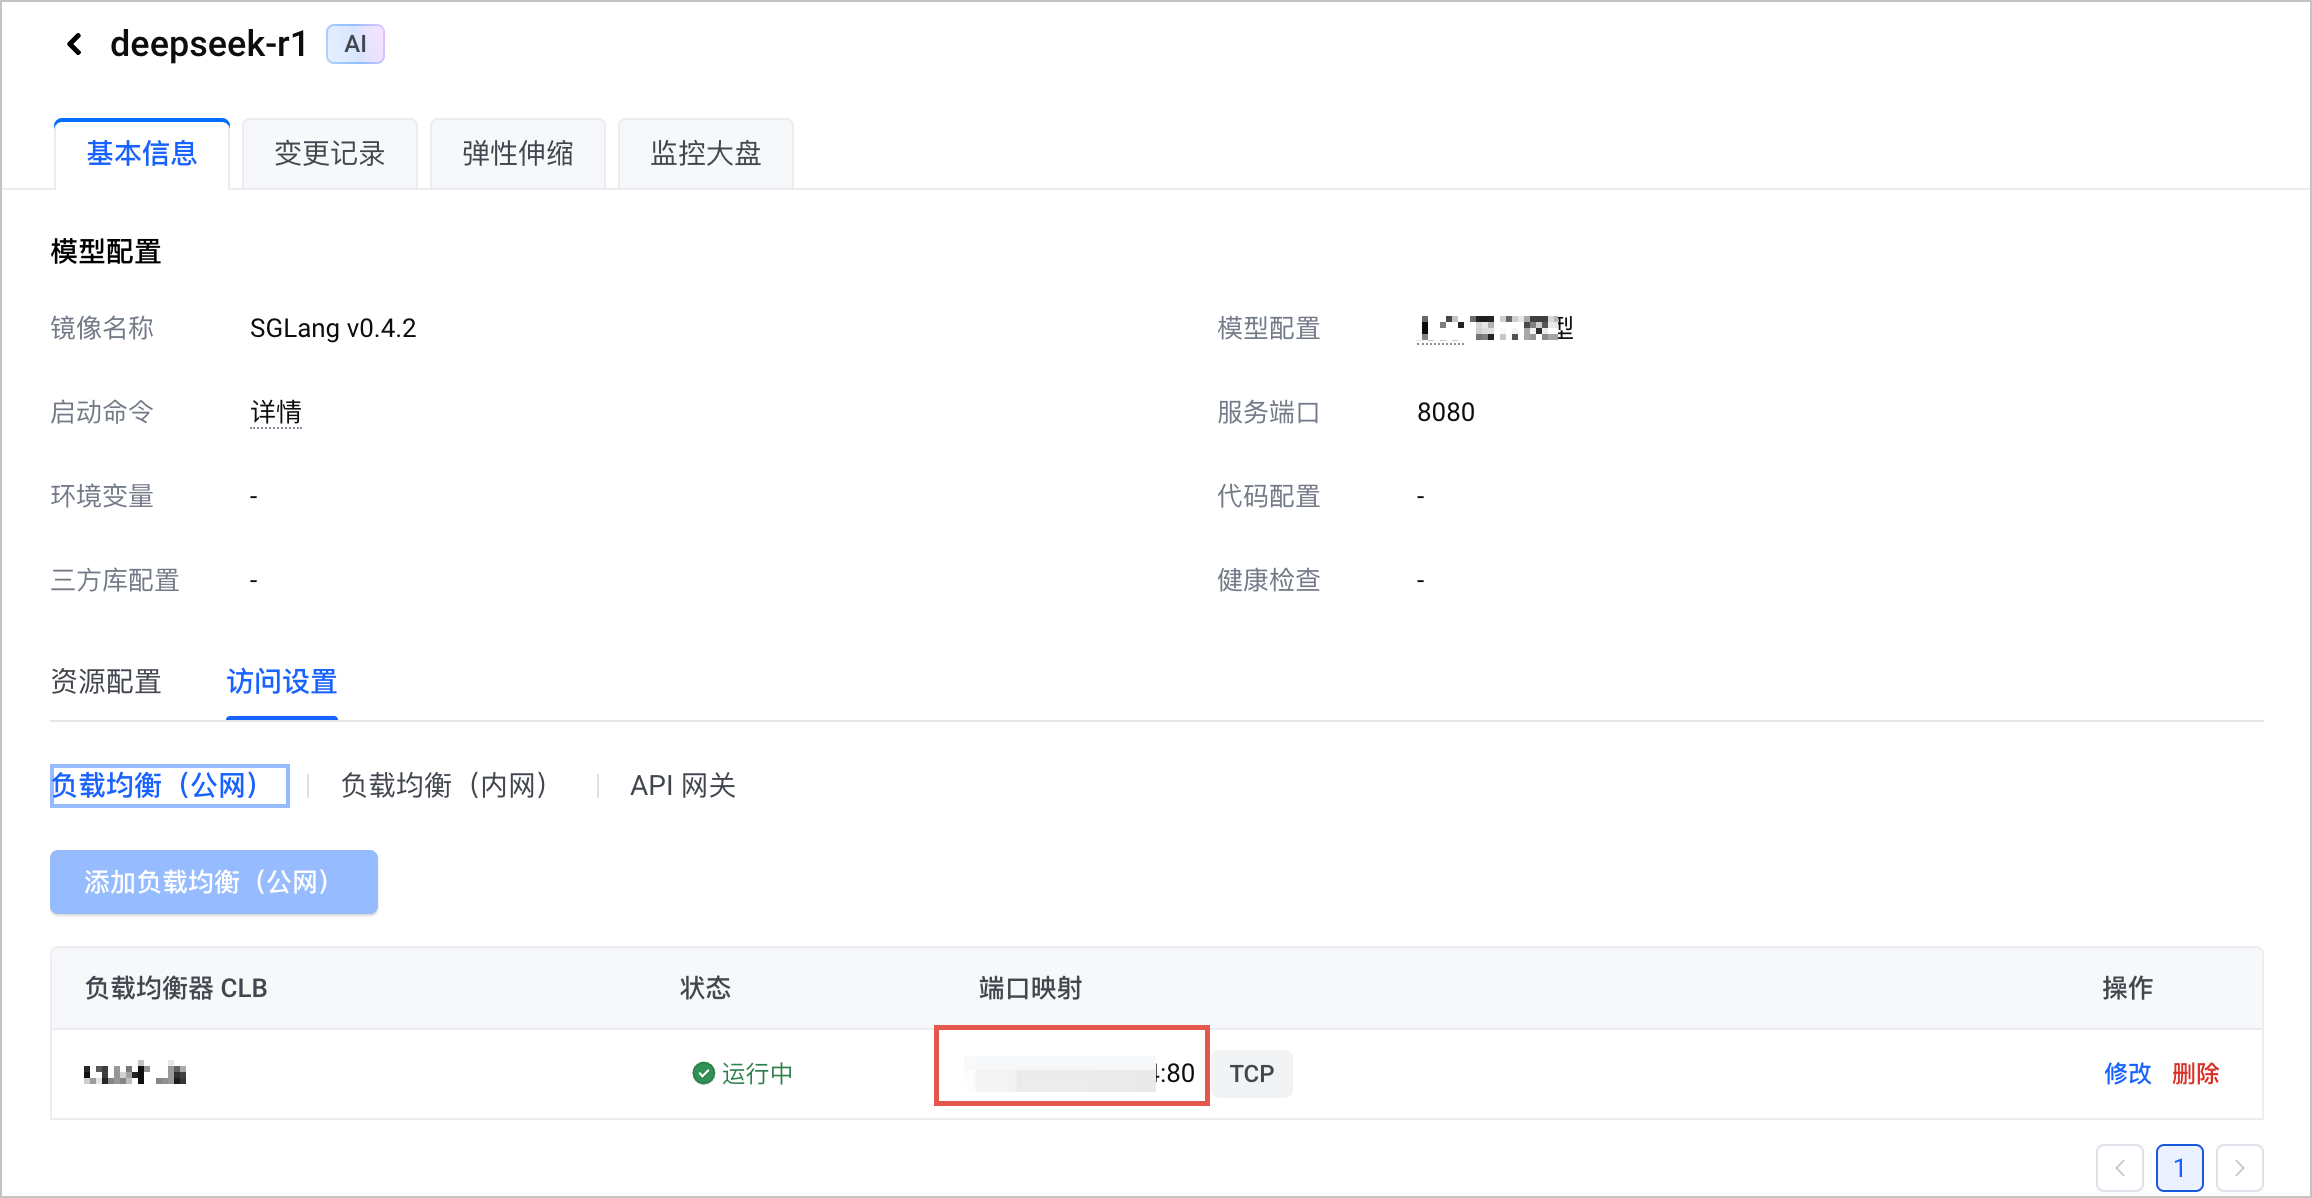
- 登录当前应用。
- 登录 持续交付控制台。
- 在左侧导航栏选择 AI 应用。
- 在 AI 应用页面,选择目标 AI 应用,单击应用卡片,进入当前应用的基本信息页签。
- 在 基本信息 > 访问设置 页签,配置应用的访问方式。详情操作说明参见 访问设置。
-
- 容器端口 和之前应用的端口保持一致。
-
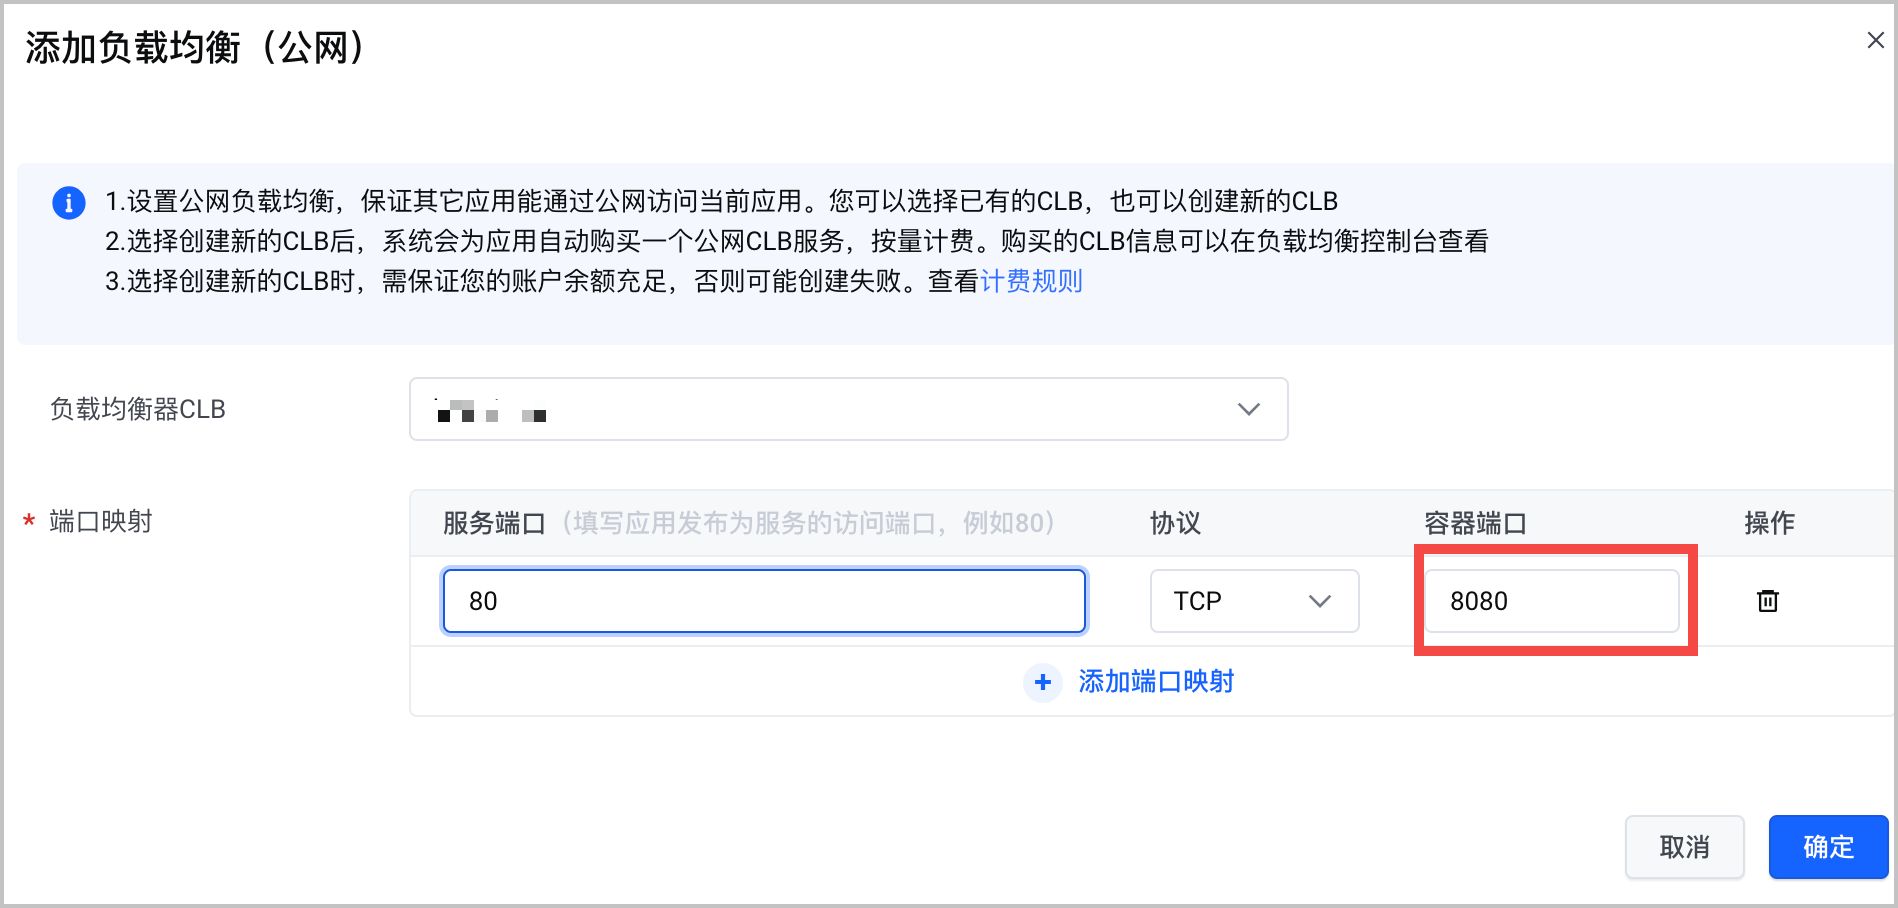
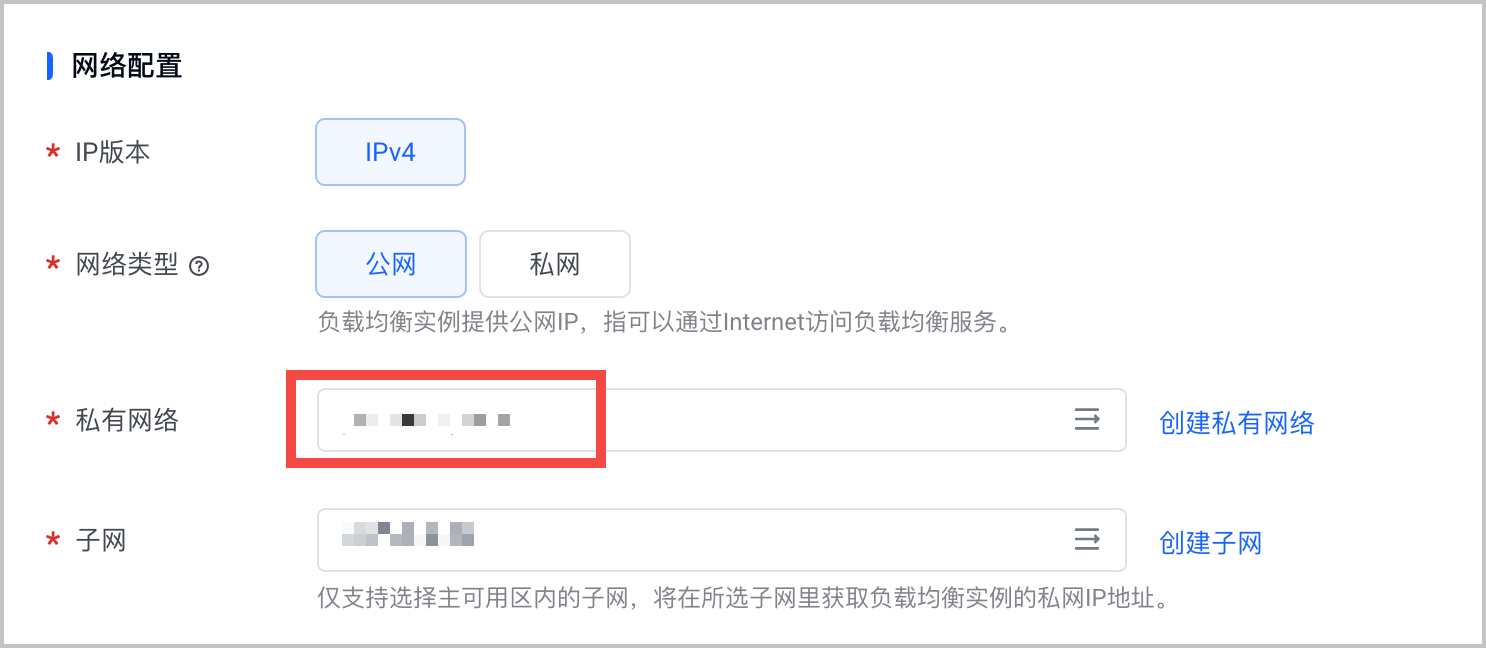
- 在创建负载均衡时,私有网络 配置必须与之前创建 VKE 集群使用的私有网络相同。
-
操作结果
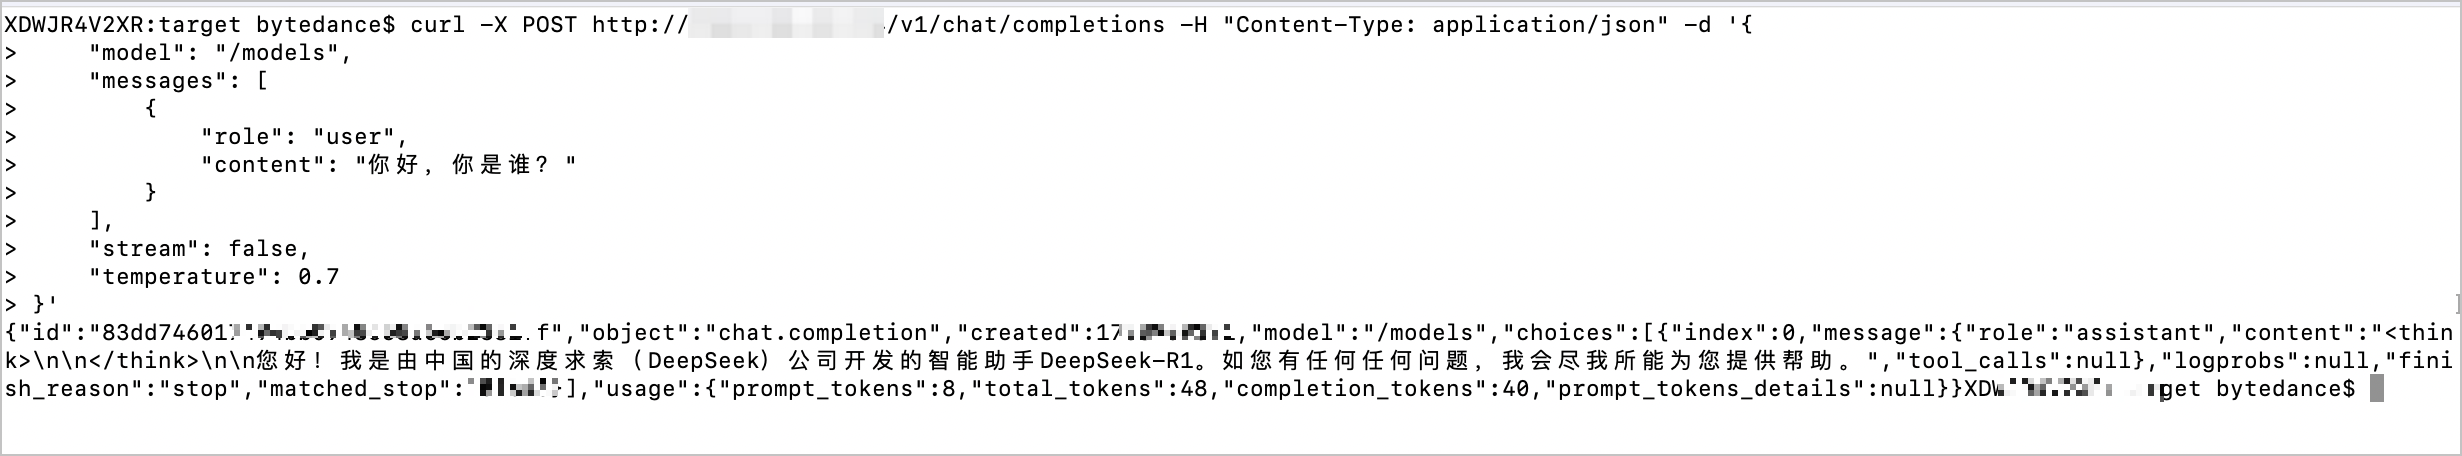
通过本地 curl 命令和已创建的负载均衡 IP 调用大模型 API,即可以成功和 DeepSeek-R1-Distill 模型对话。
最近更新时间:2025.09.04 19:20:17
这个页面对您有帮助吗?
有用
有用
无用
无用