流式计算 Flink版
流式计算 Flink版


文档指南

请输入


- 文档首页
 流式计算 Flink版最佳实践性能调优SQL 性能优化Operator Chain 和对象复用
 复制全文
 下载 pdf
Operator Chain 和对象复用
 文档反馈
 问问助手
1. 文档背景
本文介绍了 Flink 中 Operator Chain 算子链和对象复用的技术项,在性能优化和 Debug 等方面给与相关的建议。
2. 场景描述
2.1 Operator Chain
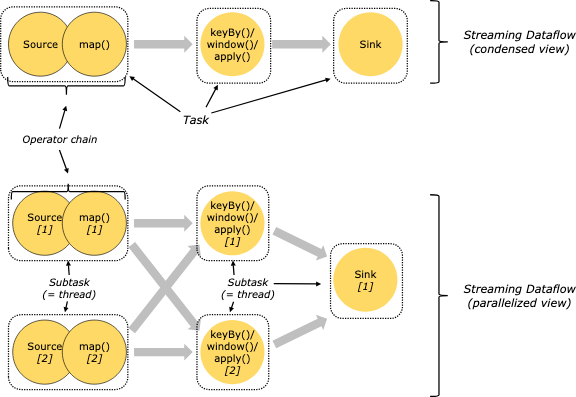
在分布式执行中,Flink 将 Operator (算子)的子任务 Chain (连接)在一起形成任务。每个任务由一个线程执行。将 Operator 连成一个任务是一项有效的优化:它能减少线程间切换和缓冲的开销,在提升整体吞吐量的同时降低延迟。可以参考如下的示意图,
2.2 对象复用
在流式场景下,对于“chain”在一起的算子,默认的行为是在上游算子向下游算子传递数据的时候会对数据进行一次深拷贝。这样做的主要考虑是下游算子可能存在对可变对象的复用或者修改等操作。
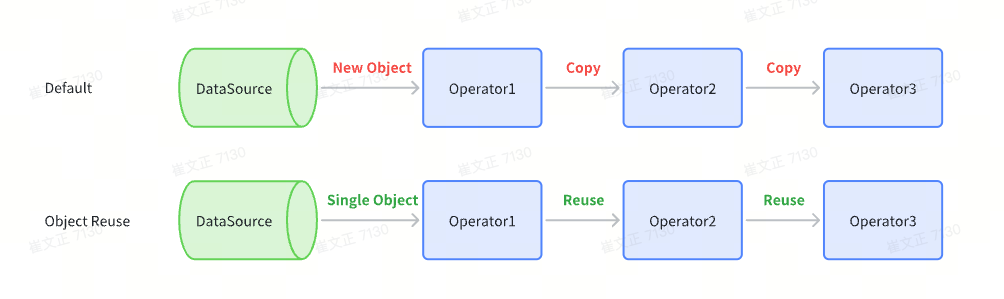
但是,往往这个数据拷贝的成本是很高的,因此,Flink 提供了动态参数pipeline.object-reuse去控制算子 chain 中上游算子向下游算子传递数据的行为。
3. 操作方法
3.1 场景一:开启 Object-Reuse 提升性能
3.1.1 参数设置
在已有的 Flink 任务中,将 pipeline.object-reuse 设置为 true 即可
任务开发 - 配置参数 - 自定义参数设置:
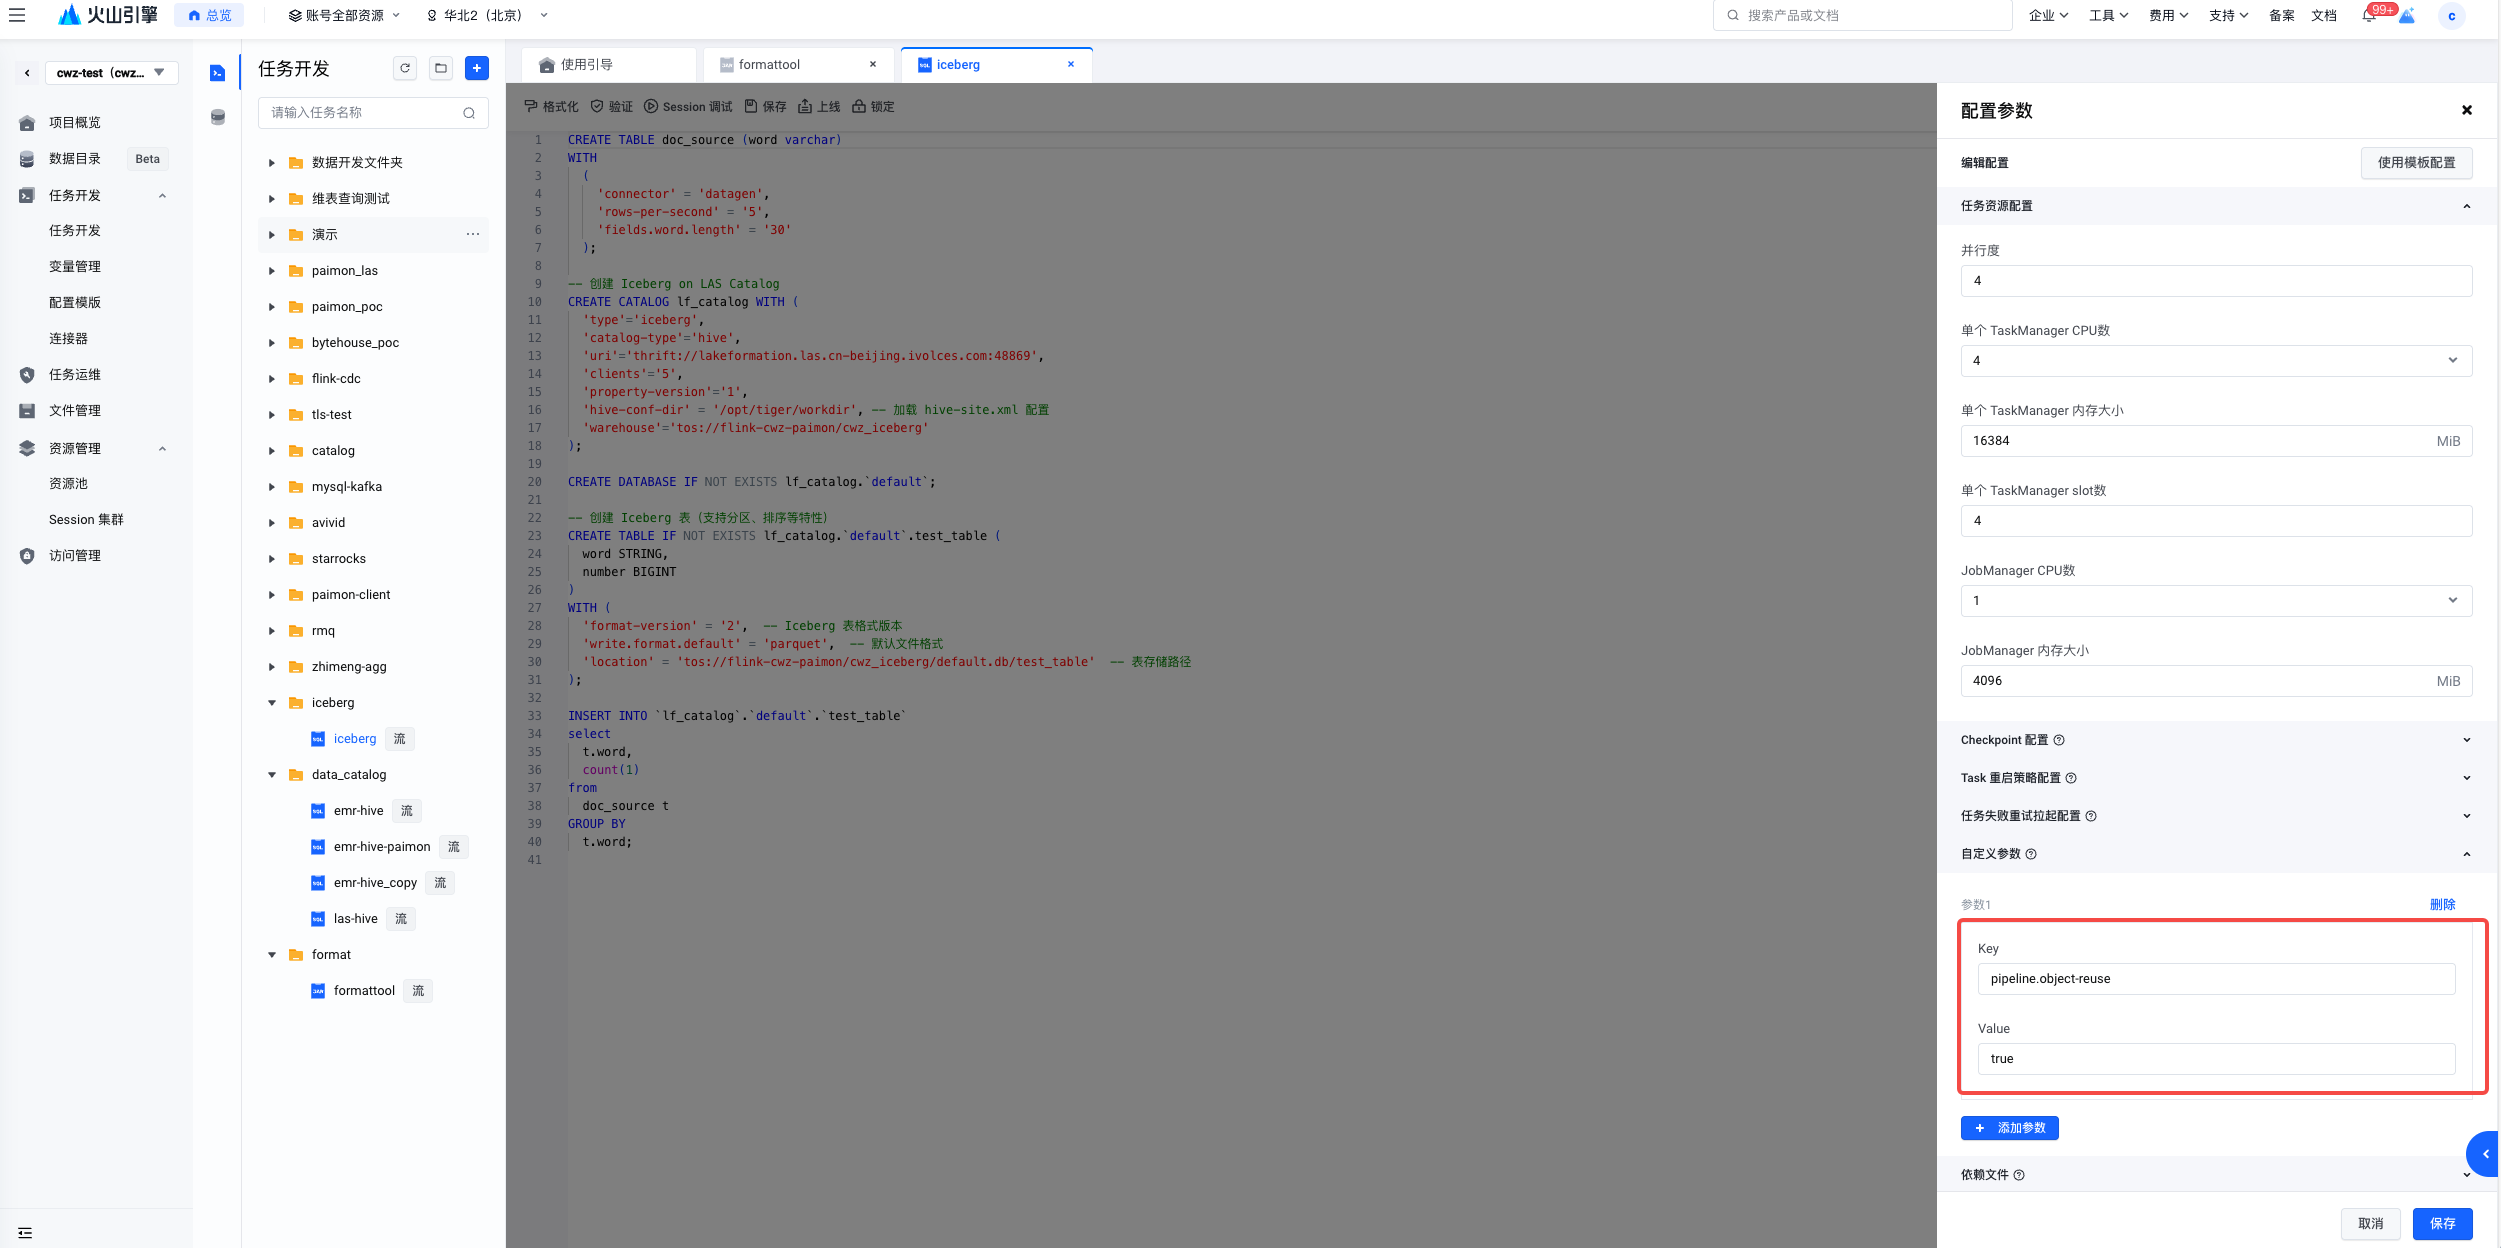
修改完毕参数后,记得保存任务,并且发布任务后,启动任务。
3.1.2 参数验证
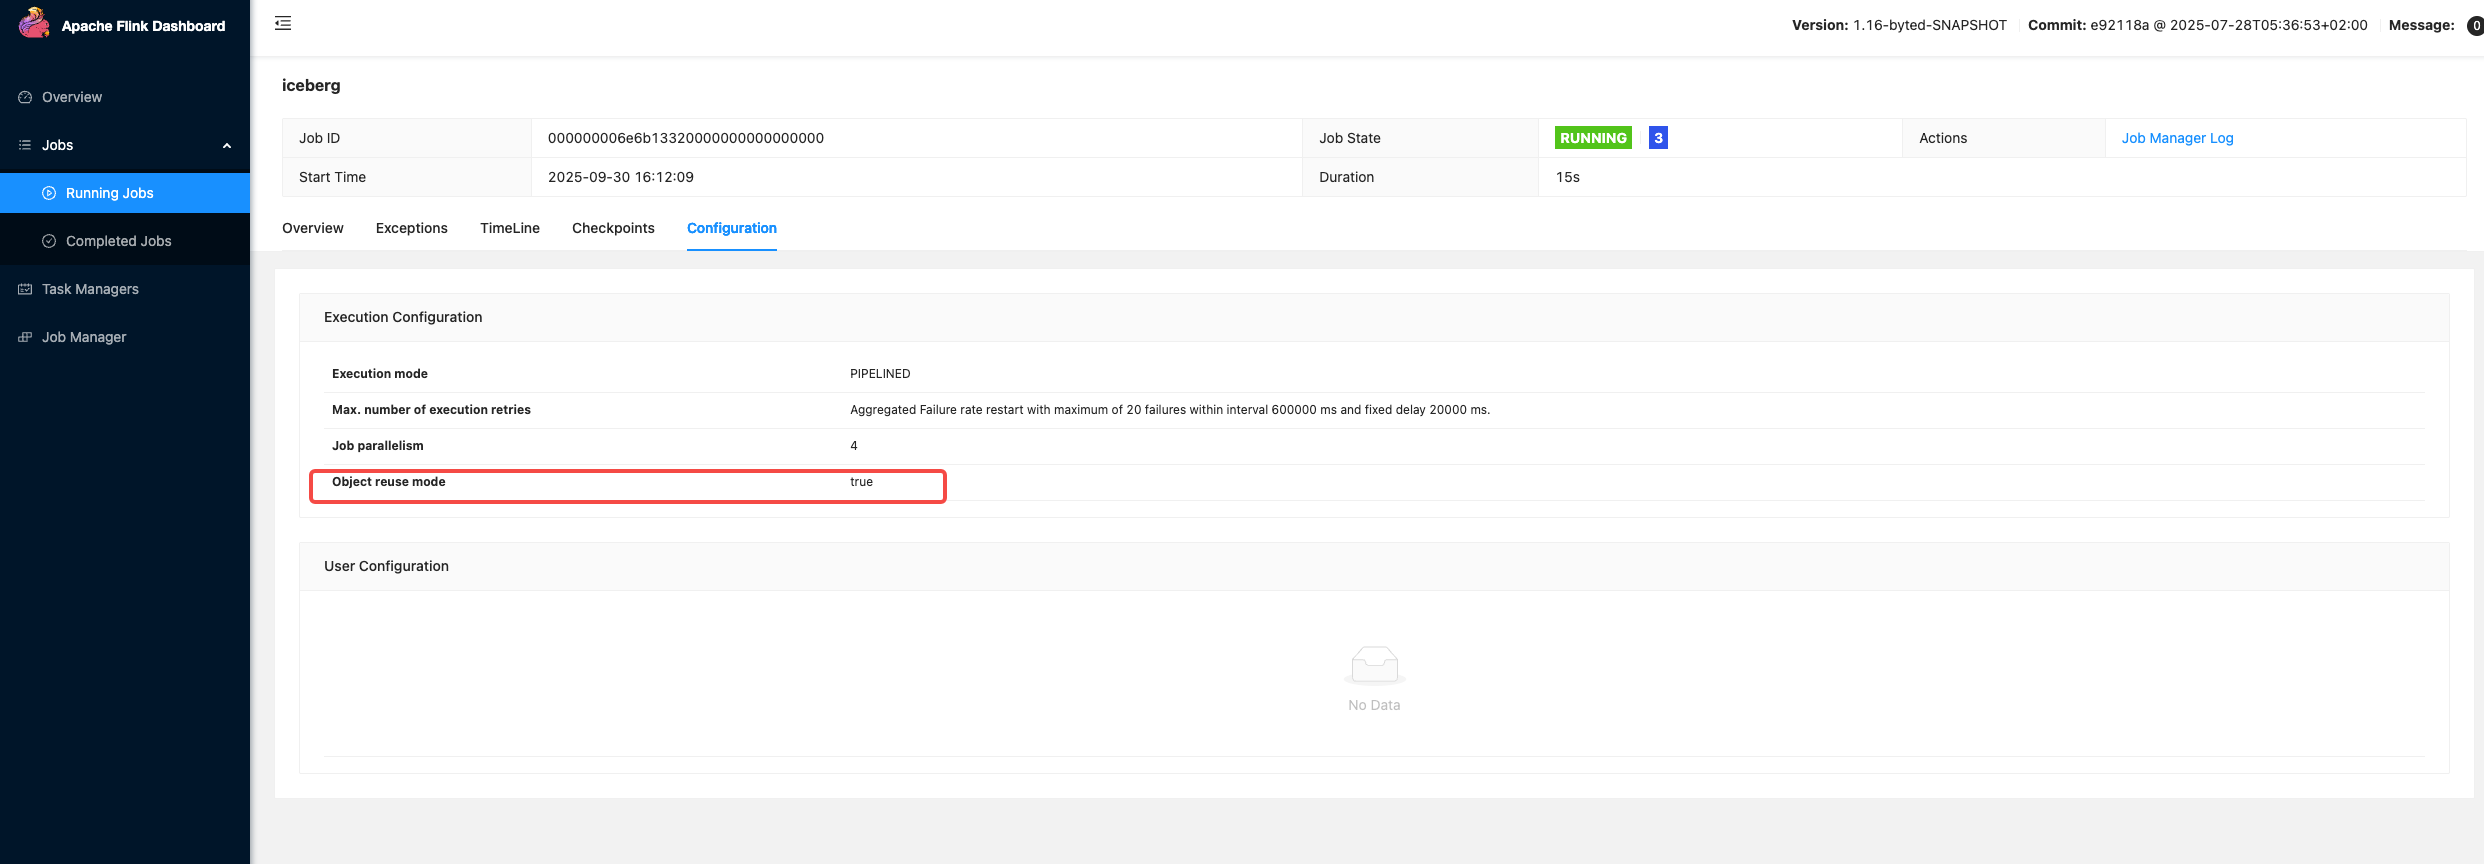
在 Flink UI 中可以通过参数确认是否生效。可以看到 Object Reuse Mode 为 true 则代表配置生效。
3.2 场景二:禁用 Operator Chaining 用来 Debug 性能瓶颈
3.2.1 参数设置
虽然 Operator Chaining 和对象复用给我们带来很多性能上的优势,但是也对我们任务调试带来一些麻烦。比如多个算子连接在一起后,出现性能瓶颈无法确认是哪个算子产生瓶颈,这时候,我们需要禁用这个特性
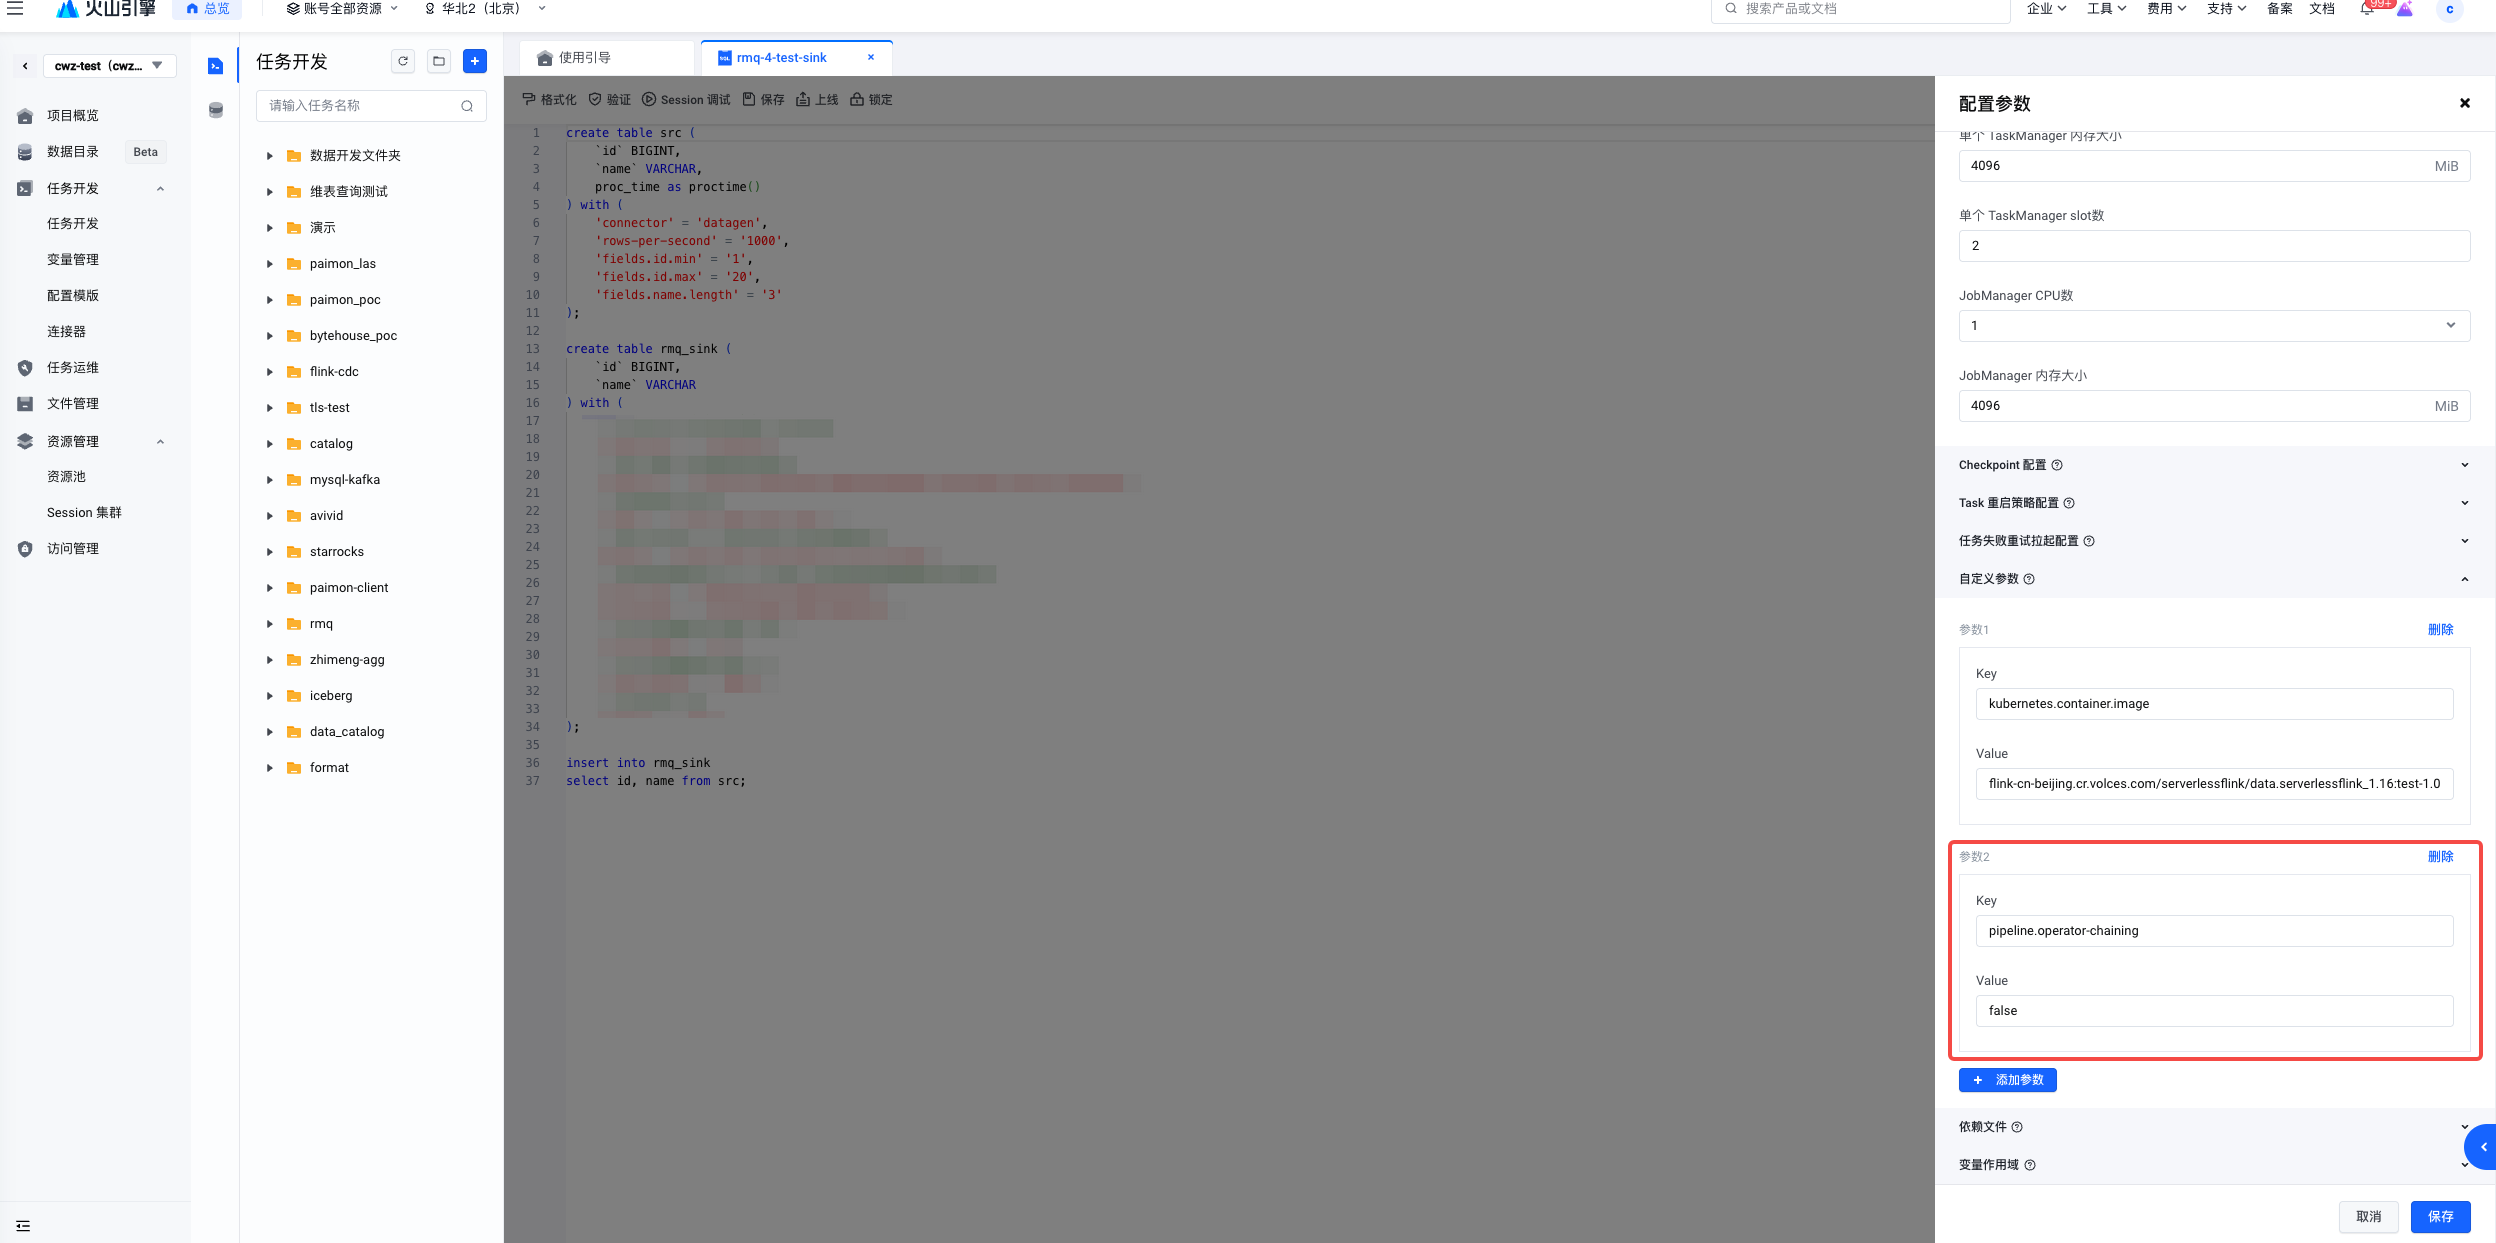
配置方法为,任务开发 - 配置参数 - 自定义参数设置。修改完自定义参数后,记得保存发布。
3.2.2 参数验证
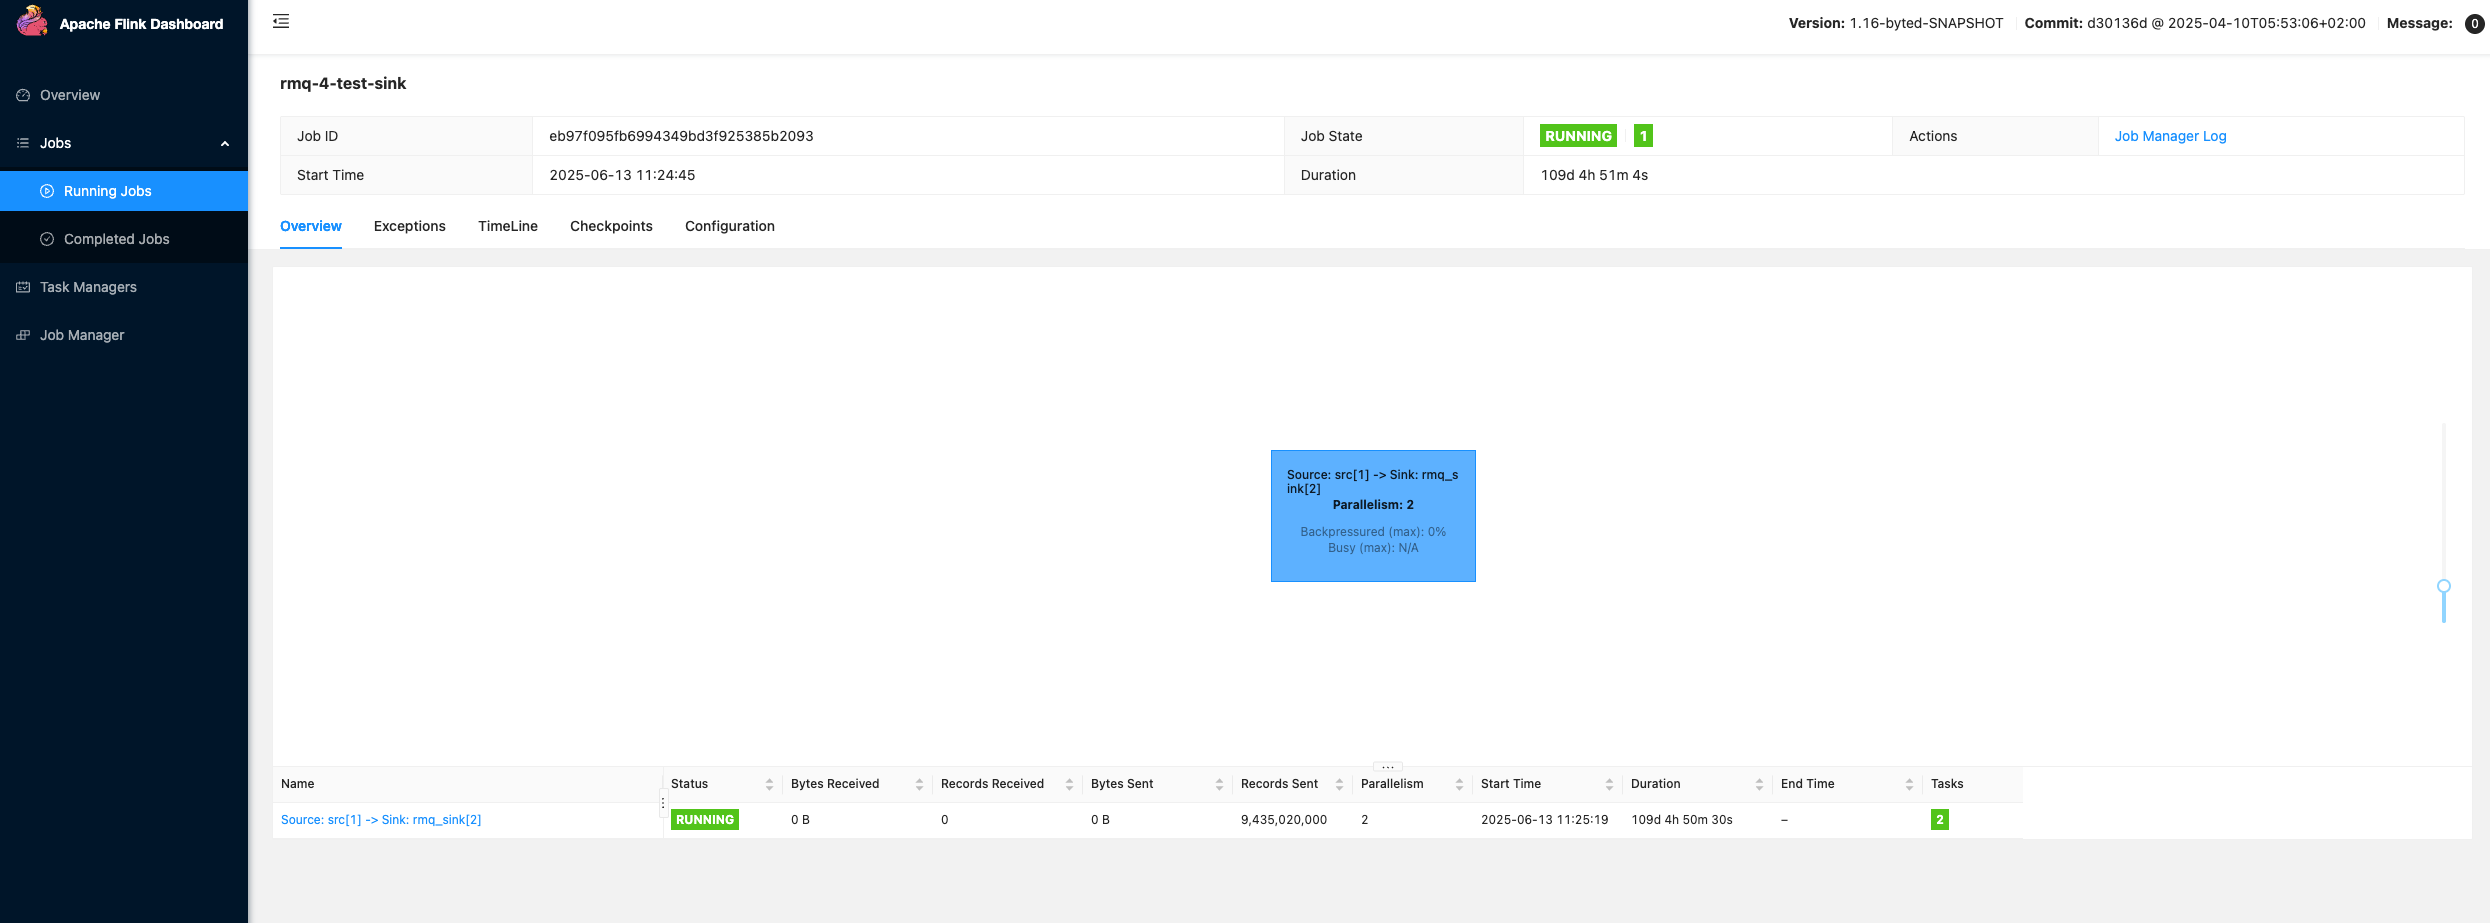
可以通过观察 DAG 图确认是否生效,比如重启前的任务 DAG 如下
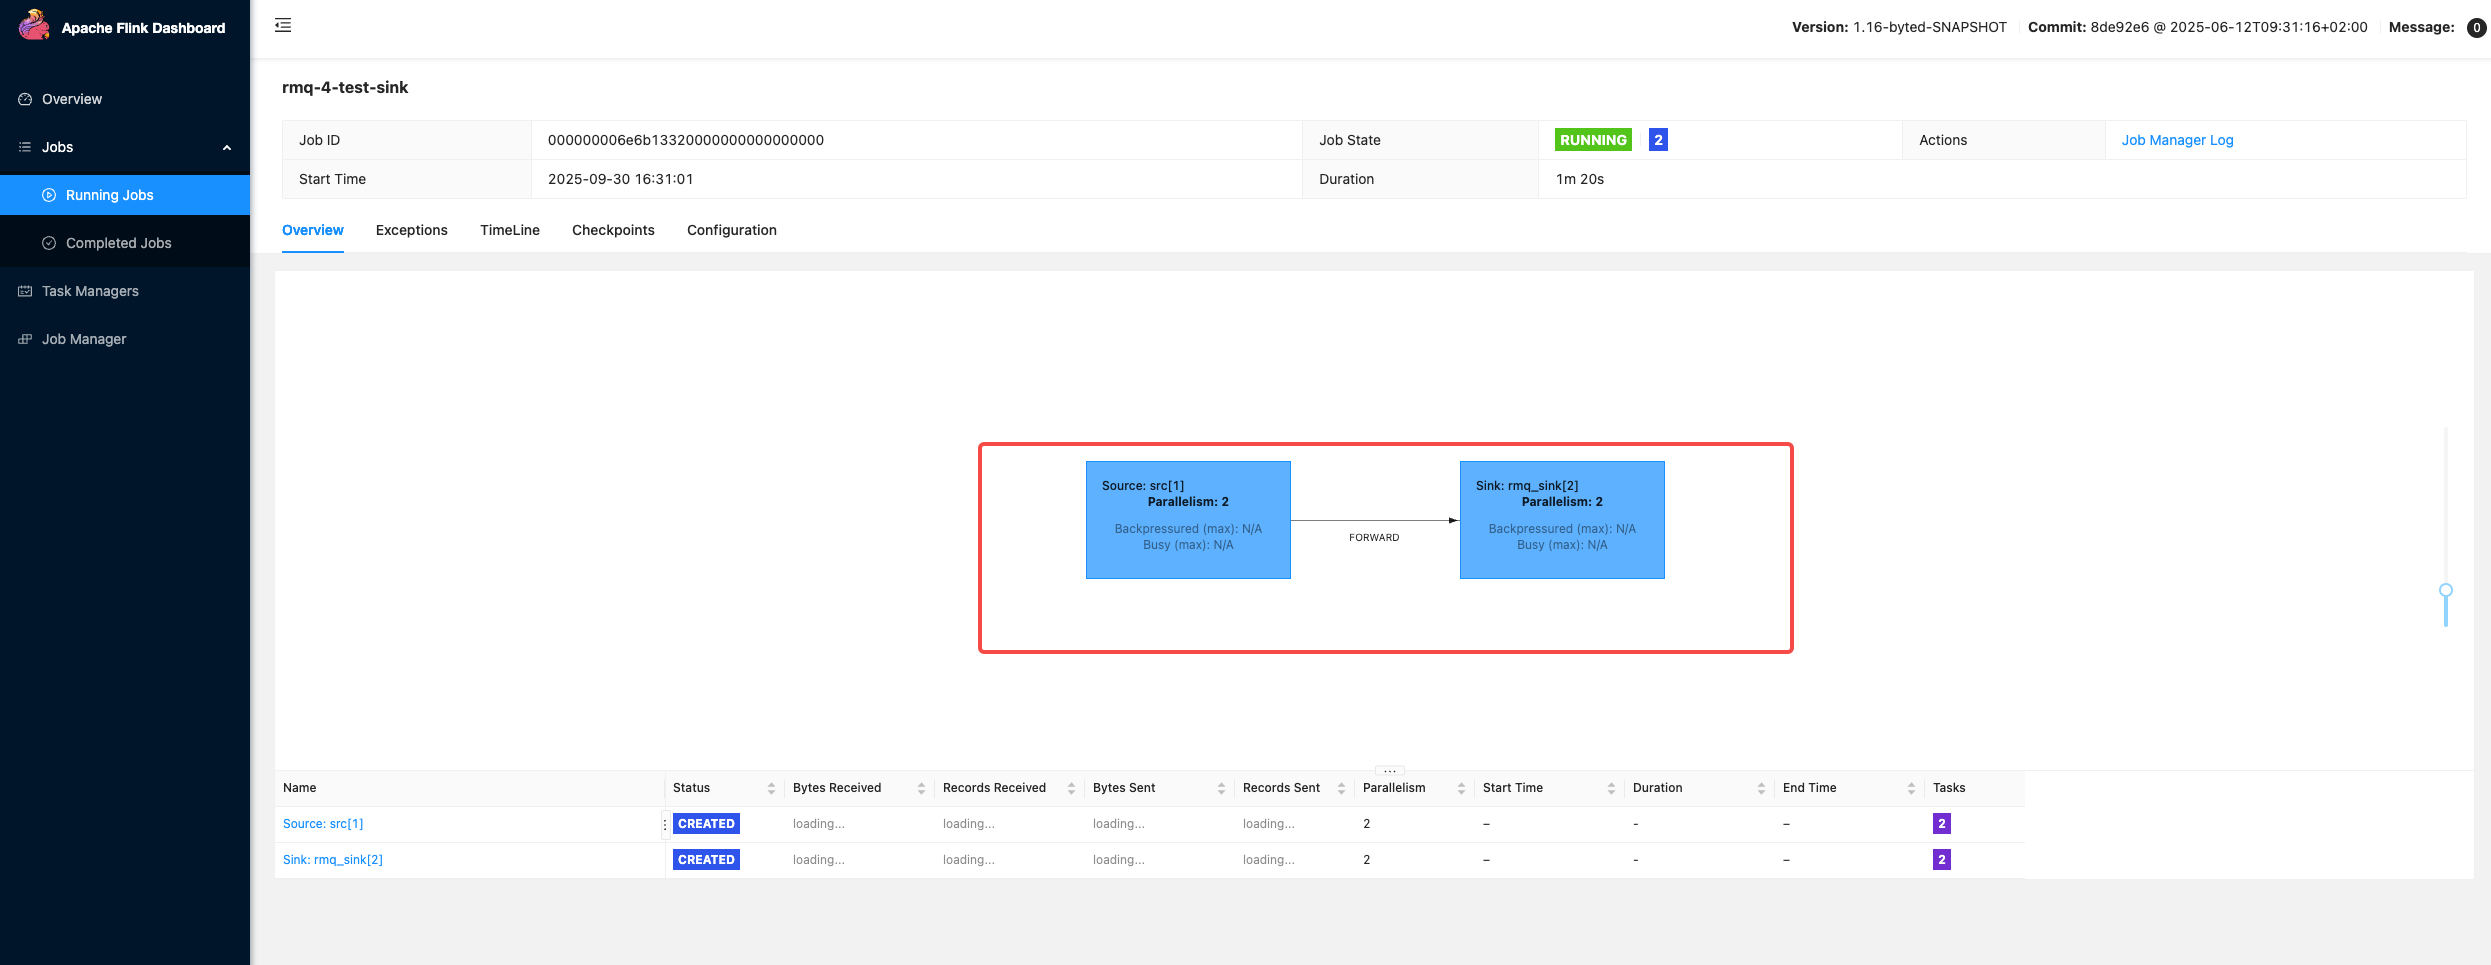
增加参数,重启后的任务 DAG 如下,可以看到原本 chain 在一起的 Operator 恢复成原始的样子:
3.2.3 注意事项
注意:禁用 Operator Chaining 建议只针对于调试场景使用,不建议对生产任务使用
- 参数会引起 DAG 的变化,会导致状态不兼容,无法从状态恢复
- 禁用算子链会导致流任务处理性能显著下降,谨慎使用
最近更新时间:2025.12.02 13:54:28
这个页面对您有帮助吗?
有用
有用
无用
无用