E-MapReduce
E-MapReduce


组件与 API 参考
请输入


CLI 参考
API 参考
EMR on ECS API参考
集群管理
节点组管理
用户管理
用户组管理
应用管理
EMR on VKE API参考
组件操作指南
Celeborn
DolphinScheduler
HBase
Hive
Iceberg
Knox
Lance
数据治理
生态与集成
最佳实践
Livy
MapReduce2
OpenLDAP
Phoenix
Proton
基础使用
高阶使用
Ranger
Ray
RayCluster 使用
Spark
StarRocks
数据湖分析
最佳实践
Tez
Daft
- 文档首页
 E-MapReduce组件操作指南Lance最佳实践使用 Lance 数据格式做多模态向量数据检索
 复制全文
 下载 pdf
使用 Lance 数据格式做多模态向量数据检索
 文档反馈
 问问助手
本文介绍如何利用 LanceDB 对存储在 Lance 中的多模数据进行向量检索。
数据集与安装包准备
本示例使用一个10万张图片的imagenet数据集为例。
- 下载数据集:
wget https://lance-poc.tos-cn-shanghai.volces.com/public/imagenet.tar
- 安装必要的Python包:
pip install daft pylance lancedb
通过 Daft 将图片转成 Lance 数据集
- 解压数据集:
tar -zxvf ./imagenet.tar
- 将解压数据上传到 TOS 路径下。
- 使用 Daft 引擎将 demo 数据集转换成 Lance 数据集:
import daft
from daft import col
from daft.datatype import DataType
import lance
from PIL import Image
from io import BytesIO
from daft.io import IOConfig, S3Config
ak = "your_ak"
sk = "your_sk"
endpoint = "https://tos-s3-cn-beijing.ivolces.com"
io_config =IOConfig (
s3 = S3Config(
endpoint_url = endpoint,
key_id = ak,
access_key= sk,
region_name="cn-beijing",
force_virtual_addressing=True,
verify_ssl=True,
)
)
IMAGE_DIR = "s3://your_bucket_name/image_original/"
OUTPUT_DATASET_PATH = "s3://your_bucket_name/new_converted_imagenet.lance"
def build_daft_dataframe(image_dir: str) -> daft.DataFrame:
pattern = f"{image_dir.rstrip('/')}/*.JPEG"
df = daft.from_glob_path(pattern, io_config=io_config)
# 直接通过 Daft 的 URL 模态下载二进制
df = df.with_column("image", df["path"].url.download(io_config=io_config))
# 显式设置为 binary 类型
df = df.with_column("image", col("image").cast(DataType.binary()))
# 可保留 path 以便调试;也可以只保留 image
df = df.select(df["path"], df["image"])
return df
def main():
df = build_daft_dataframe(IMAGE_DIR)
# 只有一个图片文件夹,直接覆盖或创建数据集
df.write_lance(OUTPUT_DATASET_PATH, io_config=io_config, mode="overwrite")
if __name__ == "__main__":
main()
使用 LanceDB 对数据集做 embedding
为支持后续基于向量的图片语义检索,我们需先将图片转化为向量化表示,该过程称为 embedding。实现 embedding 需依赖 embedding 模型,我们选择开源的 open-clip 模型。为了支持语义检索,我们选择同时支持图像编码器与文本编码器进行 embedding,且二者输出处于同一语义向量空间的多模态模型。
import lance
import lancedb
from lancedb.embeddings import EmbeddingFunctionConfig, EmbeddingFunctionRegistry
registry = EmbeddingFunctionRegistry.get_instance()
clip = registry.get("open-clip").create(device="cuda", batch_size=8192)
conf = EmbeddingFunctionConfig(source_column="image", vector_column="vector", function=clip)
storage_options = {
"access_key_id": "your_ak",
"secret_access_key": "your_sk",
"aws_endpoint": "https://{your_bucket_name}.tos-s3-cn-beijing.volces.com",
"virtual_hosted_style_request": "true"
}
uri = "s3://your_bucket_name/image_original/image_vector_demo/"
ds=lance.dataset("s3://your_bucket_name/image_original/image_vector_demo/imagenet.lance", storage_options=storage_options)
db = lancedb.connect(uri)
table = db.create_table("image_with_vector", data=ds, embedding_functions=[conf])
使用 LanceDB 对数据集进行语义检索
LanceDB 支持直接对 embedding 进行语义检索,不依赖创建向量索引。但在生产业务中,我们强烈建议先创建向量索引,然后再进行检索。
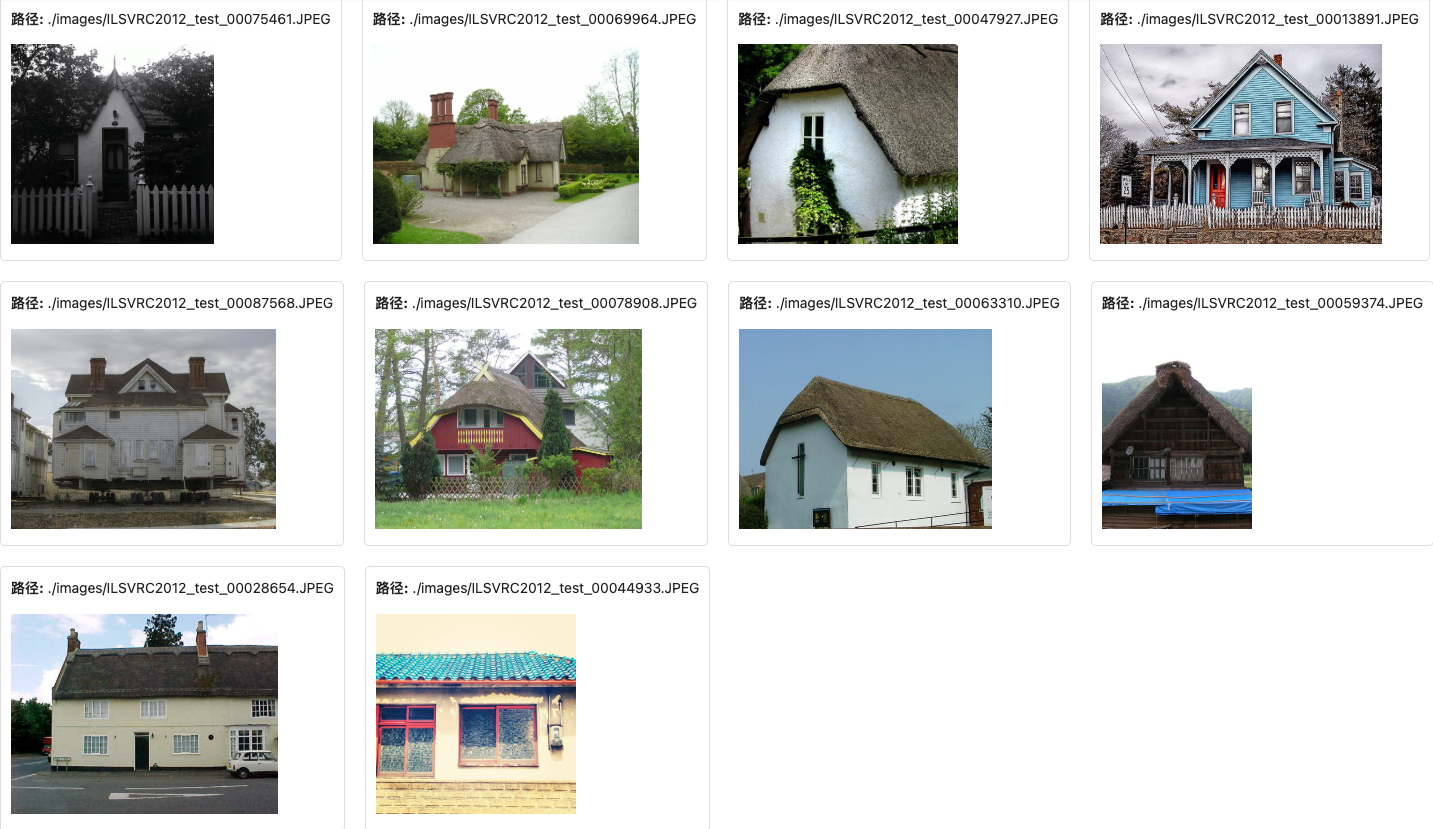
为了便于演示,这里我们使用 LanceDB 的语义检索 API,在日常使用时我们也可以直接使用 Pylance 进行检索,但需要先将用于检索的文本进行 embedding。如下是一个基于Jupyter 用 base64 解码后展示检索召回结果的代码段:
# tool for display binary
def display_subset_images(data):
html_output = "<div style='display:flex; flex-wrap:wrap; gap:20px;'>"
for idx, row in data.iterrows():
path = row["path"]
image_data = row["image"]
if isinstance(image_data, bytes):
b64_str = base64.b64encode(image_data).decode("utf-8")
else:
b64_str = image_data
html_output += f"""
<div style='border: 1px solid #ddd; padding: 10px; border-radius: 5px;'>
<p><b>路径:</b> {path}</p>
<img src='data:image/png;base64,{b64_str}'
style='max-width: 300px; max-height: 200px; object-fit: contain;'/>
</div>
"""
html_output += "</div>"
display(HTML(html_output))
result=table.search("a house").to_pandas()
display_subset_images(result)
展示效果如下所示:
最近更新时间:2025.12.24 18:46:16
这个页面对您有帮助吗?
有用
有用
无用
无用