GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践Kimi系列模型GPU-部署Kimi K2.5模型
 复制全文
 下载 pdf
GPU-部署Kimi K2.5模型
 文档反馈
 问问助手
本文以1台ecs.hpcpni3ln.45xlarge实例为例,介绍如何在GPU云服务器上部署、运行Kimi K2.5模型。
背景信息
Kimi K2.5
Kimi K2.5是一款基于万亿参数混合专家 (MoE)架构的多模态模型,拥有1T的总参数量以及32 B的激活参数。Kimi K2.5在视觉理解、工具使用、Agent集群协作和编码任务中表现卓越,同时升级了长上下文处理与双模式推理能力。了解更多。
软件要求
- NVIDIA驱动:
- GPU驱动:用来驱动NVIDIA GPU的程序。本文以535.161.08为例。
- 运行环境:
- SGLang框架:SGLang是一个用于大型语言模型和视觉语言模型的快速服务框架,本文以sglang:v0.5.8版本为例。
操作步骤
步骤一:准备环境
- 创建GPU计算型实例。
- 请根据通过向导购买实例指引,创建1台符合如下条件的实例:
-
- 安装依赖的软件、工具。
- 登录购买的实例。
- 执行如下命令,安装、配置Docker。
- sudo apt updatesudo apt install ca-certificates curl gnupg lsb-releasesudo mkdir -p /etc/apt/keyringscurl -fsSL https://mirrors.ivolces.com/docker/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://mirrors.ivolces.com/docker/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/nullsudo apt updatesudo apt install docker-ce docker-ce-cli containerd.io docker-compose-plugin -y
- 执行如下命令,安装NVIDIA Container Toolkit。
- curl -s https://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/3bf863cc.pub | sudo apt-key add -cat <<EOF >/etc/apt/sources.list.d/nvidia.listdeb http://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/ /EOFapt updateapt install nvidia-container-toolkit -y
- 执行如下命令配置Docker,使容器可以使用实例的GPU资源。
- sudo nvidia-ctk runtime configure --runtime=dockersudo systemctl restart docker
- (可选)初始化本地盘。
- 若您选用的实例规格搭配有本地盘,建议您执行如下命令将本地盘挂载到存储模型的目录“/data01”,提升模型加载速度。
- mkfs -t ext4 /dev/nvme0n1mount -t ext4 /dev/nvme0n1 /data01
说明
- 请将/dev/nvme0n1替换为实际本地盘名称。
- 请将ext4替换为您期望使用的文件系统。
步骤二:部署、运行模型
- 登录购买的实例。
- 执行如下命令,下载模型文件。
- 执行如下命令,安装配置onion。
- curl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | sudo gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu jammy main" > /etc/apt/sources.list.d/volctools.list && apt update && apt install -y onion-ai-data
- 执行如下命令,进入存放模型的目录。
- cd /data01
说明
建议您选择容量较大的磁盘目录存放模型文件,Kimi K2.5模型规模较大,请选择大于1TB的存储空间,本文以/data01为例,请将其替换为实际目录路径。
- 执行如下命令,通过onion工具下载Kimi K2.5模型。
- oniond download model Kimi-K2.5
- 请根据实例所在地域,执行如下命令,下载Docker镜像。
- docker pull ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.8.byted.202601292054docker pull ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.8.byted.202601292054
- 请根据实例所在地域,执行如下命令,启动Docker容器。
- docker run --gpus all -itd --net=host --shm-size=100g --ulimit memlock=-1 --ulimit stack=67108864 --privileged --ipc=host --security-opt seccomp=unconfined --cap-add=ALL -v /data01/:/data00/ -v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ --entrypoint /bin/bash ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.8.byted.202601292054docker run --gpus all -itd --net=host --shm-size=100g --ulimit memlock=-1 --ulimit stack=67108864 --privileged --ipc=host --security-opt seccomp=unconfined --cap-add=ALL -v /data01/:/data00/ -v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ --entrypoint /bin/bash ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.8.byted.202601292054
注意
请将/data01替换为模型实际存放目录路径。
- 执行如下命令,通过Docker日志确认容器及模型是否成功启动。
- 查看容器ID。
- docker ps
- 查看对应容器的运行日志。
- docker logs -f <CONTAINER_ID>
说明
请将<CONTAINER_ID>替换为实际容器ID。
- 启动模型服务。
- 执行如下命令,进入Docker容器。
- docker exec -it <CONTAINER_ID> bash
说明
请将<CONTAINER_ID>替换为实际容器ID。
- 执行如下命令,进入Python目录。
- cd /sgl-workspace/sglang
- 执行如下命令,启动模型服务。
- python3 -m sglang.launch_server --model-path /data00/Kimi-K2.5 --tp 8 --trust-remote-code --tool-call-parser kimi_k2 --reasoning-parser kimi_k2 --mem-fraction-static 0.8 --port 8080 --host 0.0.0.0 --max-running-requests 64
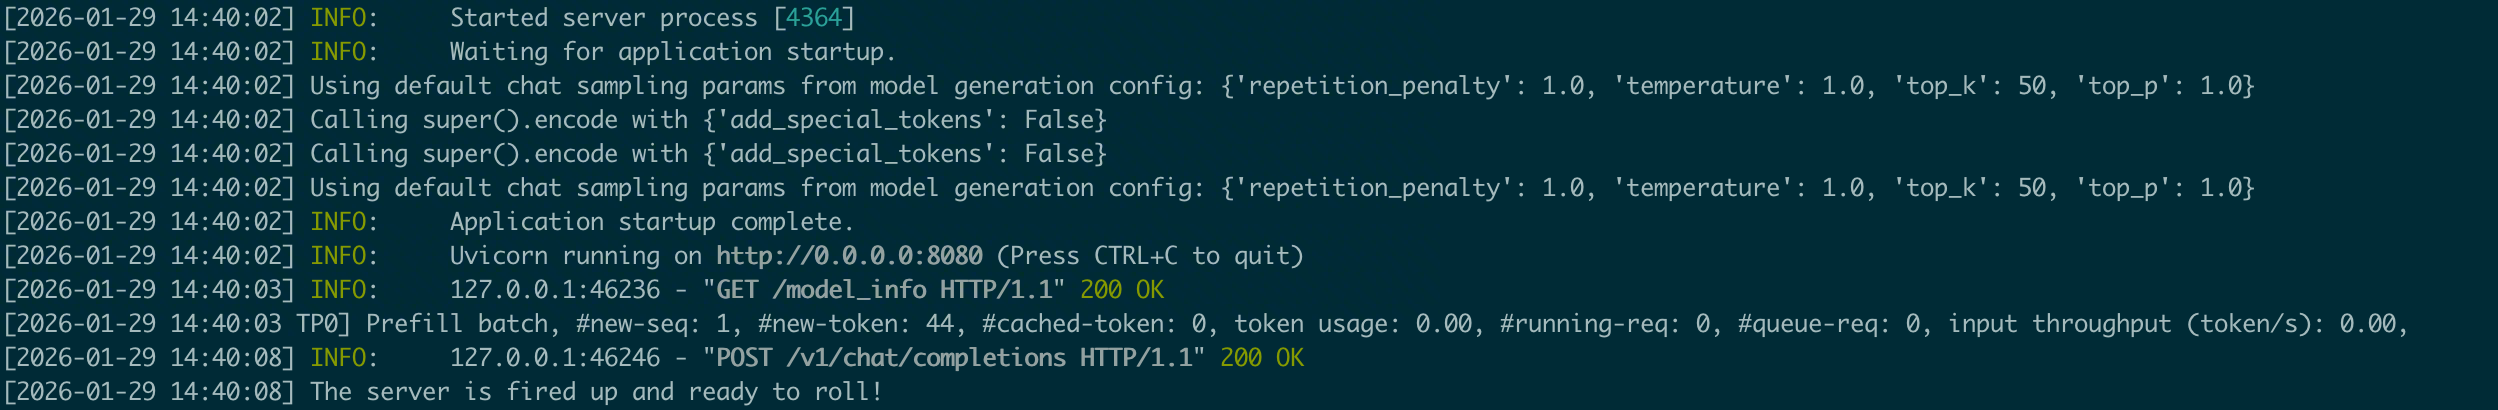
- 若回显中包含“The server is fired up and ready to roll”,表示服务已成功启动。
-
- 参数说明:
- 如上命令以部署、启动Kimi K2.5模型为例,如需部署、启动其他模型,可根据如下说明替换对应环境变量的参数值。
-
步骤三:调用模型
- 登录购买的实例。
- 执行如下命令调用模型,确保部署的模型可以正常进行推理。
- curl -X POST http://0.0.0.0:8080/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "/data00/Kimi-K2.5","messages": [{"role": "user","content": "请证明一下黎曼猜想"}],"max_tokens": 1000,"temperature": 0.7}'
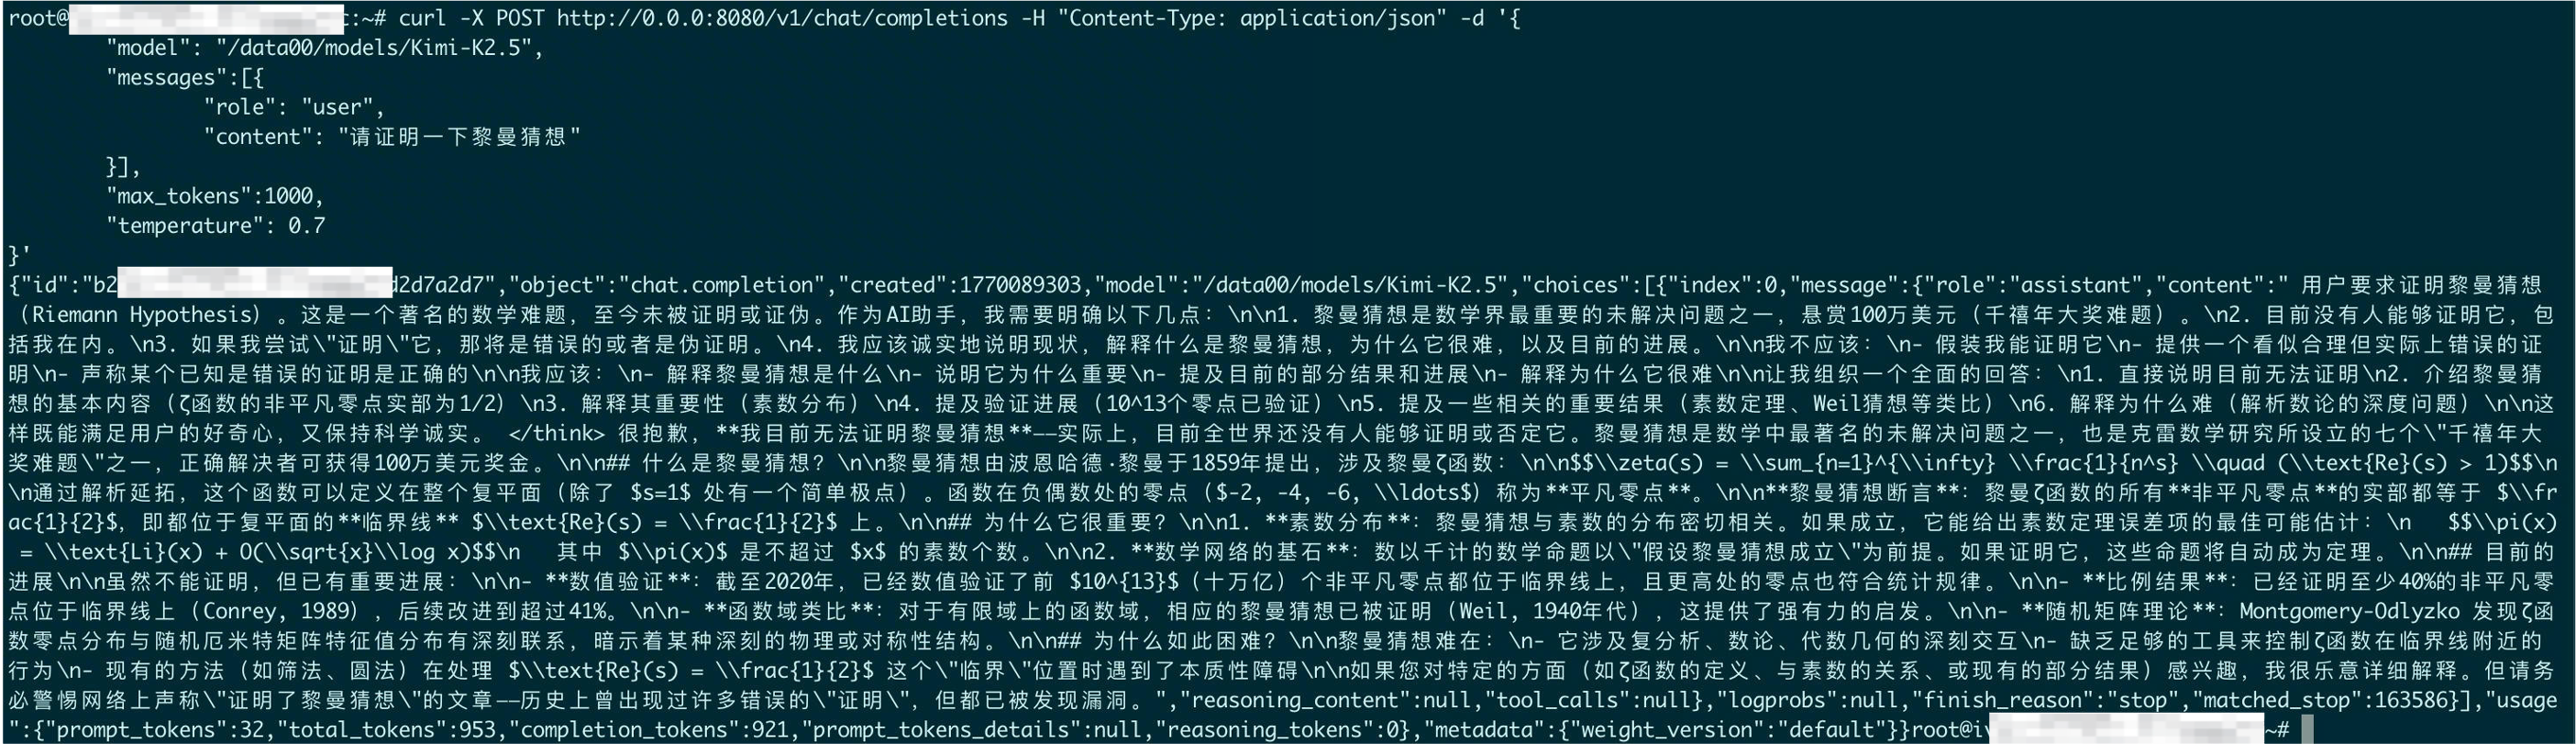
- 回显如下所示时,表示推理服务已正常运行。
-
- 参数说明:
- 本文仅说明验证使用到的参数信息,更多参数详情可查看Kimi K2.5。
-
-
最近更新时间:2026.06.23 16:25:17
这个页面对您有帮助吗?
有用
有用
无用
无用