增长分析 DataFinder
增长分析 DataFinder


- 文档首页
 增长分析 DataFinder开发者指南数据接入服务端接入Java SDKJava SDK 集成
 复制全文
 下载 pdf
 文档反馈
 问问助手
DataFinder为您提供服务端-Java SDK,用来简化服务端埋点的复杂度。通过使用SDK,您可以仅仅关注埋点方案而不需要关注具体的上报细节。本文为您介绍Java SDK的集成流程和埋点配置示例。
下图为您概要介绍 SDK 集成相关文档的组织思路,您可参考以下导读示意图了解文档结构,查阅对应文档完成 集成操作。
步骤1(可选):创建埋点需求/录入自定义埋点
完成埋点规划后,建议您根据规划将埋点需求创建再 DataFinder 的需求管理页面,并将自定义埋点先录入 DataFinder 完成自定义埋点在 DataFinder 元数据的入库。
- 埋点需求管理:您可以通过 DataFinder 的埋点需求管理功能来管理埋点需求,后续可在埋点需求管理页面中持续维护和管理需求,提高管理效率。创建埋点需求管理的操作请参见需求管理。
- 自定义埋点录入:您可以根据埋点规划,先将自定义埋点创建录入至 DataFinder 的元数据,操作详情请参见新增事件、新增事件属性、新增用户属性。
步骤2:获取APPID/APP Key
进行SDK集成前,您需要先获取在DataFinder上创建应用时,DataFinder生成的应用标识(APPID 或 APP Key),用于后续SDK集成时配置。
在开始集成前,首先需要在集团中拥有一个应用,进行 SDK 集成前,您需要获取对应应用的 appid 信息。
SaaS-云原生场景下,您可以在「项目中心」->「项目管理」->「项目详情」-> 接入应用的「详情」->「应用 ID」中可查看您的 appid,详情请参见项目管理。
SaaS-非云原生场景下,您可以在「应用列表」-> 接入应用的「详情」->「应用 ID」中可查看您的 appid,详情请参见应用列表。
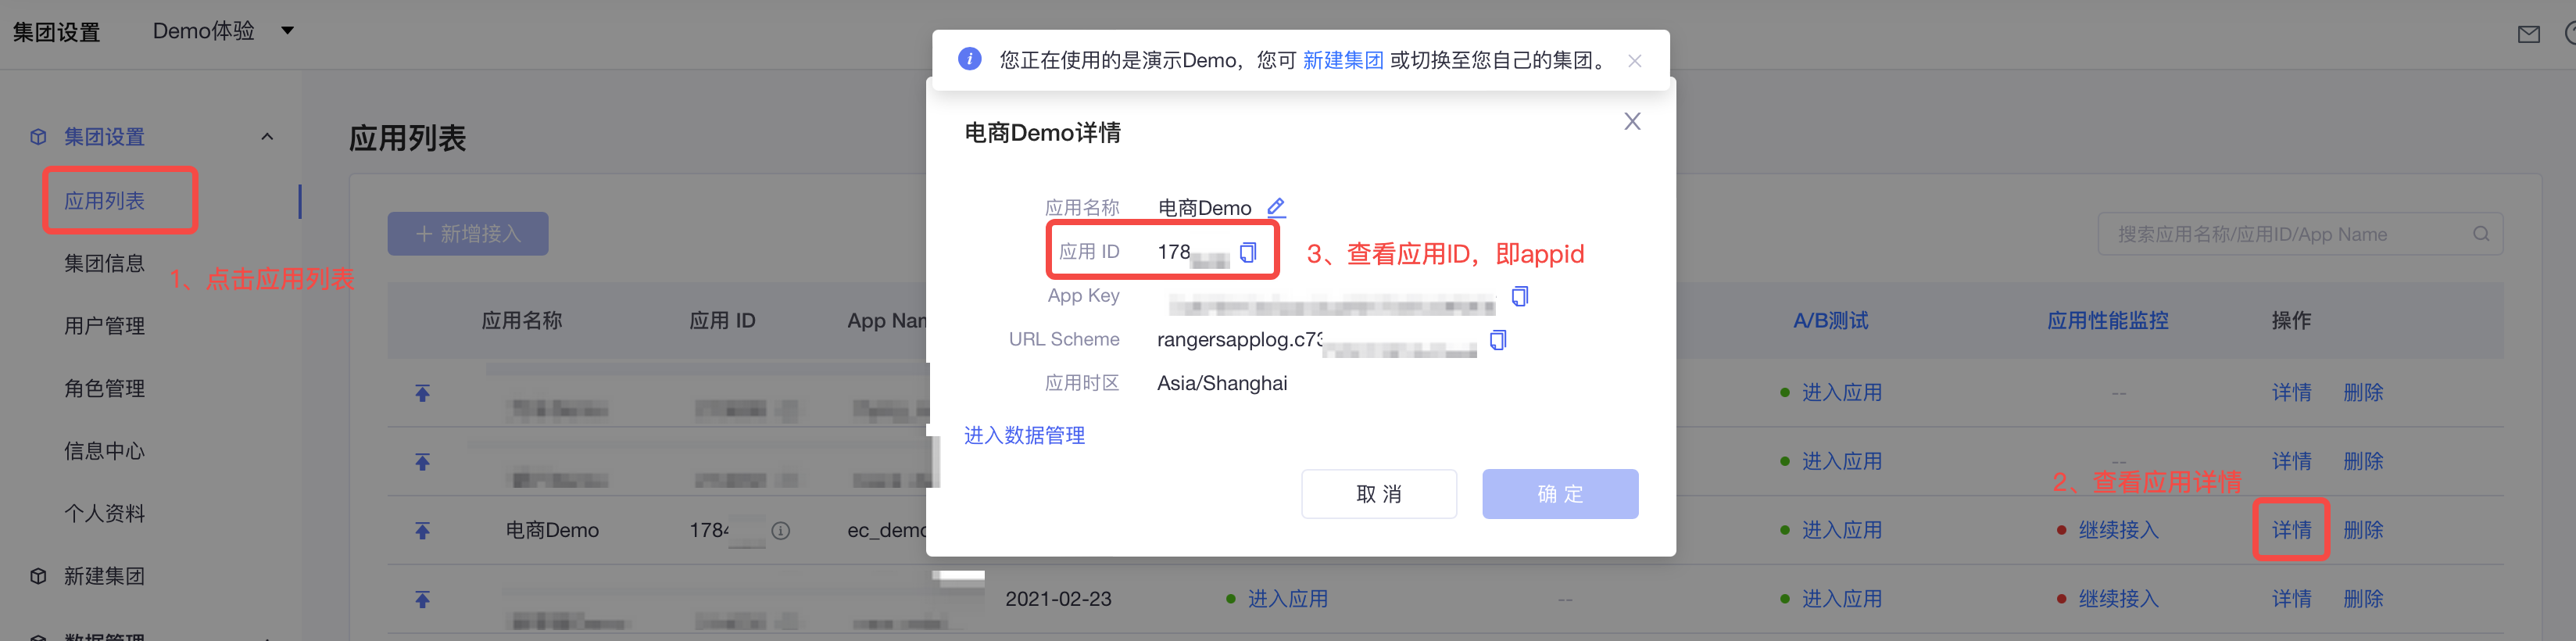
私有化场景,同SaaS-云原生场景
步骤3:获取数据上送地址
进行数据接入上报时,您需要根据当前的环境类型和端类型确认您的数据上报地址,如果上报地址设置错误,后续会导致您无法查询到上报的数据。
注意
- 请在上报数据前,务必确认您当前使用的环境类型,根据环境类型配置上报地址。查看当前的环境类型请参见SaaS云原生/非云原生&私有化环境。
- 如果您使用的是 SaaS-云原生环境,您也需确认您的服务所在的地域,根据所在地域配置上报地址(通常您的服务会在华北2-北京地域,部分用户可能会使用其他地域)。SaaS-云原生用户查看服务所在地域请参见支持的地域。
SaaS-云原生 & SaaS-非云原生
SaaS-云原生环境 | SaaS-云原生环境 | SaaS-非云原生环境 国内环境 | SaaS-非云原生 海外BytePlus环境 |
|---|---|---|---|
https://gator.volces.com
https://gator.uba.cn-guangzhou.volces.com | https://gator.uba.ap-southeast-1.volces.com |
|
|
私有化环境
私有化部署场景下,您需要获取部署私有化环境时,自行规划配置的数据上送地址。如您不清楚此地址,请联系您的项目经理或客户成功经理。
了解上报模式
增长分析的 SDK 支持多种上报模式:HTTP、KAFKA,您可按需选择使用合适的模式,对比介绍如下。
对比项 | HTTP模式 | KAFKA模式 |
|---|---|---|
支持的环境类型 |
|
|
部署复杂性 | 简单 | 简单 |
可靠性 | 高 | 很高 |
上报性能 | 高,支持批量上报。 | 高 |
版本要求 |
|
|
适用场景 |
| 集成SDK的服务和finder在同一个网络时,建议使用该模式。 |
总结 |
| |
查看示例 Demo
前往Git查看示例demo:示例代码。示例说明如下:
核心示例说明 | 核心方式示例 |
|---|---|
|
|
step1:添加依赖
获取SDK最新版本
建议您集成最新版本的SDK。当前SDK已经开源,您可前往Git仓库获取最新版本SDK:github开源仓库。
添加依赖方式1:maven 依赖
需要先在maven的settings中配置火山引擎仓库地址:
<repositories>
  <repository>
    <id>bytedance-volcengine</id>
    <name>bytedance Volcengine</name>
    <url>https://artifact.bytedance.com/repository/Volcengine/</url>
  </repository>
</repositories>
说明
- 以上的url:
https://artifact.bytedance.com/repository/Volcengine/可直接用于maven配置,不支持直接浏览器打开访问。 - 如果您希望通过浏览器查看完整仓库,可使用浏览器打开包含子目录的url:
https://artifact.bytedance.com/repository/Volcengine/com/datarangers/。
然后就可以正常配置依赖了:
<dependency>

  <groupId>com.datarangers</groupId>

  <artifactId>datarangers-sdk-core</artifactId>

//建议使用最新版本,配置示例:1.5.13-release。 (注意-release也是版本的一部分)
  <version>{version}</version>

</dependency>
我们提供了一个封装完成的的starter包,您可以在pom中通过如下方式引入:
<dependency>

   <groupId>com.datarangers</groupId>

   <artifactId>datarangers-sdk-starter</artifactId>

   //建议使用最新版本,配置示例:1.5.13-release。 (注意-release也是版本的一部分)
   <version>{version}</version>

</dependency>
添加依赖方式2:离线依赖
如果您无法访问火山的maven仓库,或者没有jar包管理工具,可以从 github 下载离线包,或者自行build离线包: mvn package -DskipTests ,相关的jar所在路径为:
datarangers-sdk-core/target/datarangers-sdk-core-{version}-release-jar-with-dependencies.jardatarangers-sdk-starter/target/datarangers-sdk-starter-{version}-release-jar-with-dependencies.jar
step2:初始化 SDK
Java的开发框架通常由SpringBoot框架(推荐)、Spring容器化、普通Java程序,三种方式的代码结构有差异,但是初始化的配置参数一致,示例介绍如下。
HTTP
- HTTP模式部署简单、可靠性高,还支持批量上报,因此推荐除同一个网络场景下推荐使用KAFKA模式上报外,其他场景推荐使用 HTTP 的方式。
- 使用HTTP模式时,sdk版本需要 >= 1.5.7。
- 使用HTTP模式时,初始化SDK时,通过
datarangers.sdk.mode参数来指定当前使用哪种模式上报数据,datarangers.sdk.mode=http表示使用HTTP模式。
以下为您介绍不同环境下使用HTTP模式的示例和配置参数说明。
SAAS-云原生
推荐使用配置的方式进行初始化,在properties或者yml配置相关参数,然后引用bean去上报,配置样例如下。
# 设置环境信息
datarangers.sdk.env=saas_native
# 配置上报模式
datarangers.sdk.mode=http

# [domain]
# 服务器ip或域名
datarangers.sdk.domain=https://gator.****.com

# [app key]
datarangers.sdk.appKeys.20000000=xxxxxxxx
核心配置参数说明如下,更多全量配置参数请参见参考:Java SDK 全量配置项说明。
参数 | 类型 | 是否必选 | 配置说明 |
|---|---|---|---|
datarangers.sdk.env | string | 是 | 配置为:saas_native,表示当前使用的DataFinder环境为SaaS-云原生环境。 |
datarangers.sdk.mode | string | 是 | 配置为:http,表示使用http模式上报数据。 |
datarangers.sdk.domain | string | 是 | 配置为DataFinder为您提供的SaaS-云原生环境的数据上报地址,详细地址请参见上文的步骤3:获取数据上送地址章节。 |
datarangers.sdk.appKeys | map | 是 | 配置上报数据应用的appid和appkey。配置格式例如
app_id和app_key可参考上文步骤2:获取APPID/APP Key章节进行获取。 |
SaaS-非云原生
以使用配置的方式进行初始化配置为例,SaaS-非云原生场景下的application.properties样例:
# SaaS-非云原生版 配置example
datarangers.sdk.env=saas
datarangers.sdk.mode=http

# [domain]
# 服务器ip或域名
# SaaS-非云原生版版本国内站
datarangers.sdk.domain=https://mcs.****.com
# SaaS-非云原生版版本国际站
#datarangers.sdk.domain=https://mcs.****.com

# [app key]
datarangers.sdk.appKeys. ${SDK_APP_1}= ${SDK_APP_KEY_1}

# [openapi]
# openapi的domain
# SaaS-非云原生版版国内站
datarangers.sdk.openapiConfig.domain=https://analytics.volcengineapi.com
# SaaS-非云原生版版国际站
#datarangers.sdk.openapiConfig.domain=https://analytics.byteplusapi.com

# openapi的ak, sk
datarangers.sdk.openapiConfig.ak= ${OPENAPI_AK}
datarangers.sdk.openapiConfig.sk= ${OPENAPI_SK}
核心配置参数说明如下,更多全量配置参数请参见参考:Java SDK 全量配置项说明。
参数 | 类型 | 是否必选 | 配置说明 |
|---|---|---|---|
datarangers.sdk.env | string | 是 | 配置为:saas_native,表示当前使用的DataFinder环境为SaaS-云原生环境。 |
datarangers.sdk.mode | string | 是 | 配置为:http,表示使用http模式上报数据。 |
datarangers.sdk.domain | string | 是 | 配置为DataFinder为您提供的SaaS-非云原生环境的数据上报地址,详细地址请参见上文的步骤3:获取数据上送地址章节。 |
datarangers.sdk.appKeys | map | 是 | 配置上报数据应用的appid和appkey。配置格式例如
app_id和app_key可参考上文步骤2:获取APPID/APP Key章节进行获取。 |
datarangers.sdk.openapiConfig.domain | string | 是 | openapi的地址,saas-非云原生必须配置,各个环境的地址链接详情请参见上文的 获取数据上送地址 章节。 |
datarangers.sdk.openapiConfig.ak | string | 是 | openapi的ak, 请联系客户经理获取。 |
datarangers.sdk.openapiConfig.sk | string | 是 | openapi的sk ,请联系客户经理获取。 |
私有化
以使用配置的方式进行初始化配置为例,私有化场景下的application.properties样例:
# 私有化配置example
# 使用 http 上报模式
datarangers.sdk.mode=http
# sdk 上报地址,以http:// 或者 https:// 开头
datarangers.sdk.domain= ${SDK_DOMAIN}

#异步线程数量,当并发不够的时候可以调整该数据
#datarangers.sdk.threadCount=20

#[http config]
# 单位是毫秒
#datarangers.sdk.httpConfig.requestTimeout=10000
#datarangers.sdk.httpConfig.connectTimeout=10000
#datarangers.sdk.httpConfig.socketTimeout=20000

# 单位是s
#datarangers.sdk.httpConfig.keepAliveTimeout=30

# [batch]
# 使用 batch 的方式
# datarangers.sdk.sendBatch=false
# 批量的数量
#datarangers.sdk.batchSize=20
#datarangers.sdk.waitTimeMs=100
核心配置参数说明如下,更多全量配置参数请参见参考:Java SDK 全量配置项说明。
参数 | 类型 | 是否必选 | 配置说明 |
|---|---|---|---|
datarangers.sdk.env | string | 否 | privatization,表示私有化环境。在私有化环境中,您可无需手动修改此参数,SDK能自动识别您当前的环境为私有化。 |
datarangers.sdk.mode | string | 是 | http,表示http模式 |
datarangers.sdk.domain | string | 是 | 数据上报地址,私有化环境的数据上报地址为自行规划配置的数据上送地址。如您不清楚此地址,请联系您的项目经理或客户成功经理。 |
KAFKA模式(仅私有化)
- KAFKA模式模式部署简单、可靠性高、上报数据的性能好,因此私有化场景下,集成SDK的服务和DataFinder在同一个网络时,建议使用该模式。
- 该模式只在私有化支持。
- 初始化SDK时,通过
datarangers.sdk.mode参数来指定当前使用哪种模式上报数据,atarangers.sdk.mode=kafka表示使用KAFKA模式。
以使用配置的方式进行初始化配置为例,私有化场景下的application.properties样例:
# 私有化配置example
# 使用kafka上报的模式
datarangers.sdk.mode=kafka
datarangers.sdk.kafka.bootstrapServers={ip1}:9192,{ip2}:9192

# kafka producer的 properties可以在这里进行配置
#datarangers.sdk.kafka.properties.retries=3
注意:如果property的key包含 . 特殊字符,需要用[]包括起来,比如:
properties:
# 使用kafka上报的模式
datarangers.sdk.mode=kafka
datarangers.sdk.kafka.bootstrapServers={ip1}:9192,{ip2}:9192

# kafka producer的 properties可以在这里进行配置
#datarangers.sdk.kafka.properties.retries=3
datarangers.sdk.kafka.properties."[sasl.mechanisms]"=PLAIN
datarangers.sdk.kafka.properties."[security.protocol]"=SASL_PLAINTEXT
datarangers.sdk.kafka.properties."[sasl.jaas.config]"=;
datarangers.sdk.kafka.properties."[sasl.kerberos.service.name]"=kafka
yml:
datarangers:
 sdk:
   mode: kafka
   kafka:
    bootstrapServers: {ip1}:9192,{ip2}:9192
    properties:
      "[sasl.mechanism]": GSSAPI
      "[security.protocol]": SASL_PLAINTEXT
      "[sasl.jaas.config]": ''
      "[sasl.kerberos.service.name]": kafka
核心配置参数说明如下,更多全量配置参数请参见参考:Java SDK 全量配置项说明。
参数 | 类型 | 是否必选 | 示例值 |
|---|---|---|---|
datarangers.sdk.env | string | 否 | privatization,表示私有化环境。在私有化环境中,您可无需手动修改此参数,SDK能自动识别您当前的环境为私有化。 |
datarangers.sdk.mode | string | 是 | kafka,表示Kafka模式 |
datarangers.sdk.kafka.bootstrapServers | string | 是 | kafka的bootstrapServers 地址: |
datarangers.sdk.kafka.properties | map | 否 | 其他kafka参数配置,可以使用 |
验证集成配置
查看启动日志
启动会打印如下日志,可以通过监测启动日志来确定配置是否符合预期。主要关注下env、sdkMode、domain等配置。
sdk config properties:
enable: true
env: PRIVATIZATION
sync: false
sdkMode: HTTP
domain: ...
headers: {...}
threadCount: 20
queueSize: 10240
sendBatch: false
batchSize: 20
waitTimeMs: 100
httpConfig: {...}
eventSavePath: logs/
eventSaveName: datarangers.log
eventFilePaths: [logs/]
eventSaveMaxFileSize: 100
eventSaveMaxDays: -1
openapiConfig: {...}
kafka: null
HTTP 模式 Debug 验证
- 查看配置或自动日志,确定配置的
sdkMode为HTTP,同时检查:- 检查datarangers.log文件是否存在数据,有埋点数据就属于异常(因为HTTP模式下,该文件不会有数据),请检查设置的sdkMode生效值。
- 检查error-datarangers.log文件,如果存在数据,请检查错误信息
- Debug验证请求/响应报文
如果通过日志无法确定是什么异常,可以用debug来看下详细的报错信息,Debug断点HttpUtils类167行(不同版本可能行数有所差异,但逻辑都是获取请求和响应报文),以下截图为1.5.3版本。- resustStr为响应报文,其中如果e不为0,说明上报失败了,反之表示成功上报。
- body为请求报文,如果响应报文了解到报错,可以获取下来看看数据格式是否正确。
HTTP 模式 curl 验证
可以使用 curl 命令,查看是否能正常上报。以下为各个环境的验证示例。
注意
您需修改脚本中的 local_time_ms 和 datetime 字段为当前时间。
SaaS-云原生环境
appkey 需要替换成相应的配置。
curl --location --request POST 'https://gator.volces.com/sdk/log' \
--header 'User-Agent: DataRangers Java SDK' \
--header 'X-MCS-AppKey:  \${AppKey}' \
--header 'Content-Type: application/json' \
--data '{
    "app_type": "app",
    "_format_name": "datarangers_svc_app_log_v3_server_sdk_1.2.7",
    "header": {
        "custom": {
            "client": "fdaf",
            "__sdk_platform": "datarangers_sdk"
        },
        "device_id": 0,
        "timezone": 8,
        "tz_offset": 28800,
        "tz_name": "Asia/Shanghai",
        "user_unique_id": "test_sdk_user"
    },
    "user_unique_id": "xxxx",
    "event_v3": [
        {
            "event": "补贴查询",
            "params": {
                "cardNum": "cardNum",
                "year": "2021"
            },
            "local_time_ms": 1637734994778,
            "datetime": "2021-12-15 14:23:14"
        }
    ]
}'
如下返回表示上报成功:
{
    "e":0,
    "magic_tag":"server_sdk_log",
    "message":"success",
    "server_time":1664352669
}
SaaS-非云原生 环境
appkey 需要替换成相应的配置。
curl --location --request POST 'https://mcs.ctobsnssdk.com/v2/event/json' \
--header 'X-MCS-AppKey: ${AppKey}' \
--header 'Content-Type: application/json' \
--data-raw '{
    "user": {
        "user_unique_id": "test_sdk_user"
    },
    "header": {
        "custom": {
            "__sdk_platform": "datarangers_sdk_1.4.9-release"
        },
        "device_id": 0,
        "timezone": 8,
        "tz_offset": 28800,
        "tz_name": "Asia/Shanghai",
        "user_unique_id": "10.1.6.229"
    },
    "events": [
        {
            "event": "enterprise_search",
            "params": "{\"date_time\":\"20220803 15:19:56\",\"operateType\":9,\"moduleName\":\"\",\"productType\":0}",
            "local_time_ms": 1659511196363,
            "datetime": "2022-08-03 15:19:56"
        }
    ]
}'
如下返回表示成功:
{
    "e": 0,
    "message": "success",
    "sc": 1
}
私有化环境
domain 替换成相应的配置, app_id 也要修改成相应的配置。
curl --location --request POST '${domain}/sdk/log' \
--header 'User-Agent: DataRangers Java SDK' \
--header 'Content-Type: application/json' \
--data '{
    "app_type": "app",
    "_format_name": "datarangers_svc_app_log_v3_server_sdk_1.2.7",
    "app_id": 10000000,
    "header": {
        "custom": {
            "client": "fdaf",
            "__sdk_platform": "datarangers_sdk"
        },
        "device_id": 0,
        "timezone": 8,
        "tz_offset": 28800,
        "tz_name": "Asia/Shanghai",
        "user_unique_id": "test_sdk_user",
        "app_id": 10000000
    },
    "user_unique_id": "xxxx",
    "event_v3": [
        {
            "event": "补贴查询",
            "params": {
                "cardNum": "cardNum",
                "year": "2021"
            },
            "local_time_ms": 1637734994778,
            "datetime": "2021-12-15 14:23:14"
        }
    ]
}'
如下返回表示上报成功:
{
    "e":0,
    "magic_tag":"server_sdk_log",
    "message":"success",
    "server_time":1664352669
}
KAFKA 模式 (只支持私有化)
查看kafka topic: sdk_origin_event 是否有数据上来,kafka 的使用方式参考文档:Kafka订阅(私有化) 增长分析-火山引擎。
注意事项
当前SaaS云原生/私有化和SaaS-非云原生场景下,在用户属性、Item属性等上报场景下的上报方式不完全一致,您需根据实际使用的环境情况,先了解下对应环境的数据上报注意事项。
细分 | SaaS-云原生/私有化 | SaaS-非云原生 |
|---|---|---|
普通事件属性 | 调用sendEvent即可,通过sendEvent中的参数来灵活设置上报的事件属性的属性类型等参数。 | |
用户属性 |
| SaaS-非云原生场景下,您需要先在系统中创建之后再上报,参考:User Profile API(SaaS查看)。 |
Item属性 | Item属性需要先在系统中创建之后再上报。当前支持的上报方式有:
更多关于业务维度接入的指导请参见业务维度(item)数据接入使用实践。 |
更多关于业务维度接入的指导请参见业务维度(item)数据接入使用实践。 |
发送普通事件
调用Java SDK的sendEvent API 即可上报事件,示例如下。
@Resource(name = "appEventCollector")
private EventCollector appEventCollector;

appEventCollector.sendEvent("uuid2", 10000000, null, "test_event_java_sdk", new HashMap<String, Object>() {{
    put("date_time", LocalDateTime.now().format(DateTimeFormatter.ofPattern("yyyyMMdd")));
    put("current_time", LocalDateTime.now().format(DateTimeFormatter.ofPattern("yyyyMMdd HH:mm:ss")));
}});
- 以上为一个上报示例,
sendEventAPI 有多个接口定义,可灵活的配置上报事件,详情请参见sendEvent 。 - 如果您希望批量上报事件,可使用
sendEventsAPI,详情请参见sendEvents。
设置用户属性
用户属性需要先在系统中创建之后再上报,上报时您可调用Java SDK的用户属性设置相关API设置用户属性,示例如下。
eventCollector.profileSet("uuid-1", 10000028, new HashMap<String, Object>() {{
    put("profile_1", "param_1");
    put("profile_2", "param_2");
    put("profile_3", "param_3");
    put("profile_4", "param_4");
}});
- 更多用户属性设置的API详情请参见用户属性相关接口。
设置Item属性
Item属性需要先在系统中创建之后再上报。业务对象内置的id属性,对应的字段名称为item_id,因此不需要再定义一个 id 属性。
注意
如果创建业务对象(Item)时,业务对象名(属性名)使用驼峰方式命名,在使用Java SDK上报时会自动转换为下划线格式。例如,您创建的业务对象名为FirstName,数据上报后会转换为First_Name。如果您希望保留驼峰格式,可改用HTTP API方式上报数据。
以下为设置Item属性的示例。
List<Item> items = new ArrayList<>();
items.add(new BookItem("1000", "book").setName("Java").setPrice(100).setPublishDate(LocalDate.now()).setAuthors(author).setCategory("computer"));
items.add(new BookItem("1002", "book").setName("PHP").setPrice(100).setPublishDate(LocalDate.now()).setAuthors(author).setCategory("computer"));
eventCollector.itemSet(10000028, "book", items);
- 更多Item属性设置的API详情请参见业务对象相关接口。
发送携带item的事件
List<Item> items = new ArrayList<>();
items.add(new BookItem("1000", "book"));
items.add(new BookItem("1002", "book"));
items.add(new PhoneItem("1002", "phone"));
eventCollector.sendEvent("user-001", 10000028, null, "set_items", new HashMap<String, Object>() {{
    put("param1", "params");
    put("param2", items.get(0));
    put("param3", items.get(1));
    put("param4", items.get(2));
}});
上报匿名用户事件
如果需要使用服务端的方式上报匿名用户事件信息,需要把 user_unique_id 的值置为 ""(空字符串),然后设置其他能关联上的设备信息,比如device_id、web_id、anonymousId。如果用户登录之后,能拿到user_unique_id,并且希望登录实名之后的行为能跟匿名之前的行为关联起来,那么在设置正确的user_unique_id之后,还需要带上匿名的时候设置的 device_id、web_id 或 anonymousId。
使用 device_id/web_id 上报匿名用户事件
当使用appEventCollector上报时,deviceId即为device_id,当使用webEventCollector、mpEventCollector上报时,deviceId 即为web_id。
Map<String, Object> eventParams = new HashMap<>();
eventParams.put("date_time", new SimpleDateFormat("yyyyMMdd").format(new Date()));
eventParams.put("event_param1", "value1");

// app/web/mp 这里都是deviceId 即可
Long deviceId = 10000L;
Header header = new HeaderV3.Builder()
        .setAppId(appId)
        .setDeviceId(deviceId)
        .setUserUniqueId("")
        .build();

// app/web/mp 使用不同的 EventCollector
// app
appEventCollector.sendEvent(header,"test_app_event_anonymous", eventParams, System.currentTimeMillis());

// 实名之后,关联匿名的行为, u1 会关联上之前设置的匿名用户行为(根据 deviceId 进行关联)
Header header2 = new HeaderV3.Builder()
        .setAppId(appId)
        .setDeviceId(deviceId)
        .setUserUniqueId("u1")
        .build();
appEventCollector.sendEvent(header2,"test_app_event_anonymous", eventParams, System.currentTimeMillis());

// web
webEventCollector.sendEvent(header,"test_web_event_anonymous", eventParams, System.currentTimeMillis());

// mp
mpEventCollector.sendEvent(header,"test_mp_event_anonymous", eventParams, System.currentTimeMillis());
使用 anonymousId 上报匿名用户事件
用户 device_id/web_id 都是long型,如果用户的自定义匿名ID是string的话,device_id/web_id无法满足,可以使用 anonymousId 这个string类型的字段来进行上报。
anonymousId 只支持web/mp,即要使用webEventCollector或者mpEventCollector来进行上报。
Map<String, Object> eventParams = new HashMap<>();
eventParams.put("date_time", new SimpleDateFormat("yyyyMMdd").format(new Date()));
eventParams.put("event_param1", "value1");

String anonymousId="test_anonymousId1";
Header header = new HeaderV3.Builder()
        .setAppId(appId)
        .setAnonymousId(anonymousId)
        .setUserUniqueId("")
        .build();
// web
webEventCollector.sendEvent(header,"test_web_event_anonymous", eventParams, System.currentTimeMillis());

// 实名之后,关联匿名的行为, u1 会关联上之前设置的匿名用户行为(根据 anonymousId 进行关联)
Header header2 = new HeaderV3.Builder()
        .setAppId(appId)
        .setAnonymousId(anonymousId)
        .setUserUniqueId("u1")
        .build();
webEventCollector.sendEvent(header2,"test_web_event_anonymous", eventParams, System.currentTimeMillis());

// mp
mpEventCollector.sendEvent(header,"test_mp_event_anonymous", eventParams, System.currentTimeMillis());
上报历史数据
注意:【SaaS-非云原生版本】历史数据导入需要隔天才能查看,【SaaS-云原生】、【私有化】版本可实时查看
如果数据的客户端时间超过七天,正常情况下无法导入,如需导入历史数据,需在header的custom字段中增加历史数据的标识__is_history,属性值设置为字符串"true"。
代码样例如下:
appEventCollector.sendEvent(userUniqueId, appId, new HashMap<String, Object>() {{
                    put("__is_history","true");
                }}, "test_event",
                new HashMap<String, Object>() {{
                    put("date_time", new SimpleDateFormat("yyyyMMdd").format(new Date()));
                    put("current_time",
                            new SimpleDateFormat("yyyyMMdd HH:mm:ss").format(new Date()));
                }},
                1637734994778);
先验证元数据,然后再在行为细查中去查看。
验证事件
事件发送成功之后,如果是第一次在新事件上报,最长可能需要等5分钟才能查看到。先检查元数据是否正常:
- 在“数据管理”>“元数据管理”> “一般事件”下查看是否有上报的事件。
- 在“数据管理”> “元数据管理”>“事件属性”下查看是否有上报的属性,以及属性的类型、属性关联的事件是否正确。
当事件在元数据中存在后,那么就可以直接在用户细查里面去查询。
验证用户属性
(1)先在“数据管理”>“元数据管理”>“用户属性”中验证用户属性是否存在,并检查属性类型是否符合预期。
(2)然后在“分析工具”>“用户分析”>“用户细查”中,点击并进入其中一个用户详情页面,查看最近上报的用户属性。
- 用户属性上报后,您可以在用户细查的最近个体画像中查看对应的用户属性。
- 用户属性相关的事件也同步上报后,您可在右下方的公共属性列表中查看到对应的用户属性。
但是注意上报用户属性之后,一定要上报一条事件,否则用户细查这边的公共属性列表可能查询不到,因为用户细查是跟事件进行关联的。
验证业务对象
先在“数据管理”>“业务对象”下查看业务对象是否绑定到了事件。然后可以在行为细查进行查询,在行为细查里面会显示item_id。
如果想查看业务对象的属性值,可以在“分析工具” > “高级分析”> “业务对象分析”里面去查看。
埋点实时检测
在“数据管理” > “一般事件” > “验证埋点”上选择“服务端埋点”,然后输入需要检测的 user_unique_id,然后将url参数设置到 verify.url上即可。
当有该用户的埋点数据上报时,会看到上报的内容数据。
- 注意该url有效期只有60分钟。
- SDK版本 >= 1.5.7。
- 如果url错误或者过期,实时检测不会上报或者上报失败,但是不影响正常的埋点上报。
- 如果页面上查看不了内容数据,可以先查看实时埋点上报的日志:
- 搜索关键词 ERROR 日志 以及 “verify request” 和 “verify config”。
- 实时上报的相关的类为
com.datarangers.sender.VerifySender,可以debug下。 - 没有错误日志,但是实时上报不显示内容,可以刷新下页面重新生成url。
注意事项
如果页面上查询不到数据,可以尝试下刷新页面。
API列表 | API说明 |
|---|---|
单个上报事件的接口。 | |
批量上报事件的接口。 | |
设置用户属性的接口。 | |
设置业务属性的接口。 |
AppEventCollector 使用的参数有两个:appType 和 properties。
- appType 只支持:
- app,在服务端上传应用移动端相关的数据
- web,在服务端上传应用web端相关的数据
- mp,在服务端上传应用小程序端相关的数据
- properties 前缀都是
datarangers.sdk。
配置模块 | 配置项 | 含义 | 备注 |
|---|---|---|---|
不涉及 | mode | 上报模式(不区分大小写):http、file、kafka | 在java SDK 版本>=1.5.7 版本之后,建议使用新的该配置。当mode和save同时存在的时候,以mode为准。 |
env | 枚举类型,saas 表示云上,privatization表示私有化,非必须,sdk可以根据配置自动判定。 | 无 | |
sync | boolean类型,同步异步,默认为false,使用异步上报的方式。 | 无 | |
save | boolean型变量,表示是否保存到本地文件, saas 只支持配置成 false。 | 该配置在>=1.5.7 版本之后废弃,使用 | |
http | domain | DataFinder 的域名或者ip,支持http和https,例如为 https://{具体域名地址}。
| 当使用http上报模式的时候,必须配置。 |
threadCount | 异步线程池核心线程数里,默认是20。 | 无 | |
httpConfig.requestTimeout | http发送的请求超时时间,单位是毫秒,默认是10000。 | 无 | |
httpConfig.connectTimeout | http发送的连接超时时间,单位是毫秒,默认是10000。 | 无 | |
httpConfig.socketTimeout | http发送的socket超时时间,单位是毫秒,默认是20000。 | 无 | |
httpConfig.keepAliveTimeout | http连接池的keepAliveTimeout,单位是秒,默认是30。 | 无 | |
httpConfig.trustDisable | true/false。是否禁用双向认证,如果发生ssl相关的错误,建议优先配置证书,或者配置为true,表示禁用双向认证。默认是true | 无 | |
httpConfig.customKeyTrustEnable | true表示自定义客户端的证书路径以及密码,默认是false | 无 | |
httpConfig.keyMaterialPath | keyMaterial 路径 | 无 | |
httpConfig.keyPassword | key密码 | 无 | |
httpConfig.storePassword | store密码 | 无 | |
httpConfig.trustMaterialPath | trustMaterial路径 | 无 | |
httpConfig.trustStrategy | 信任策略。
| ||
sendBatch | boolean类型,表示是否开启批量上报。默认是false,不使用批量。 | saas-非云原生从 1.5.13 版本(含)开始支持批量上报。 | |
batchSize | 批量上报的数量 | ||
waitTimeMs | 批量上报,不足batchSize的时候,最大等待时间 | ||
appKeys.${SDK_APP_1} | SAAS环境,上报设置的appkeys,可以设置多个。多个可以的方式为: | 注意替换成真实的app_id和appkey。 | |
eventCountFileDisable | 表示是否禁用count.log 文件,默认为false;设置为true,则不会有count.log | ||
http(OpenAPI) | openapiConfig.domain | openapi的域名:
| 如果在saas-非云原生上需要进行item和用户属性上报,需要配置openapiconfig,其他情况不需要进行配置。 |
openapiConfig.ak | openapi的ak,请联系客户经理获取。 | ||
openapiConfig.sk | openapi的sk,请联系客户经理获取。 | ||
file | eventSaveName | 保存日志的文件名,需要保证文件的写权限,默认是 datarangers.log。 | 无 |
eventSavePath | 保存日志的文件路径,需要保证写权限和创建文件的权限,模式是 logs/ | 无 | |
eventSaveMaxFileSize | 表示需要保存的日志文件的最大文件大小,单位为MB,默认是100。 | 无 | |
eventCountFileDisable | 表示是否禁用count.log 文件,默认为false;设置为true,则不会有count.log | ||
eventFilePaths | 表示需要保存的日志文件的位置,为一个字符串数组,数组中的每一个值都表示一个路径,用户将日志文件写到不同的文件夹下,可以配合多个LogAgent实例使用。 | 无 | |
eventSaveMaxDays | 最多保留多少天的日志文件,超过这个时间的日志会被删除,默认是-1,即不删除文件。因此长时间运行的时候,为了避免占用过多磁盘,需要自行删除日志文件,或者配置一个合理的值,比如 7。 | 无 | |
kafka | bootstrapServers | kafka的地址。 | 使用kafka模式需要进行配置。 |
properties | 是一个map,需要配置的其他的kafka properties。kafkaProducer的参数参考:Kafka官网文档 | ||
verify | verify.url | 服务端埋点实时检测的url地址。 | SDK版本 >= 1.5.7 |
更多Java SDK的常见问题请参见参考:Java SDK 集成 FAQ。