AI 数据湖服务
AI 数据湖服务


算子广场

请输入


- 文档首页
 AI 数据湖服务行业实践具身智能
 复制全文
 下载 pdf
具身智能
 文档反馈
 问问助手
具身智能模型训练数据的关键在于“量”与“质”——规模化采集多源数据、精准还原交互过程、持续回流真实场景。然而,从数据采集到模型训练,各类采集处理流程均面临着不同的挑战:真机采集成本高,多模态数据对齐难,动作标注与质量筛选繁琐,海量原始记录难以直接转化为可用的训练样本。LAS 具身智能系列算子为您提供从语义标注、空间标注,到标注复检、扩展数据合成,形成从数据生产到质量保障的闭环,助力沉淀具身场景下更高质量的训练数据集。
典型场景
具身场景下,数据从采集到训练,通常会经历以下几个流程。原始记录还要经过时间对齐、异常剔除、任务标注、质量检查和版本登记,才能组织成模型可读取的样本。其中,数据采集只是开始,决定数据价值的是处理流程:对齐、清洗、标注、质检与版本管理。
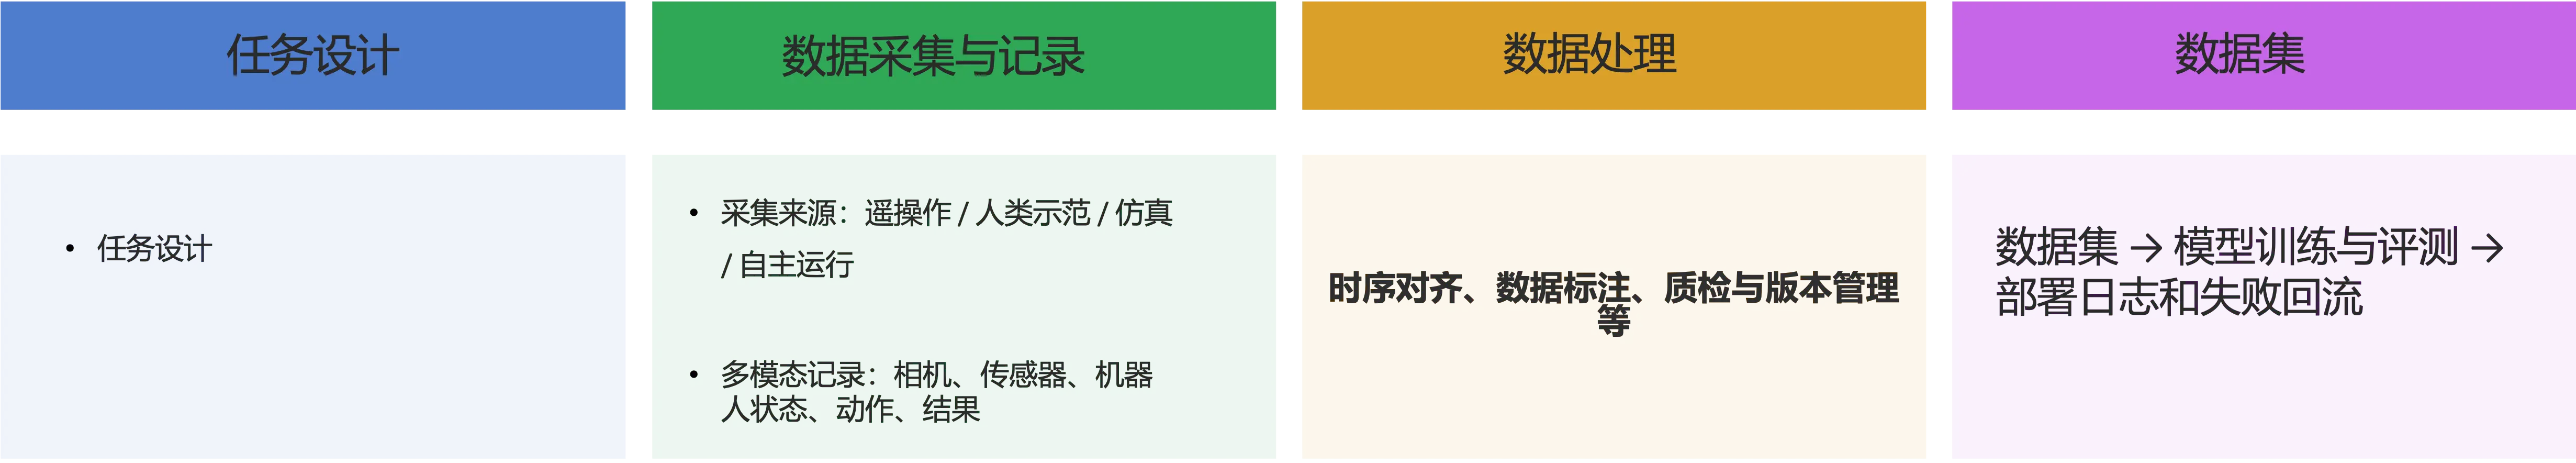
模型部署后,训练过程出现的新失败场景,又会回到采集与标注环节。模型训练可分为多个阶段,其中基础预训练、跨域/中训练阶段的场景如下。
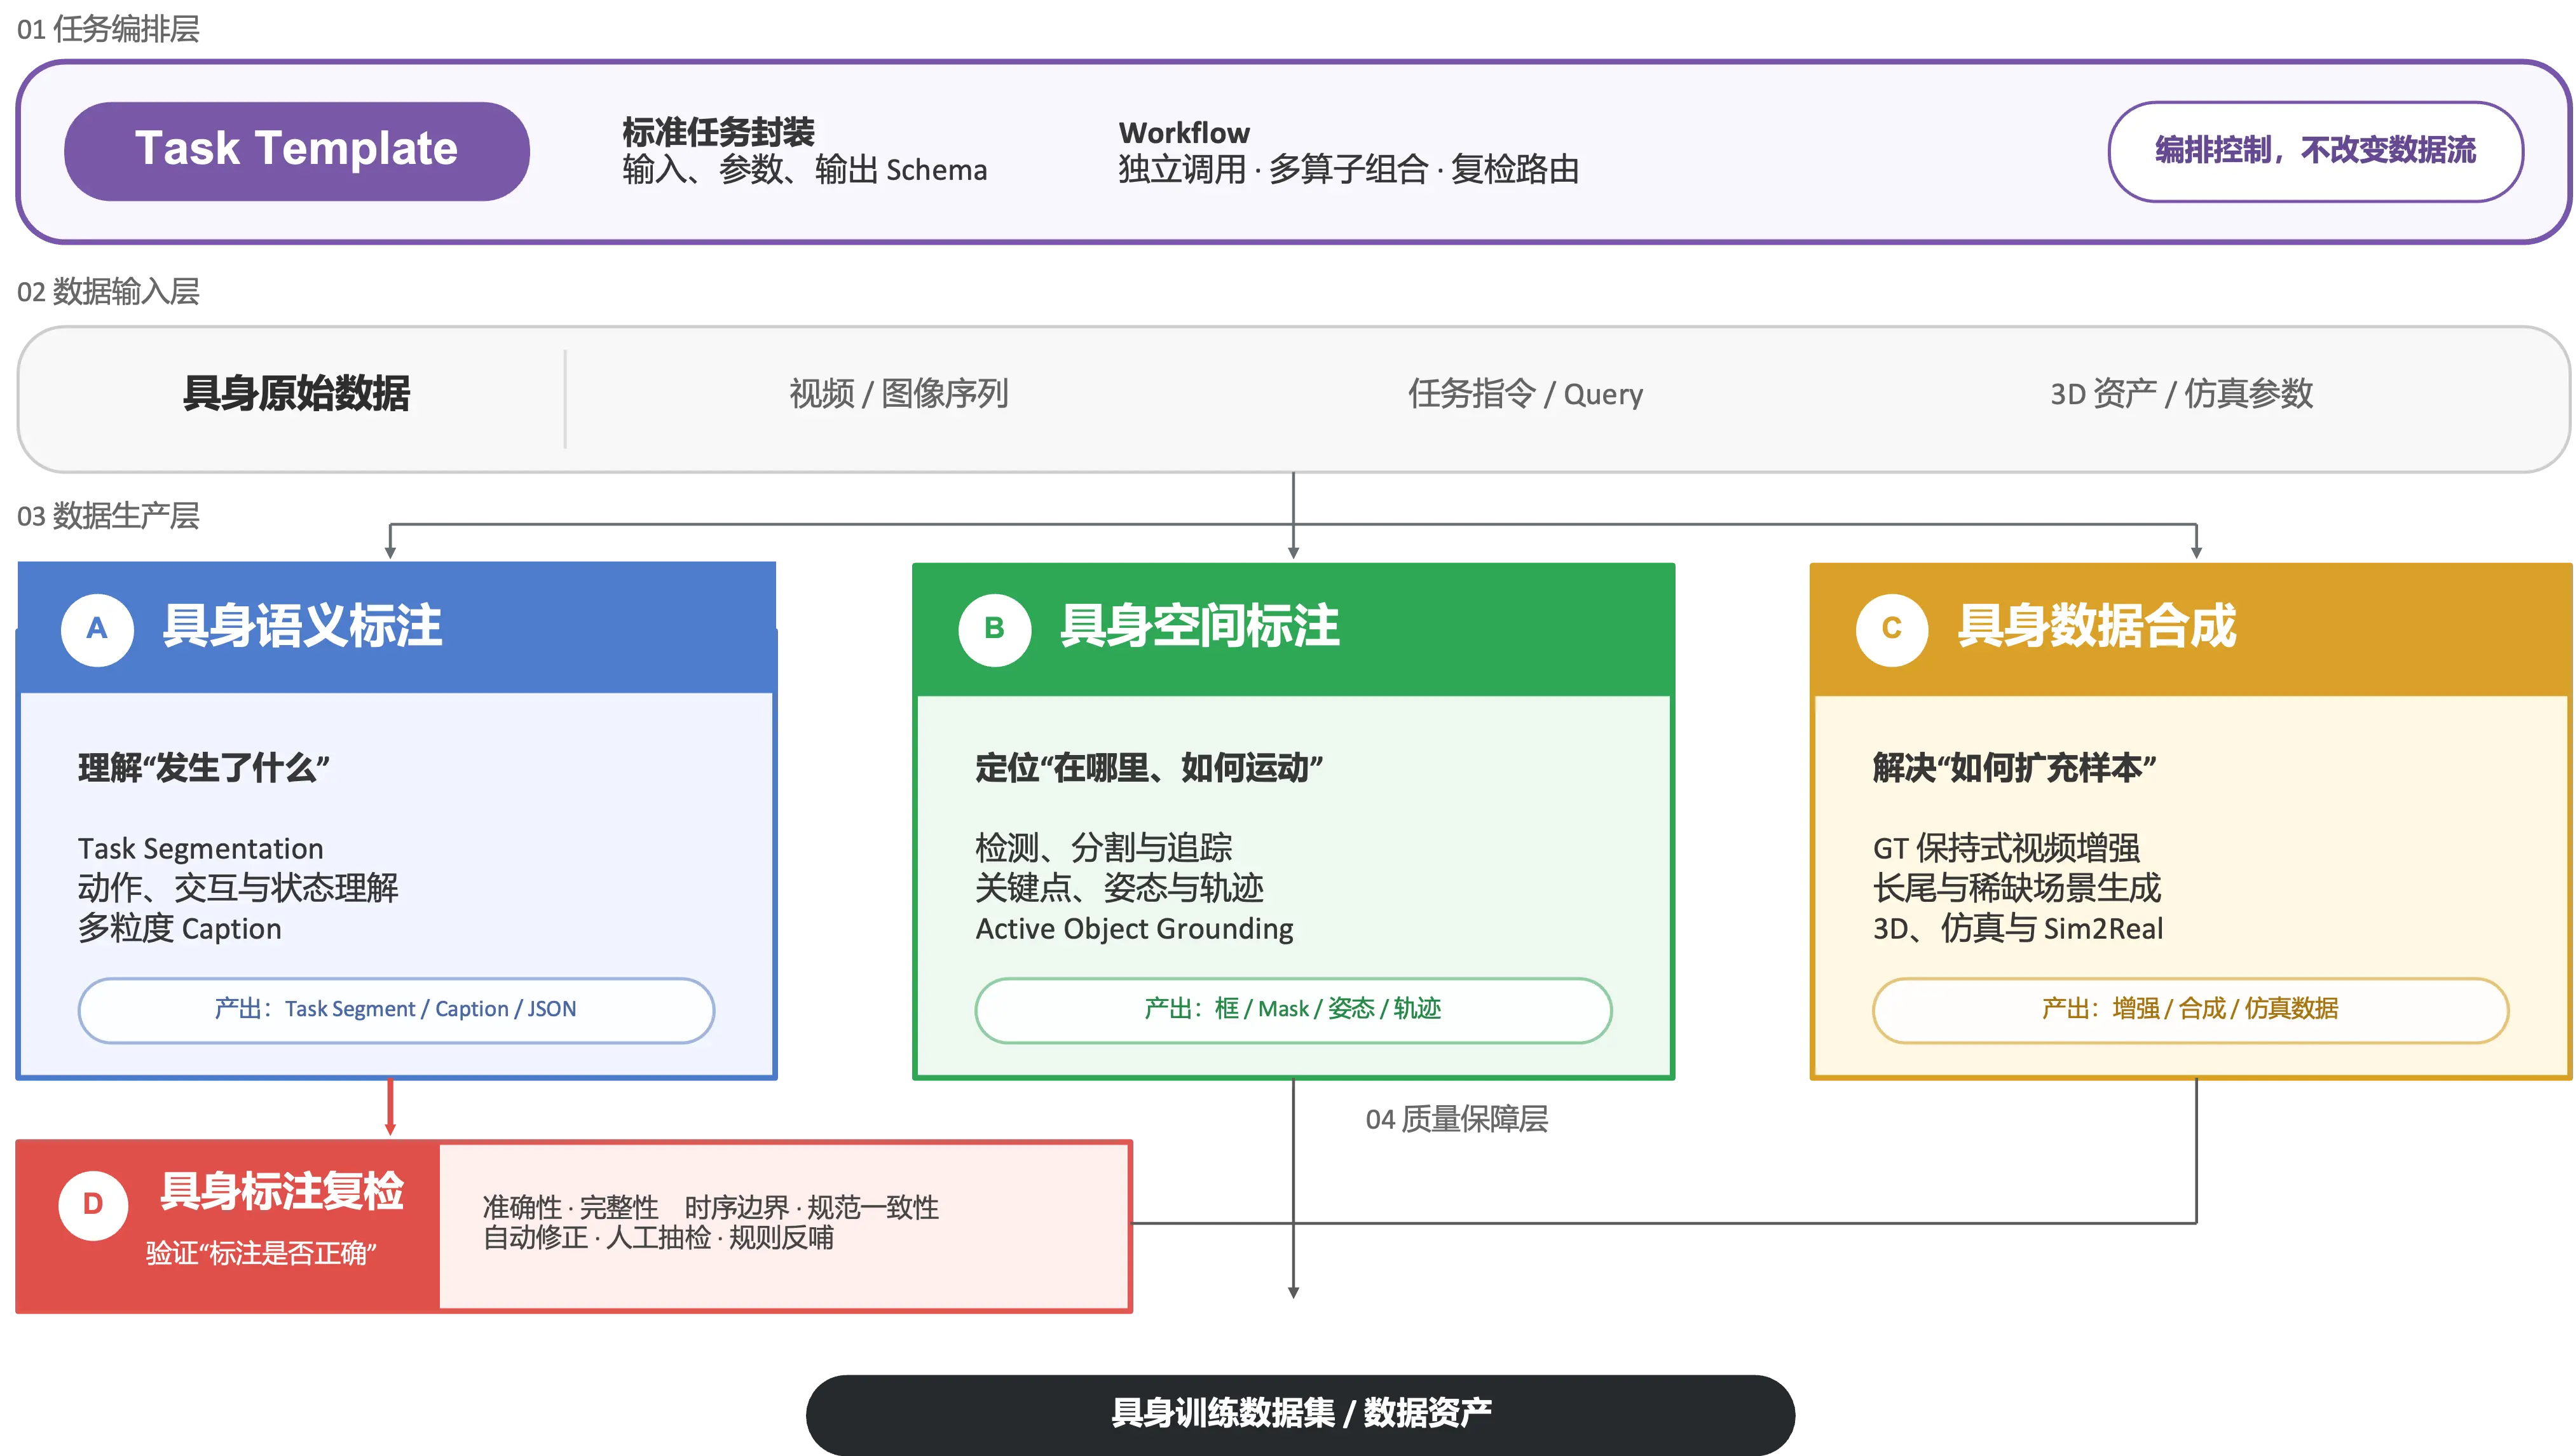
LAS 具身智能算子体系面向训练数据生产,包含具身语义标注、具身空间标注、具身数据合成三类生产算子,以及具身标注复检一类质量保障算子。能力覆盖语义解析、自动验收、空间定位和数据扩充。
(1)目标语义标注
识别交互物品、任务阶段与原子动作,生成带时间边界的描述和标准化技能标签,将原始操作视频转为可训练的时序语义数据。
(2)目标空间标注
定位物品、机械臂与人手,输出目标框、Mask、关键点及跨帧轨迹,为感知、操作和人机交互模型提供空间监督。
(3)数据质检
自动检查标注的语义、时序与格式问题,给出评分和修正建议,以机器复检结合人工抽检稳定数据质量。
(4)数据扩展
通过视频理解、生成编辑与仿真扩充训练样本,补足真实采集成本高、长尾场景少和分布单一等问题。
相关算子
算子 | 核心定位 | 主要输出 | 产品价值 |
具身语义标注 | 解析具身任务中的动作、交互、状态及其时序关系 | Task Segment、视频/片段/动作级 Caption、结构化 JSON | 将原始视觉数据转化为可检索、可训练的语义数据 |
具身标注复检 | 自动验收语义标注结果,定位问题并驱动修正 | 质量评分、问题类型与位置、修正建议、自动修正结果、复检任务 | 以机器自动复检与人工抽检替代全量人工复检,降低成本并稳定交付质量 |
具身空间标注 | 定位对象、部件、区域、姿态及连续运动轨迹 | 检测框、Mask、关键点、姿态、轨迹、Active Object Grounding | 将任务语义落实为空间 Ground Truth,支撑感知与操作模型训练 |
具身数据合成 | 通过生成模型和仿真环境生成、增强并扩充训练数据 | 增强视频、合成样本、3D 资产、仿真数据及配套 Ground Truth | 低成本补充数据规模、分布多样性和真实采集难覆盖的长尾场景 |
应用实践
语义标注
物品识别 & 时序标注
具身语义标注可联合利用主视角与腕部视角视频:先识别任务中的主要交互物品,再结合物品上下文解析主视角中的连续动作,输出任务摘要、动作时间边界、动作描述和标准化技能标签,适用于机器人操作视频的时序预标注与训练数据构建。
应用流程链路
- 切分长视频:对于较长视频,先按语义连续性切分任务片段,避免单次处理内容过长。
- 识别交互物品:输入左右腕部视角拼接视频,识别物品类别、实例及夹持时间段。
- 整理物品上下文:将物品名称、稳定实例 ID、外观特征和夹持信息组织为文本上下文。
- 生成时序标注:输入主视角视频与物品上下文,生成覆盖时间轴的动作片段及技能标签。
- 合并与后处理:按时间轴合并各片段,可按训练要求统一语言、描述粒度和静止片段处理方式。
使用示例
- 应场景1输入视频:左右机械臂辅助视角视频拼接后的视频
-
Replay Play00:00 / 01:10 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 场景2输入视频:主视角视频
-
Replay Play00:00 / 01:10 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 先基于辅助视角视频捕获更清晰细节的物品细节,识别物品,再基于主视角视频进行动作时序标注。
- 应用场景1:交互物品识别
- 任务模版:embodied_active_object_detection@v2
- 输出结果示例:
-

- 算子处理结果后续建议:
- 将返回结果中物品清单整理成简短文本,作为后续时序标准请求中的 task_context.prompt_context。
- 上下文中的每一行都以产出的稳定实例 ID(obj_001、obj_002 …)开头,这样主视角 caption 在多次操作同一物体(例如"第 2 次拿起同一个黄色长尾夹")时,可以复用同一稳定 ID 对齐。
- 在物品清单之后追加一段【动作类别词表】与【skill 填写规则】,明确告知模型可选的标准化原子动作类别,为每个动作片段输出对应的 skill 标签。
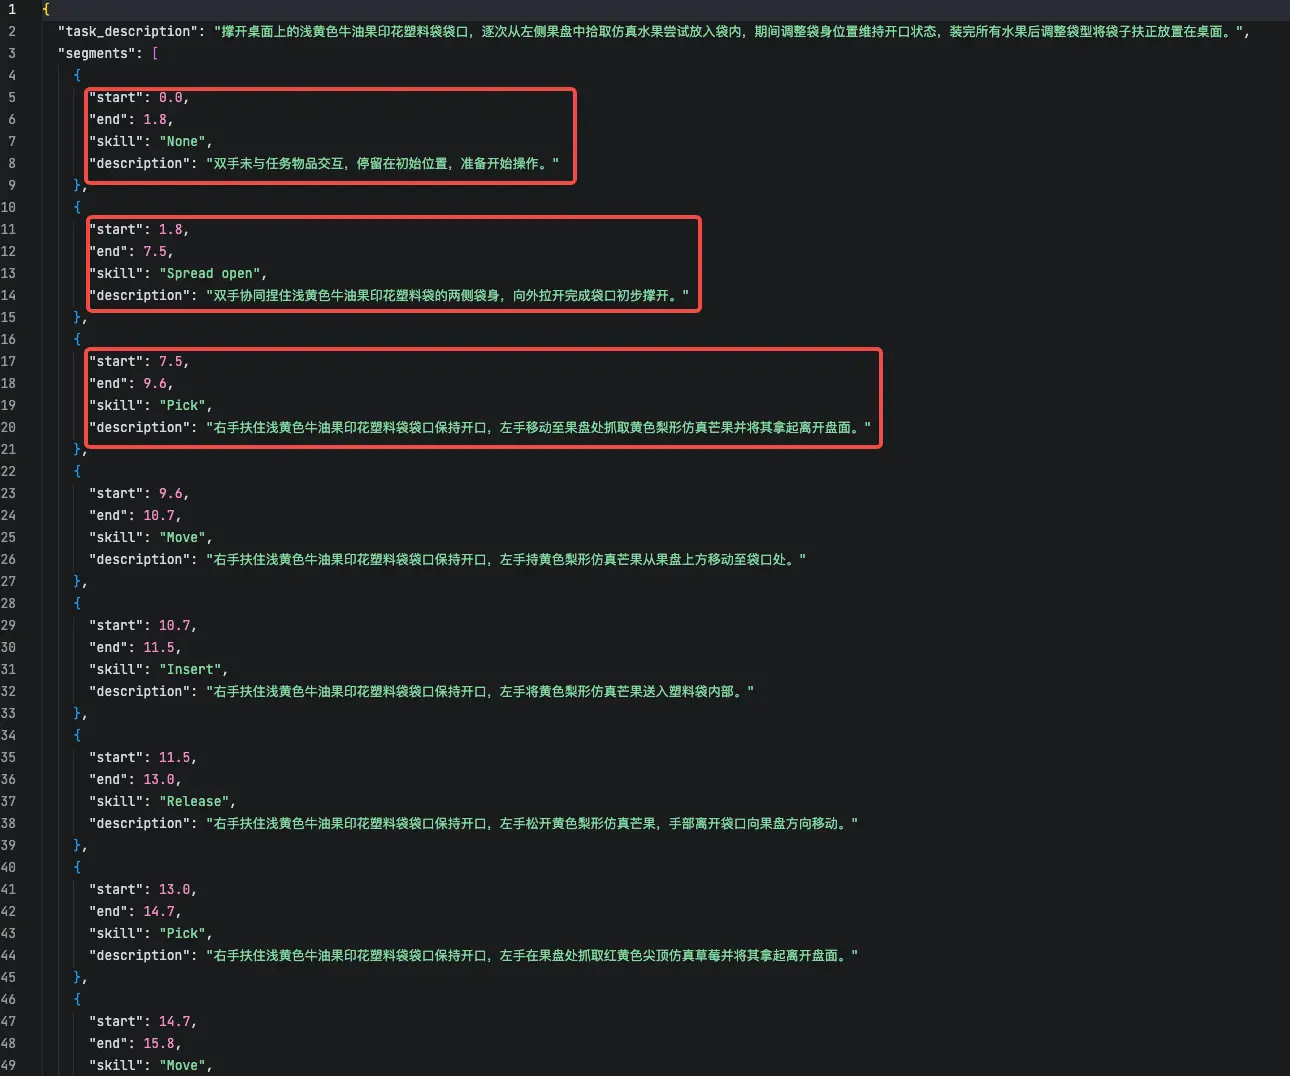
- 应用场景2:动作时序标注
- 任务模板:embodied_action_captioning@v2
- 关键参数:
- 将交互物品识别结果作为task_context.prompt_context输入。
- 输出结果示例:
-
标注复检
具身标注复检对语义标注结果进行自动验收,检查动作与物品描述是否准确、时间边界是否连续、字段与标签是否符合规范,并将结果分流至自动通过、自动修正或人工复检,降低全量人工检查成本。
应用流程链路
- 准备复检输入:汇集原始视频、标注结果、标注规范和 JSON Schema。
- 执行多维检查:检查语义准确性、事件完整性、时序边界及格式规范。
- 输出质量结论:生成质量评分、问题类型、问题位置和修正建议。
- 分级处理结果:高质量数据自动通过,可修复问题自动修正,其余结果进入人工抽检。
- 反哺标注链路:沉淀高频错误规则,持续优化任务模板和标注能力。
使用示例
例如,某动作片段标注为“右手拿起红杯”,但视频中实际由左手操作,且结束时间晚于物品放下时刻。复检可定位手别错误与边界偏移,给出修正建议;修正后的结果再次验收,通过后进入训练集。
空间标注
物品识别与分割
具身空间标注可根据文本、目标点或目标框,在图片和视频中定位指定物品,输出目标框与像素级 Mask;处理视频时还会返回跨帧轨迹标识,适用于目标 Grounding、交互对象跟踪及 HOI、Affordance 数据构建。
应用流程链路
- 上传图像或视频:将包含目标物品的采集素材上传至存储。
- 指定目标:仅有名称时使用文本提示;已有目标点或目标框时直接作为定位提示。
- 执行检测或分割:目标检测输出目标框,实例分割进一步输出像素级 Mask。
- 关联跨帧结果:视频中通过 track_id 保持同一物品在连续帧中的身份一致。
- 生成空间标注:将目标框、Mask 和轨迹结果用于训练、筛选或人工校正。
使用示例
以下展示已知“绿色水果”,进行目标分割与跨帧跟踪的示例。
- 分割与跨帧跟踪结果
-
Replay Play00:00 / 00:05 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 任务代码-核心参数示例
-
手部姿态预估
手部姿态预估从第一人称或第三视角的人类操作视频中提取手框、左右手属性、21 点二维关键点和腕部相对三维关节,并在视频中保持跨帧身份一致,可用于人类示范预标注及 HOI 数据构建。
应用流程链路
- 上传操作素材:输入包含清晰可见人手的图片或视频,无需额外提供目标提示。
- 识别手部实例:检测手框并区分左手、右手。
- 估计手部姿态:输出二维关键点和以腕部为参考的相对三维关节位置。
- 关联连续轨迹:使用 track_id 关联视频中同一只手,并对短时遮挡进行连续跟踪。
- 组合训练数据:将手部姿态与物体轨迹、动作片段结合,形成手—物交互样本。
使用示例
【手部姿态估计 - 示例1:未开启佩戴者手部筛选(ownership)】
- 输入示例
- 左目视频
-
Replay Play00:00 / 00:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 任务代码-核心参数示例
-
- 输出结果示例
- 基于输出结果视频标注展示
-
Replay Play00:00 / 00:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
——注意,本算子不直接返回视频结果,以上为基于算子处理结果 manifest 在原视频上进行标注后的示例。
【手部姿态估计 - 示例2:开启佩戴者手部筛选(ownership)】
- 输入示例
- 左目视频、时间戳、鱼眼相机参数
-
Replay Play00:00 / 00:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
-
- 右目视频、时间戳、鱼眼相机参数
-
Replay Play00:00 / 00:10 Live 00:00FullscreenCssfullscreenClick and hold to drag
-
- 左相机坐标系到右相机坐标系的刚体变换
- 任务代码-核心参数示例
-
- 输出结果示例
- 基于输出结果视频标注展示
-
Replay Play00:00 / 00:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
——注意,本算子不直接返回视频结果,以上为基于算子处理结果 manifest 在原左视频上进行标注后的示例。
机械臂识别与分割
机械臂识别与分割可从机器人操作视频中自动定位活动机械臂,输出像素级 Mask、目标框和跨帧轨迹标识,可用于操作数据清洗、机械臂区域标注,并为夹爪状态与交互关系分析提供输入。支持主视角、腕部视角视频输入,无需多次调试即可稳定稳定输出识别结果。
应用流程链路
- 上传操作视频:输入单臂或多臂机器人执行任务的连续视频。
- 自动筛选实例:识别机械臂候选,筛选活动实例并排除长期静止目标。
- 生成首帧标注:为各机械臂实例生成独立的检测框和分割种子。
- 传播分割结果:沿时间轴持续分割并跟踪机械臂,保持实例身份一致。
- 输出空间结果:生成逐帧目标框、Mask 与轨迹标识,供下游训练或质检使用。
使用示例
对双机械臂操作视频自动识别并持续分割活动机械臂:
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
接触点识别
接触点识别用于定位机械臂末端或人手与物品的交互位置,输出交互双方的目标框和二维接触点对,可用于接触点预标注、交互片段筛选,以及抓取、放置等操作行为分析。
应用流程链路
- 上传图像或视频:输入包含机械臂/人手与物品交互过程的素材。
- 设置执行主体:按需指定机械臂、人手或自动判断,无需提供目标提示。
- 筛选交互片段:视频可先定位候选交互区间,再按指定帧率处理。
- 识别接触位置:输出执行主体与物品的目标框,以及双方对应的二维接触点。
- 校验结果:结合原视频抽检遮挡、模糊和目标混淆导致的漏检或点位偏移。
使用示例
示例 1:机械臂接触点识别
对腕部视角中夹爪抓取蔬菜的视频识别接触点:
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
示例 2:人手接触点识别
以下为接触点算子对人手与物品交互过程进行人手接触点识别的示例:
Replay
00:00
/
00:10
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
接触点依据画面中的可见线索预测,用作数据预标注,不等同于传感器测得的物理接触真值。
数据拓展
世界模型训练
视频精细理解能力可将多来源视频批量转换为稳定的文本监督信号。视频级描述覆盖场景、主体、空间关系和动作过程;稠密描述进一步提供带时间边界的事件与动作片段,适用于世界模型预训练、视频检索和时序监督构建。
应用流程链路
- 汇集视频语料:接入真实采集、互联网或仿真视频,完成格式统一与基础清洗。
- 选择描述粒度:视频级训练使用通用描述;片段级训练使用稠密描述。
- 批量生成描述:算子解析主体、环境、动作变化、空间关系与时间推进。
- 自动质检筛选:按完整性、时间连续性和描述可用性筛选结果,并对异常样本抽检。
- 构建训练样本:将视频或时间片段与描述配对,写入世界模型训练数据集。
使用示例
- 示例1:输入视频
-
Replay Play00:00 / 00:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 应用场景1:细粒度描述
- 任务模版:general_video_captioning,生成一段通用中文描述。
- 适用场景:适合作为视频级语义标签、视频-文本配对和预训练数据文本监督。
- 输出结果示例
-
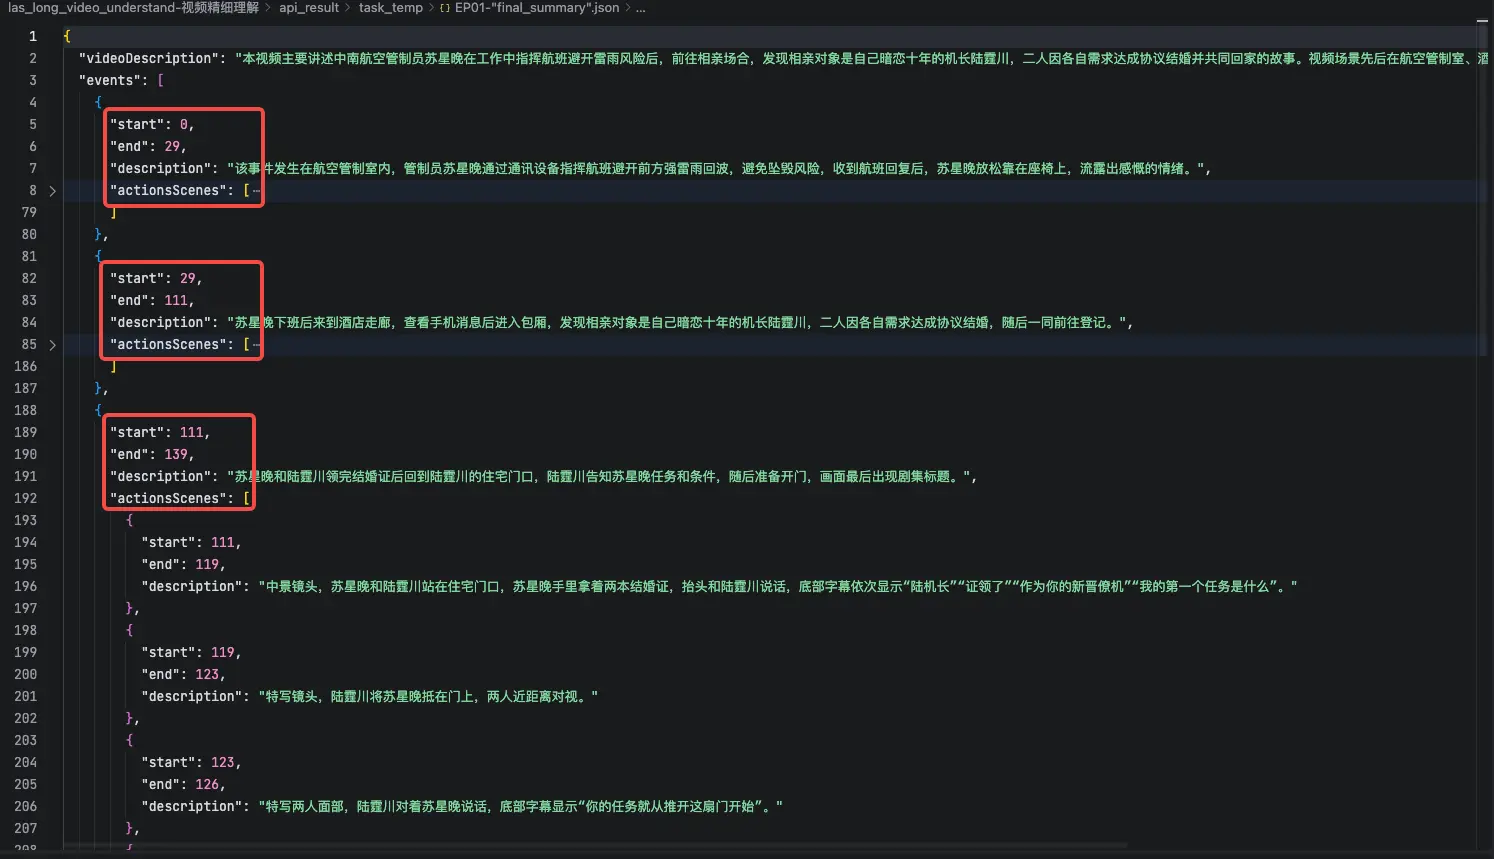
- 应用场景2:稠密视频描述
- 任务模版:dense_video_captioning,按时间切分,生成动作、场景内容总结。
- 适用场景:强调统一结构和时间边界,适合片段级索引、时序监督构建、自动切片和批量质检,不限定某个场景类别。
- 输出结果示例:
-
具身数据合成
具身数据合成通过生成模型和仿真环境生产或增强训练数据,可在保持动作与轨迹语义的前提下替换物品、背景、材质和机械臂,也可生成 3D 资产与仿真样本,补充真实采集难覆盖的环境和长尾事件。
应用流程链路
- 确定扩展目标:选择环境泛化、物体替换、机械臂替换、轨迹生视频或 3D 资产生成等任务。
- 准备条件输入:上传真实/仿真视频、首帧图、文本描述或轨迹,并明确需要保持与变化的要素。
- 生成扩展样本:通过视频生成编辑或仿真,在保持动作和轨迹的同时扩展场景、主体与外观分布。
- 同步生成标注:按任务产出语义、空间、姿态或轨迹 Ground Truth。
- 质检与入库:检查物理一致性、跨帧稳定性和标注一致性,合格样本进入训练集。
使用示例
以机械臂擦拭桌面的视频为输入,保持机械臂动作和运动轨迹不变,将简单桌面背景扩展为家庭厨房、实验室和工业操作台,并调整物品颜色、材质与光照。生成结果经物理一致性和时序稳定性检查后,与原始样本共同用于训练,以提升模型对新环境及长尾干扰的泛化能力。
最近更新时间:2026.10.20 10:11:08
这个页面对您有帮助吗?
有用
有用
无用
无用