AI 数据湖服务
AI 数据湖服务


算子广场

请输入


- 文档首页
 AI 数据湖服务视频视频理解视频精细理解
 复制全文
 下载 pdf
视频精细理解
 文档反馈
 问问助手
视频精细理解算子面向通用视频内容,支持直接对视频进行理解与分析。无论是短视频、影视片段、课程录屏还是监控录像,用户上传视频并给出 query 或 task_template 后,即可对视频内容进行描述、问答、信息提取,并结合时间戳定位相关片段。支持小时级(最大支持 3h、10G)视频输入,也支持结合画面、语音、音乐和音效,按视频中的事件和动作阶段生成带时间信息的结构化描述。
算子介绍
算子 ID:las_video_understanding、las_long_video_understand (旧版 ID)
适用场景
Replay
00:00
/
00:15
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
支持一些视频内容理解类的任务:
- 跨片段问答:整合多clip信息回答复杂问题;
- 高光生成:提取关键片段(情感高潮、剧情转折等);
- 角色追踪:持续锁定目标实体并分析其行为;
- 章节拆解:按逻辑拆分长视频为章节;
- 音视频综合分析:结合画面变化、语音内容和音效线索输出综合理解结果;
- 金句抽取:提取视频中的核心观点或精彩台词。
典型应用场景如下。
核心能力
- 全局精细理解:支持小时级(最大支持 3h、10G)视频,可生成连贯时间线、章节总结等内容。
- 音视频联合理解:支持结合视频画面、语音、背景音和音效进行综合分析,适用于需要同时关注视觉和听觉线索的场景。
- 事件与行为识别:精准检测关键事件、人物动作、场景变化和逻辑关系。
- 视频问答:基于视频内容的自然语言问答,快速定位答案及时间戳。
- 高效摘要与标签:可生成章节摘要、主题标签和人物关系等内容,便于知识管理。
- 结构化输出:支持输出时间线、事件列表等内容,方便二次处理或知识库构建。
- 场景化任务模板:提供通用视频描述、细粒度视频描述、音视频综合理解、具身交互物品识别、动作时序标注、目标检测等内置模板,降低 Prompt 设计和参数调优成本;支持 模板名@版本号 格式指定模板版本,未传版本号时默认使用 v1。
效果展示
【预置任务模板:大模型预训练场景示例】
- 示例1:输入视频
-
Replay Play00:00 / 02:20 Live 00:00FullscreenCssfullscreenClick and hold to drag
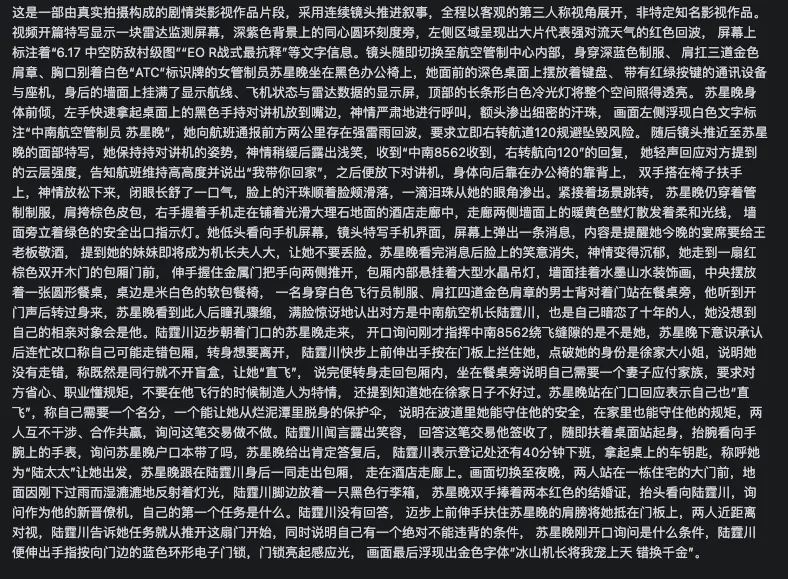
- 应用场景1:细粒度描述
- 任务模版:general_video_captioning,生成一段通用中文描述。
- 适用场景:适合作为视频级语义标签、视频-文本配对和预训练数据文本监督。
- 输出结果示例
-
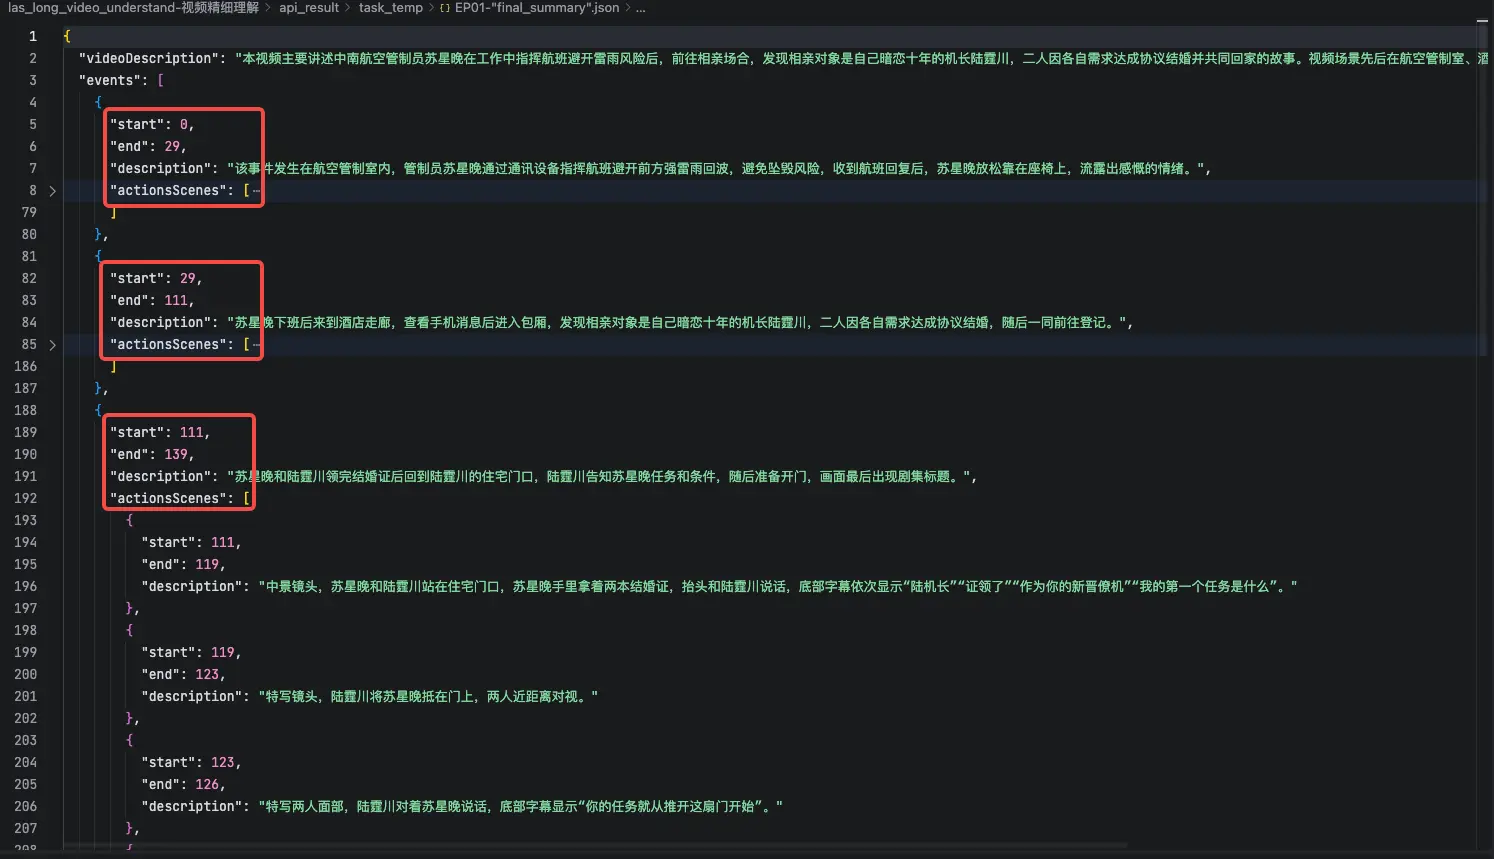
- 应用场景2:稠密视频描述
- 任务模版:dense_video_captioning,按时间切分,生成动作、场景内容总结。
- 适用场景:强调统一结构和时间边界,适合片段级索引、时序监督构建、自动切片和批量质检,不限定某个场景类别。
- 输出结果示例:
-
【预置任务模板:具身智能应用示例】
- 应场景1输入视频:左右机械臂辅助视角视频拼接后的视频
-
Replay Play00:00 / 01:10 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 场景2输入视频:主视角视频
-
Replay Play00:00 / 01:10 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 先基于辅助视角视频捕获更清晰细节的物品细节,识别物品,再基于主视角视频进行动作时序标注。
- 应用场景1:交互物品识别
- 任务模版:embodied_active_object_detection@v2
- 输出结果示例:
-

- 算子处理结果后续建议:
- 将返回结果中物品清单整理成简短文本,作为后续时序标准请求中的 task_context.prompt_context。
- 上下文中的每一行都以产出的稳定实例 ID(obj_001、obj_002 …)开头,这样主视角 caption 在多次操作同一物体(例如"第 2 次拿起同一个黄色长尾夹")时,可以复用同一稳定 ID 对齐。
- 在物品清单之后追加一段【动作类别词表】与【skill 填写规则】,明确告知模型可选的标准化原子动作类别,为每个动作片段输出对应的 skill 标签。
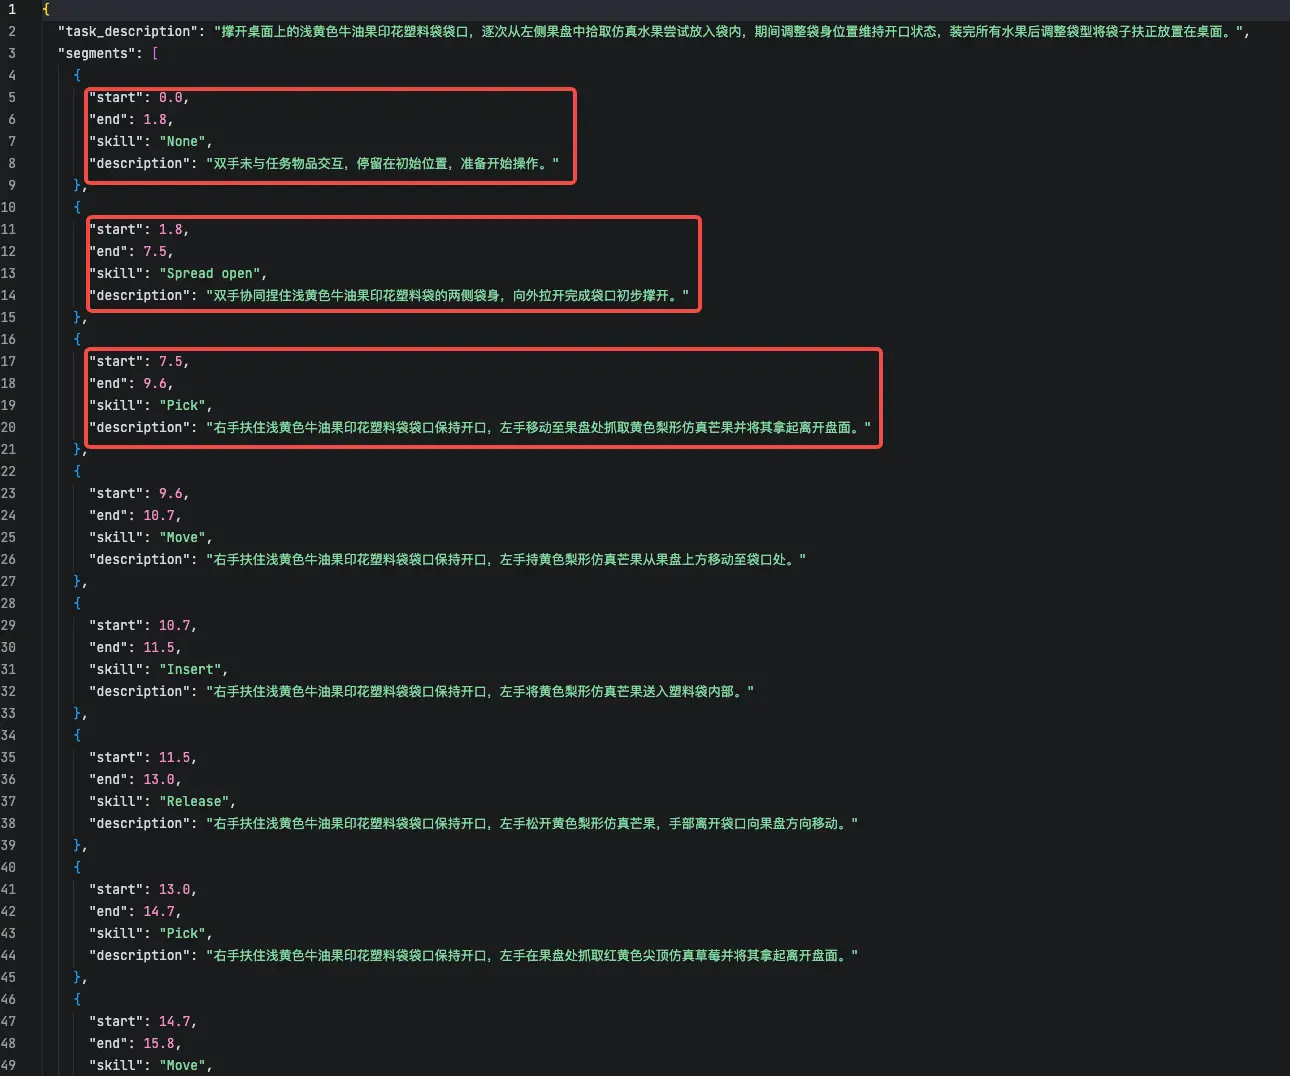
- 应用场景2:动作时序标注
- 任务模板:embodied_action_captioning@v2
- 关键参数:
- 将交互物品识别结果作为task_context.prompt_context输入。
- 输出结果示例:
-
【自定义Query任务:影视剧/体育赛事总结】
- 示例2:输入视频
-
Replay Play00:00 / 01:15 Live 00:00FullscreenCssfullscreenClick and hold to drag
- 算子配置示例:可自定义query,灵活设置视频内容提取、总结等要求
-
- 结果示例
-
支持的地域
- 北京:cn-beijing
- 上海:cn-shanghai
- 广州:cn-guangzhou
算子性能
细分项 | 性能影响说明 |
最大 Submit RPM | 2000 |
最大 Poll RPM | 4000 |
最大并发度 | 100 |
耗时 | * 总耗时与视频时长、内容复杂度、网络环境相关。 |
输入与输出要求
输入要求
细分 | 详细说明 |
支持的输入数据模态 |
|
输入格式:视频 |
|
输入路径要求 | 通过请求参数 video_url提供给算子输入数据,当前支持公网 URL、TOS 路径这两种方式。
|
输出要求
细分 | 详细说明 |
输出数据模态 | * 文本 |
输出路径:API 返回 | 算子处理完成后,直接通过算子 Poll 接口的返回参数将结果返回。 |
计费说明
- 计费标准
-
- 细分项计费标准说明计费项包括4个计费项:模型输入、模型输出、缓存存储、缓存命中。需支付的费用为所有计费项的计费之和。计费类型按量计费,单位:元/百万 Tokens,按实际的计费用量每小时出账。单价各计费项的单价以调用模型时,基于模型输入长度进行阶梯定价,处于不同输入长度的梯度范围内的单价不同。
- 计费详情
- 计费公式:总费用 = 模型输入费用 + 模型输出费用 + 缓存存储费用 + 缓存命中费用
-
-
- 计费预估
- 基于上述计费详情表格,您可预估输入的视频大约为多少 Token,结合算子请求代码预估大约多少 Token,作为整体模型输入长度的预估。
- 注意:此预估结果并不能作为准确的输入长度数据,仅作为参考,实际进行任务处理时,还会有系统 Prompt 等其他输入,但其他输入的长度一般不会很长。
说明
当前,使用 doubao-seed-2.1 模型时,产生的费用账单中,影响因子依旧展示为 doubao-seed-2.0 相关的影响因子。您可根据账单中的单价等详情来明确当前账单实际使用的模型类型。
注意与前提
API 调用
API 调用说明
- 本算子的 API 为异步任务接口,您需要通过 Submit 接口提交任务获得任务的 task_id,再通过 Poll 接口获取对应任务(task_id)运行状态,并获取算子处理结果。
- 注意,任务提交后,任务的 task_id 有效期为 3 天,超过 3 天后即无法通过此 task_id 来获取算子处理结果。
Submit
接口说明
调用 las_video_understanding 算子进行视频精细理解。最小可用请求可传入 video_url 和 query,也可传入 video_url和 task_template,其余字段可根据任务复杂度和分析需求按需配置。
请求参数
operator_id string 必选 示例值: las_video_understanding
算子ID: las_video_understanding 或者 las_long_video_understand (旧)
operator_version string 必选 示例值: v1
算子版本
data long_video_understand_info 必选
算子参数
video_url string 必选 示例值: https://example.com/video.mp4
待分析视频的可访问地址。支持 http/https、火山 TOS(tos://bucket/key)等,请确保服务端可拉取该资源,建议使用稳定、可直接下载的文件链接。最大支持时长:3 小时;最大支持大小:10 GB;支持格式:mp4、mov、avi、mkv、flv、webm。对于需要输出较多事件和动作细节的任务,建议优先处理 30 分钟以内的视频,以获得更稳定的结果结构和时间边界。
query string Optional 示例值: 请按时间顺序总结视频中的关键进球,并标注球员号码与时间点
对视频的分析目标或问题描述。未传入 task_template 时必填;同时传入 query 和 task_template 时,显式 query 会覆盖模板的默认 query,其他显式参数也会覆盖对应模板默认值。建议尽量明确输出目标和结果组织方式,问题越具体,结果通常越稳定。
task_template string Optional 示例值: general_video_captioning@v1
任务模板。传入后可自动补齐任务所需默认配置;使用模板时通常只需传入 video_url 和 task_template。支持通过 模板名@版本号 指定模板版本,未携带版本号时默认使用 v1,例如 general_video_captioning 等价于 general_video_captioning@v1。
支持:
- general_video_captioning:生成连续、详细、非结构化的视频级描述。
- dense_video_captioning:生成包含事件、动作和场景时间信息的结构化 JSON 描述,适合需要输出较多事件和动作细节的任务,建议优先用于 30 分钟以内的视频。
- video_audio_understanding:结合视频画面、语音、音乐和音效,生成音视频综合理解结果。
- omni_video_audio_captioning:综合理解画面与声音,按视频中的事件和动作阶段生成带时间信息的结构化描述。
- speech_recognition:转写音频或视频中的语音,并区分说话人。
- audio_understanding:总结和分析纯音频内容。
- embodied_active_object_detection:面向具身操作场景识别主要交互物品,支持 v2。
- embodied_action_captioning:面向具身操作场景生成动作时序标注,支持 v2。
- embodied_action_captioning_prior:结合候选动作先验生成动作时序标注,支持 v2。
- object_detection:检测指定目标并返回 bbox。
task_context task_context Optional 示例值: {"prompt_context":"主要交互物品:黄色图钉、浅绿色便签。"}
任务模板结构化上下文。支持 prompt_context、target_object 和 audio_url;具体适用模板见下表。
prompt_context string Optional 示例值: 主要交互物品:黄色图钉、浅绿色便签
任务上下文先验信息,当前支持 task_template 为 embodied_action_captioning 或 embodied_action_captioning@v2 时生效
target_object string Optional 示例值: pink_bear(粉色毛绒小熊)
目标检测类别及描述,当前支持 task_template 为 object_detection 时生效。建议使用“英文类别 key(中文/自然语言描述)”格式,输出中的 category 会使用括号前的类别 key
audio_url string Optional 示例值: tos://bucket/audio.wav
独立音频地址。用于 video_audio_understanding 或 omni_video_audio_captioning 时优先于视频内置音轨。
start float Optional 示例值: 30.0
视频分析开始时间,单位为秒。范围为[0, 视频时长],且start < end。
end float Optional 示例值: 120.0
视频分析结束时间,单位为秒。范围为[0, 视频时长],且start < end。
fps float Optional 示例值: 1.0
视频抽帧帧率,提高 fps 会增加分析准确性,同时也会增加处理时延与Token 消耗和成本。默认 1.0,取值范围为 [1/60, 10]。一般场景使用默认值即可;当任务需要识别快速动作或更细粒度事件时,可尝试适当提高取值。
media_resolution string Optional 示例值: medium
视频处理分辨率档位,影响视觉细节保留程度与处理时延。默认 medium,支持:low、medium、high、xhigh。一般场景使用默认值即可;当任务对字幕、小目标、球衣号码等视觉细节的识别要求较高时,可尝试使用更高档位。
model_name string Optional 示例值: doubao-seed-2-1-lite-260915
指定视频理解模型。默认 doubao-seed-2-1-lite-260915。若无特殊需求,建议使用默认值。
支持:
- Seed 2.0 Mini:doubao-seed-2-0-mini-260428。
- Seed 2.0 Lite:doubao-seed-2-0-lite-260428。
- Seed 2.1 Lite:doubao-seed-2-1-lite-260915。
- Seed 2.1 Pro:doubao-seed-2-1-pro-260628、doubao-seed-2-1-pro-260915。
- Seed 2.1 Turbo:doubao-seed-2-1-turbo-260628。
reasoning_effort string Optional 示例值: minimal
控制模型推理强度。默认 minimal,表示关闭深度思考。常见取值:minimal、low、medium、high。一般场景使用默认值即可;当任务涉及跨片段归纳、复杂因果关系或多角色分析时,可尝试使用更高档位。
clip_context string Optional 示例值: medium
控制单个视频分片的上下文范围。默认 medium,支持:medium、long。一般场景使用默认值即可;当任务更依赖上下文连续性时,可尝试使用更高档位 long。
use_responses_api boolean Optional 示例值: false
是否启用 Responses API 能力。启用后可缓存视频内容,缓存有效期为 1 小时,适合同一视频的重复分析请求。
previous_response_ids list of string Optional 示例值: ["cache_resp_test"]
传入上一轮响应返回的响应标识符列表后,可复用已缓存的视频内容,仅在 use_responses_api=true 时生效。
返回参数
metadata object
请求元信息
task_id string 示例值: task-xxx
异步模式下的任务 ID,用于作业状态查询。
task_status string 示例值: PENDING
异步模式下的任务状态。
- PENDING, 提交任务排队
- RUNNING, 正在运行
- COMPLETED, 已经完成
- FAILED, 失败
- TIMEOUT, 超时
business_code string 示例值: 0
业务码。提交成功时通常返回 0 。
error_msg string
如有异常,会返回详细的异常信息。
推荐配置
场景 | 推荐参数 |
通用摘要、基础问答 | 使用默认参数即可 |
体育比赛、动作细节分析 | 可适当提高 fps;对球衣号码、小目标等细节识别要求较高时,可尝试 media_resolution=high |
会议纪要、课程拆解、剧情梳理 | 可尝试 clip_context=long;当任务涉及复杂归纳时,可进一步尝试提高 reasoning_effort |
同一视频重复分析、复用已缓存视频 | use_responses_api=true,并传入 previous_response_ids;视频缓存有效期为 1 小时 |
示例
请求示例
返回示例
Poll
接口说明
查询视频理解任务的执行状态和结果。
请求参数
返回数据
metadata metadata
请求元信息
task_id string 示例值: task-xxx
异步模式下的任务 ID。
task_status string 示例值: COMPLETED
异步模式下的任务状态。
- PENDING, 提交任务排队
- RUNNING, 正在运行
- COMPLETED, 已经完成
- FAILED, 失败
TIMEOUT, 超时
异步任务通常需要结合 task_status=COMPLETED 与 business_code=0 判断任务已真正完成。
submit_time string 示例值: 2026-07-21T16:04:06+08:00
任务提交时间,格式为 ISO 8601 时间戳。
end_time string 示例值: 2026-07-21T16:04:06+08:00
任务结束时间,格式为 ISO 8601 时间戳。
business_code string 示例值: 0
业务码。业务处理成功时通常返回 0。
error_msg string
如有异常,会返回详细的异常信息。
data long_video_understand_result
返回的数据
token_usages list of token_usage_info 示例值: [{"model_name":"doubao-seed-2-1-lite-260915","token_usage":{"prompt_tokens":4453444,"completion_tokens":10929}}]
token 使用情况
model_name string 示例值: "doubao-seed-2-1-lite-260915"
模型名称
token_usage object 示例值: {"prompt_tokens": 4453444, "completion_tokens": 10929, "cached_tokens": 10032, "cached_store_tokens": 10032, "total_tokens": 4464373}
Token 使用量
video_duration float 示例值: 847.296
原始视频时长
resolution string 示例值: 1920x1080
原始视频分辨率
final_summary string 示例值: 视频整体讲述了...
最终总结
response_ids list of string 示例值: ["cache_resp_test"]
开启 Responses API 后返回的响应标识符列表,可在后续 Submit 请求中通过 previous_response_ids 传入,以复用已缓存的视频内容
示例
请求示例
返回示例
错误码
最近更新时间:2026.10.21 21:19:00
这个页面对您有帮助吗?
有用
有用
无用
无用