AI 数据湖服务
AI 数据湖服务


算子广场

请输入


- 文档首页
 AI 数据湖服务视频内容创作视频脚本规划
 复制全文
 下载 pdf
视频脚本规划
 文档反馈
 问问助手
输入视频主题和创作要求,即可生成一份可用于后续制作的视频生产规划,包括图片素材规划、视频内容结构、镜头安排、视频引用素材建议、时长节奏和口播文案等(不直接生成音视频、图文等素材资产)。规划会将创意拆解为清晰的内容结构、镜头安排、素材建议和时长节奏,适合教育及营销视频的前期策划。
算子介绍
算子 ID:las_hypervideo_script_planner
适用场景
- 课程讲解:语文古诗伴读、英语单词讲解、数学例题讲解、科学现象解释等教育视频前置规划。
- 广告营销:广告输出、营销视频生产等。
- 批量策划:为系列化内容生成结构统一的制作方案,减少重复策划工作。
- 需要控制纯视频画面与精准文字画面生成比例,并约束准确文字进入课件帧的混合生产场景。
核心能力
- 从创意到制作方案:将主题、受众和表达目标整理成可执行的视频生产规划。
- 生产规划:拆解视频内容,规划各场景的生成模式、分镜脚本、时长和衔接关系。
- 模式路由:将场景分配为 video、frame和hybrid。video 适合人物动作、故事情境、环境氛围和视觉演示等纯视频场景;frame 适合课件页、准确文字、公式、音标、例题、练习题、图表和总结页等文字较多的场景。hybrid 适合同一个场景中既需要生成视频画面,又需要准确渲染文字/布局的场景。
- 参考资料理解与图片复用:理解内容图片、PDF 和视频;通过 ref_strategy 决定内容原图是否进入人物、道具或背景的具体状态,并由场景引用。PDF 和视频只用于理解。
- 图文联合风格:visual_style 支持一张风格图、风格文字或二者结合;明确冲突以风格文字为准。风格独立于内容图片引用策略。
- 素材状态与角色声音:同一人物、道具或背景可具有多个状态;一个状态可保留多张内容原图,人物各状态可配置独立声音,台词引用相应人物及声音状态。
- 适配不同内容类型:支持课程讲解和广告营销视频策划。
效果展示
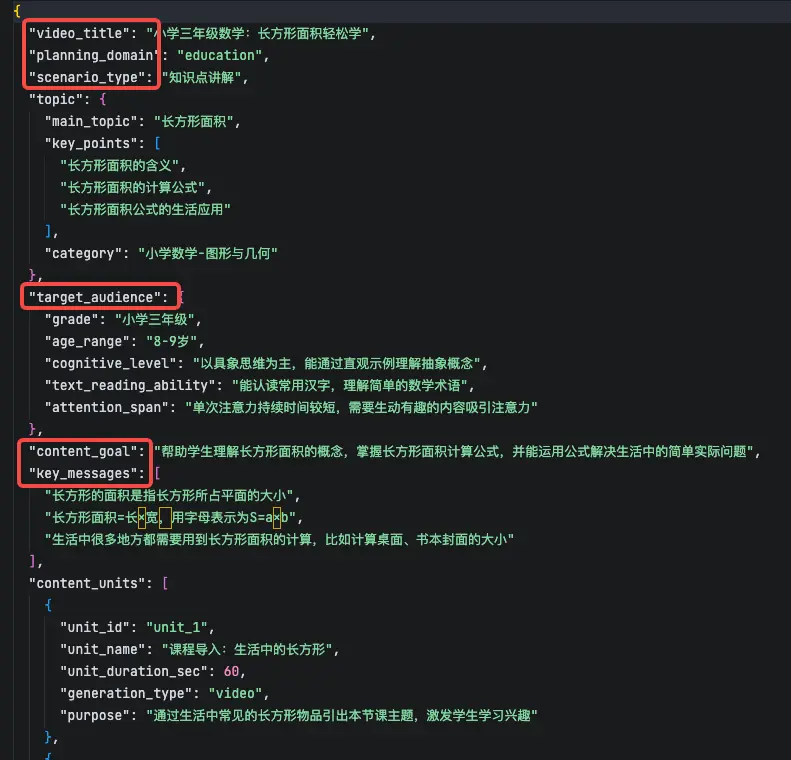
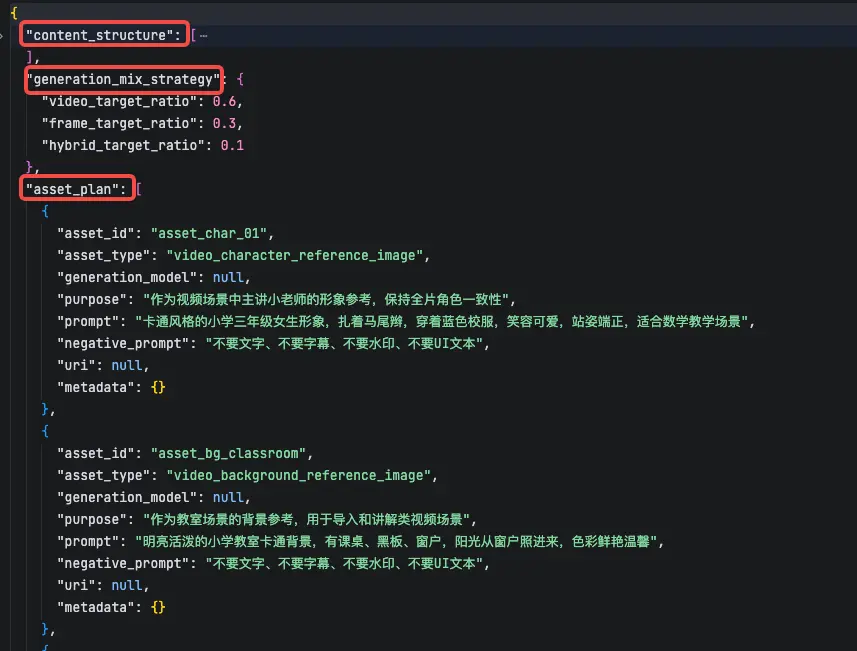
- 输入:教育场景的示例
-
- 可基于算子输出结果进行视频生成,以下为示例
-
Replay Play00:00 / 01:00 Live 00:00FullscreenCssfullscreenClick and hold to drag
——注意,本算子不直接输出视频
支持的地域
- 北京:cn-beijing
- 上海:cn-shanghai
- 广州:cn-guangzhou
算子性能
细分项 | 性能影响说明 |
Submit RPM | 600 |
Poll RPM | 600 |
输入与输出要求
输入要求
细分 | 详细要求 |
输入数据模态 |
|
输入模态:prompt | 通过请求参数 prompt 提供给算子输入数据,输入建议:
|
输入模态:参考 image/file/video | 通过请求参数 ref_images 、ref_files、ref_videos 提供给算子输入数据。
|
输入模态:视觉风格 image/prompt | visual_style.ref_images 最多 1 张,不占内容图片额度;visual_style.prompt 最多 6000 字符 |
输出要求
计费说明
- 计费标准
- 细分项计费标准说明计费项
- 算子处理费用:基于输出的视频脚本的目标视频时长统计用量,不同时长按不同单价进行计费。即,需要规划脚本的目标视频时长越长,费用越高。
- 多模态参考输入费用(按需):如果提供了多模态的输入内容(有效内容图片、PDF 文档、视频、独立风格图片等),则收取 1元的多模态输入费用。
计费类型按量计费,单位:元,按实际的计费用量每小时出账。单价基于需要规划脚本的目标视频时长进行阶梯计费。
- 计费详情
- 详细价格与计费规则参见大模型调用计费-视频脚本规划。
-
-
注意与前提
Rest API 调用
API 调用说明
- 本算子的 API 为异步任务接口,您需要通过 Submit 接口提交任务获得任务的 task_id,再通过 Poll 接口获取对应任务(task_id)运行状态,并获取算子处理结果。
- 注意,任务提交后,任务的 task_id 有效期为 3 天,超过 3 天后即无法通过此 task_id 来获取算子处理结果。
Submit
接口说明
提交视频脚本规划任务,提交成功后返回任务 ID,可通过查询接口获取处理结果。
请求参数
operator_id string 必选 示例值: las_hypervideo_script_planner
算子 ID。
operator_version string 必选 示例值: v1
算子版本。
data HyperVideoScriptPlannerReqParams 必选
视频脚本规划请求参数。
prompt string 必选 示例值: 为小学三年级数学“长方形面积”课程生成 5 分钟讲解视频规划
创作需求描述,不能为空或全空白;建议说明主题、目标受众及必须呈现的信息。
prompt_strategy string Optional 示例值: education_v1
提示策略。education_v1 用于教育规划,marketing_ecommerce_v1 用于营销电商规划。显式传入时优先使用该策略;未传时按 planning.domain 选择教育或营销策略。建议两者保持一致。
total_duration_sec integer Optional 示例值: 300
目标视频总时长(秒),范围 [30, 1800]。若同时传入 min_total_duration_sec 或 max_total_duration_sec,目标时长必须满足对应下限或上限;未传入的上下限不参与关系校验。未传时根据创作需求自动推断,无法确定时回退为 270 秒。最终时长以 Poll 返回的 total_duration_sec 为准。
planning Planning Optional
规划领域和领域上下文配置。未传、传入 null 或空对象时默认使用教育领域。
domain string Optional 示例值: education
规划领域:education 为教育,marketing 为营销。缺省、null 或空白时默认 education;去除首尾空白后不区分大小写。
context PlanningContext Optional 示例值: {"target_grade":"小学三年级","subject":"数学","course_topic":"长方形面积"}
领域上下文。未传、为 null 或空对象时不补充领域上下文。education 使用下表的三个可选字段;marketing 接受自定义 JSON 对象,没有固定必填子字段,当前商品、受众等营销要求请写入 prompt,扩展字段暂不用于生成规划。
target_grade string Optional 示例值: 小学三年级
仅教育领域:目标年级。缺省或空白时不提供该信息。必须放在 planning.context 内,不能写在 data 顶层。
subject string Optional 示例值: 数学
仅教育领域:学科。缺省或空白时不提供该信息。
course_topic string Optional 示例值: 长方形面积
仅教育领域:课程主题。缺省或空白时不提供该信息。
ref_images list of string Optional 示例值: ["https://example.com/reference-01.png"]
内容参考图片 URL 列表,最多 20 项;请提供可访问的 HTTP(S) 图片地址。未传或为空列表时不使用内容参考图。相同 URL 按首次出现顺序去重;图片参与内容理解,是否作为实体状态原图被场景使用由 ref_strategy 决定。独立风格图不占用此额度。
ref_files list of string Optional 示例值: ["https://example.com/reference.pdf"]
参考文件 URL 列表,最多 3 项,当前仅支持 PDF,所有 PDF 合计最多 5 页;广州地域暂不支持参考文件输入。请提供可访问的 HTTP(S) 地址;未传或为空列表时不使用参考文件。PDF 文本和页内图片仅用于内容理解,不作为可引用原图。
ref_videos list of string Optional 示例值: ["https://example.com/demo.mp4"]
参考视频 URL 列表,最多 5 项。每项必须是字符串,去除首尾空白后为非空 HTTP(S) URL 且不超过 4096 字符。未传、为 null 或为空列表时不使用参考视频;相同 URL 按首次出现顺序去重。视频仅用于内容理解,不直接剪入成片;实际格式、编码、大小和时长的可处理性以素材理解结果为准。
ref_strategy string Optional 示例值: auto
内容原图引用策略,只接受小写 auto、none、all,未传时使用旧字段 reference_mode 的值,两者均未传时默认 auto。auto:自动选择相关内容图,也可不选;none:内容原图不进入执行资产,但素材仍参与理解;all:去重后的全部内容图必须进入实体状态,并被场景通过 asset_refs 使用,无法完整有效绑定时任务失败。策略不要求引用 PDF 或视频,也不影响全局视觉风格;none 不免除素材处理费用。
visual_style VisualStyle Optional
全局视觉风格,支持仅图片、仅文字或图文组合。图片提供视觉基底,文字补充或调整;明确冲突以风格文字为准。未传、为 null、空对象或图文均为空时沿用默认风格逻辑。风格在所有引用策略下均生效,不自动移植风格图中的角色、物体、Logo 或文字,也不承诺像素级复刻。
ref_images list of string Optional 示例值: ["https://example.com/watercolor-style.png"]
风格参考图数组,最多 1 张,与顶层 ref_images 的 20 张内容图分别计数。每项必须是字符串,去除首尾空白后为非空 HTTP(S) URL 且不超过 4096 字符;缺省、null 或空数组表示无风格图。风格图不参与内容引用覆盖,也不直接成为内容资产;有风格图时计入多模态输入。
prompt string Optional 示例值: 保留水彩笔触,改成冷色调并增加留白
风格文字要求,必须是字符串,去除首尾空白后最多 6000 字符;缺省、null 或空白表示无风格文字。可单独使用,不需要同时上传风格图。该文字本身不计为独立的多模态素材输入。
reference_mode string Optional 示例值: auto
ref_strategy 的旧字段名,取值和语义相同。两者同时提供非 null 值时必须完全一致,否则返回 Parameter.Invalid。
output_tos_path string Optional 示例值: tos://bucket/output/script_planner/
可选的结果输出目录,使用 tos:// 路径;调用账号需具备目标目录写入权限。不传、传 null 或空白时,任务成功后通过 Poll 返回产物下载链接。链接有效期为 24 小时,请及时下载保存。
output_language string Optional 示例值: zh
输出语言,支持中文、英文。中文取值:zh、cn、chinese、zh-cn、中文;英文取值:en、eng、english、en-us、英文,拉丁字母别名不区分大小写;默认 zh。
aspect_ratio string Optional 示例值: 16:9
目标视频画幅比例,默认 16:9。
resolution string Optional 示例值: 1920x1080
目标视频分辨率,使用“宽x高”表示像素尺寸,默认 1280x720。
fps integer Optional 示例值: 25
目标视频帧率(帧/秒),范围 [1, 120],默认 30。
video_target_ratio double Optional 示例值: 0.6
video 场景的目标时长占比,范围 [0, 1]。用于人物动作、故事情境、环境氛围和不需要准确渲染文字的视觉演示。可只传部分比例;全部传入或已传正值之和大于等于 1 时归一化,只有一种模式未指定时补足余量,其他情况由模型规划。比例规则处理后必须至少保留一种可用模式;营销策略默认 hybrid_target_ratio=0,此时不能再同时将 video_target_ratio 和 frame_target_ratio 设为 0。
frame_target_ratio double Optional 示例值: 0.3
frame 场景的目标时长占比,范围 [0, 1]。用于准确文字、布局、课件页、图表等。未传时按上述比例规则补足或由模型规划。
hybrid_target_ratio double Optional 示例值: 0.1
hybrid 场景的目标时长占比,范围 [0, 1]。用于同一场景同时需要生成视频画面与准确文字或布局的情况。教育策略未传时由模板自动规划,营销策略未传时默认 0。
video_max_scene_duration_sec integer Optional 示例值: 8
单个 video 模式场景的最大规划时长(秒),范围 [4, 30],默认 15。
min_total_duration_sec integer Optional 示例值: 240
规划总时长下限(秒),范围 [1, 1800]。未传时按目标时长自动生成下限,通常约为目标的 85%。
max_total_duration_sec integer Optional 示例值: 300
规划总时长上限(秒),范围 [1, 1800]。未传时按目标时长自动生成上限,通常约为目标的 115%;若同时传入 min_total_duration_sec,需大于等于该下限。
返回数据
metadata metadata
请求元信息
task_id string 示例值: task-xxx
异步模式下的任务 ID,用于作业状态查询。
task_status string 示例值: PENDING
异步模式下的任务状态。PENDING:接收请求,RUNNING:正在运行,COMPLETED:已经完成,FAILED:失败。
business_code string 示例值: 0
业务码,0 表示成功。
error_msg string
如有异常,会返回详细的异常信息。
请求示例
返回示例
错误码
Poll
接口说明
查询视频脚本规划任务的执行状态和结果。
请求参数
返回数据
metadata metadata
请求的元信息
task_id string 示例值: task-xxx
任务 ID
task_status string 示例值: COMPLETED
任务状态。PENDING:接收到请求,RUNNING:正在运行,COMPLETED:已经完成,FAILED:失败。
submit_time string 示例值: 2026-07-21T16:04:06+08:00
任务提交时间,格式为 ISO 8601 时间戳。
end_time string 示例值: 2026-07-21T16:04:06+08:00
任务结束时间,格式为 ISO 8601 时间戳。
business_code string 示例值: 0
业务码,0 表示成功。
error_msg string
如有异常,会返回详细的异常信息。
data HyperVideoScriptPlannerResponse
返回的数据
intent_profile_path string 示例值: ""
意图画像 JSON 的对象存储路径。未提供 output_tos_path 时为空字符串;指定输出目录且生成该文件时返回实际路径。
intent_profile_uri string 示例值: https://example.com/intent_profile.json
意图画像 JSON 的下载链接。
production_plan_path string 示例值: ""
生产规划 JSON 的对象存储路径。未提供 output_tos_path 时为空字符串;指定输出目录且生成该文件时返回实际路径。
production_plan_uri string 示例值: https://example.com/production_plan.json
生产规划 JSON 的下载链接。
creative_brief_path string 示例值: ""
营销创意 JSON 的对象存储路径。未提供 output_tos_path 时为空字符串;指定输出目录且生成该文件时返回实际路径。
creative_brief_uri string
reference_analysis_path string 示例值: ""
参考资料分析 JSON 的对象存储路径。未提供 output_tos_path 时为空字符串;指定输出目录且生成该文件时返回实际路径。
reference_analysis_uri string
total_duration_sec double 示例值: 300.0
60.0
contains_multimodal_input boolean 示例值: true
是否包含任意有效的多模态输入。存在视频、文档、音频、图片或文本输入时为 true,否则为 false。
请求示例
返回示例
错误码
参考:输出 JSON 文件字段说明
intent_profile.json
intent_profile.json 描述用户想要什么内容,主要包含视频标题、规划领域、主题、关键知识点、受众、内容目标、内容单元、总时长、画幅、分辨率、输出语言、全局视觉风格、文字策略、音频策略、约束和假设等信息。关键字段包含:
production_plan.json
production_plan.json 描述下游如何生产视频,主要包含:
asset_plan 关键字段
人物、道具和背景的根节点表示主体身份,视觉生成信息放在一层 states 中。同一人物的不同年龄或服装、同一道具的完好或破损、同一背景的白天或夜晚属于同一主体的不同状态;同状态的不同视角可共用一个状态的多张原图。
states 关键字段
场景通过状态 asset_id 引用视觉素材;ref_image_* 是原图标识,不可填入 asset_refs。复用一个状态时应保留其全部 reference_images,不能只读取主图 uri 就认定已使用其余图片。逻辑主体不直接生图;封面等平铺素材仍在自身保存生成模型、提示词和 URI。新规划不再输出 reference_materials 或 reference_refs。
scene_plan 关键字段
场景与分镜的 audio
有分镜的 video 场使用 storyboards[*].audio,场级音频为空;frame 使用 scene.audio;hybrid 的配音在 scene.audio,分镜音频关闭。场景和分镜的 audio 不再直接存放 speaker_role、voice_style。声音状态可以与画面状态不同,例如画面使用幼年状态,旁白使用成年状态;不同人物或不同声音状态的台词分别保留。
以下为生产规划结构节选,展示两张内容原图属于同一人物状态及台词声音引用;省略其余章节、场景和组装字段。
creative_brief.json(可选)
营销任务生成营销创意时返回该文件;教育任务不返回。文件以 creative_brief 字符串保存用于规划的创意正文,保留原有换行与段落,不是另一份结构化生产规划。
reference_analysis.json(可选)
内容图片、PDF 或视频等参考资料产生分析结果时返回,教育和营销均适用。没有内容参考资料、仅有独立风格图或风格文字时不返回。即使 ref_strategy=none,资料仍可产生分析;分析中的来源标识不代表原图已被场景引用。
image_entities 的 entity_type 为 character、prop 或 background;其 states 中每项含 state_key、state_name、description、image_refs。image_refs 指向内容原图 ref_image_*,而 entity_key、state_key 解释识别分组,实际执行引用以生产规划中主体和状态的 asset_id 为准。文件直接保存分析对象,不额外包裹一层 reference_analysis。
所有产物均随完整任务成功后由 Poll 返回地址;未生成的可选文件会省略对应 path 和 uri 字段,不输出空文件。文件路径及返回条件见 Poll 接口。
最近更新时间:2026.10.21 20:48:58
这个页面对您有帮助吗?
有用
有用
无用
无用