容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务AI 云原生推理套件Helm 模板 AI 应用Qwen 实践快速部署基于 Dynamo 和 vLLM 的 Qwen3-235B (PD 分离)
 复制全文
 下载 pdf
快速部署基于 Dynamo 和 vLLM 的 Qwen3-235B (PD 分离)
 文档反馈
 问问助手
本文主要介绍使用容器服务(VKE)快速部署基于 Dynamo 和 vLLM 的 Qwen3-235B (PD 分离)模型推理服务。
方案介绍
本方案结合火山引擎的多项加速技术,提供在 Kubernetes 集群中快速部署 Qwen3-235B-A22B 模型的方法。
- Qwen3:由阿里云推出的最新一代通义千问大模型,它包含 2 款混合专家(MoE)与 6 款密集(Dense)模型,参数量从 0.6B 到 235B 不等,能满足多样化需求。
- Dynamo:NVIDIA Dynamo 是一个开源、低延迟的模块化推理框架,用于在分布式环境中服务生成式 AI 模型。
- GDKV 模型加速:由火山引擎提供的基于 RDMA + GDR(GPU Direct RDMA)技术实现的模型极速加载方案。
- 弹性极速缓存(EIC):由火山引擎存储团队面向大语言模型推理场景推出的高性能分布式 KV Cache 缓存服务。
- PD 分离技术:将推理过程分为两阶段,部署于不同硬件资源以优化性能:
- Prefill(预填充):计算密集型阶段。
- Decode(解码):显存密集型阶段。
部署信息
- 模型:Qwen3-235B-A22B
- 推理引擎:Dynamo、vLLM
- 实例规格:ecs.hpcpni3ln.45xlarge
- Prefill:推荐规格 * 1 台
- Decode:推荐规格 * 1 台
支持能力
- 并行策略:PD 分离
- 数据精度:FP8
- 模型加速:GDKV
- KV Cache:弹性极速缓存(EIC)
- 观测:托管 Prometheus(VMP)、应用性能监控全链路版(APMPlus)
- 访问:API 网关(APIG)
性能评估
开源场景与该模版优化后的效果对比如下表所示。
说明
性能结果与机器规格、分发配置、网络带宽等相关,最终以实际测试结果为准。
对比类别 | 开源 | 优化后 |
推理引擎 | vLLM (开源版) | Dynamo + vLLM(火山引擎优化版) |
Input/Output | 3500/1500 | 3500/1500 |
TTFT(ms) | <=5000 | <=5000 |
TPOT(ms) | <=50 | <=50 |
并行策略 | TP | PD 分离、TP |
单卡吞吐 TPS | 897 | 1595 |
使用说明
- 本实践涉及较多组件,相互间有依赖,配置复杂,为了获得符合预期的结果,请务必根据本文指引操作。
- 同时开启 GDKV 模型加速和 EIC 弹性极速缓存时,实例节点的内存可能成为瓶颈。如有性能需求,建议只开启 EIC,操作方式,详见:EIC 性能测试方法。
- 为了获得符合预期的结果,同时符合容器服务的 使用限制,请按照本文方案(或在本文推荐的资源上)操作。如需替换方案,您可以联系对应的火山引擎客户经理咨询。
- 请勿使用 mGPU 对 GPU 进行切分。
- 完整的部署流程,依赖部分火山引擎邀测能力,请联系火山引擎客户经理申请如下功能的邀测试用:
-
前提条件
创建高性能计算集群
说明
高性能集群所在的 地域和可用区 需要与 VKE 节点的 地域和可用区 一致。
创建 VKE 集群
配置项 | 说明 |
集群配置 | |
Kubernetes 版本 | 选择 v1.28 及以上版本。 |
容器网络模型 | 选择 VPC-CNI。 |
节点池配置 | |
托管节点池 | 开启 托管节点池。 |
可用区 | 与 高性能计算集群 所在的可用区相同。 |
计算规格 | 选择已申请邀测的高性能计算 GPU 型ecs.hpcpni3ln规格。 |
高性能计算集群 | 选择之前创建的高性能计算集群。 |
节点数量 | 2 个。 |
数据盘 | 配置如下两个数据盘:
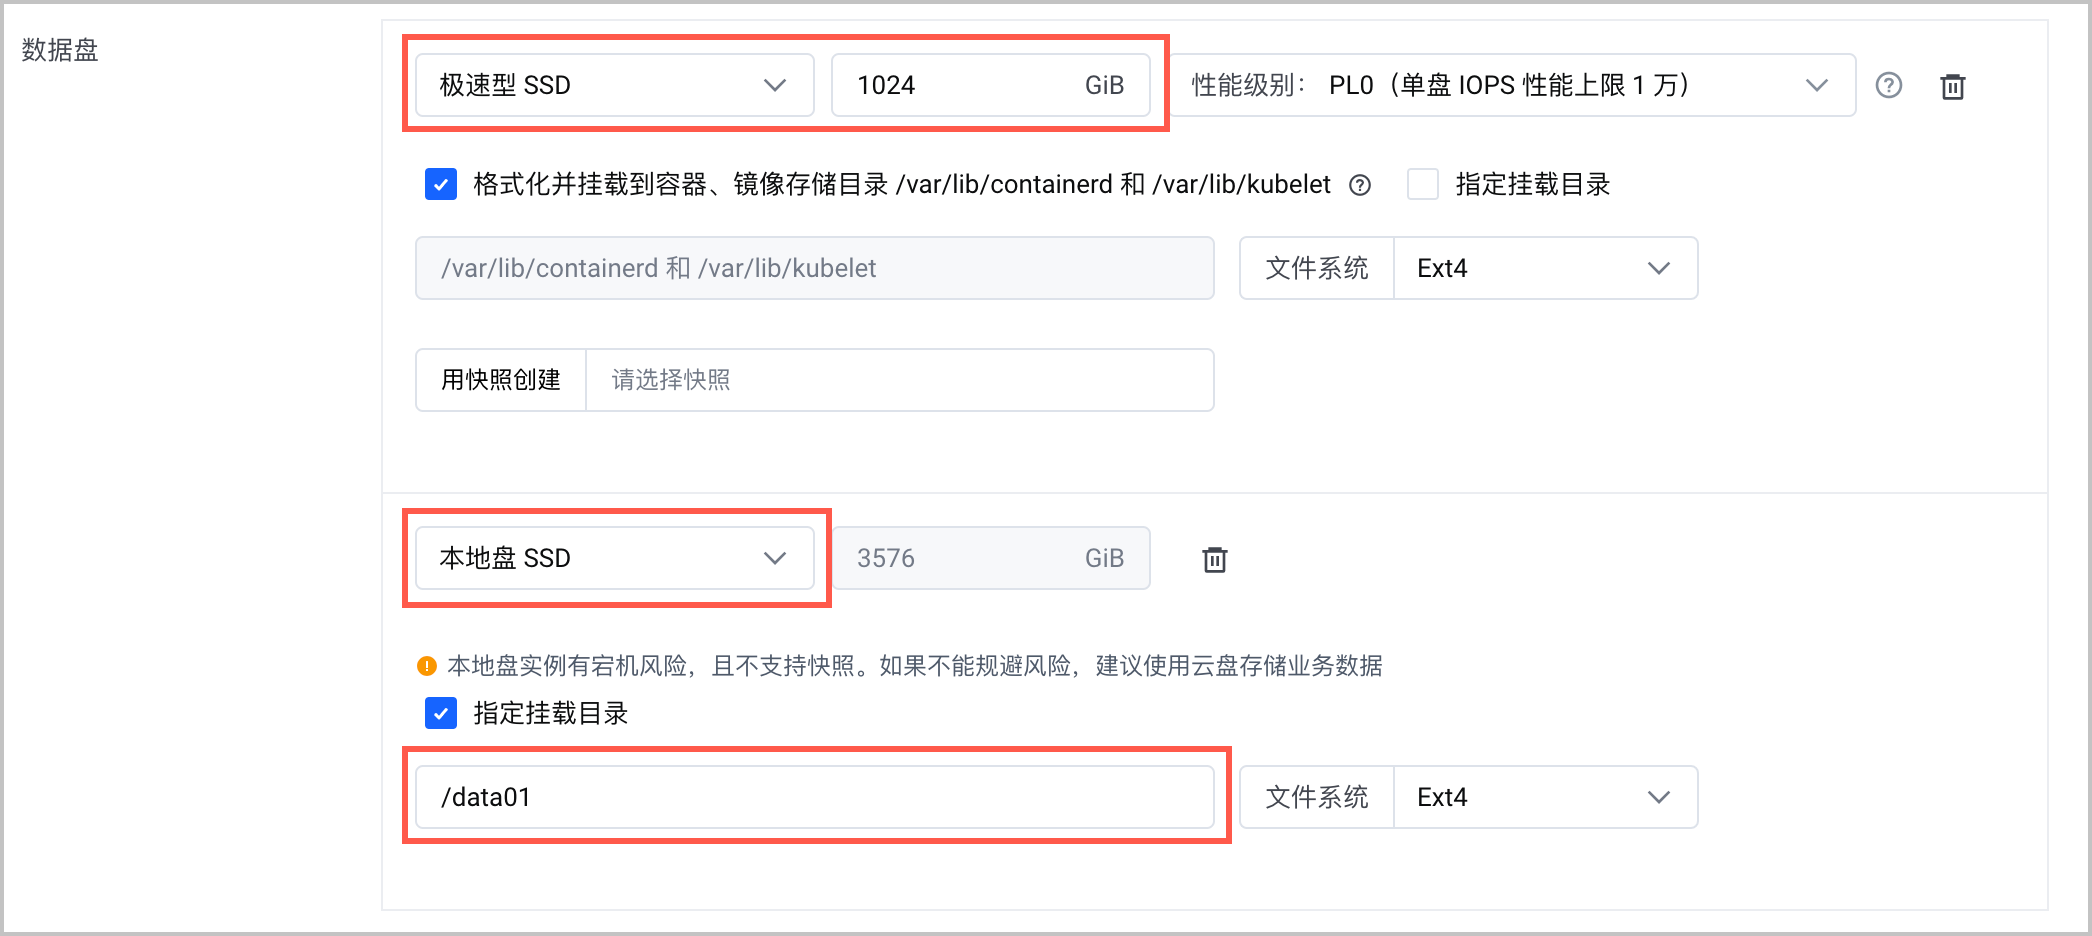 |
节点标签 (Labels) | 通过 VKE 部署模型时,需设置节点标签来配置 RDMA 使用模式。 标签键设置为:vke.node.rdma.mode,标签值设置为:shared。 |
Kubelet 自定义参数 | 通过 VKE 部署模型时,需通过 Kubelet 自定义参数配置 RDMA 设备的 NUMA 亲和策略。 参数选择:topology-manager-policy,参数值选择:best-effort。 |
组件配置 | |
nvidia-device-plugin | (必装)NVIDIA 设备驱动,支持在容器里使用 GPU 显卡设备的管理组件。 |
rdma-device-plugin | (必装)支持 RDMA 网卡设备的管理,提供 Pod Container 使用 RDMA 设备能力。 |
apig-controller | (必装)API 网关控制器,提供云原生的 AI 网关能力,根据不同策略完成推理流量的智能负载均衡。 |
csi-ebs | (必装)支持容器集群使用存储服务的标准 CSI 接口实现。 |
prometheus-agent | (必装)托管 Prometheus 监控组件,采集 Kubernetes 集群监控指标数据到火山引擎托管 Prometheus 服务(VMP)。 |
apmplus-opentelemetry-collector | (必装)采集 OpenTelemetry 数据和 Prometheus 指标并发送至应用性能监控全链路版(APMPlus)。 |
apmplus-server-agent | (必装)采集服务和主机监控数据并发送至 APMPlus。 |
cr-credential-controller | (推荐安装)免密拉取镜像仓库(CR)镜像,简化部署操作。 |
keda | (推荐安装)基于 Kubernetes 的事件驱动的弹性伸缩器。基于复杂指标完成推理服务的弹性伸缩任务。 |
vci-virtual-kubelet | (推荐安装)利用弹性容器实例部署系统组件等 CPU 工作负载,免运维且不占用 GPU 节点计算资源。 |
操作步骤
步骤一:创建 EIC 实例
EIC 通过以存代算、GDR 零拷贝等方式大幅降低推理 GPU 资源消耗,优化推理时延。
- 登录 弹性极速缓存控制台。
- 在左侧导航栏选择 实例管理,单击 创建实例。
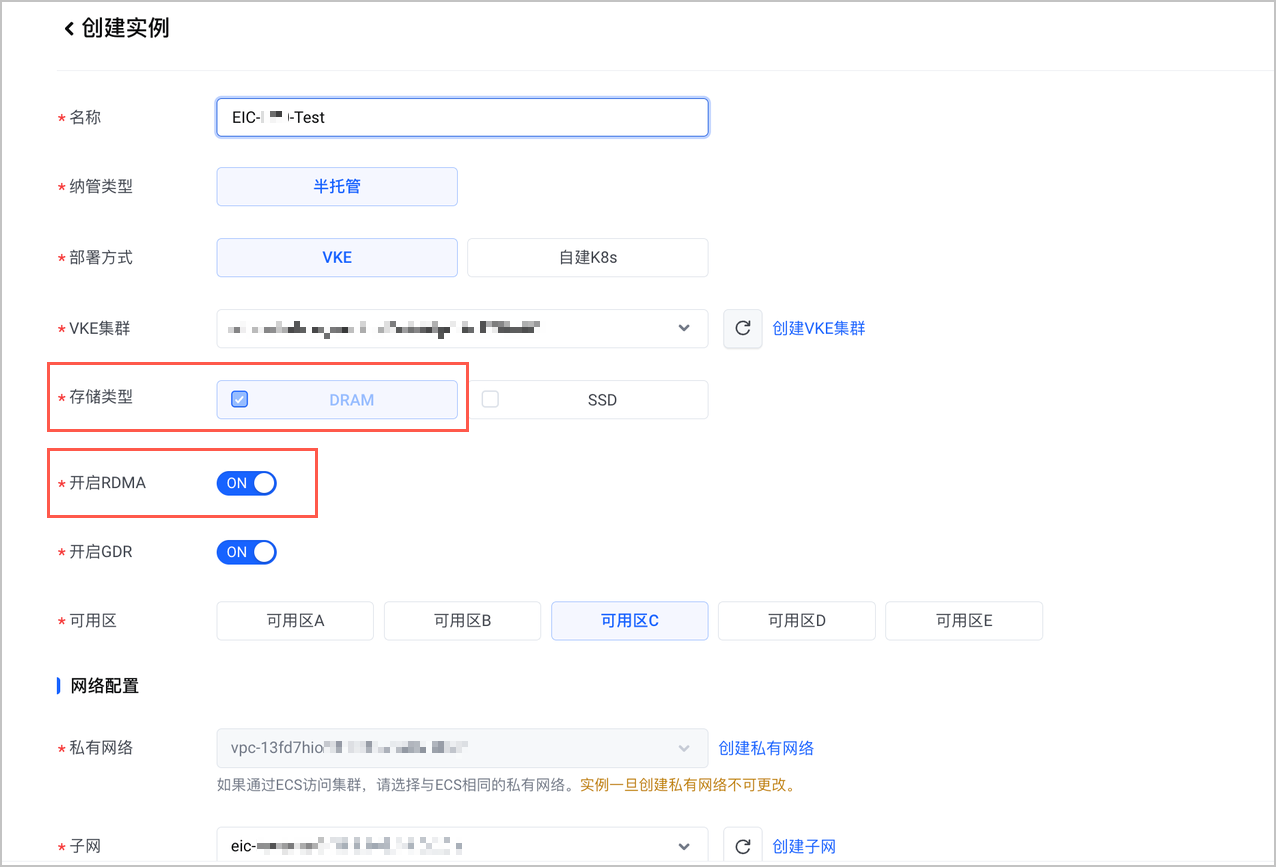
- 根据界面提示配置实例参数,其中部分参数按如下说明配置,其余参数按需自定义配置。
-
-
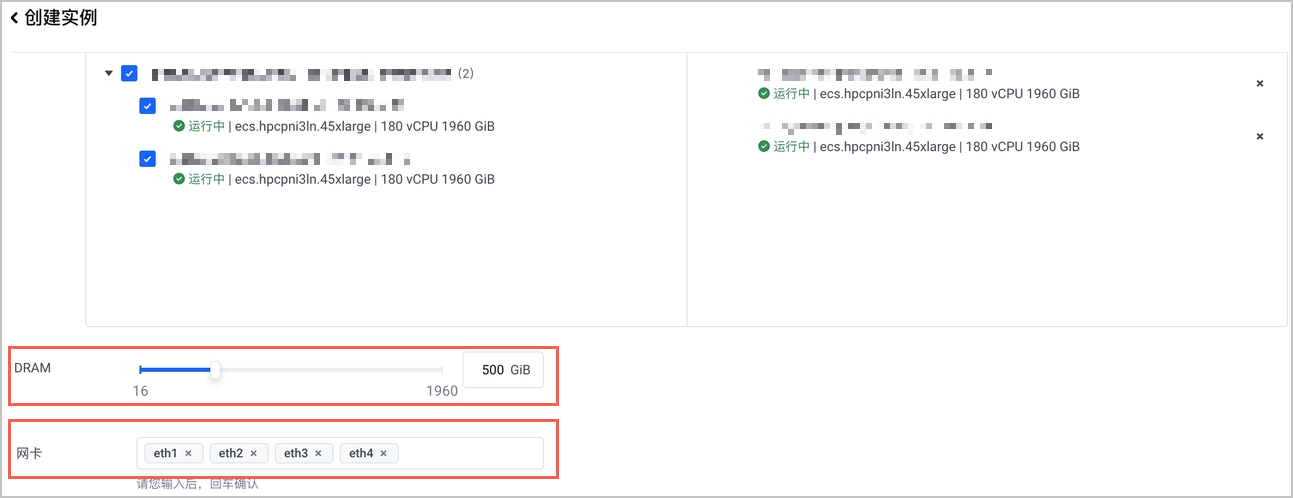
- 配置项说明VKE 集群选择之前创建的 VKE 集群。存储类型选择 DRAM。开启 RDMA开启。节点选择创建 VKE 集群时关联创建的节点。DRAM设置为 500 GiB。网卡设置为eth1、eth2、eth3、eth4。
- 单击页面右下角的 创建实例。实例状态显示 运行中,表示 EIC 实例创建成功。
- 如果创建实例时发生错误,实例状态将转变为 创建失败,您可以将鼠标悬浮到实例状态上查询具体失败原因。确认原因后单击实例对应的 删除 按钮来销毁实例,然后重新创建实例。若无法自行处理,请联系火山引擎客户经理获取相关技术支持。
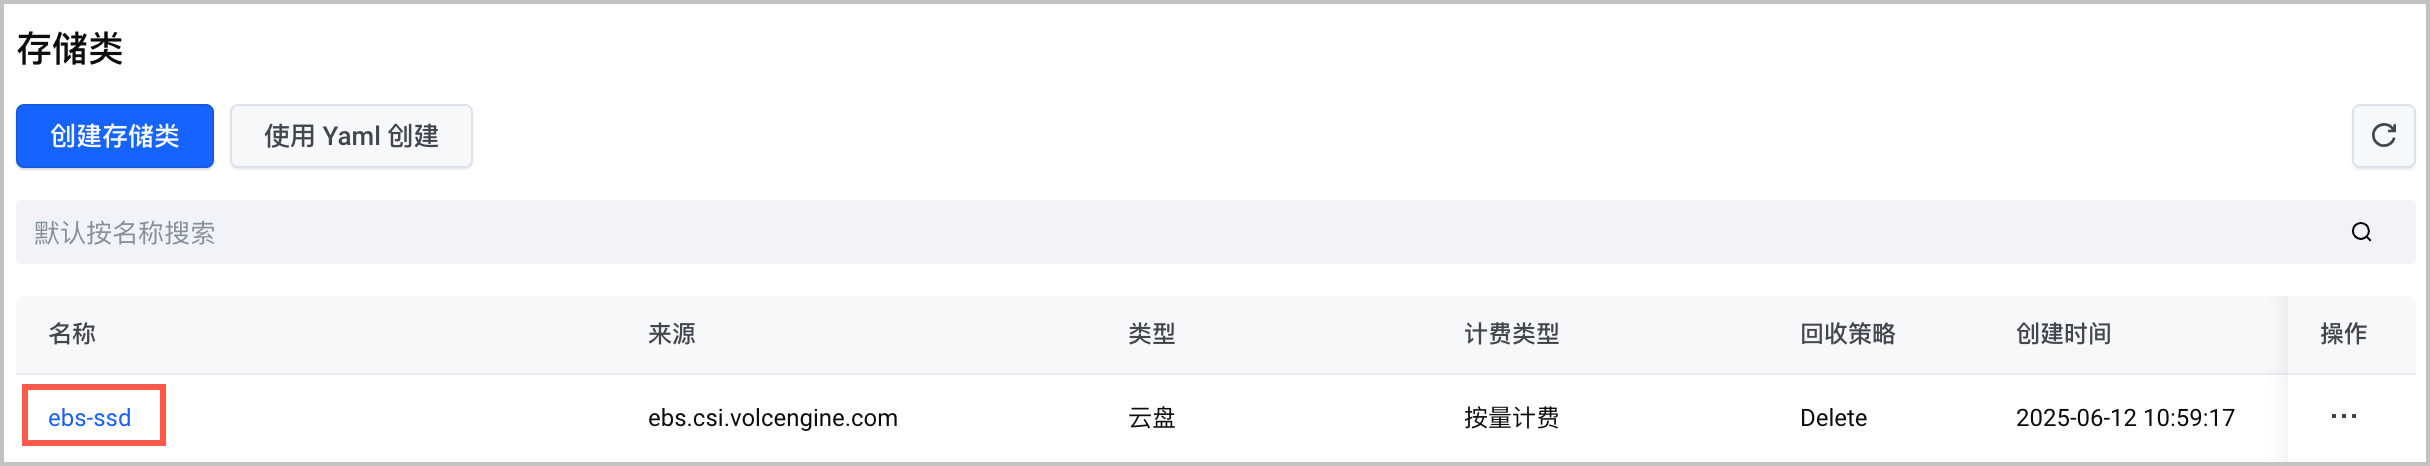
步骤二:确认 NATS 和 ETCD 需要的存储类
说明
步骤三:部署 qwen3-dynamo-vllm-pd
容器服务基于 Dynamo 和 vLLM 框架提供 PD(Prefill-Decode)分离的 Qwen3-235B-A22B 模型应用,可通过 应用模版 快速部署。
- 在 容器服务控制台 左侧导航栏,选择 应用中心 > 应用模板。
- 在 应用模板 页面,找到 qwen3-dynamo-vllm-pd 应用模板,单击 立即部署。
- 在 部署应用 页面,配置 qwen3-dynamo-vllm-pd 服务参数。其中,部分参数按如下说明配置,其余参数根据界面提示或参考 应用模板 中的说明配置。
- 配置项说明编排模板应用模板选择 qwen3-dynamo-vllm-pd 的 Chart 版本,建议选择最新版本。参数配置qwen3-dynamo-vllm-pd 的配置方法。单击values.yaml后的编辑图标,可编辑当前应用的 YAML 文件。其中,部分配置项说明请见下方表格。名称根据界面提示的命名要求,自定义应用名称。部署环境集群选择 前提条件 中创建的 VKE 集群。命名空间自定义选择目标集群下的命名空间。协议阅读了解协议内容后勾选协议。
- 支持按需编辑修改values.yaml文件配置,部分参数说明如下表所示,建议保持默认配置。
- 配置项说明示例值modelConfig.local.path用于存放模型文件的 ECS 本地路径,务必与前置条件中的数据盘匹配。/data01/modelsprefillWorker.replicasPrefill 节点部署的副本数。1decodeWorker.replicasDecode 节点部署的副本数。1decodeWorker.routerDecode 节点的 Router 算法。round-robinetcd.persistence.storageClassETCD 使用的存储类。ebs-ssdetcd.persistence.sizeETCD 存储的大小。10Ginats.config.cluster.enabledNATS 是否使用 cluster 配置。truenats.config.cluster.replicasNATS cluster 副本数,大于等于3。3nats.config.jetstream.fileStore.pvc.storageClassNameNATS 使用的存储类。ebs-ssdnats.config.jetstream.fileStore.pvc.sizeNATS 存储的大小。10Gi
- 如需启用 EIC,可按照如下代码块及其注释说明,修改应用的values.yaml文件配置。
- kvcacheConfig:eic:enabled : true# EIC 实例 ID。登录弹性极速缓存控制台,进入实例详情页面的“实例信息”页签查看。instanceId: "eicydx97nk******" # EIC 实例的 Endpoint。登录弹性极速缓存控制台,进入实例详情页面的“实例信息”页签查看。endpoint: "192.168.xx.xx:12500;192.168.xx.xx:12500;192.168.xx.xx:12500"# EIC 节点网卡。登录弹性极速缓存控制台,进入实例详情页面的“节点列表”页签查看。ClientMultiNetLocalInterfaceNames: "eth1;eth2;eth3;eth4"
- 单击 确定,部署完成应用。
- 应用部署完成后会显示在 Helm 应用 页面。选择目标项目、集群、命名空间,找到已部署的 qwen3-dynamo-vllm-pd 应用,单击名称,进入详情页面查看该应用的基本信息、关联创建的工作负载、服务、其他资源等。
-
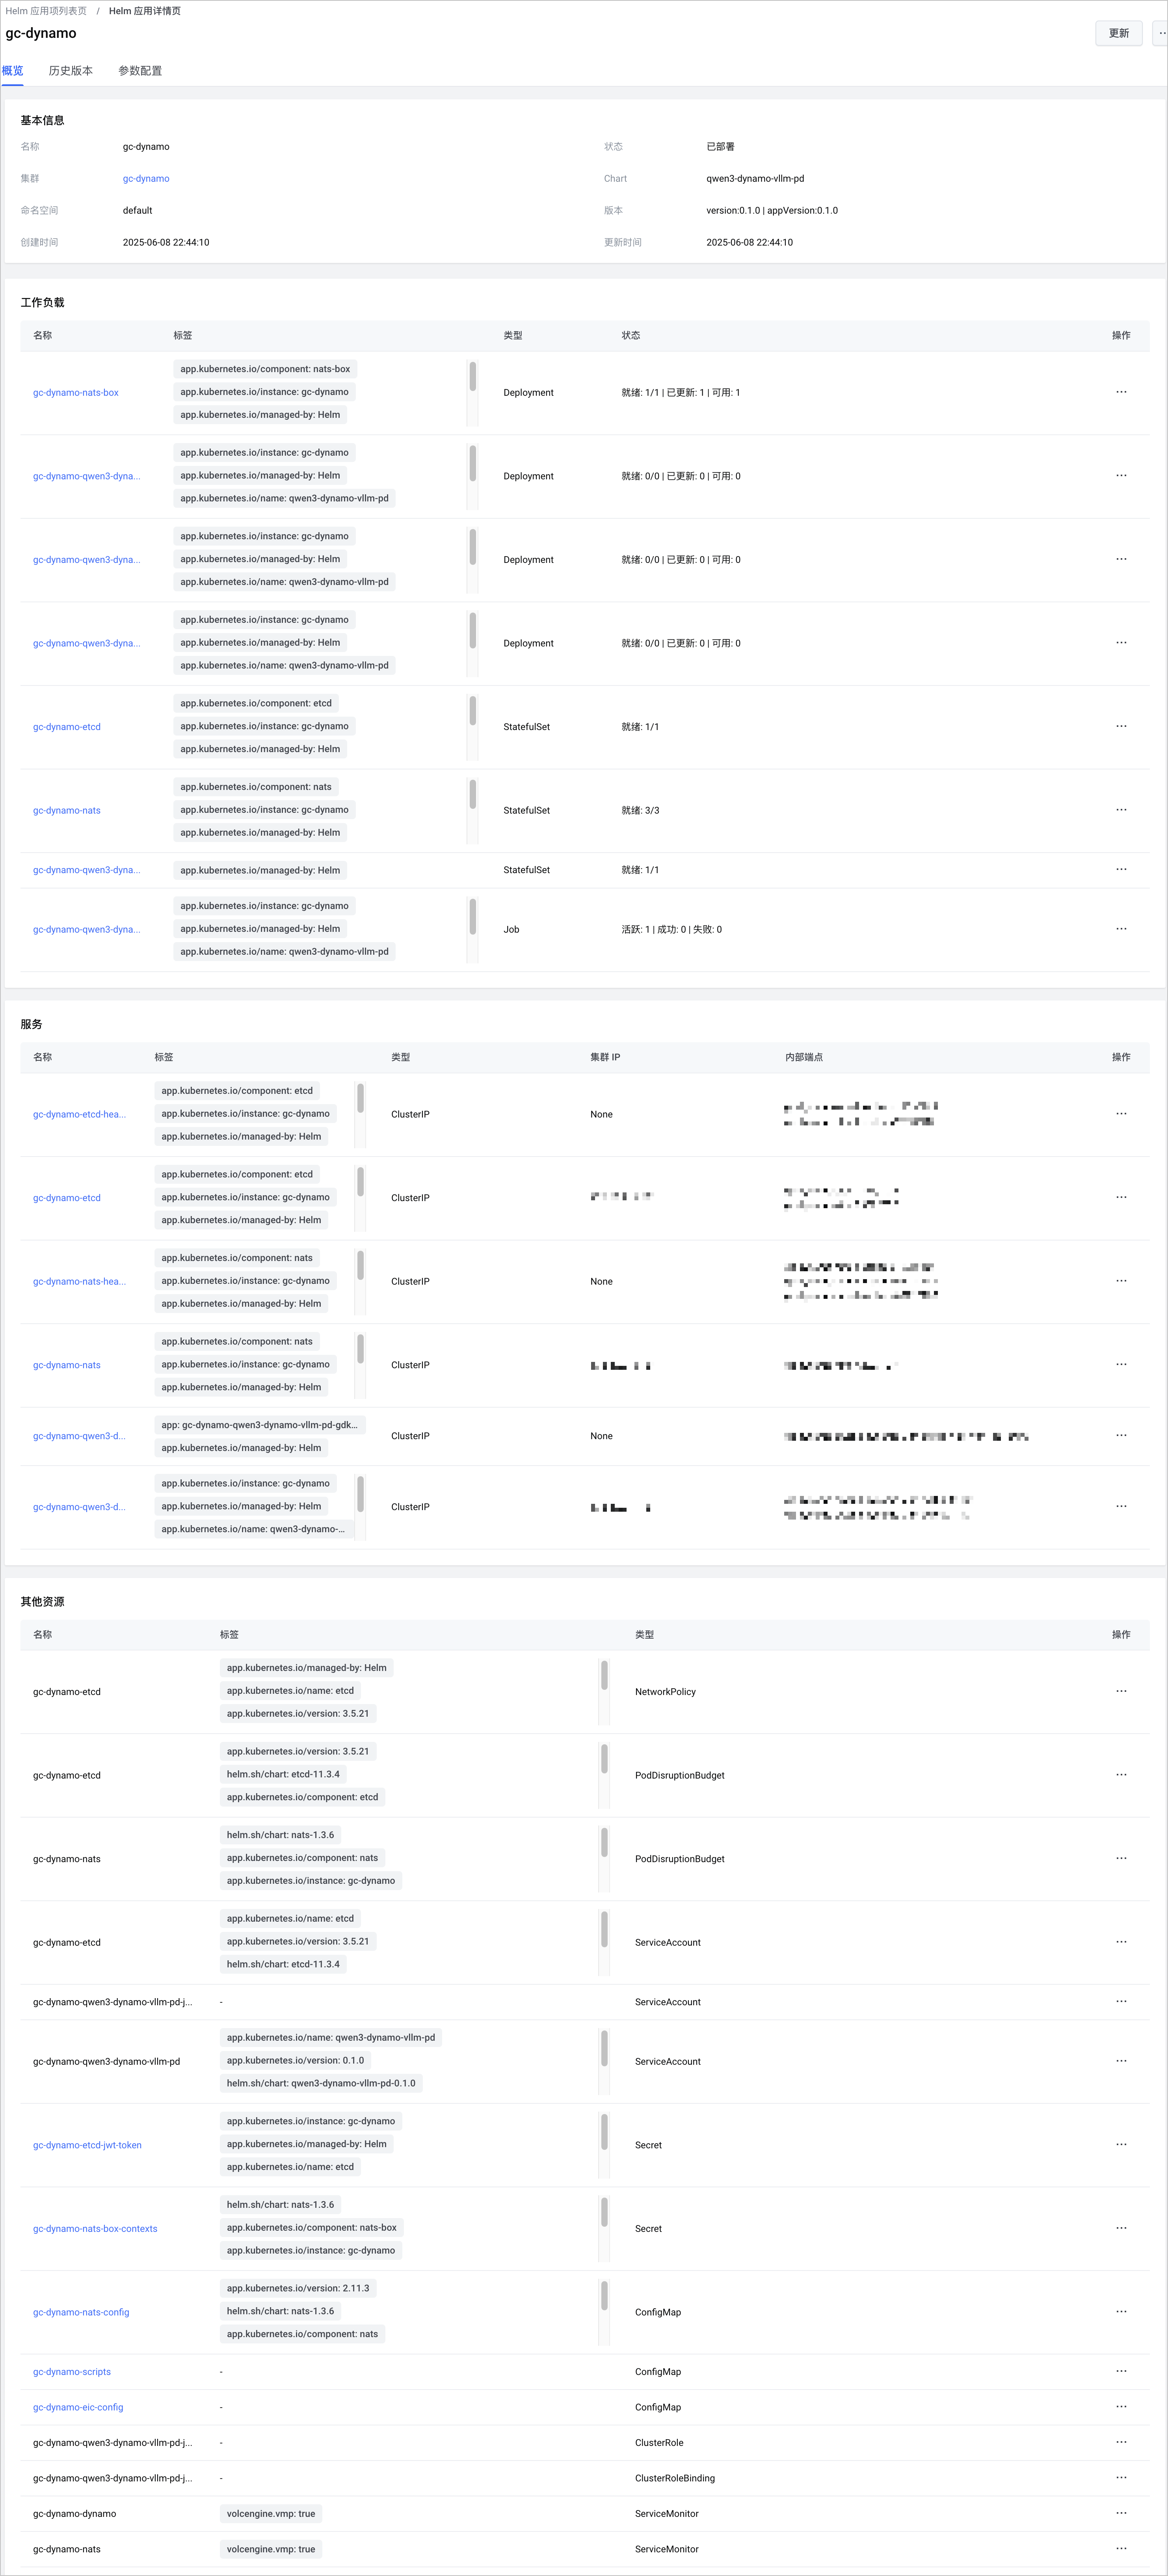
说明
其中,<应用名称>-qwen3-dynamo-vllm-pd格式的服务,是该应用对外暴露的服务(Service)名称,后续配置路由、模型验证等步骤,需要关联该服务。
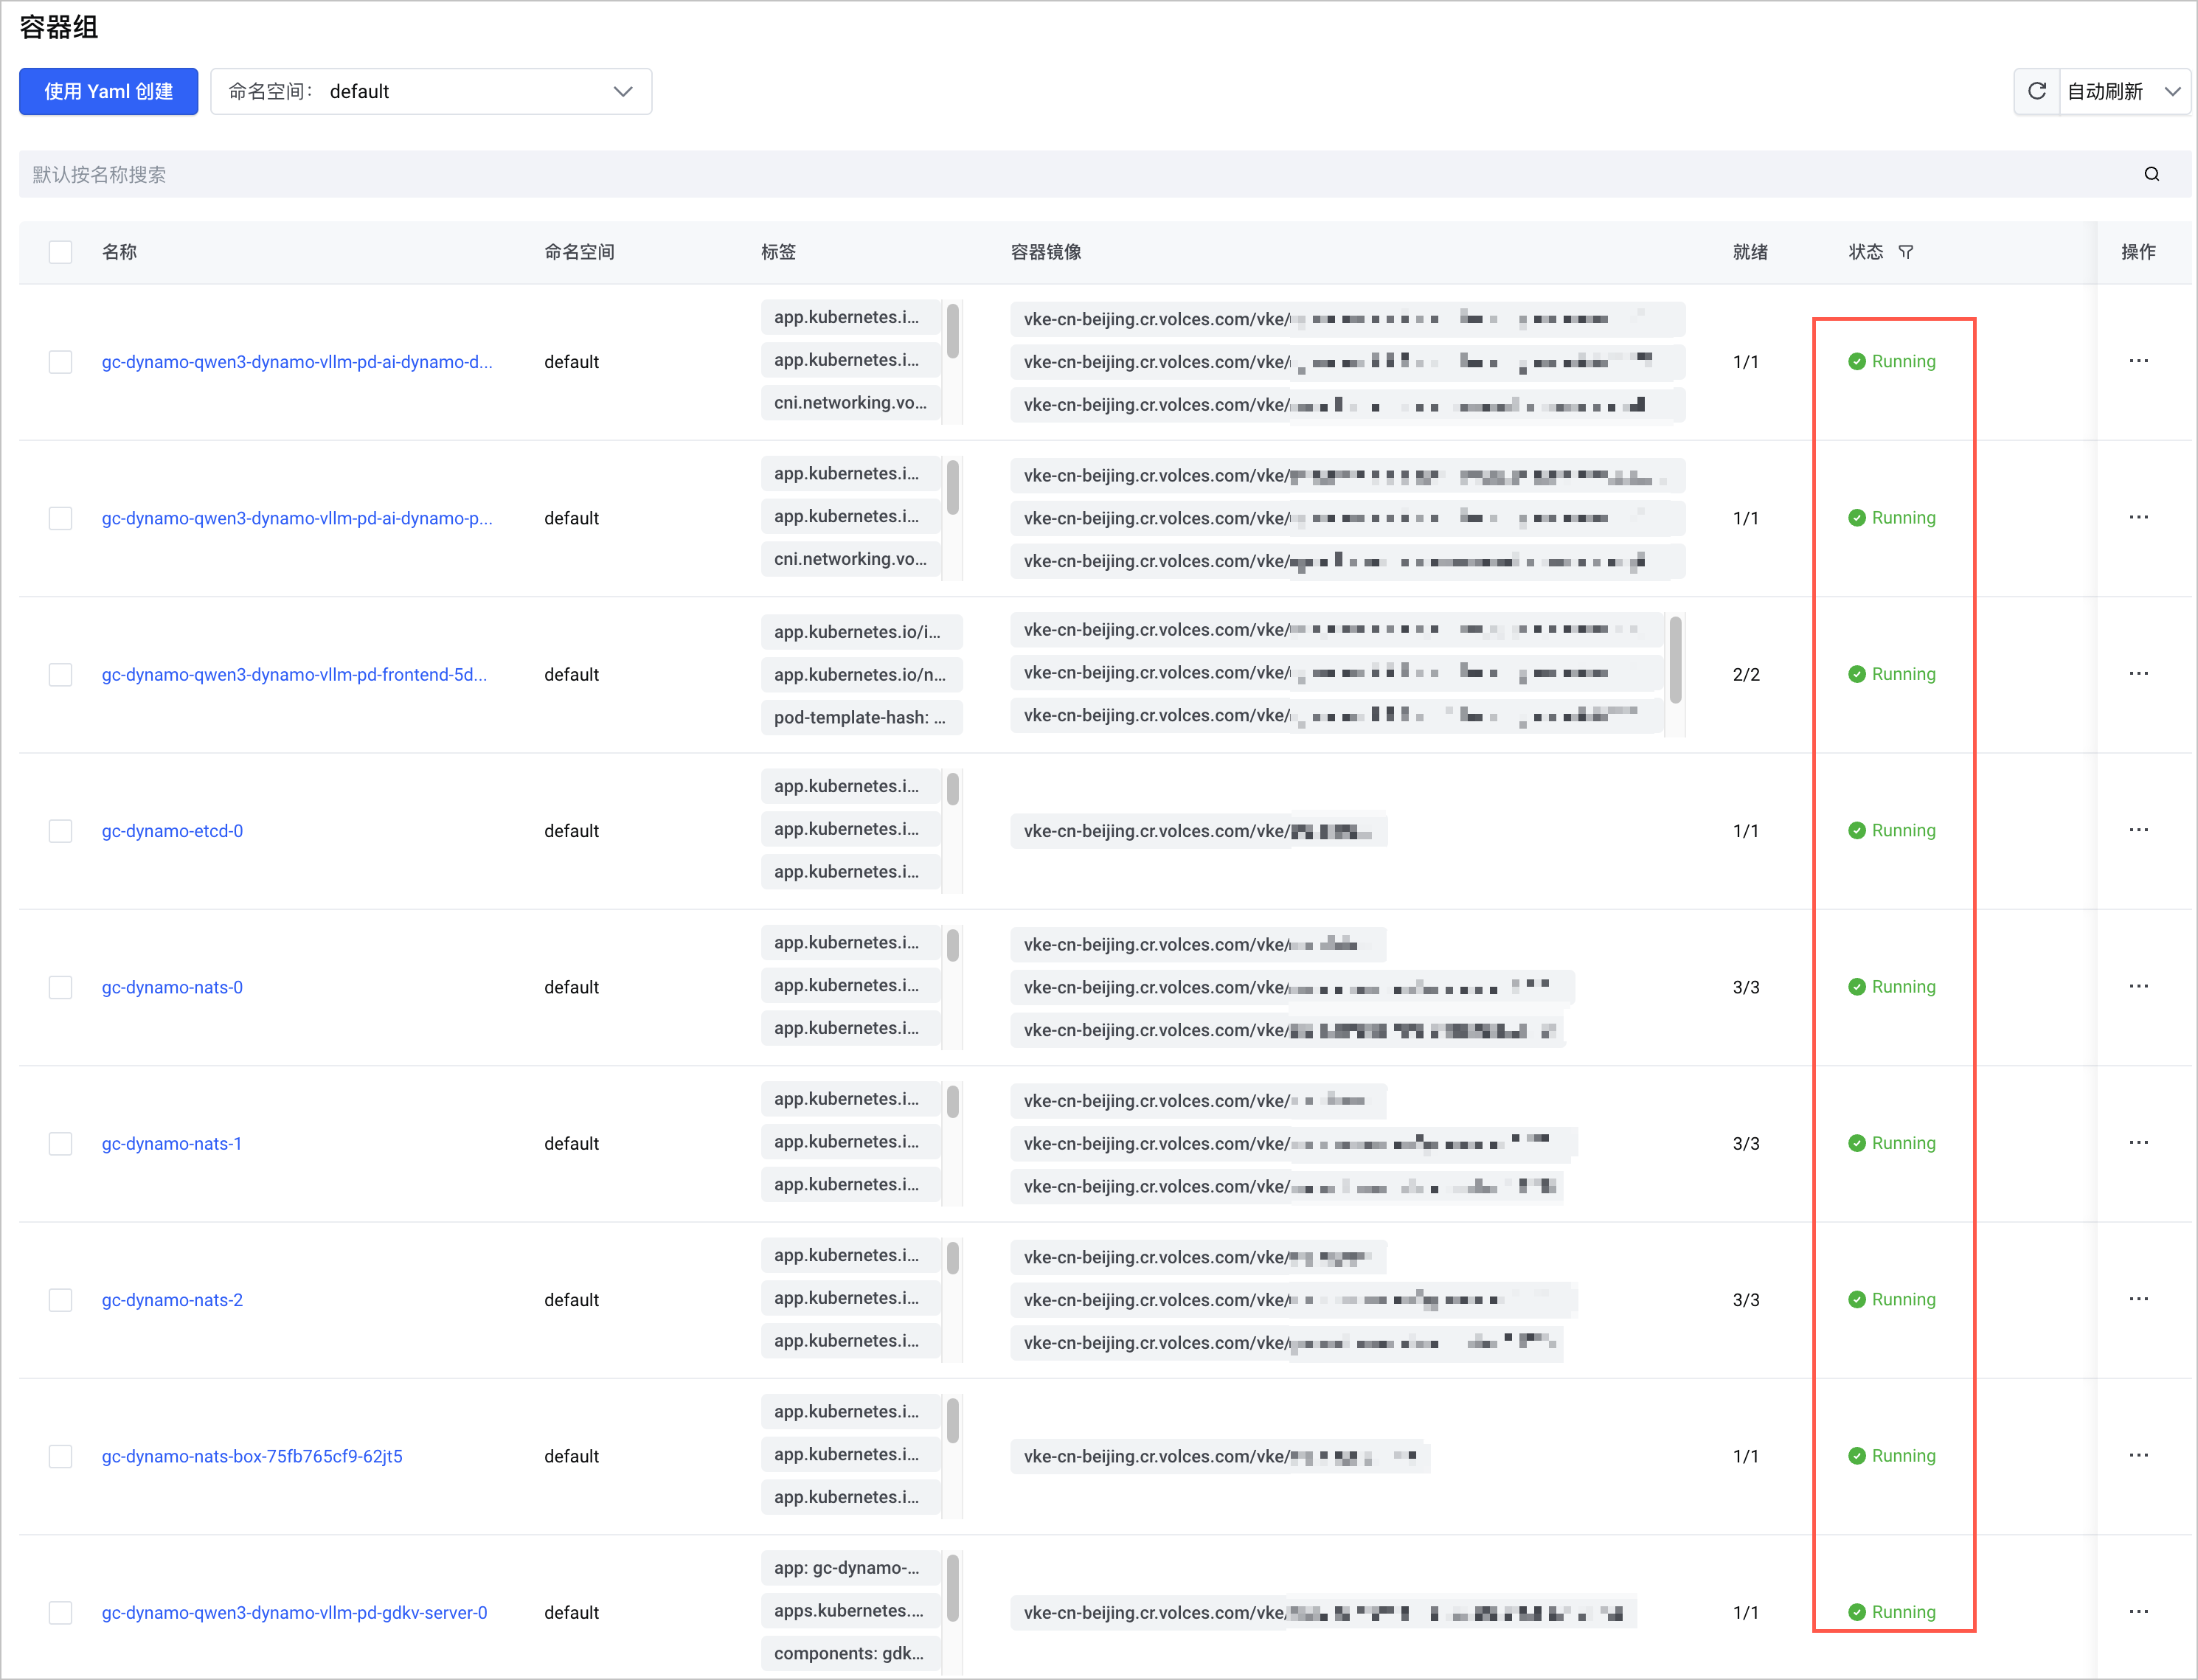
- 在 VKE 集群的 容器组 页面,查看 qwen3-dynamo-vllm-pd 应用对应的 Pod 状态。
- 在 容器服务控制台 左侧导航栏,选择 集群,找到目标集群并单击集群名称。
- 在目标集群管理页面选择 工作负载 > 容器组,然后搜索 qwen3-dynamo-vllm-pd 应用对应的名称,查看相关 Pod 的状态。
-
步骤四:配置路由
通过 APIG Ingress 配置模型路由。APIG Ingress 基于火山引擎 API 网关(API Gateway,APIG) 提供托管的云原生网关功能,实现高可用、高扩展的 Ingress 流量管理方式,满足在云原生应用场景下对业务流量稳定性和高可用性的需求。
- 在集群管理页面的左侧导航栏中,选择 服务与路由 > 路由规则,单击 创建路由规则。使用 API 网关对外暴露集群内的模型服务。部分参数按如下说明配置,其余配置详情,请参见 通过控制台创建 APIG Ingress。
- 配置项说明基本配置命名空间选择部署 qwen3-dynamo-vllm-pd 应用模板的命名空间,用于关联该应用对外暴露的服务。Ingress 配置Ingress 类型选择 云原生 API 网关。网关 APIG 规格配置网关规格可以选择 自动创建,也可以选择 使用已有 APIG 实例。说明使用 API 网关暴露集群中的模型服务时,建议配置如下参数或功能(部分参数仅 APIG 控制台支持配置,VKE 控制台无相关配置):
- 实例规格:建议选择 4c8g 规格,默认双可用区高可用。
- 熔断: 当某些 GPU 实例出现异常时,一般会希望尽快将故障实例下线,避免故障持续。同时希望能够保留故障现场为后续进一步排查提供依据。 可以通过配置网关的熔断规则,将出现故障的实例进行隔离。
- 可观测性:在 VKE 控制台上创建的 API 网关实例,默认情况下未开启监控告警和日志功能。如有需要,建议您在 API 网关控制台 中开启对应实例的日志和监控告警能力。
- 实例监控:能够帮助您从入口网关层面及时发现整个系统链路上的非预期现象。例如:后端不健康、后端 Crash 等,在 API 网关会报503错误码,以及具体的错误详情。
- 实例日志:从访问日志里能够查看请求错误详情、请求耗时、请求在后端各个 Pod 的分布等详情。
后端 Upstream负载均衡算法 建议配置为 轮询。在后端负载近似均衡的前提下,更适用于后端升级变更的场景。监听配置协议转发配置域名填写需要暴露的 Ingress 域名。后续该域名的 A(Address)记录需要配置当前 Ingress 创建成功后生成的公网 IP 地址或者私网 IP 地址。服务选择部署 qwen3-dynamo-vllm-pd 应用模板时,关联创建的<应用名称>-qwen3-dynamo-vllm-pd格式名称的服务,端口号设置为 8000。
- (可选)配置 API 网关认证鉴权。
- 登录 API 网关控制台。
- 创建消费者:在左侧导航栏选择 消费者管理,单击 创建消费者。
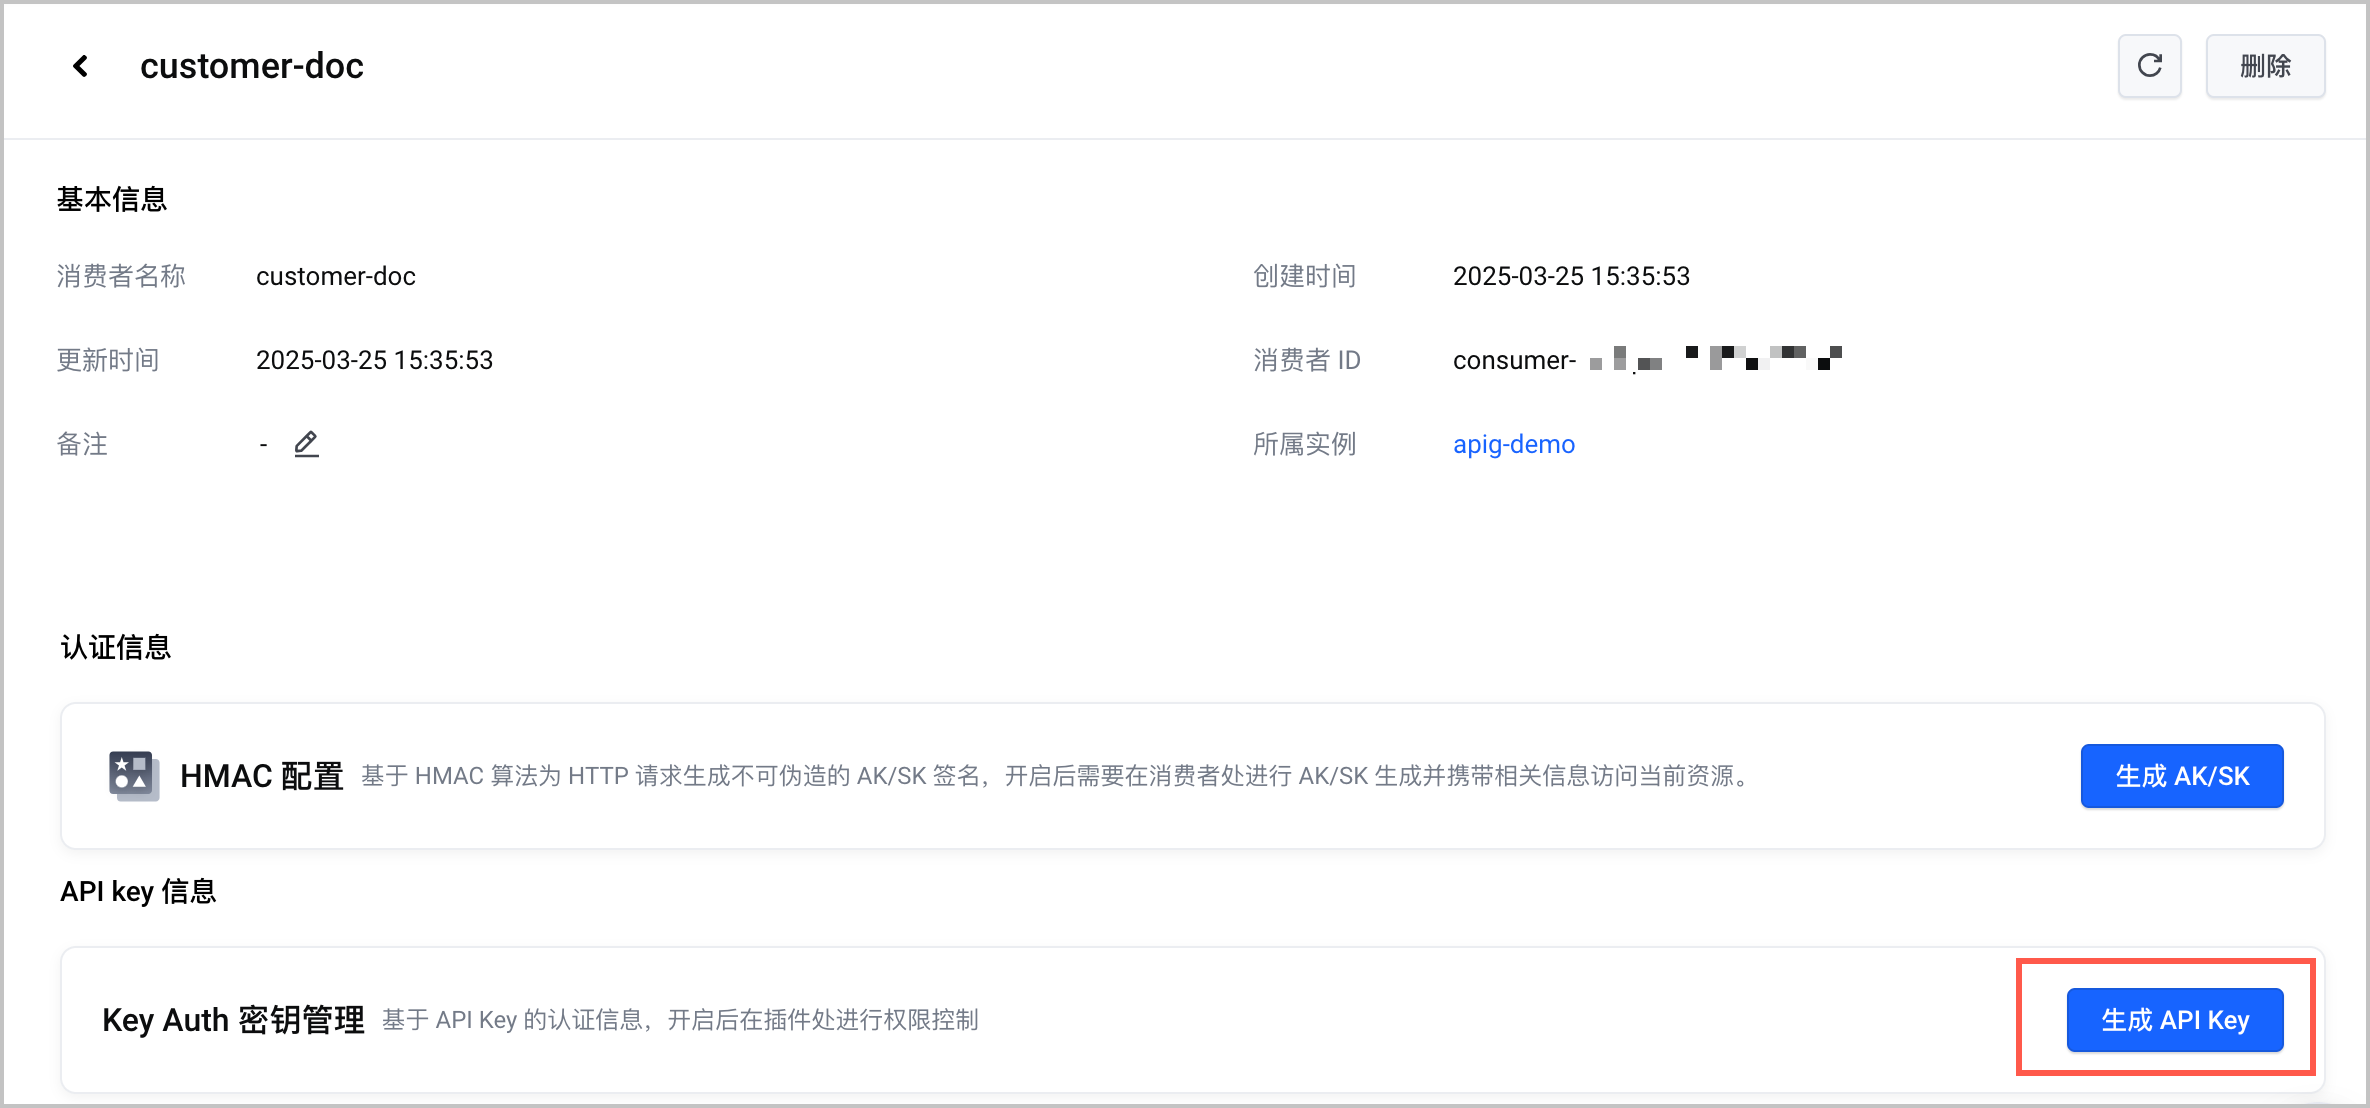
- 生成 API-KEY :在消费者列表中,单击目标消费者名称,进入消费者详情页面。在 API Key 信息区域,单击 生成 API Key。
-
- 在弹出的对话框内容选择 自动创建 API Key 认证信息。
-
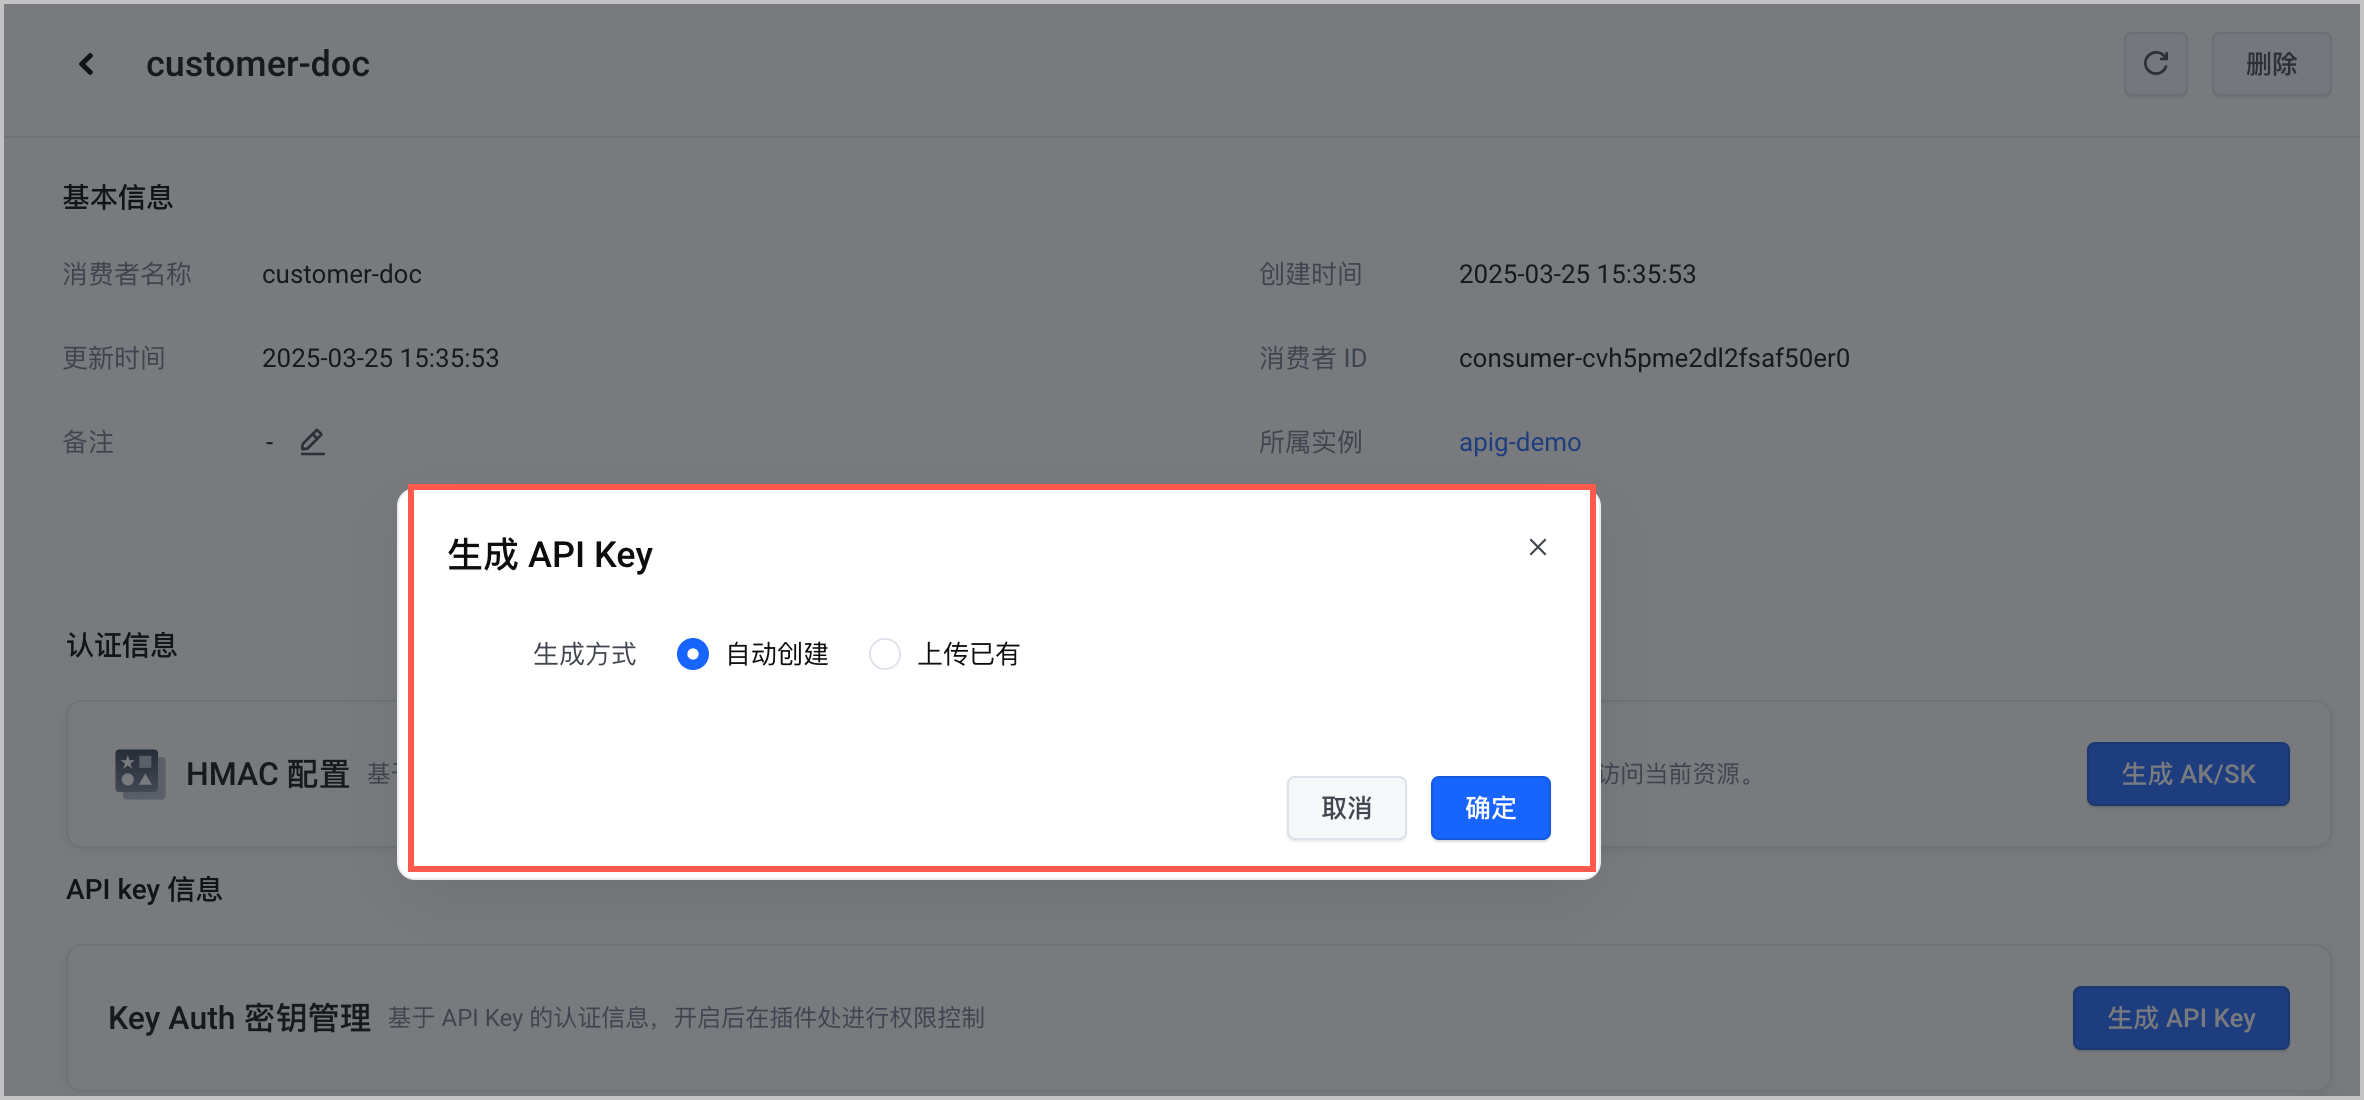
- 单击 确定,生成 API Key 认证信息。
-
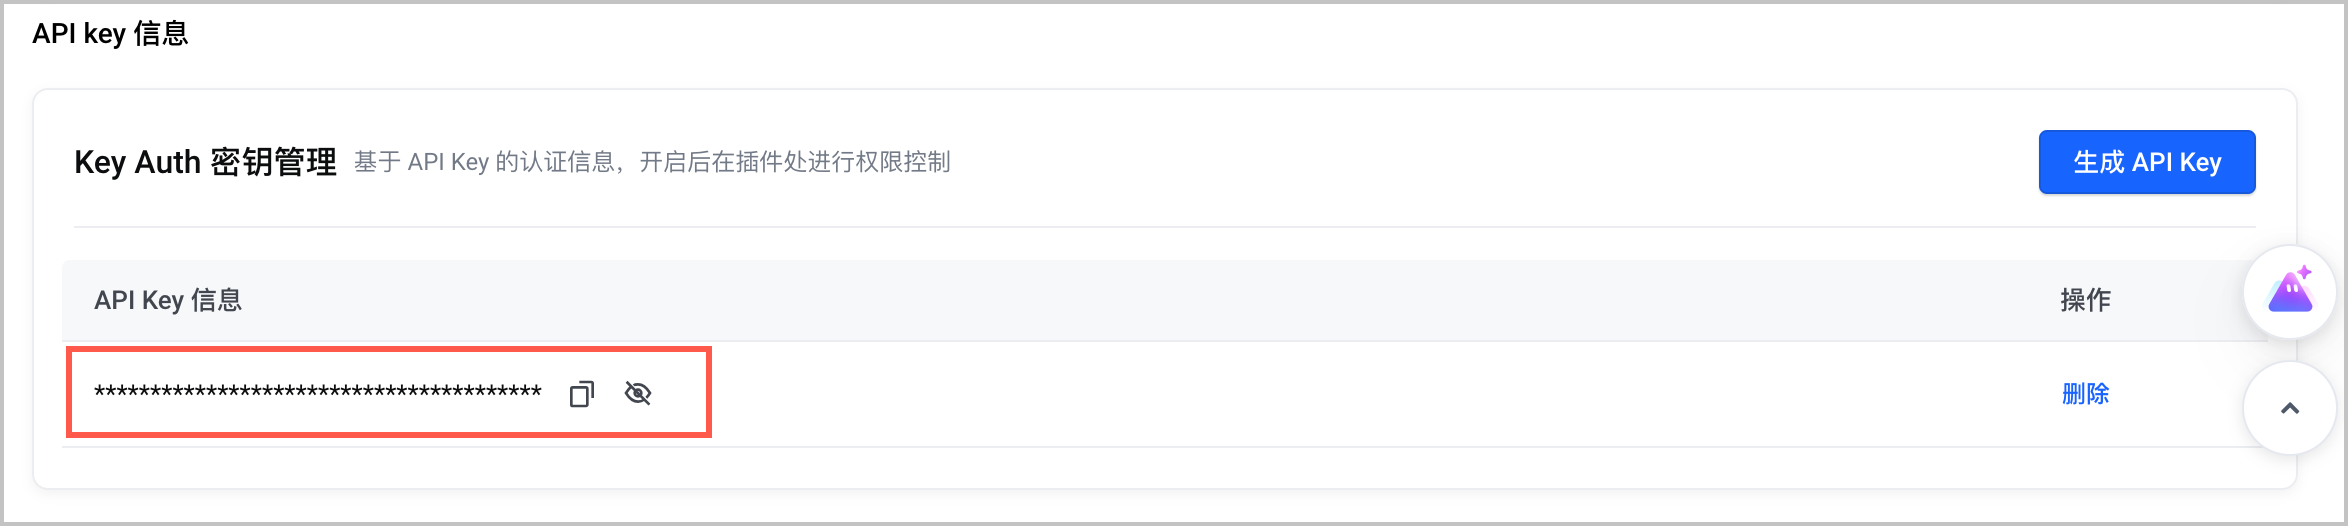
- 启用 Key Auth 插件:在左侧导航栏选择 插件管理 > Key Auth插件,单击 创建插件,配置插件参数。
- 生效级别:选择 路由级别,并配置插件所属实例、服务和路由。
- 认证配置:选择 header,并配置来源为 Authorization,表示在请求头中的 Authorization 附带 API Key 认证信息。
- 消费者:选择步骤一中创建的消费者。
- 其他配置保持缺省。
- 获取 Ingress 地址。
-
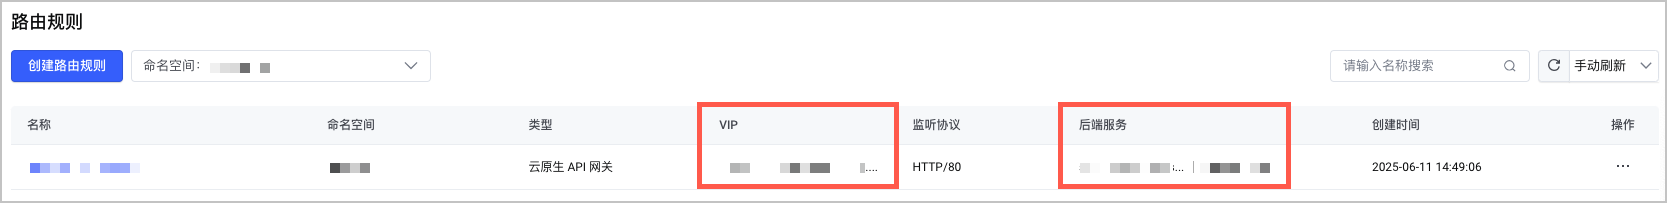
- VIP:包含公网访问 IP 和私网访问 IP。
- 后端服务:包含后端服务名称和访问域名。
- 配置域名解析。
- 在本机上可以配置 IP 和域名的解析进行测试。
- 在生产环境,请在域名提供商中配置 Ingress 的访问域名,且确保 Ingress 访问域名的 A 记录已配置 Ingress 的公网 IP 地址或者私网 IP 地址。
步骤五:开启观测配置
基础观测提供 AI 资源及推理服务的监控指标,深度观测提供推理应用的全链路性能监控服务。
基础观测
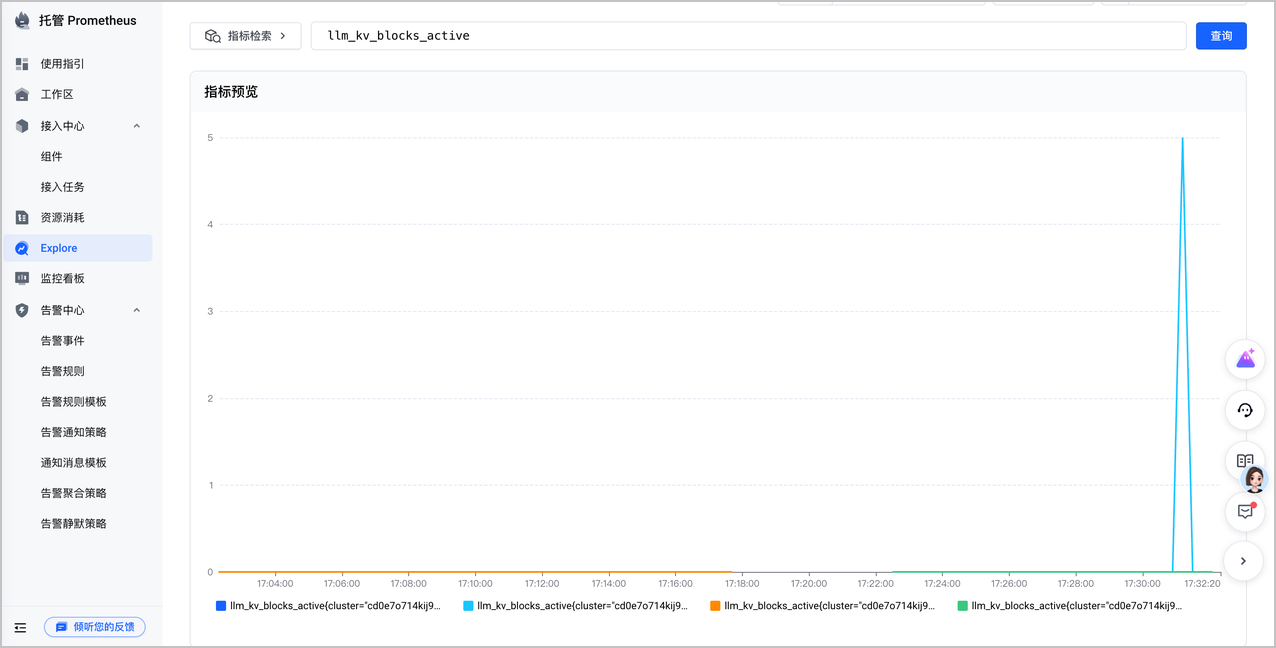
- 开启观测后,Dynamo 指标会被采集到托管 Prometheus(VMP)服务,您可以在托管 Prometheus 控制台中使用 Explore 查询指标,示例如下:
-
- 查看 Dynamo 应用监控。
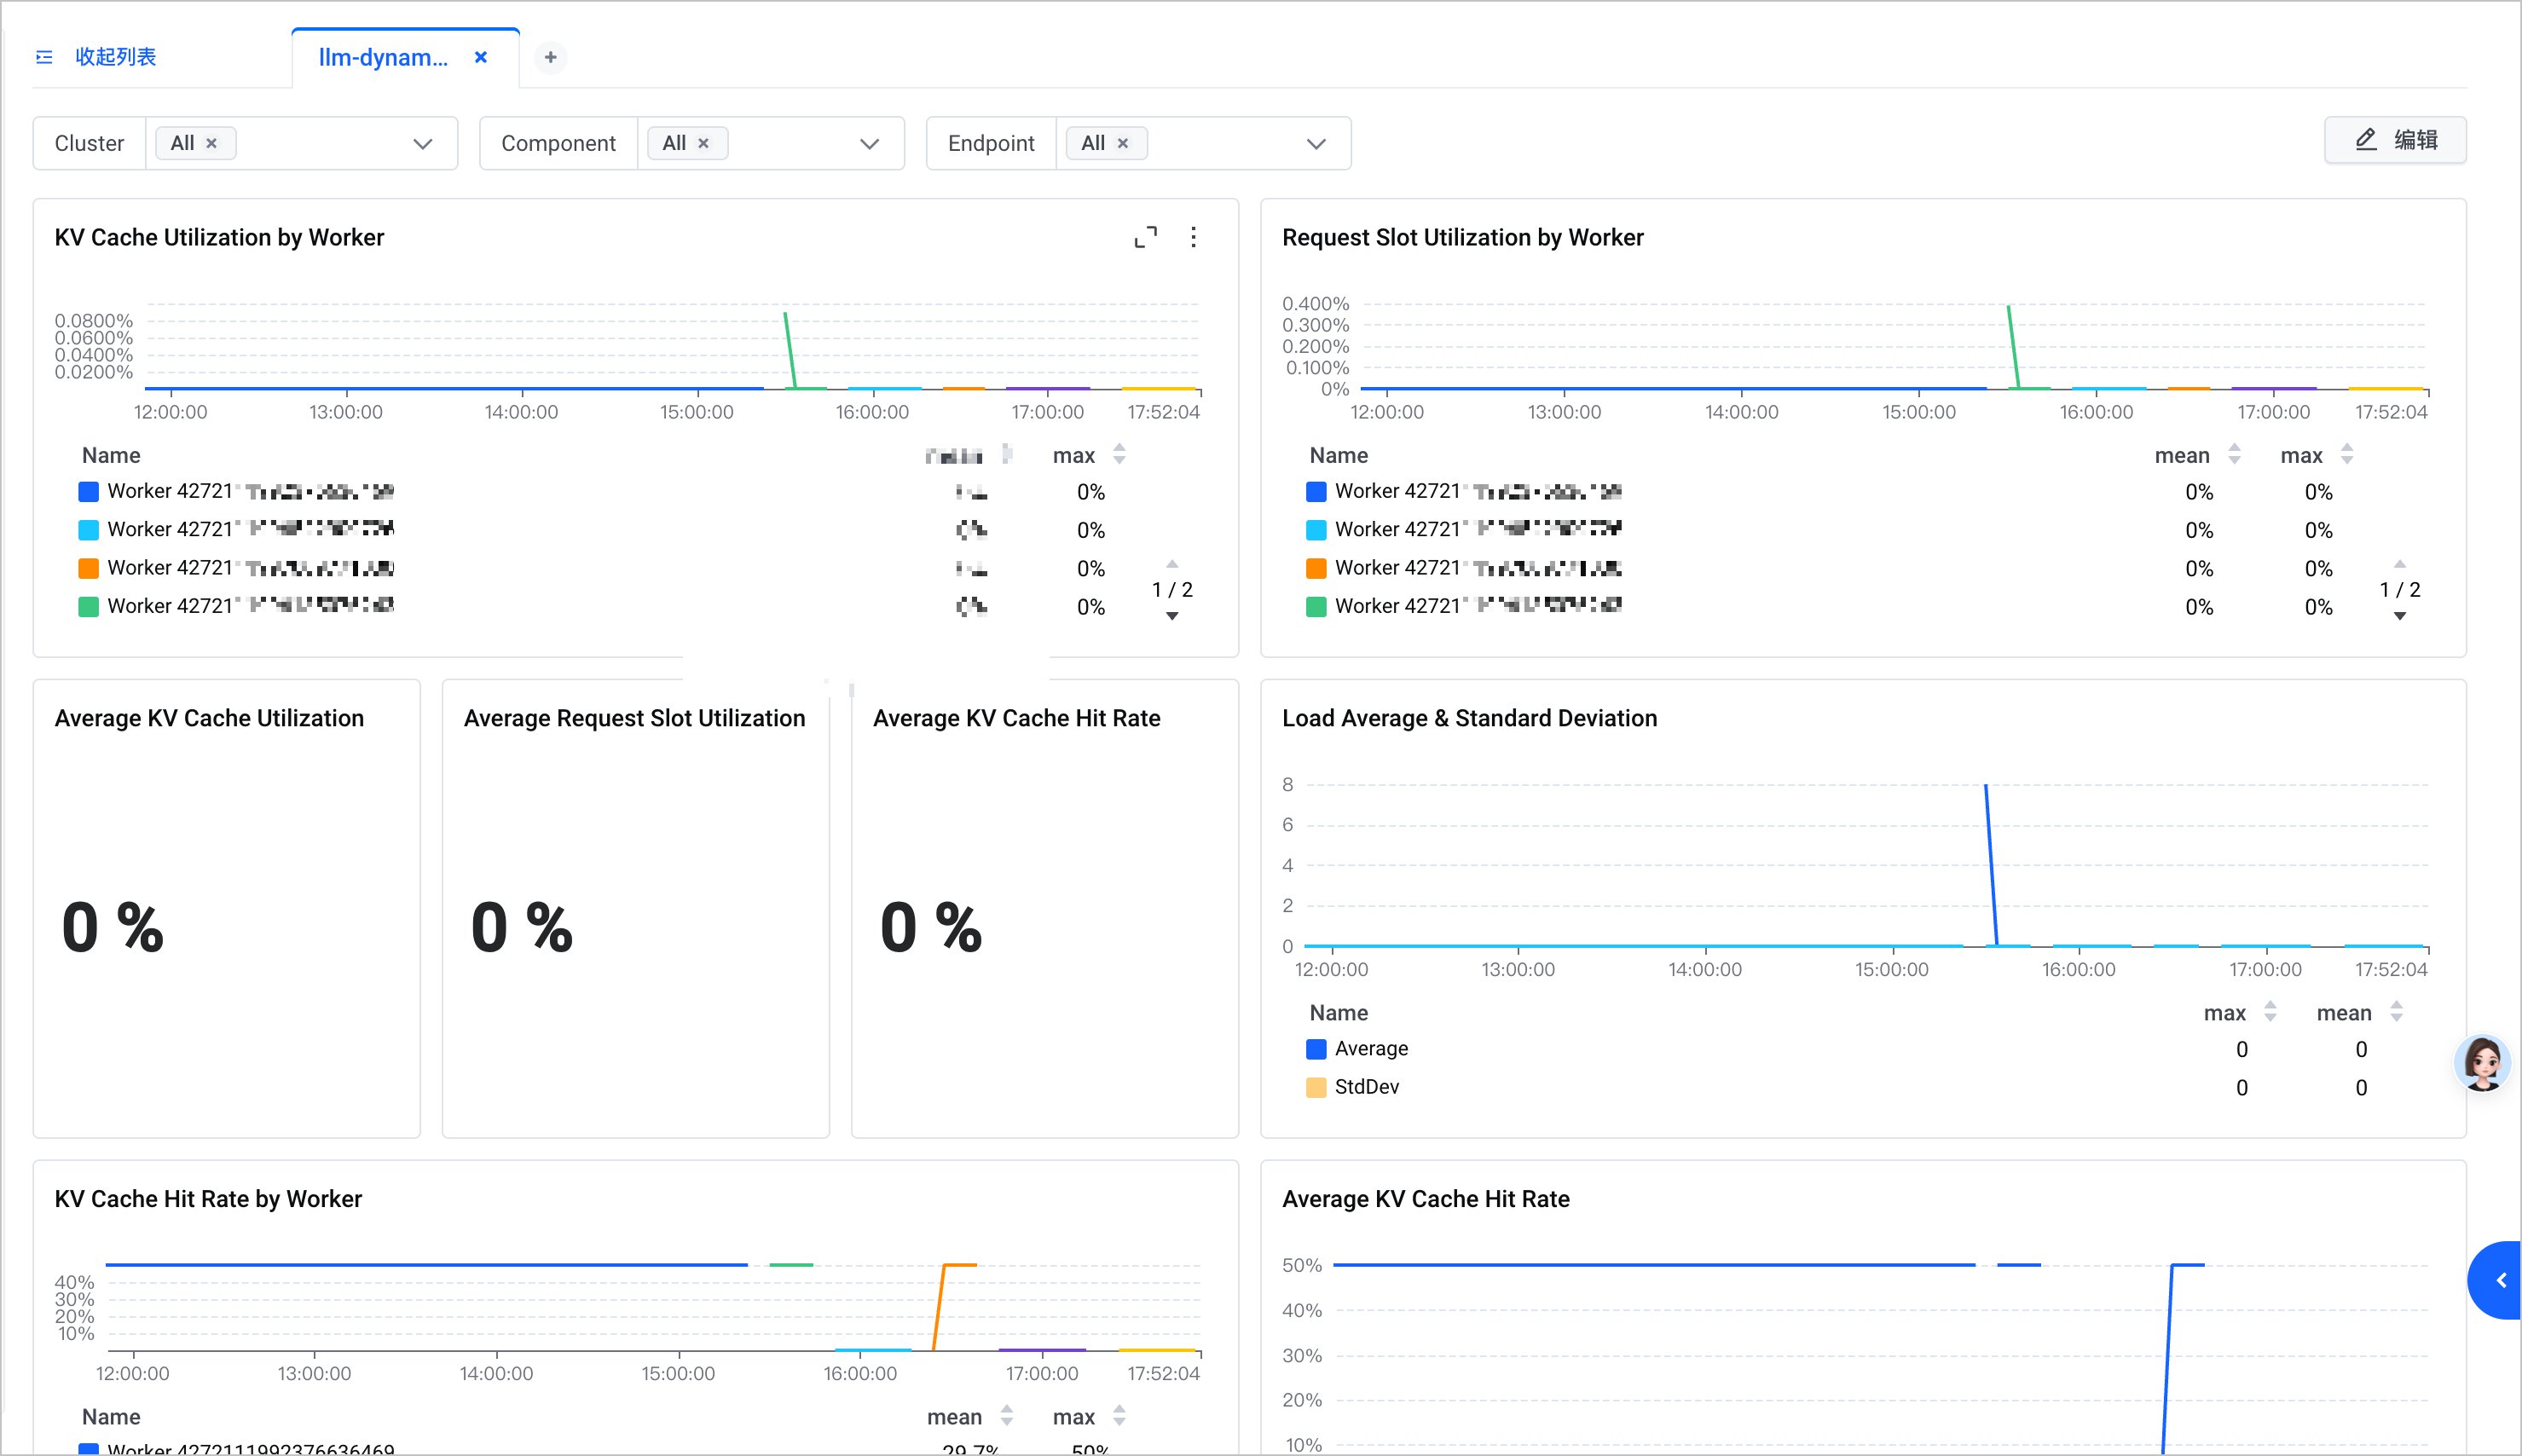
- 您可以使用 VMP 预置面板查看 Dynamo 应用监控,在 VMP 服务控制台,选择 监控看板,搜索dynamo,可查看到如下示例所示的 Dynamo 应用看板:
-
- 您也可以自建 Grafana,并搭建 Dynamo 的监控看板。操作方式请参见 在容器服务集群中部署 Grafana 并接入工作区。
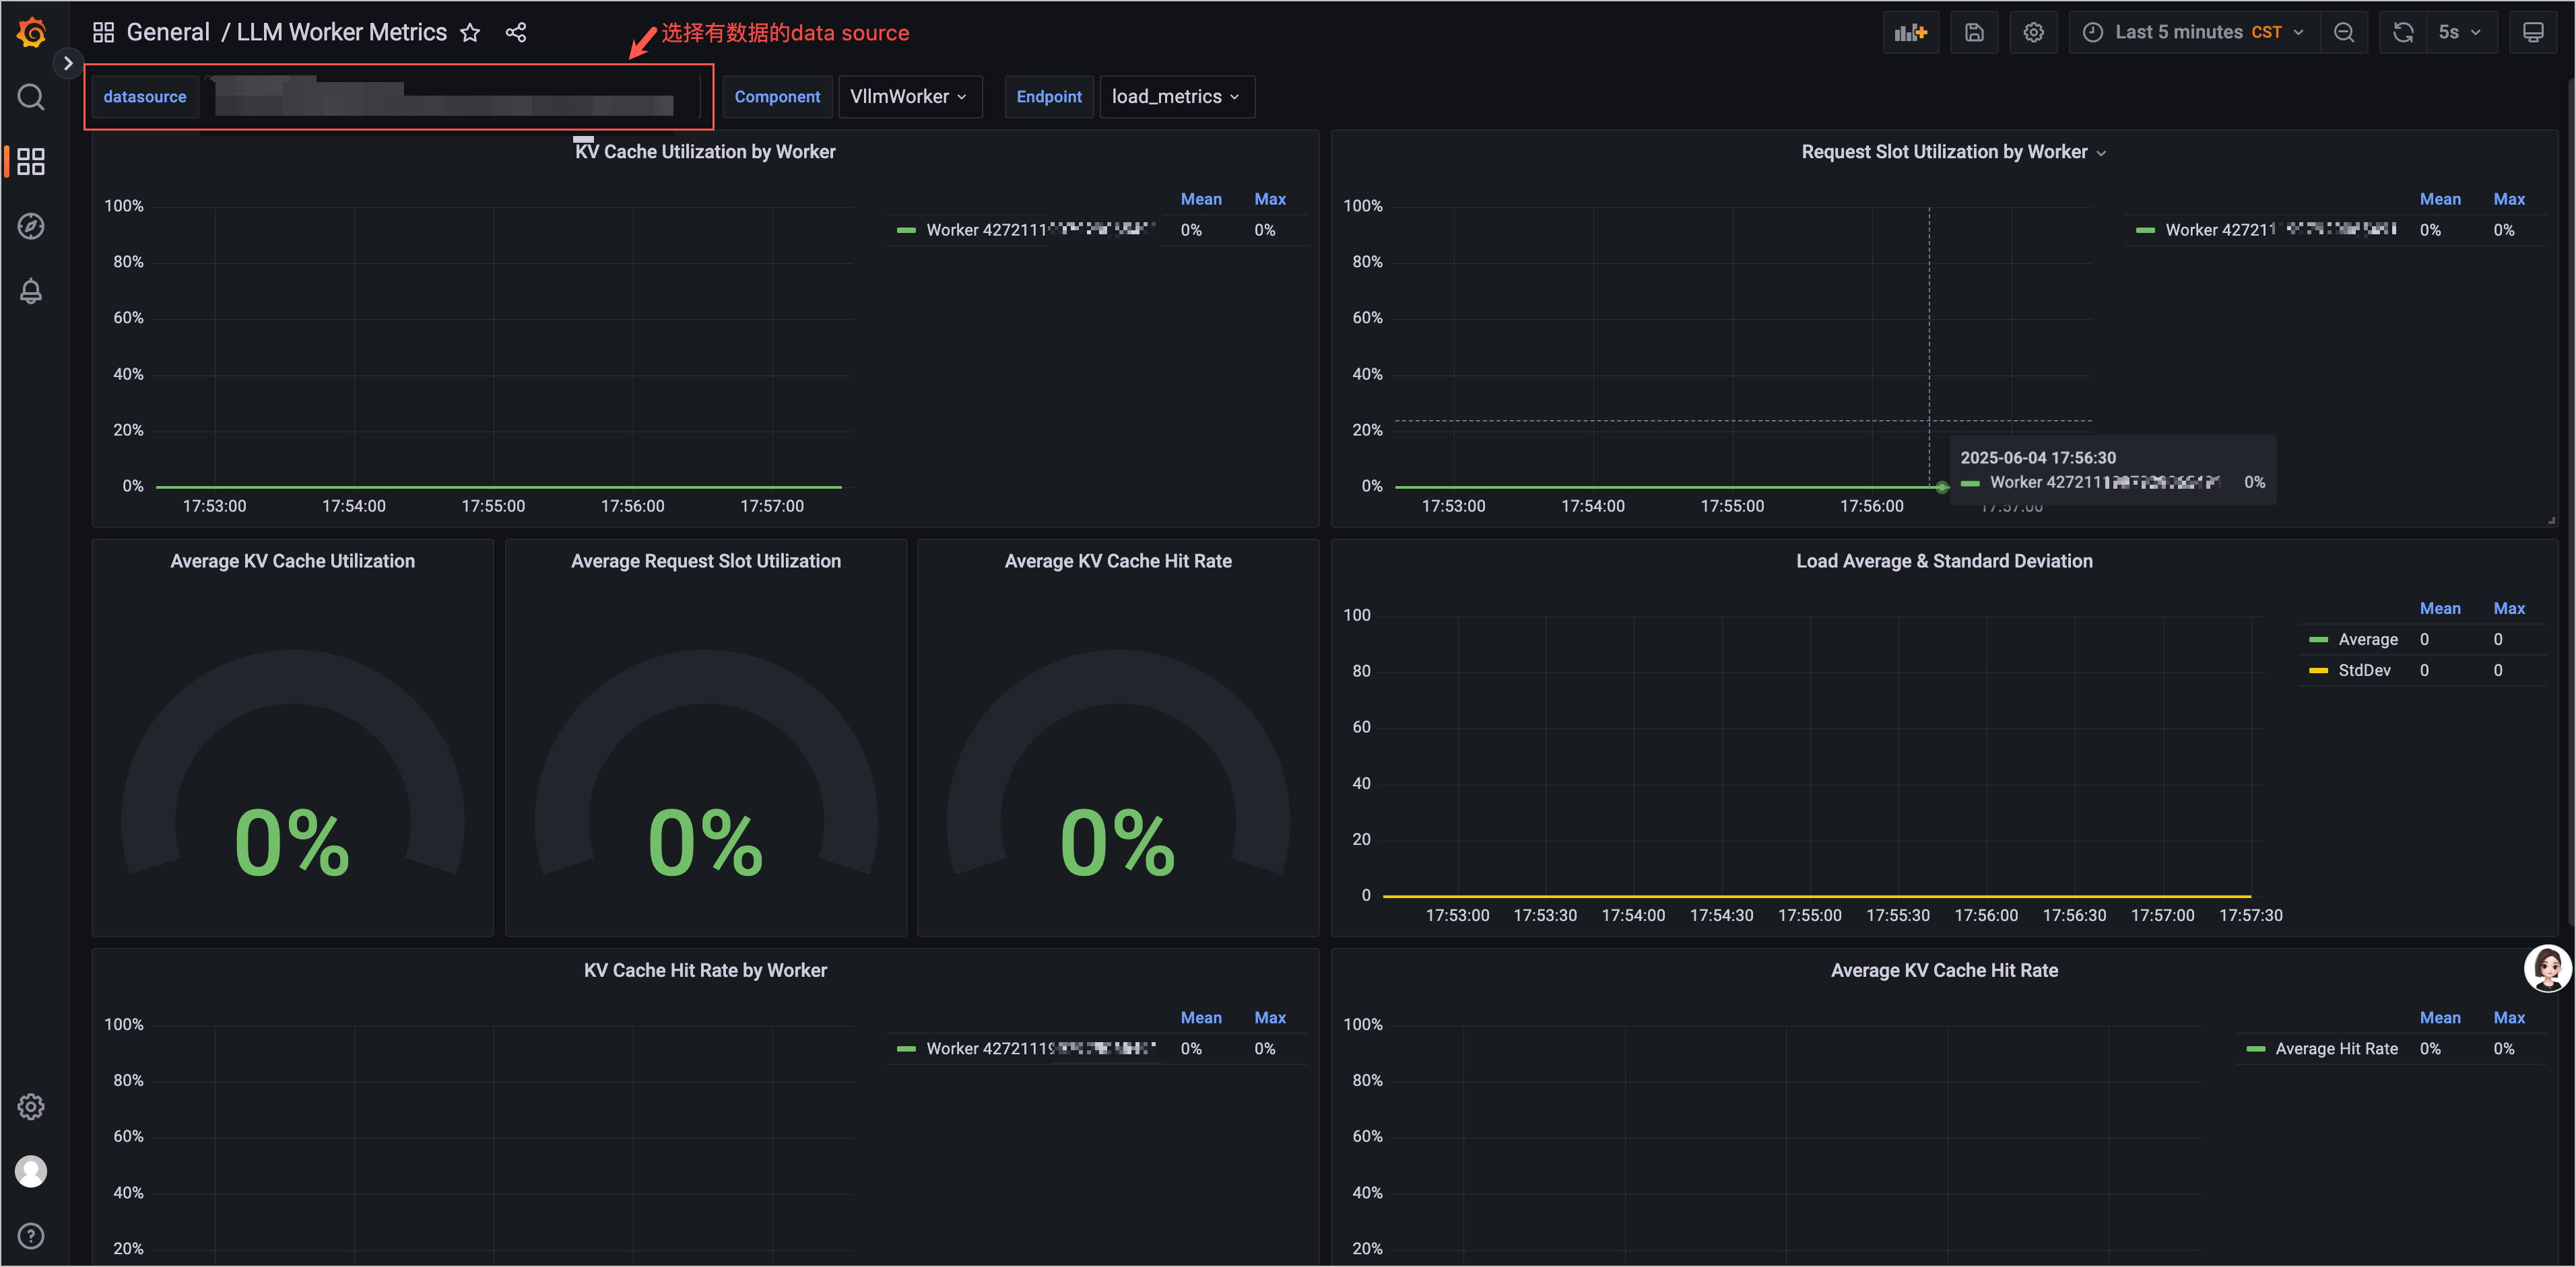
- 登录上述 Grafana ,选择导入如下看板 JSON 文件。
- 导入后效果如图所示。
-
深度观测
- 登录 应用性能监控全链路版控制台,在左侧导航栏选择 服务端监控。
- 搜索以Dynamo为关键字的服务,单击服务名,进入观测看板页面。
- 查看指标。
- LLM 指标。
- 在 服务总览、LLM性能、Token用量 等页签,可查看大模型核心指标与服务黄金指标,例如:大模型调用次数、Token 使用量、响应耗时、TTFT、TPOT、QPS、请求错误率等。
说明
TTFT、TPOT 指标需要流式调用才会产生相应指标。
- 流式调用示例如下:
- curl localhost:8000/v1/chat/completions \-H "Content-Type: application/json" \-d '{"model": "Qwen/Qwen3-235B-A22B","messages": [{"role": "user","content": "hello"}],"stream": true,"stream_options": {"include_usage": true,"continuous_usage_stats": true}}'
-

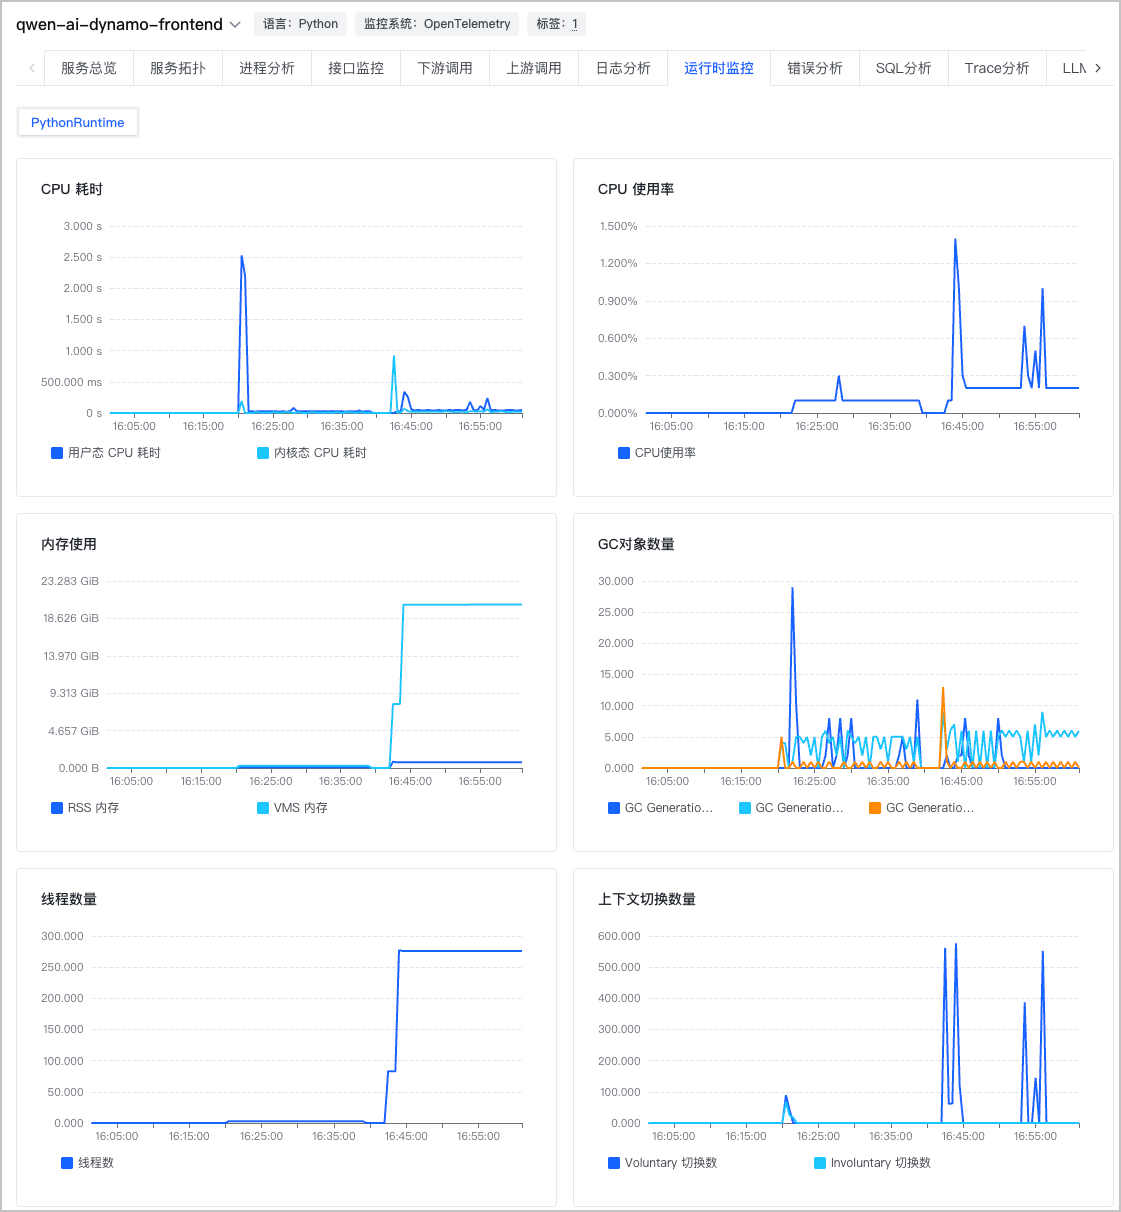
- 运行时指标
- 在 运行时监控 页签,可查看运行时相关监控信息,例如:CPU 耗时、CPU 使用率、内存使用、GC 对象数量、线程数量、上下文切换数量等。
-
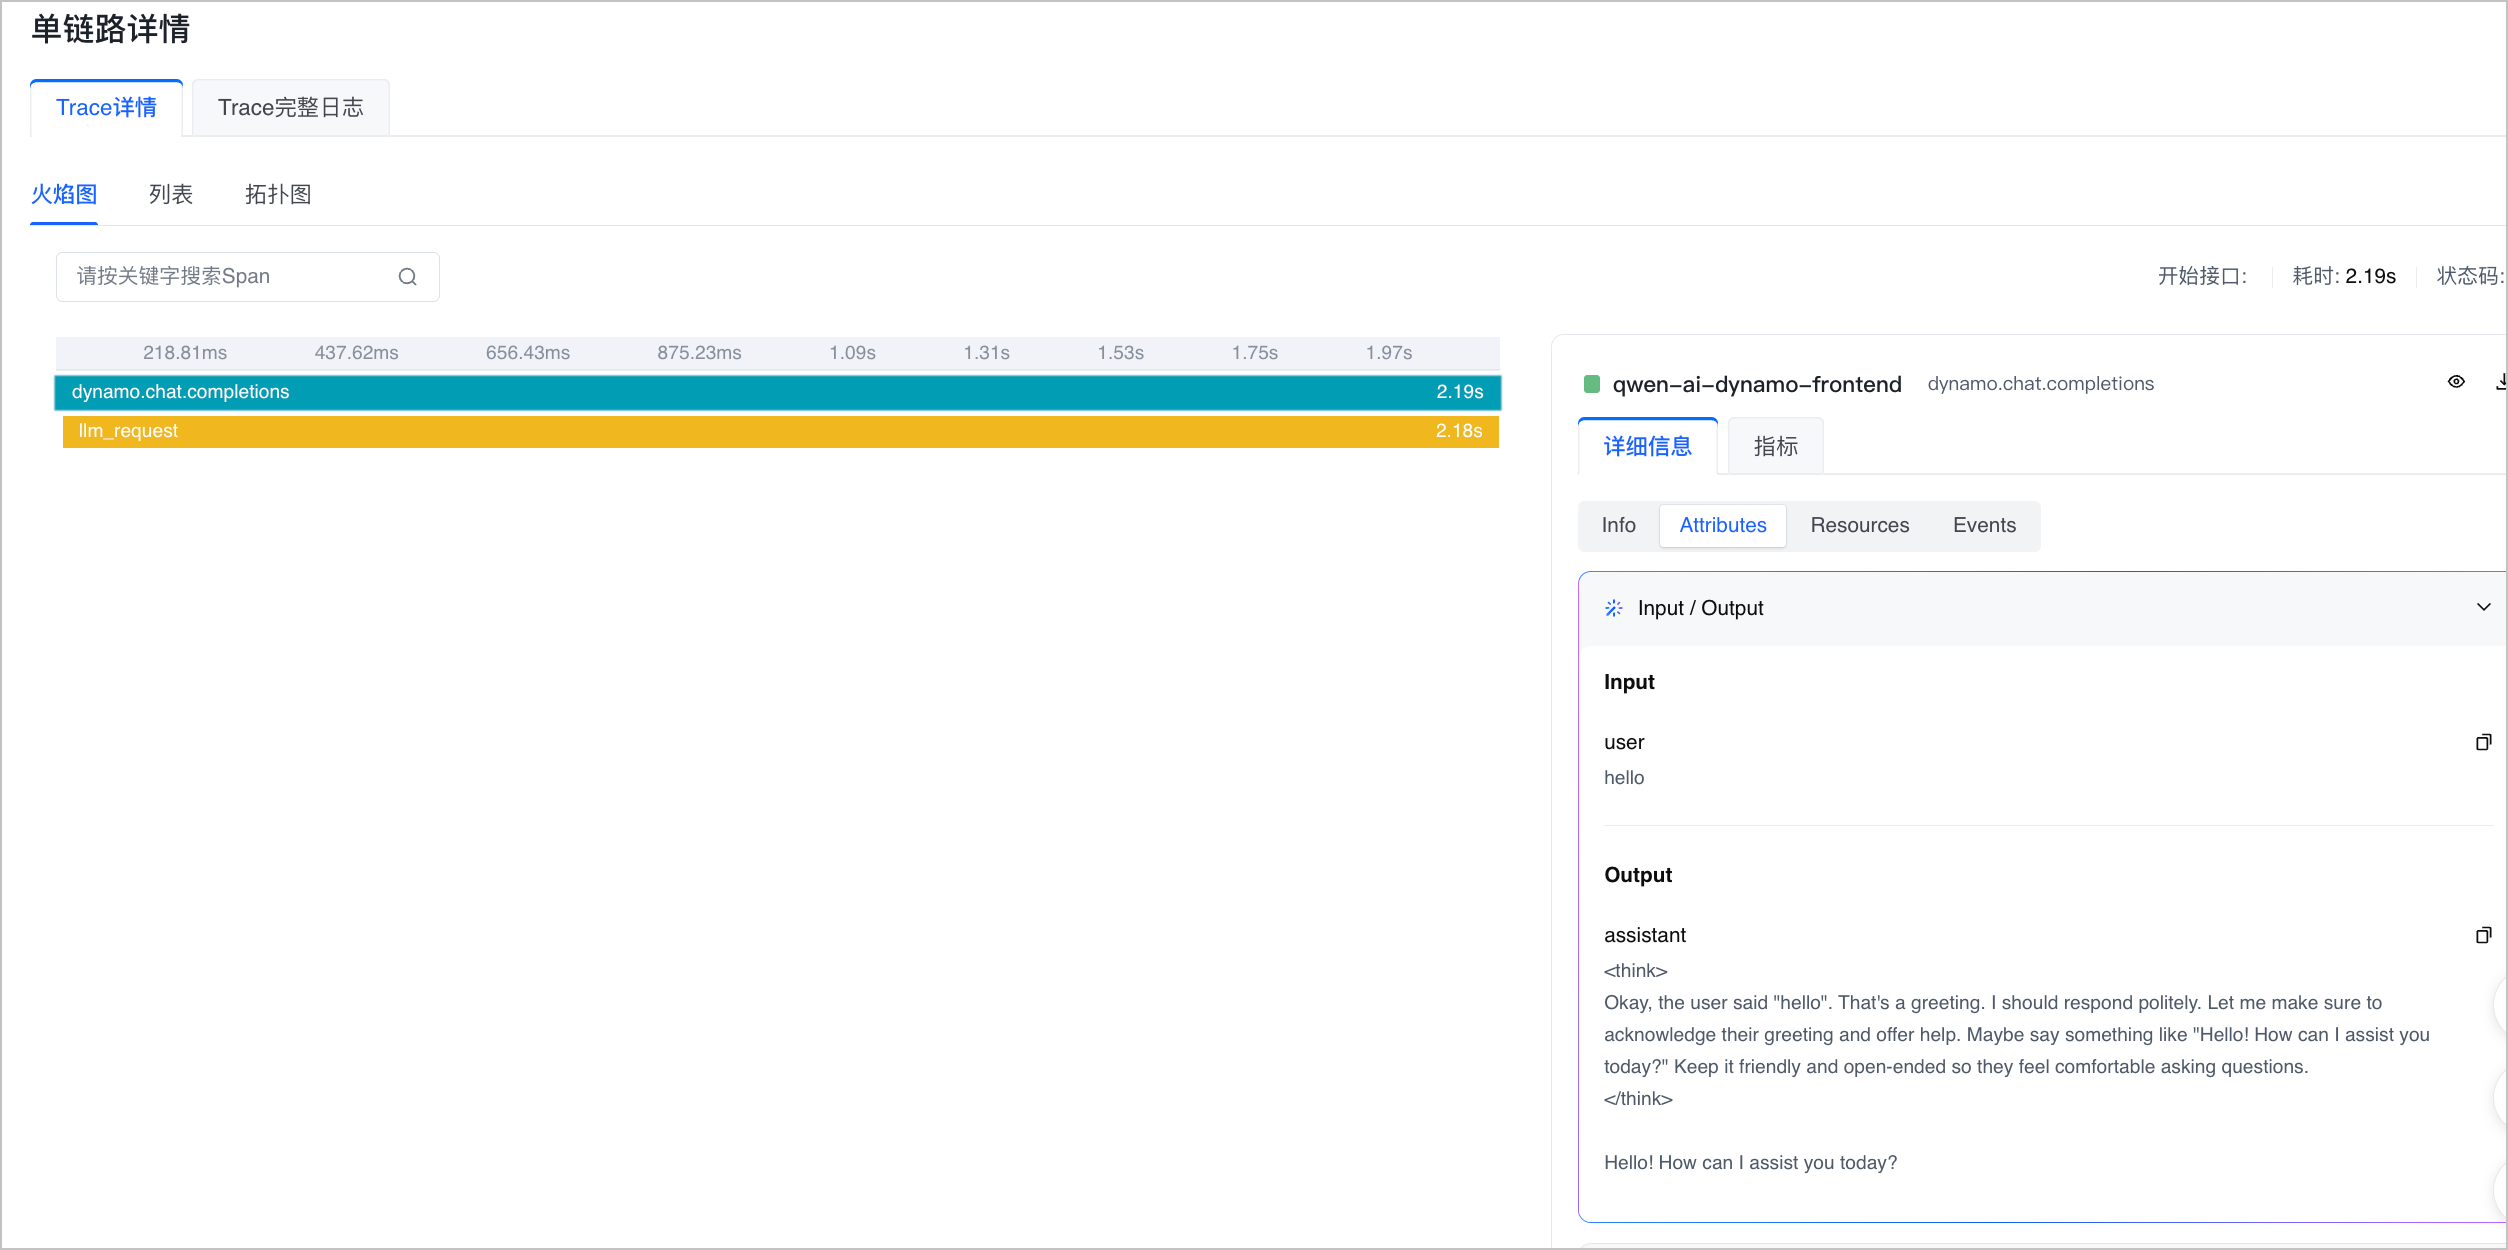
- 查看链路分析。
- 从 Dynamo 应用的 Trace 分析页签,可以根据不同条件检索链路信息。单击目标 Trace ID,前往单链路详情页面。在列表视图中查看 Trace 信息。
-
模型验证
方式一:通过 Service 访问
部署 qwen3-dynamo-vllm-pd 应用模板后,关联创建的<应用名称>-qwen3-dynamo-vllm-pd格式名称的服务,提供 HTTP API 端点(8000 端口)。使用服务端点,可以按照 OpenAI 兼容 API 方式去调用。
示例代码如下所示。
说明
其中:
- 将localhost:8000替换为您<应用名称>-qwen3-dynamo-vllm-pd服务的端点。
- content参数的值,输入您与模型的对话内容。
curl localhost:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "Qwen/Qwen3-235B-A22B",
"messages": [
{
"role": "user",
"content": "In the heart of Eldoria, an ancient land of boundless magic and mysterious creatures, lies the long-forgotten city of Aeloria. Once a beacon of knowledge and power, Aeloria was buried beneath the shifting sands of time, lost to the world for centuries. You are an intrepid explorer, known for your unparalleled curiosity and courage, who has stumbled upon an ancient map hinting at ests that Aeloria holds a secret so profound that it has the potential to reshape the very fabric of reality. Your journey will take you through treacherous deserts, enchanted forests, and across perilous mountain ranges. Your Task: Character Background: Develop a detailed background for your character. Describe their motivations for seeking out Aeloria, their skills and weaknesses, and any personal connections to the ancient city or its legends. Are they driven by a quest for knowledge, a search for lost familt clue is hidden."
}
],
"stream": false,
"max_tokens": 30
}'
您可以在 qwen3-dynamo-vllm-pd 应用对应 Helm 应用详情页 的 工作负载 区域,选择任意一个网络连通的工作负载,跳转到详情页面,单击页面右上角 控制台,登录应用对应 Pod,进行 API 调用。
方式二:通过 APIG 方式访问
开启 API 网关的认证鉴权功能时,需要在请求中添加认证 Token。
示例代码如下所示。
说明
其中:
- 将http://example.com中的example.com替换为 步骤四:配置路由 中获取的 Ingress 后端服务访问域名。
- eyJhbGciOiJSUzI******替换为 步骤四:配置路由 中生成的 API Key。
- content参数的值,输入您与模型的对话内容。
curl http://example.com/v1/chat/completions -X POST \
-H "Content-Type: application/json" \
-H "Authorization: Bearer eyJhbGciOiJSUzI******" \
-d '{
"model": "Qwen/Qwen3-235B-A22B",
"messages": [
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Who won the world series in 2020?"}
]
}'
最近更新时间:2026.03.16 14:54:00
这个页面对您有帮助吗?
有用
有用
无用
无用