不久前,火山引擎举办了V\-Growth云端一体增长沙龙,本场沙龙围绕体验升级与业务创新,聚焦RTC、智能美化特效、云游戏等业务场景,深入探讨了如何打造云端一体的全链路音视频能力。活动中,火山引擎RTC负责人宋慎义从实时性、富媒体传输、多人互动、全球化、RTC与其他模块协同5个方面,详细阐述了火山引擎RTC的技术实践。
### **一、实时性**

为解决实时性问题,我们在传输的信源分类、信道建模、信道策略三方面进行分别考虑。首先针对信道进行建模,根据信源分类和信道建模特征来整体调整信道策略。
**信源**
信源分类重要的是信源的分级,我们把信源用可靠性、实时性两个维度进行拆分。整体上需要传输的信息可以分为如下几类:
 *信源分级*
以音频内容为例,高频信号与低频信号在整体的音频的信息中,重要程度不同。很显然,低频分量重要性更高。视频也一样,不同清晰度的视频中,低清的重要性要比高清视频更高。
我们经过很多信道优化,可以将弱网环境下的丢包率优化至2%\-5%。在剩下2%\-5%的丢包场景中,就需要让信源进行容错,例如:
* 在2%的容错率情况下:视频可以通过关键帧,音频可以通过netEQ的方式容错。
* 如果需要更高的容错率,就需要对信源进行分层冗余,例如,视频的SVC有时域、空域的区别;音频MDC会有多描述编码;包括现在比较流行的AI Codec,本质上是保留最重要最核心的语音信号,其他信号可以忽略。
**信道**
信道面临的主要挑战是如何评价信道的质量,有哪些评价体系。传输技术的好坏,最主要取决于能以多高的准确性、多快的速度评估信道。在过去,信道的评估往往只有信道容量这一个维度。后来有了一些新的评估手段,例如延时、带宽时延积、丢包等,现在主要用延时丢包乱序、平稳性等各个综合指标,以及主动探测、被动探测等多种方式来评估。整体上使用多种方法把信道尽可能完善、快速的描述、评估出来。
评估之后就是信道分级。信源是根据可靠性、实时性分级,信道也一样,可以把最可靠、实时的一些信道优化方式用于传输最重要的信息。
我们在搜索RTC时会了解到很多传输协议,但其实传输协议的格式并不重要,因为所有传输协议最终实现的都是3个目的:
* 如何FEC实现更低延时?
* 如何调节重传,实现更高可靠性?
* 如何把信道分离,保证重要数据能够快速、优先传递,不重要数据可以丢弃或暂缓?
**信道策略**
所以好的实时性保证,需要信源、信道分级相结合,用合适的协议传输合适的内容。
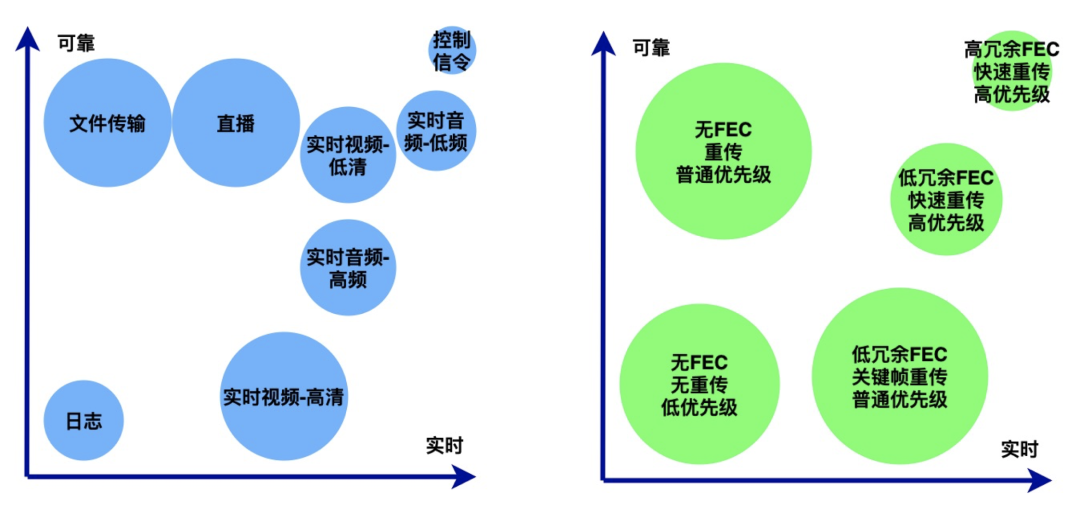 *信源与信道分级*
同时我们也需要考虑实时性的扩展优化,例如信道的容量是否可扩展?在早期RTC优化中,对信道容量是没有过多拓展的。但其实现在我们很多设备都是多网卡的,服务端转化也是多链路的,这些都可以实现扩展。
信道的扩展既可以扩充传输容量,另一方面也可以提升传输稳定性。
同时,不同场景对实时性的要求不同。例如在大型会议中,需要交互的观众并不多,对于不需要参与交互的观众,实时性要求并不高,我们就可以把最优质的信道、传输容量留给最需要实时的信息。火山引擎RTC目前能够实现在70%的突发丢包和500毫秒的突发乱序或延时场景下,保证重要数据不丢失,不影响信息理解和正常沟通。
### **二、富媒体**
最开始的RTC传输都只采集单纯的视频和音频,而近年来越来越多的富媒体应用场景不断诞生,例如:体积视频包括全景视频、VR、双目等新场景;多信源也包括KTV合唱、多画面等应用;最近比较流行的全景声,也伴随着多声道和高精度采样等技术。
 *全景视频分块并行编码*
其中全景视频对RTC的挑战巨大。火山引擎的解决方法是把360度的全景分层,分为一个8K超清视频和一个540P标清视频。对于8K的超清视频,整体的传输需要进行超清视频分块并行编码和局域传输。并行编码的技术有很多,例如H.264可以按照Slice进行编码,H.265按Tile编码,最终实现在有限信道传输特定信息,标清的这一路视频作为背景进行兜底。这样在看全景视频时,即便当前网络无法传输很高清的图像,有540P的视频也不会影响流畅性。此外,因为全景视频经常用于教育、工业等场景,火山引擎私有云、边缘云可以提供局域网加速方案。
 *多信源下的实时性实现*
富媒体下面临的另一个挑战是多信源。大家经常面临多个人需要同步沟通的场景。行业的通用做法是尽量降低延时,所有人的延时都很低,自然可以实现同步。我们在这个基础之上做了一些优化,即利用全局时钟同步信号,发布给所有发布端和接收端。这样产生的信源音频和视频都会同步进行时钟对齐,接收端也通过这个方式,即便在唱歌等场景下都能实现实现不同端很好的实时性。
此外,近些年研究的热点就是全景声的空间音效。如果要实现极致体验,不仅需要双声道,还需要多声道才能更好满足。不过目前很多的音频编解码和传输方式,对多声道支持并不太好。
另一个热点就是高精度采样,大家应该都知道奈奎斯特抽样定理,人耳感知是20\-20kHz,所以奈奎斯特抽样定义大概抽样到40kHz。但这个方式有一些弊端,它只对连续信号可以进行采样,对于离散信号采样精度会严重影响整体视频的清晰度,目前火山引擎也提供了高精度采样,例如24bit;在没有高精度采样的场景下,我们也提供更高的采样率,例如96kHz、192kHz的采样率的编解码,可以实现在不同场景下的重采样。
另外,在高精度采样和多声道场景下,音频编码之后的数据会非常大。为了让全景声能够在实时场景下得到更好的传输,我们引入了多描述编码MDC技术,Codec就可以实现让全景声信号分层,达到非常低的延时。目前火山引擎RTC已经具备在8K/120fps、100Mbps源流情况下,能够实时观看10Mbps FoV流的传输能力,在多个观看端一起观看的情况下,pct95端到端延时小于500毫秒,头动延时小于300毫秒。
### **三、多人互动**
近些年随着RTC技术发展,互动人数、互动规模不断提升,这对RTC造成了更大挑战。
在超大房间,很多用户快速进房、退房时会有消息风暴;同时传输的拓扑也会不断进行动态的生成与重建;另外音视频的拓扑也会面临分离传输的情况。
火山引擎RTC在多人互动架构上也进行了多轮的演进:
* 在人数比较少的情况下,可以使用网状SFU(大多数RTC架构采用的方式),相对简单,又可以实现全量交换,但服务端很容易遇到转发瓶颈;同时,因为每个人都是对等的,当人数很多,快速进房退房时,会产生信令的广播风暴。
* 针对这个问题的优化策略是给用户分角色,把静默用户(只观看、不上麦、不开摄像头)区分出来,这样的用户进出房间就不广播,极大减少信令。
* 另外对于这种超大房间,网状拓扑也不太合适。需要把大房间里面的嘉宾的信号变成树状拓扑。
* 同时当房间人数多的时候,信令广播消息比较大时,需要接入连接复用,压缩信令。
* 网状拓扑变成树状拓扑,可以解决几百人规模互动存在的问题,但如果想达到更高的互动,还需要继续优化。
* 例如音频选路风暴 :在一个房间内无论有多少人在听,绝大多数RTC系统都只会选择声音最大的几路音频。那么选路过程中会有比较大工作量。客户端不会同时拉几路流,边缘计算也没有办法同时拉几路流,因为如果所有边缘节点都同时拉所有音频流的话,整体传输量非常巨大。所以我们把一个房间内的所有音频在一个源站上进行聚合并选出全局的TOP3,然后集中进行分发,这样音频链路与视频链路就自然分开了。
* 另外在多人场景下,自动订阅优势会产生突发的信令。例如:当一个房间内有几十万用户,一个嘉宾忽然进入,会让所有用户同时订阅这个嘉宾,这时需要关闭自动订阅,开启按需订阅。因为每个用户看到的嘉宾可能是不一样的,一般情况下一个用户最多观看“5\*5”、“7\*7”个嘉宾的视频,就不能让用户都去自动订阅相同的嘉宾,用户可以根据自己选中的按需订阅。
* 在上述的场景下,信令的推送也是非常大的压力。所以我们把信令架构变成分布式信令,进行并发推送。最终实现服务端O(N)的复杂度(N指用户数量),在客户端实现O(1)的复杂度。也就是理论上如果一个客户端最多能同时观看“7\*7”49个人的视频,同时听到3路音频的话,那么随着人数上涨,他的计算量和网络带宽不会随之增加。
目前火山引擎RTC支持单房间内2种超大规模互动的方式:
* 大讲堂模式:可以实现50嘉宾和100万观众。
* 研讨会模式:可以实现1000嘉宾和1万个观众。
### **四、全球化**
在面临全球化场景下,快速进房、稳定性是2大长期研究方向。
* 快速进房:如果一个RTC系统是全球化的,传统的房间服务是中心化的,那么在地球另一端的用户进房速度就会非常慢。
* 分布式房间:火山引擎的解决方案是使用分布式房间。同时,将用户进行分类,例如有一些用户是观众,他的信息没有必要扩散给其他人,所以我们把信令进行了拆分,在全球做了多个信令中心,可以下沉到离用户最近的边缘节点;只针对发言的嘉宾把信息异步通知到其他信令中心,而观众的信令不变,那么观众也不会被其他的信令中心感知到,实现了快速进房。
 *分布式房间*
* 分发生成树:当一个房间在全球化多中心场景下,且人数特别多时,当全球节点达到几千的量级,那么单机计算生成树会变慢。为了实现快速进房,同时房间内有新嘉宾发言开关摄像头的时候,所有用户都能够快速感知,就要在全球多个中心并发计算生成树。这时会有一些冲突的情况,需要实时进行回环检测。由于用户的变化是动态的,也要实时进行节点的分裂与合并。最终还需要考虑每个用户端到端延时的要求,这就要求实现大致平衡的生成树。另外出于容灾的考虑,整个生成树还需要能够快速动态重建。
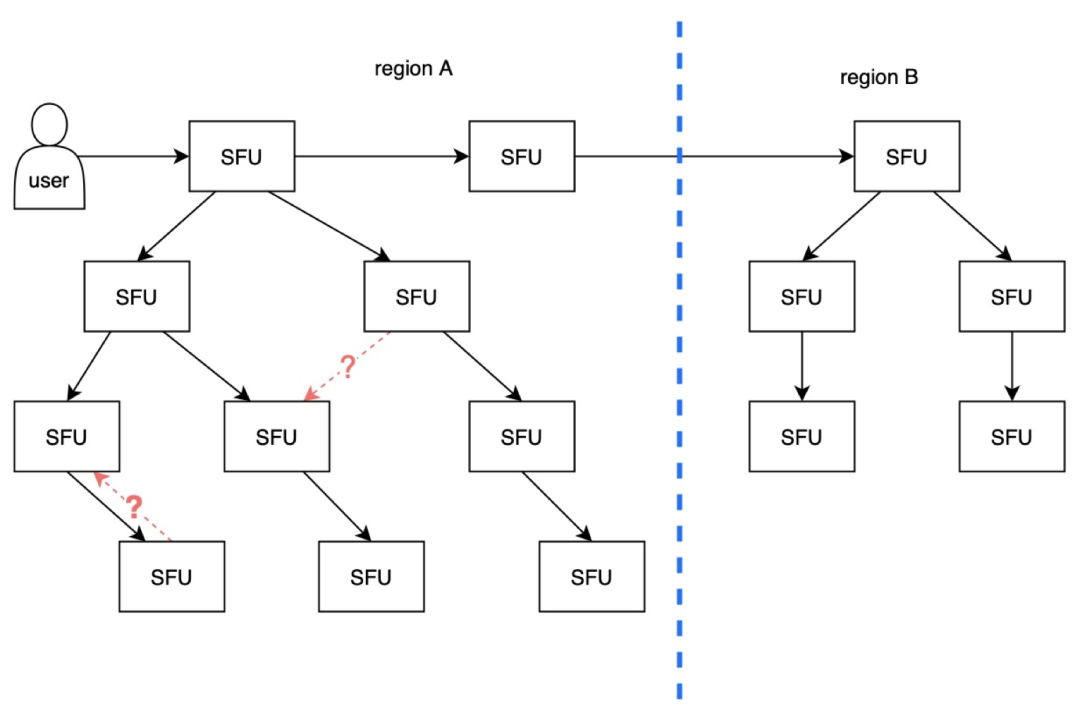 *分发生成树*
* 稳定性:如果要实现全球化的高可用,仅依靠业务侧的优化或应用层的优化是不够的,必须实现更底层的优化。火山引擎打造一个广域网的SDN系统,能够将流转变为包级别进行转发。
 *数据链路层Overlay网络*
* 这是一个数据链路层的Overlay网络,相当于把我们之前局域网上的 SDN 搬到了公网上。当然这也面临一些新挑战,例如公网上的节点多种多样,且数量庞大,当达到上千的量级的时候,单一的路由中心也不能管理了。
* 于是我们又建设了分布式的路由表,而且本身的这个二层Overlay网络的传输能力也是能够根据 payload 进行分级QoS的。有了这个系统,节点和区域的故障就能够实现秒级感知和切换。
* 经过上述优化,火山引擎RTC能够实现全球传输延迟PCT995 200毫秒以内、全球端到端延迟PCT95 400毫秒以内,全球接入可用性达99.9%以上,全球转发可控性达99.9%以上。
### **五、RTC+X**
在越来越复杂的场景下,客户往往不会单一的使用RTC,而是更倾向于与其他多个模块协同共同解决一个或多个复杂的功能。RTC与其他模块、客户自身应用的协同,则又是一大挑战。
RTC在App中,与点播、直播、网页、消息、下载、API共存,不仅共用音视频设备,还共用网络带宽、CPU/GPU内存。
所以RTC一定不能设计为专门抢占资源、带宽,而是需要考虑如何更好识别当前资源占用率,并能够允许客户自定义给RTC预留资源、使用特定限制的资源。
火山引擎 RTC 为实现与其他模块、客户自身应用的更好协同,目前已支持外部采集、渲染;带宽/性能数据的实时回调;根据静态设备适配清晰度、码率;动态性能/带宽的升降级;同时还支持自定义的降级策略。例如客户可以为RTC设定一个特定的带宽上限,也可以让RTC预留现有带宽20%给其他业务使用;以及当CPU使用率达80%,RTC直接进行降级等策略。
基于上述的方式,RTC可以在确定的资源下与其他模块进行更好的协同。