前两日,火山引擎在《从 ClickHouse 到 ByteHouse:实时数据分析场景下的优化实践》中,与大家分享了字节跳动在打造 ClickHouse 企业版「ByteHouse」的路程中,使用 ClickHouse 的两个典型应用与优化案例。今天我们会介绍字节跳动内部如何通过深度优化 ClickHouse 高效解决广告业务里人群预估的问题。
# **业务背景**
众所周知,广告是很多互联网公司的主要收入。在字节内部有大量和广告场景相关的分析场景。其中 **人群预估** 是一个非常典型的场景。在广告精准投放过程中,广告主需要知道当前选定的人群受众组合中大概会有多少人,用于辅助判断投放情况进而确定投放预算。
人群预估从技术角度抽象本质就是集合的快速交并补计算, 主要难点和挑战:
* **人群包数据量多,基数大。**
* **计算复杂** :广告主可以设定一个非常复杂的圈选条件,还有可能和其他数据进行交叉分析。
* **查询时长要求短** : 直接面向广告主。如果页面上等待时间超过 1s 就会有明显感知,如果等待时间继续增加,广告主的体验会非常不友好。
在使用 ClickHouse 之前也尝试了不少已有的系统,如 Druid、ES、Spark,甚至业务方还自研过一个系统。其中 Druid、ES、Spark 均不能很好满足所有的需求。自研的系统因为可以高度的定制解决性能问题,但缺乏一定的灵活性。
因此,通过对比我们选择了 ClickHouse。原因主要有两个方面:
* **快** :特别适用于大宽表的场景,这个是其他引擎所不能比拟的;
* **架构简单** :适合定制化的开发,甚至去修改整个执行逻辑,确实内部也做了较大的优化改造。
# **初步尝试**
采用明细存储的方式,表有 2 列,分别是 tag_id 和 uid。tag_id 表示标签,uid 是对应的 user_id。对 tag_id 建立了主键,因此可以快速的找出对应的 user_id 集合。集合的交集操作会转化为 in,并集转换成 or,补集转换成 not in 实现。
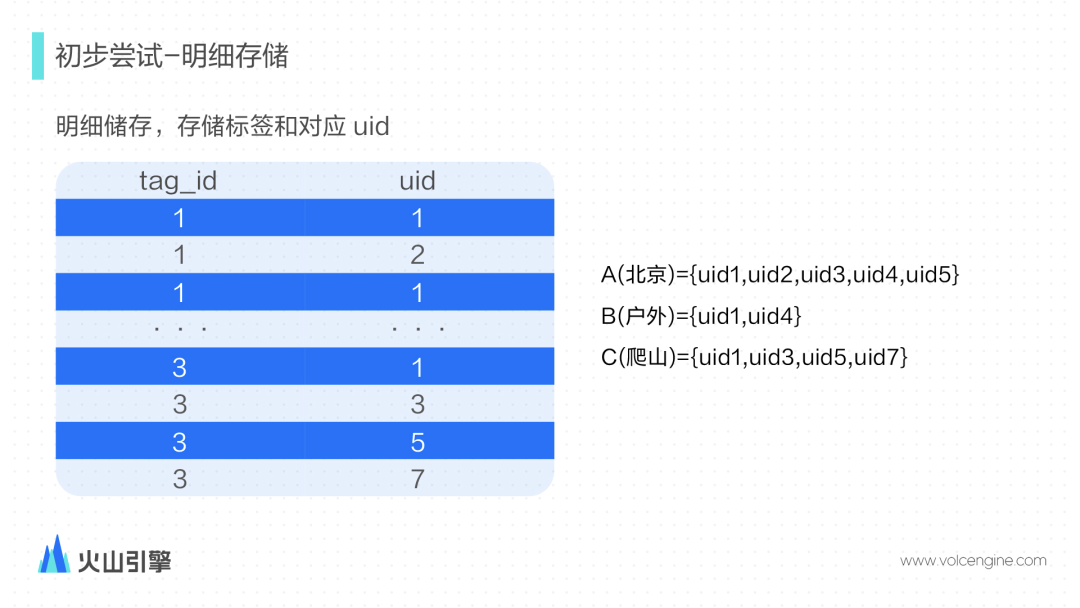
举个 A&B 的具体场景,转换成SQL的实现逻辑如下:
```Plain Text
SELECT count distinct(uid)
```
在这种情况下想要快速的求出 SQL 的结果,我们主要尝试了 2 个优化方向:
### **并行计算**
减少节点之间数据传输,把计算下推下去,减少汇聚节点的计算压力。
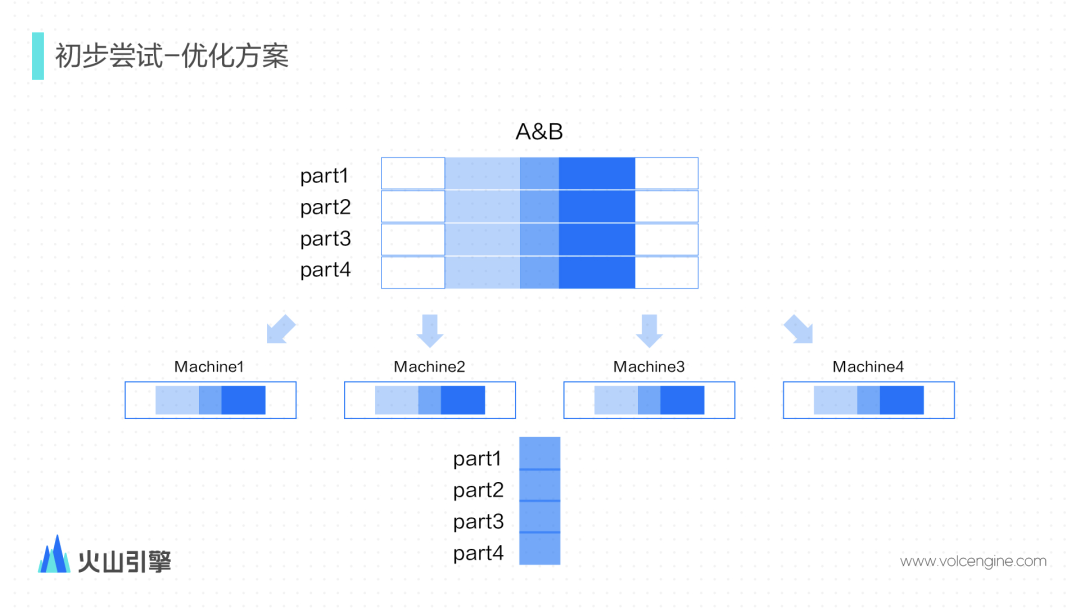
如图显示,按照user_id划分为 N 个区间,分别导入到 N 台不同的机器,保证每台机器上的用户不重复。每一台机器可以独立完成交集计算,因为用户不会重复,每个机器只需要返回完 count distinct 结果,而不是对应的聚合函数中间状态,可以大大减少传输的数据量,最后汇总只需要做累加即可。
具体优化调整实现处理逻辑:
* **导入数据按照用户 ID 分片** ,数据分散在多个节点;
* **扩充了 SQL 语法,并行计算,修改了引擎的执行逻辑** 。支持 count distinct 中间结果不做 merge 直接进行累加。
### **快速计算 count distinct**
主要优化思路:
* 优化 hash 函数,能够快速求出 hash 结果
* 精确算法下优化 hash 表的结构,减少 hash 冲突
* 通过一些近似函数的方式,在业务允许一定的误差的情况下可以更快速求出结算结果,比如 UniqHLL12/UniqCombined 等。
通过优化后的方案上线,大部分的查询都能满足性能,但是也出现了一些不足:
* 当表达式非常复杂,特别是存在很多的交集和补集的时候,由于交集和补集需要用子查询来实现,SQL 会非常长,对用户很不友好,且不利于分析。
* 当人群包非常大且表达式复杂的时候查询容易超时。因为 in 和 not in 的操作是比较花费 CPU 资源的。
而且随着数据量的不断增长 ClickHouse 性能也出现了明显的波动,不得不探索新的方案。
# **进阶探索**
主要是基于位图的优化探索。位图是一种逻辑上非常巧妙的描叙集合的方法。根据 user_id的特性,采用性能最好的稀疏位图索引 RoaringBitmap 来表示一个标签组合对应的人群包。在这样的情况下,集合的计算可以转换到对应位图的计算。
ClickHouse 其实有引入 RoaringBitmap,但是是 32 位的 Bitmap。而我们的用户规模用 32 位表示并不够,因此我们给 ClickHouse 引入了 Bitmap64 类型和一系列的相关计算函数。
新的数据结构变成一列 tag_id 用来表示标签,另外一列类型为 Bitmap64 的 uids 表示标签所对应的user_id的集合。
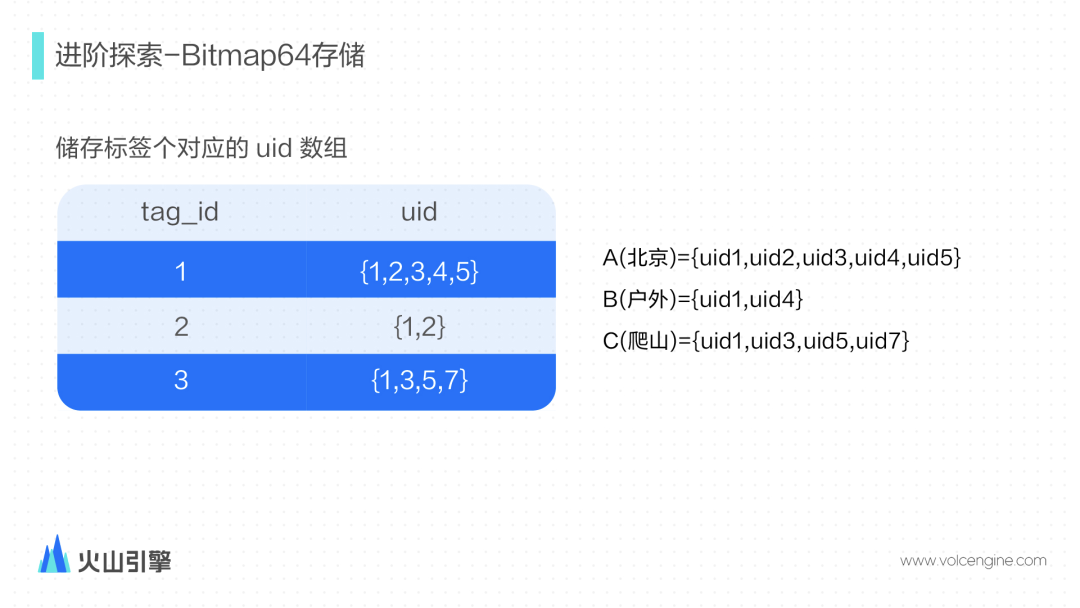
A&B 的场景,转换成SQL的实现逻辑变得更加简单
```Plain Text
SELECT bitmapCount('A&B')
```
相比于明细存储,使用 Bitmap 有如下优势:
* 空间节省,没有冗余数据,RoaringBitmap 存储高效;
* 计算高效;
* SQL 直观,无需子查询,且具有更好的拓展性。
但是在验证过程中发现只有 Bitmap 还远远不够,陆续做了其他方面的优化:
### **并行计算**
和初步尝试方案的想法一样,尽可能的并行计算,减少数据传输。相比于之前用子查询来表示交集和补集,采用 RoaringBitmap 来实现交集和补集要简单很多,而且能更加充分的实现并行计算,到线程粒度。这样,一方面可以更好的利用上多核的计算资源。另一方面,可以更好的控制查询使用的资源,避免一些大查询占用过多资源。
### **数据层面优化**
在整个并行改造后我们发现效果并不明显,通过对 RoaringBitmap 底层原理的深入研究和对数据的分析,我们发现,原因是区间内的 **user_id 过于离散** 。
离散的原因有 2 点:
* uid 的生成并不是连续的。
* 由于数据按照一定规则均匀划分到不同的区间内,那么就会导致子区间内的数据比原始空间更加离线。
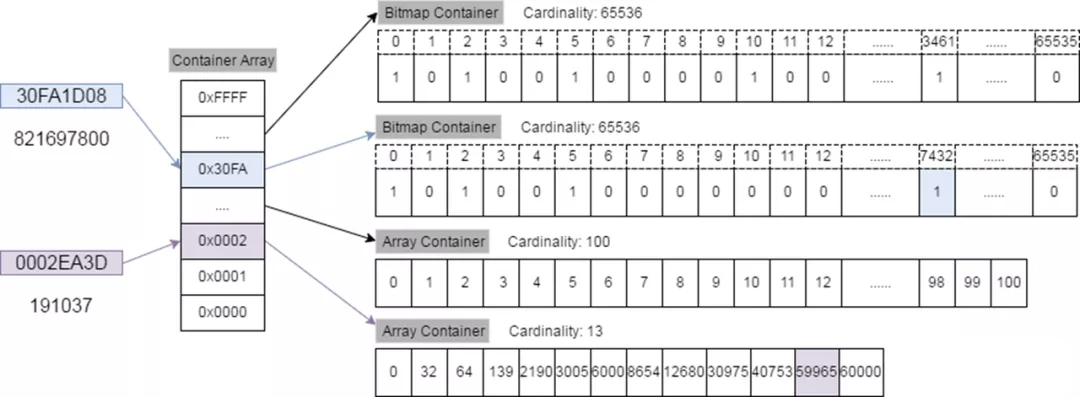
离散会导致慢的原因跟 RoaringBitmap64 的实现有关,RoaringBitmap64 是由一系列 RoaringBitmap32 表示,当数据比较稀疏的时候,每个 RoaringBitmap32 内部又由很多个 array container 组成。而对有序数组的交并补计算尽管也比较高效,但是相比于 Bitmap 计算来说还是有明显的差异。这样导致计算性能提升不上去。
于是我们思考能不能通过编码的方式,对区间内的数据进行编码,让数据更加集中,从而提升计算效率。最终达到效果:
* 编码后同一个区间内的用户相对集中;
* 不同区间的用户编码后同样在不同的区间内;
* 编码后同一个人群包同一个区间内的 user_id 相对集中;
* 编码的过程是在引擎内部实现的,对用户是无感知的。当数据导入的时候,会自动完成编码。
因为篇幅关系不做更多的展开, 最后通过引入编码让性能提升 1~2 个量级。
### **计算的优化**
主要有下面 3 点:
* 通过一些指令集计算和汇编指令对计算进行加速,在实际测试中发现这个能够大大加快计算速度;
* Bitmap 的计算能够尽可能在原地完成,减少数据拷贝;
* 在处理的时候需要对整个表达式进行处理和判断,看看哪些计算可以在原地完成。为了能更多使用本地处理且不影响结果可以适当调整逻辑执行计划;
* Bitmap 在大量的并集的情况下与原来的相比提升不够明显;
* 通过把 RoaringBitmap32 的 Fast Union 的思想移植到 RoaringBiamap64 上,通过 lazy 计算的方式,提高大量并集的计算性能。
### **读取的优化**
大家都知道 ClickHouse 是列存数据库,对于每一列的数据又是分块存储的,默认是每 8192 行为一块。分块存储的好处是能够更好的做压缩,减小数据存储。对于一些基本类型来说效果很好。但是对于 Bitmap 类型来说本身值的类型就非常大,8192 行组成的块大小非常大,会有很大的读放大,非常影响性能。另外,ClickHouse 是在主键上的稀疏索引,并不能精确地定位某一个块中是否包含对应的数据。对于普通类型也是没有问题的,因为有的时候建立精确索引并且查找索引的代价还不如直接暴力扫原始数据。但是对于 Bitmap 来说扫描过多的数据是我们不愿意看到的。
因此我们做了这几个优化:
* 调整块的大小,把默认的 8192 行改成了 128,在实际测试中大多数场景的最佳实践。如果数据太细,那么会导致 mark 文件过大,读取索引定位数据的时间变长。
* 定期合并历史数据,因为有的标签是增量数据,通过合并可以减少数据读取。
* 通过二级索引的方式能够更好的精确定位,尽量减少读取不需要的数据。
### **通过 cache 减少计算的数据量**
用户读取的数据和计算的结果通常具有二八原则,即经常读取的都是一小部分数据。因此,通过引入 cache 可以加速第二、第三次读取时间。
目前实现了三层的 cache:
* 读取层面的 cache,对于同一个标签,通过 cache 第二次可以直接命中内存;
* 中间计算结果的 cache,做法是提供一个 udf 函数可以让用户复用中间的计算结果。比如需要计算,A&B&C&D&E&F,A&B&C&D&E&F&G,A&B&C&D&E&F&H,就有重复计算的部分;
* 对结果的 cache,结果 cache 只需要记录一个 string 用来表示计算的表达式和一个 uint64 表示结果,代价非常小,可以用很小的空间存储大量的计算结果。
### **最终效果**
通过进阶探索的改造优化后实现
**空间:**
* 采用 RoaringBitmap 可以减少 tag_id 列的冗余存储,同时 uid 采用压缩存储,因此整的空间存储降低为原来的 1/3;
**导入时长:**
* 因为数据量降低了,因此导入也变快了,导入时长也缩短为原来的 1/3;
**查询时长:**
* avg/pct99/max 下降明显;
* 消除了绝大多数 5s 以上的大查询;
**资源:**
* CPU 使用下降明显;
* 内存使用上 PageCache 节省 100 G+ 以上。
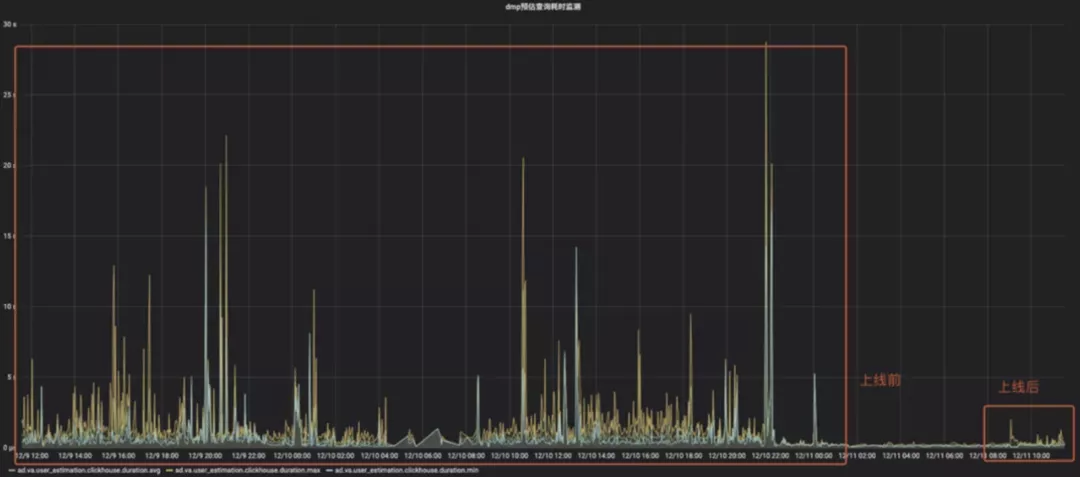
可以看到对比优化前确实是经常有一些大的查询,有些时间久的甚至超过了 20s。上线后如右边的红框所示,很少看到超过 5s 的查询了,绝大部分查询非常稳定。结合上cache的能力可以直接把 QPS 下降了 4 倍以上。
最终优化方案在线上取得了比较大的成果,业务方的反馈也很不错。基本上在较长的一段时间内都能满足业务需要。随着数据量的不断增长,我们还会继续进行更深入的迭代:
* **从计算层面和数据层面进行更多的优化,读取的数据更少,更精准的找到真正要读取的数据。** 减少甚至尽可能消除读放大。计算上能够有更多其他方面的尝试,包括利用一些新硬件减少计算的时间等。在持续优化的同时能支持标签的实时更新;
* **从 cache 层面能够做的更加智能化。** 通过解析表达式,从子表达式的粒度看看是否能够把一些公共子项缓存起来, cache 才会更通用。可能要引入一些机器学习的算法;
* **扩充表达式的表现能力** ,能够在更多的场景得到应用。目前在计算的时候是使用一个 uint64 来表示一个对应的标签,如果表示一个多维的标签,内部有一些做法,但是还不是很通用,业务方用起来也有点费劲。未来能在标签的表达上有更好的支持。
# 小结
本文主要介绍了 ClickHouse 在人群预估这个广告业务常见的分析场景里我们的实现方案和优化的思路,以及未来的迭代计划。
目前,[企业版 ClickHouse「ByteHouse」](https://mp.weixin.qq.com/s?__biz=MzI0NzU1NzI5NQ==&mid=2247486736&idx=1&sn=b27899674dc1a3f102221e9d9caeaa81&scene=21#wechat_redirect)已经发布。未来,火山引擎将通过 ByteHouse 来为客户持续提供字节跳动和外部最佳实践,构建交互式大数据分析平台,以应对复杂多变的业务需求和高速增长的数据场景。