豆包语音
豆包语音


文档指南

请输入


- 文档首页
 豆包语音接入必读流式语音识别
 复制全文
 下载 pdf
流式语音识别
 文档反馈
 问问助手
功能说明
说明
流式语音识别2.0服务提供将音频转写为文本的能力。针对不同场景需求,提供以下两种接口:
- 一句话识别:模型等一句话说完后再返回该句的确定文本,显示稍慢但结果更稳定。适用于准确率优先、多语种或无需实时上屏的场景
- 实时语音识别:模型在接收语音的同时显示识别文字。适用于会议字幕、直播字幕、智能外呼等对响应速度要求较高的场景
选型建议
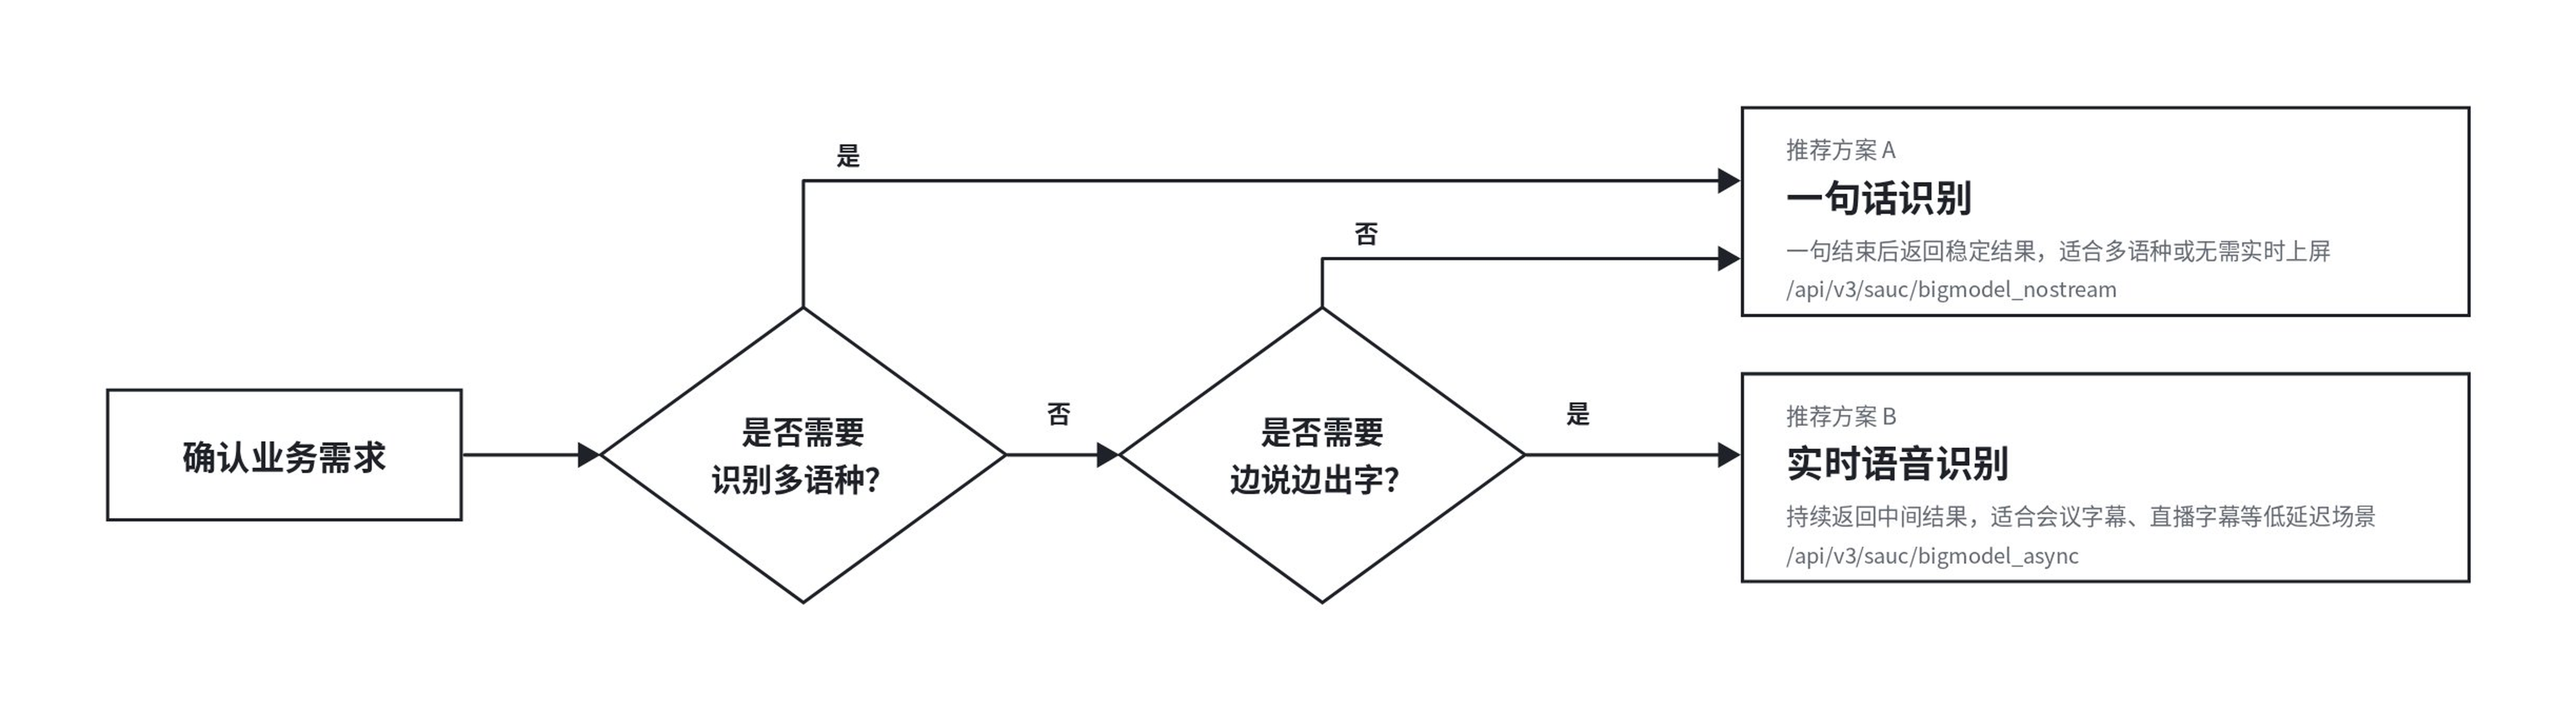
- 优先选择一句话识别:需要多语种能力,或业务只消费句级稳定结果
- 优先选择实时语音识别:如果用户说话后需要尽快看到第一个字,并且应用可以用新结果覆盖屏幕上的临时文字
交互流程
- 建立连接:客户端发起 WebSocket 连接
- 发送初始化请求:客户端发送完整请求,包含携带鉴权信息、Resource ID、音频格式及附加参数等,详细请参考接口文档中的参数说明
- 确认初始化结果:服务端返回首个响应。若初始化成功,客户端进入音频发送阶段;若失败,客户端应记录错误码、请求标识和关键配置,关闭连接或按策略重试,错误码含义请参考:错误码查询
- 持续发送音频流:按实时音频节奏持续发送音频包,每包时长建议 100~200 ms,发包间隔建议 100~200 ms
- 持续接收识别结果:服务端在处理音频的过程中持续返回识别结果。客户端可根据 result_type 判断是全量结果还是增量结果,并结合 definite更新临时文本或提交稳定分句
- 发送最后一包音频:客户端发送携带结束标志(负包:sequence为负值)的最后一包音频
- 接收尾部结果和最终包:客户端继续接收剩余识别结果,确认收到最终包(is_last_package=true)后,客户端再主动关闭连接
说明
- 为保证较好的响应速度和识别准确率,建议每隔 200 ms 发送一个时长为 200 ms 的音频包
- 音频发送和结果接收是并行过程。客户端收到最后一包音频后立即断开连接,可能丢失尾部识别结果
- 客户端最后一包音频只表示“音频发送完毕”,不代表服务端结果已全部返回
FAQ
Q1:definite字段有什么含义?
字段说明
definite用于标识当前分句识别结果是否已稳定
- false:表示当前结果为临时结果,分句未定稿,后续可能被新的识别结果覆盖或修正
- true:表示当前结果为最终结果,分句已定稿,不会再被后续结果修改
场景说明
- 服务端首先返回实时流式识别结果,此时 definite = false,表示结果尚未最终定稿
- 系统通过检测连续静音时长是否达到 end_window_size 设定值,判断一句话是否说完:
- 未开启 enable_nonstream:判定一句话说完后,直接返回 definite = true,该句结果为最终稳定结果
- 开启 enable_nonstream:判定一句话说完后,系统会对这一小段音频重新识别,用更精准的结果替换之前实时显示的文字,最终返回definite=true
注意事项
- definite = false 的结果适用于实时展示,定稿前可能受后续音频影响而修改结果
- definite = true的结果表示当前分句已定稿,适用于需要稳定结果的场景
Q2:Result_type 取值 full 和 single 有什么区别?
字段说明
result_type 用于控制服务端返回识别结果的组织方式
- full:每次都会重复返回“目前为止的全部文字”,每次返回的结果表示从句子开头到当前时刻已识别出的完整内容,后一包为前一包的累计扩展。以用户说“今天天气真不错。明天也很好。”为例:
- single:每次只返回当前一句,每次返回的结果表示当前正在识别的单个分句,中间结果可能被修正,并通过 definite 字段标识该分句是否已定稿(definite 含义见 Q1)。以用户说“今天天气真不错。明天也很好。”为例:
取值建议
- full:适合只关注最终整句结果、无需精细控制中间态的场景
- single:适合实时字幕等需要按分句逐句上屏、并区分草稿与定稿的场景,可配合 definite 实现“草稿覆盖 + 定稿提交”的展示效果
最近更新时间:2026.09.29 13:48:00
这个页面对您有帮助吗?
有用
有用
无用
无用