即梦AI
即梦AI


文档指南

请输入


- 文档首页
 即梦AI即梦AI-视频生成OmniHuman1.5产品介绍
 复制全文
 下载 pdf
产品介绍
 文档反馈
 问问助手
1. 产品介绍
1.1 产品名称
OmniHuman1.5
1.2 产品介绍
OmniHuman1.5(即梦同源数字人模型),该模型可根据用户上传的单张图片+音频,生成与图片对应的视频效果。支持输入任意画幅包含人物或其他主体(宠物、动漫等)的图片,结合音频,生成高质量的视频。
人物的情绪、动作与音频具有强关联性,支持通过提示词(prompt)对画面、动作、运镜进行调整。同时OmniHuman1.5对动漫、宠物等形象支持较好,允许指定讲话人/主体,可广泛应用于内容表达、唱歌和表演等场景。
相较于上一代模型,OmniHuman1.5 在运动自然度和结构稳定性提升明显,在人物/主体的运动表现力和画面质量上更优。可以广泛应用于制作剧情对话、多人对话/对唱、商品交互、漫剧等内容。对比其他视频通用模型,OmniHuman 数字人大模型在人物/主体的剧情演绎效果上极具优势。
1.3 产品优势
- 节奏性表演:模型效果的灵活性延伸到了音乐领域,算法能够仅凭一张图像和一首歌曲,创造出富有情感的数字歌手。在我们的推理模块驱动下,动作不仅限于简单的口型同步,还包括自然的停顿和节奏变化,能够灵活应对从独唱抒情歌曲到欢快演唱会等各种风格。
- 情感表演:仅通过一张图像和一段音频,模型就能让数字演员“活”起来。通过分析音频的情感内涵(无需文本提示),它能够生成引人入胜、富有电影感的表演,涵盖从激烈愤怒到真挚告白的完整戏剧表现力。
- 上下文感知:我们的模型通过解析音频的语义上下文,超越了简单的口型同步和重复动作,使角色能够表现出真实的情感变化,并让动作与他们的言语和意图相匹配,仿佛他们拥有自己的意志。
- 文本引导的多模态表现:算法精心设计的框架接受文本提示,并展示出卓越的提示遵循能力,从而能够精确控制物体生成、镜头运动和特定动作,同时保持完美的音频同步。
- 单人/多人场景表演:模型的框架扩展到复杂的多人场景,它通过将单独的音轨路由到单个画面中正确的角色,来生成动态的表演,支持指定说话人或一起表演。
- 支持多样化主体:模型展示了绝佳的鲁棒性,涵盖了令人难以置信的多样化主题,包括真实的动物、拟人化的角色和风格化的卡通
注意模型生成具有一定的随机性,并非每次生成效果均符合您的预期
1.4 效果演示
下方演示案例仅用于展示本模型的能力,如果侵犯了您的权利,请联系我们删除
原图 | 驱动效果 | 备注 |
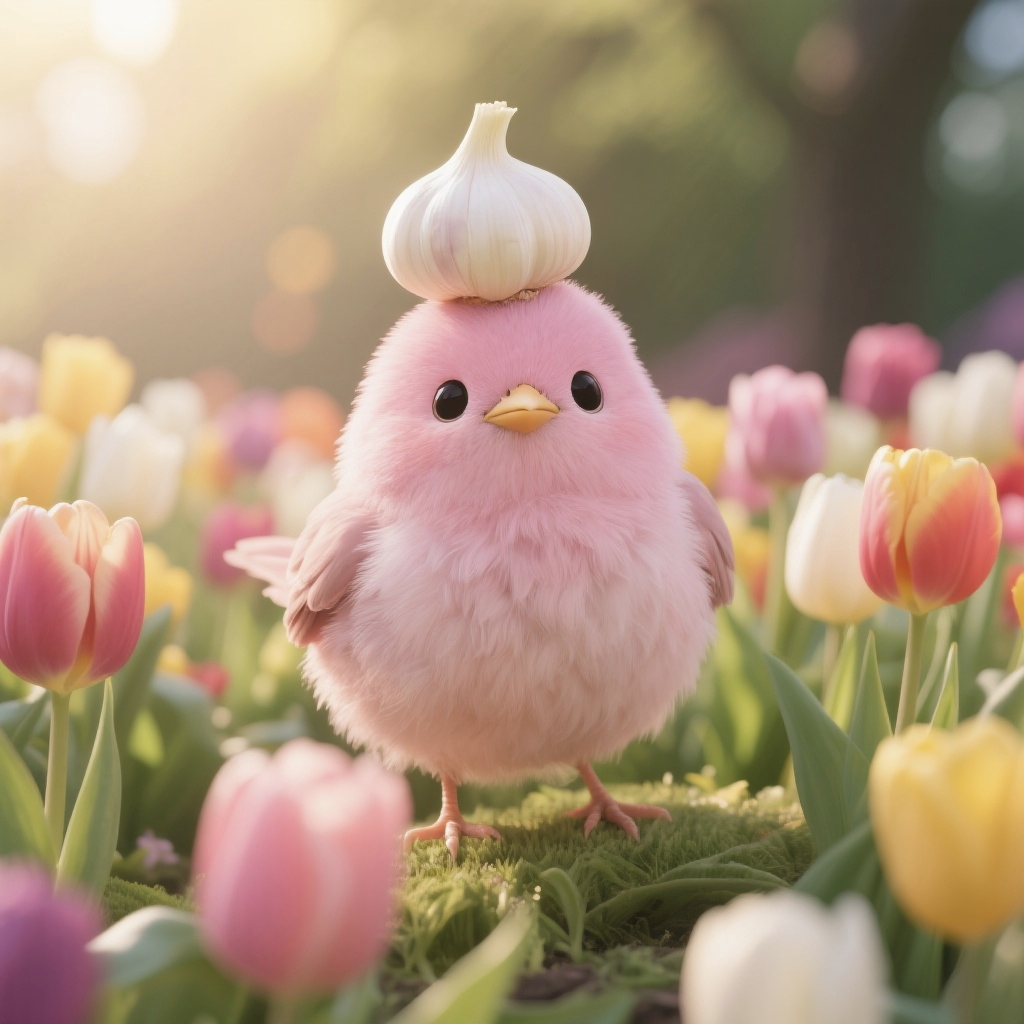 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
| 仅使用图片与音频驱动,不输入提示词。 |
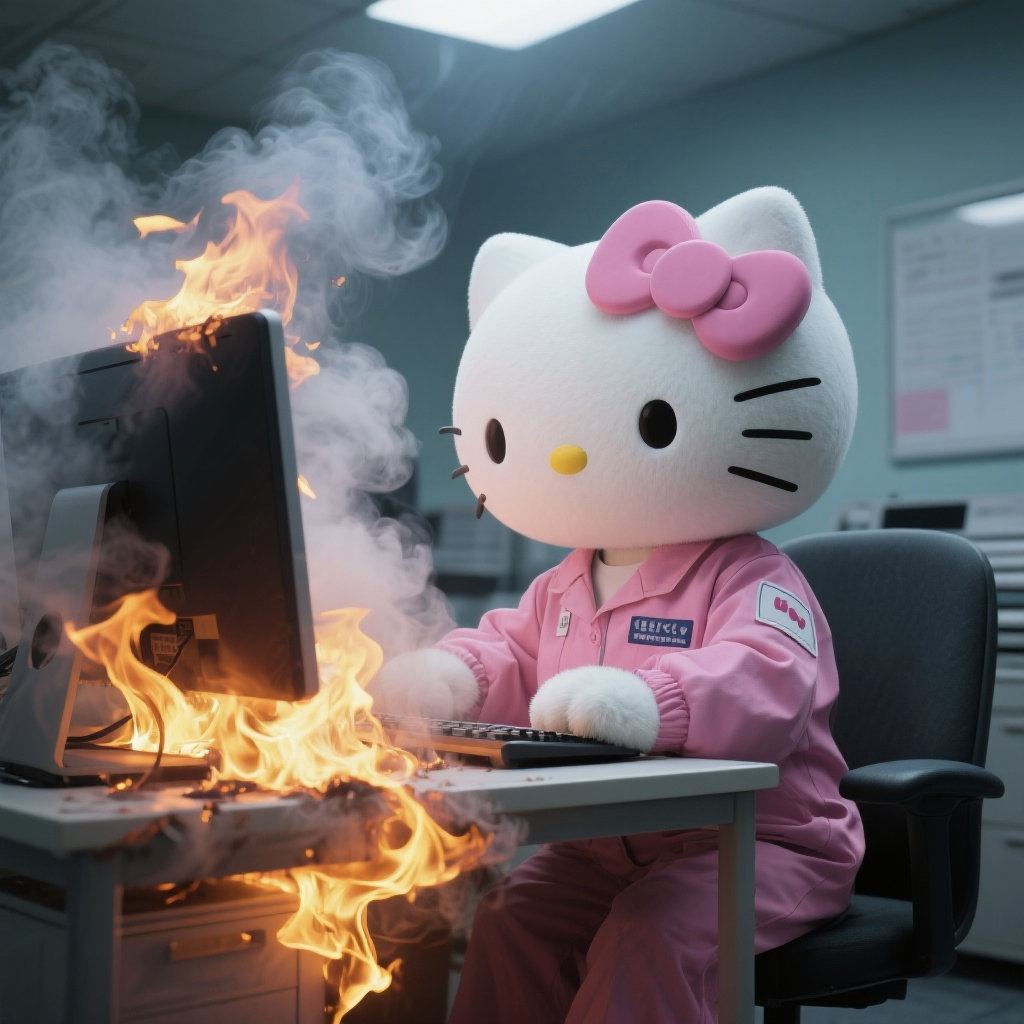 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
| 使用图片与音频驱动,使用提示词描述运镜效果。 |
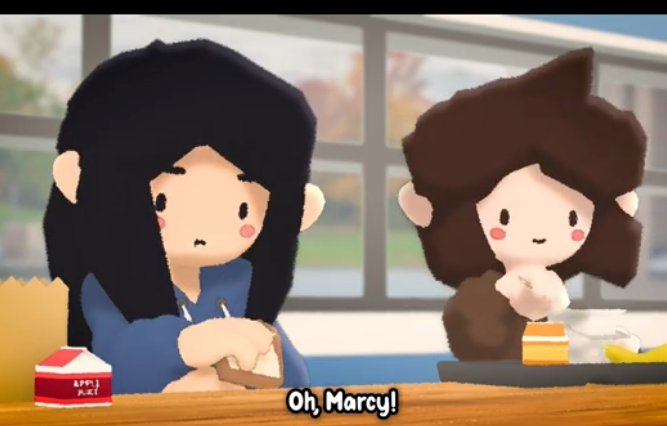 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
| 使用图片与音频驱动,不输入提示词。 多角色图片中,可以指定某个角色说话。 |
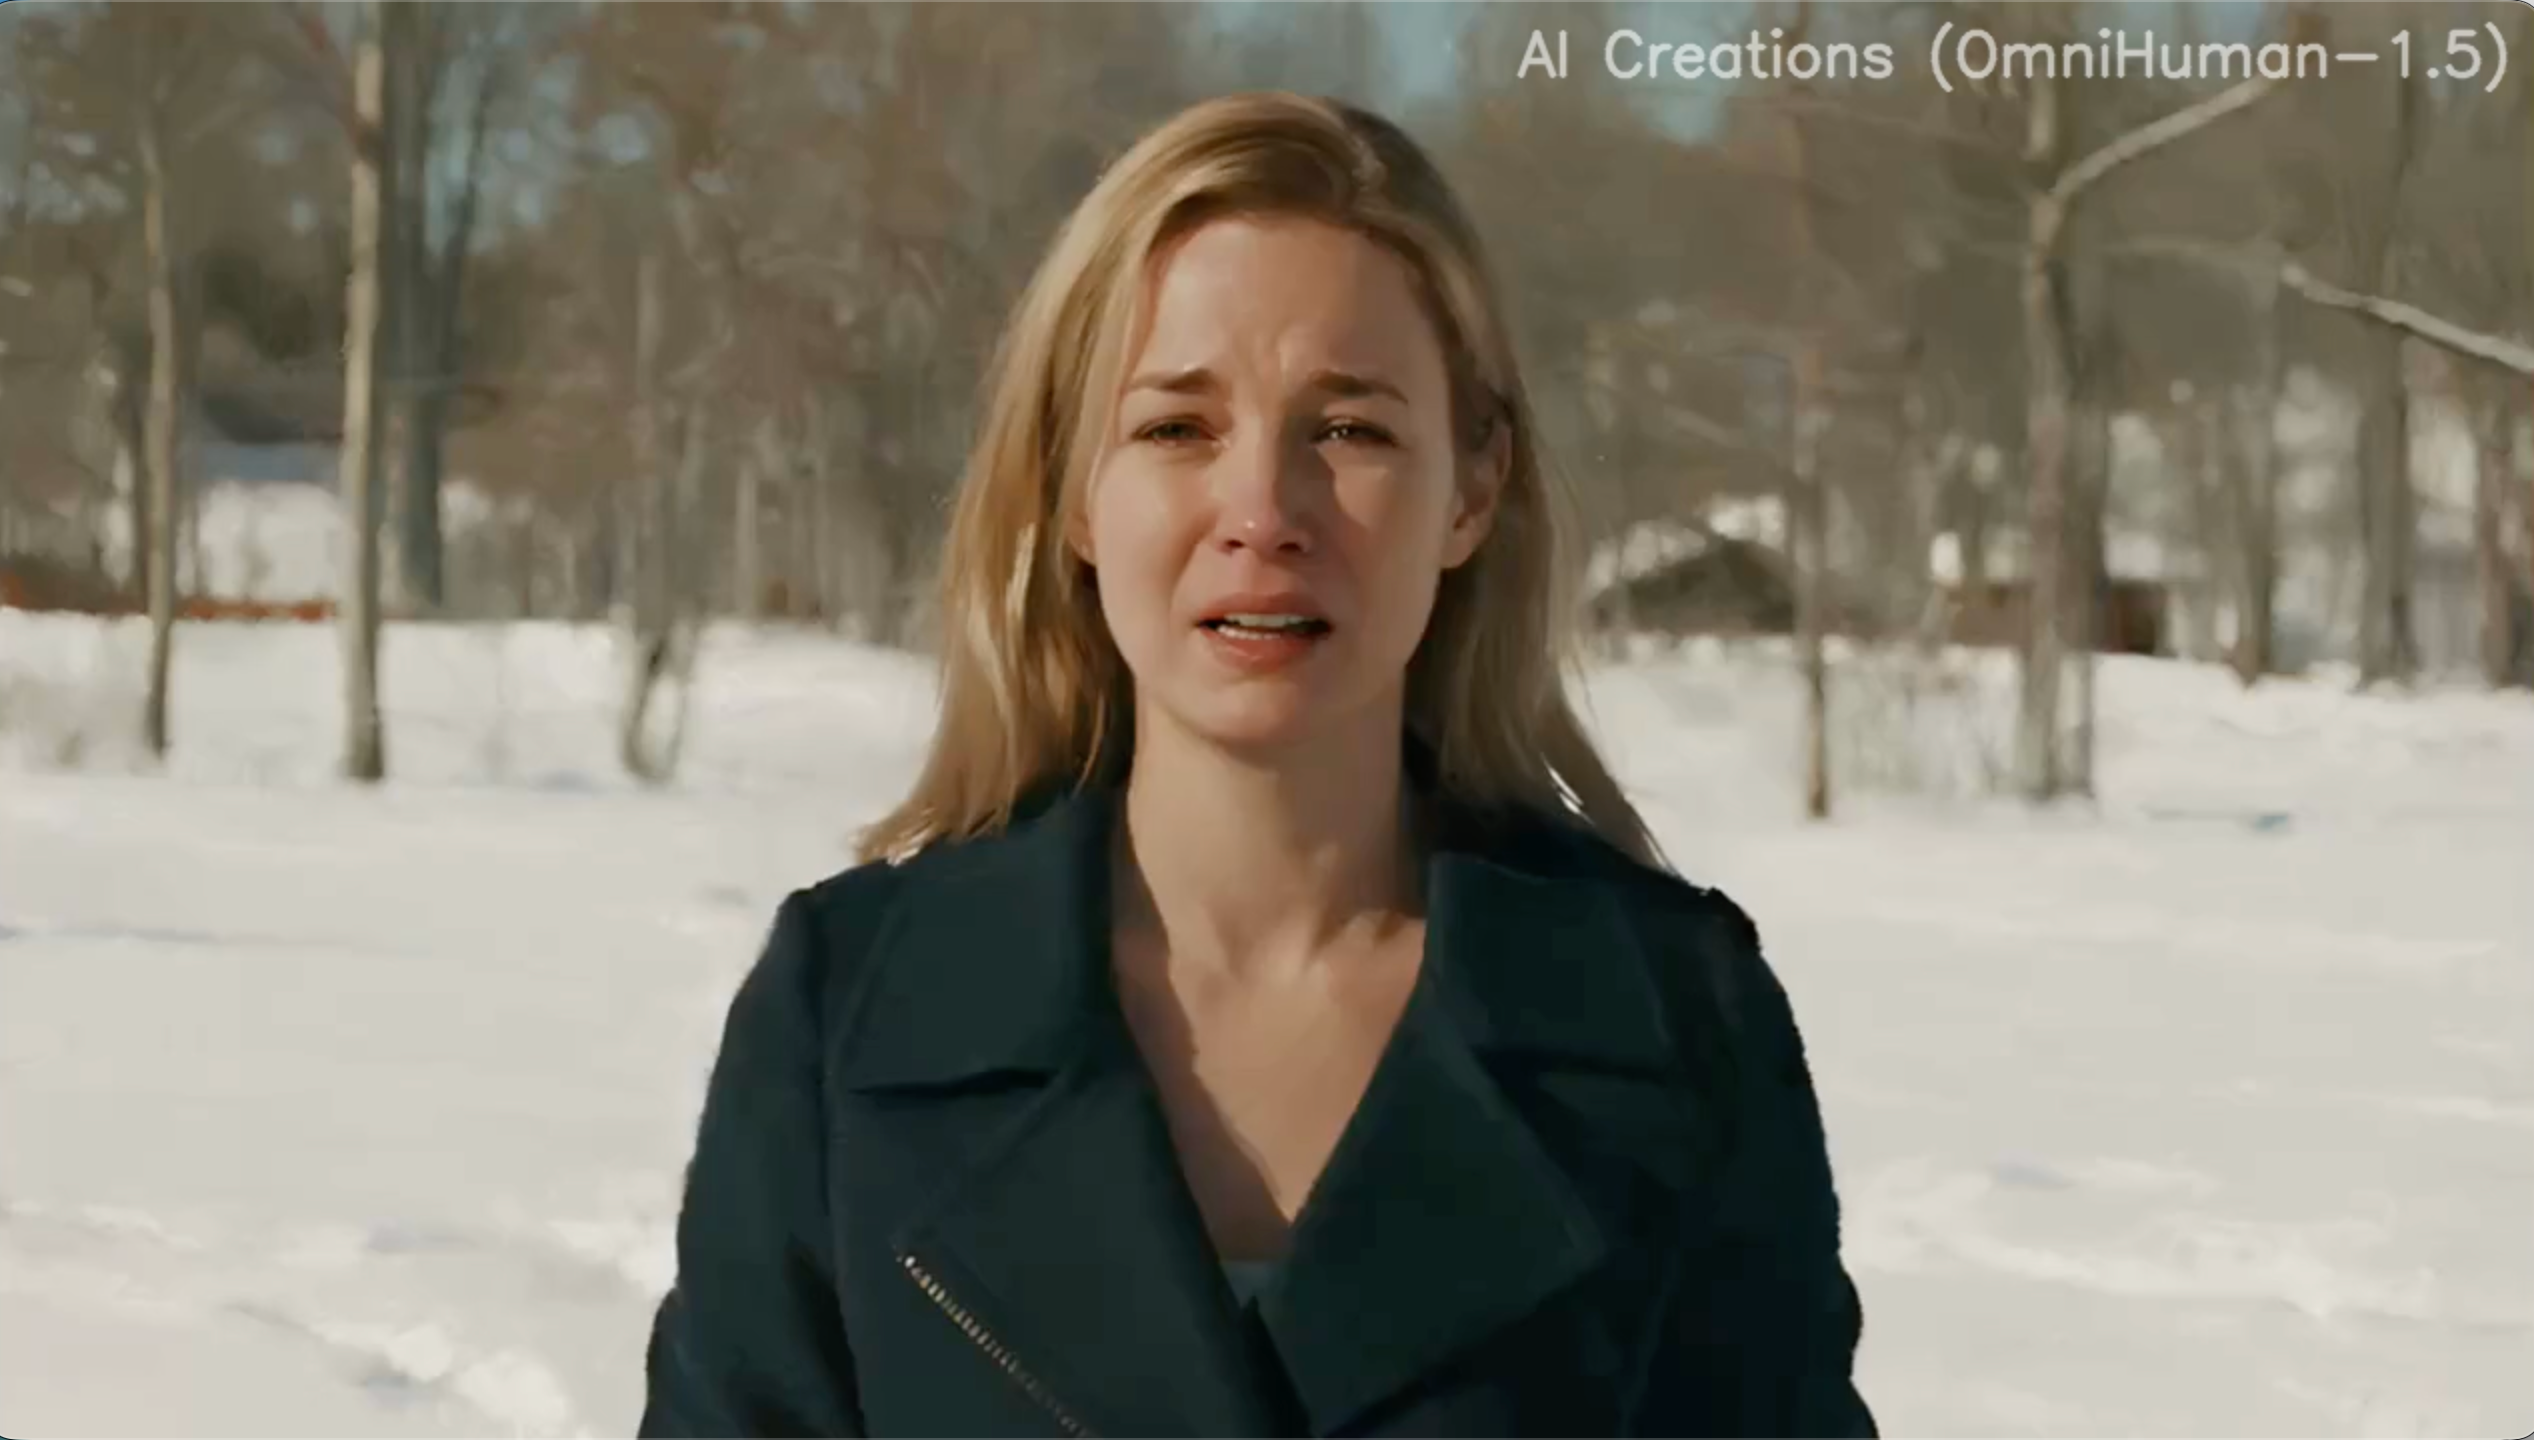 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
| 使用图片与音频驱动,未输入提示词 注意:水印为后期添加,非模型生成 |
2. 提示词指南
2.1 核心原则
- 把编写提示词当成讲故事,使用连贯自然的自然语言,尽可能减少孤立词汇的堆砌。
- 只描述动态的事件即可,图片中已经包含的静态特征(角色穿什么衣服、戴什么首饰等等)无需描述。
- 提示词需要遵循清晰、不矛盾、少否定的原则。使用具体而非抽象的描述,分步骤引导。
2.2 最佳实践模板
推荐结构:镜头运动 + 说话角色情绪 + 说话状态(说话/哭泣/唱歌/...) + 具体动作 + (可选)背景事件/其他角色的动作
完整示例:"镜头从侧面缓慢推进到正面中景。年轻女子坐在窗边,心情平静,轻轻端起咖啡杯,微笑着对镜头说话。旁边的男孩悄悄看着她,时不时转向镜头笑笑。背景中灯光柔和地闪烁。"
2.3 提示词编写示例
指令类型及编写技巧 | 提示词示例 | 驱动效果 |
连续动作及走位控制 通过“先”、“然后”等词描述动作顺序,实现复杂的动作编排。在提示词中加入角色的“说话”、“唱歌”这类词汇 | 镜头跟随,男人转过身看向镜头向前走,陶醉地唱歌。他先用双手摸领口,然后双手张开抬起头,沉醉的样子。 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
先说话再做动作/先做动作再说话 说话时的动作可以进行编排,在说话前后也能插入动作 | 男人迅速摘下口中的香烟,然后对着镜头开口说话。 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
多角色动作控制 多人场景着重描述角色间的互动方式 ⚠️ 多人唱歌和说话(多人场景指定一个人或同时指定多个人)需要使用到主体检测Subject Detection服务,该服务会检测图像中的所有主体(人、动物等)并返回他们各自的mask_url,如果想指定一个形象说话,则传递该形象对应的mask_url,如果想指定多个形象(同时说话)则传递一个mask_url组成的列表 | 跟随镜头,画面左侧举着火把的男人先一边看向其他人说话,随后他重新看向镜头。 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
镜头运动控制
| 镜头向右环绕,聚焦到男人的脸正面。男人快速摘下眼镜,面朝正前方说话。 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
情绪层次控制&微表情控制 结合音频内容描述细腻的情绪变化 | 男人先是神情淡定,对着镜头说话。随后突然变得紧张惊慌,眉头紧皱 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
特效/无中生有/增加画面元素 参考图里没有出现的元素,可以用提示词添加 | 父子俩神情惊愕地望向镜头方向,儿子说话。随后镜头开始缓缓推进,空气中出现扭曲波动,父子如尘烟般被抽入画面深处,瞬间消失。镜头定格,空荡的沙发上,只剩遥控器和手机。 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
镜头焦点控制 对于前后景分别存在不同角色的场景,可以通过提示词控制镜头移焦,配合内容表意 | 记者对着镜头报道,同时身后的国王突然倒地,镜头对焦到记者身后倒地的国王。记者不可思议地快速转过头看着身后说话 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
环境互动描述 让角色与环境产生自然的互动关系,或是描述背景画面里所发生的事件 | 猩猩站在原地,举起右臂保持自拍姿势,看着镜头说话。身后的火山岩浆逐渐变成了蓝色 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
2.4 注意事项
推荐做法:
- 在提示词中将“角色xxx说话”“角色xxx唱歌”写出,有助于提高说话表现
- 视频清晰度高度依赖输入的图片!尽可能上传清晰度更高的图片
- 单次生成效果具随机性,复杂场景可多次抽卡尝试
- 输入提示词效果不佳,也可以尝试不输提示词看看
效果问题规避方法:
- 结构稳定性 15 秒以内较好,15 秒后可能出现衰退
- 人脸占比过小会偶现口型不动(角色不说话)的现象,尽可能规避超远景
- 人物长时间出镜再入镜后易出现一致性变化,设计提示词时尽量规避角色反复出镜的情况
- 极端姿势或角度效果可能不佳
3. 入参与出参说明
4. 服务开通与计费规则
4.1 服务开通
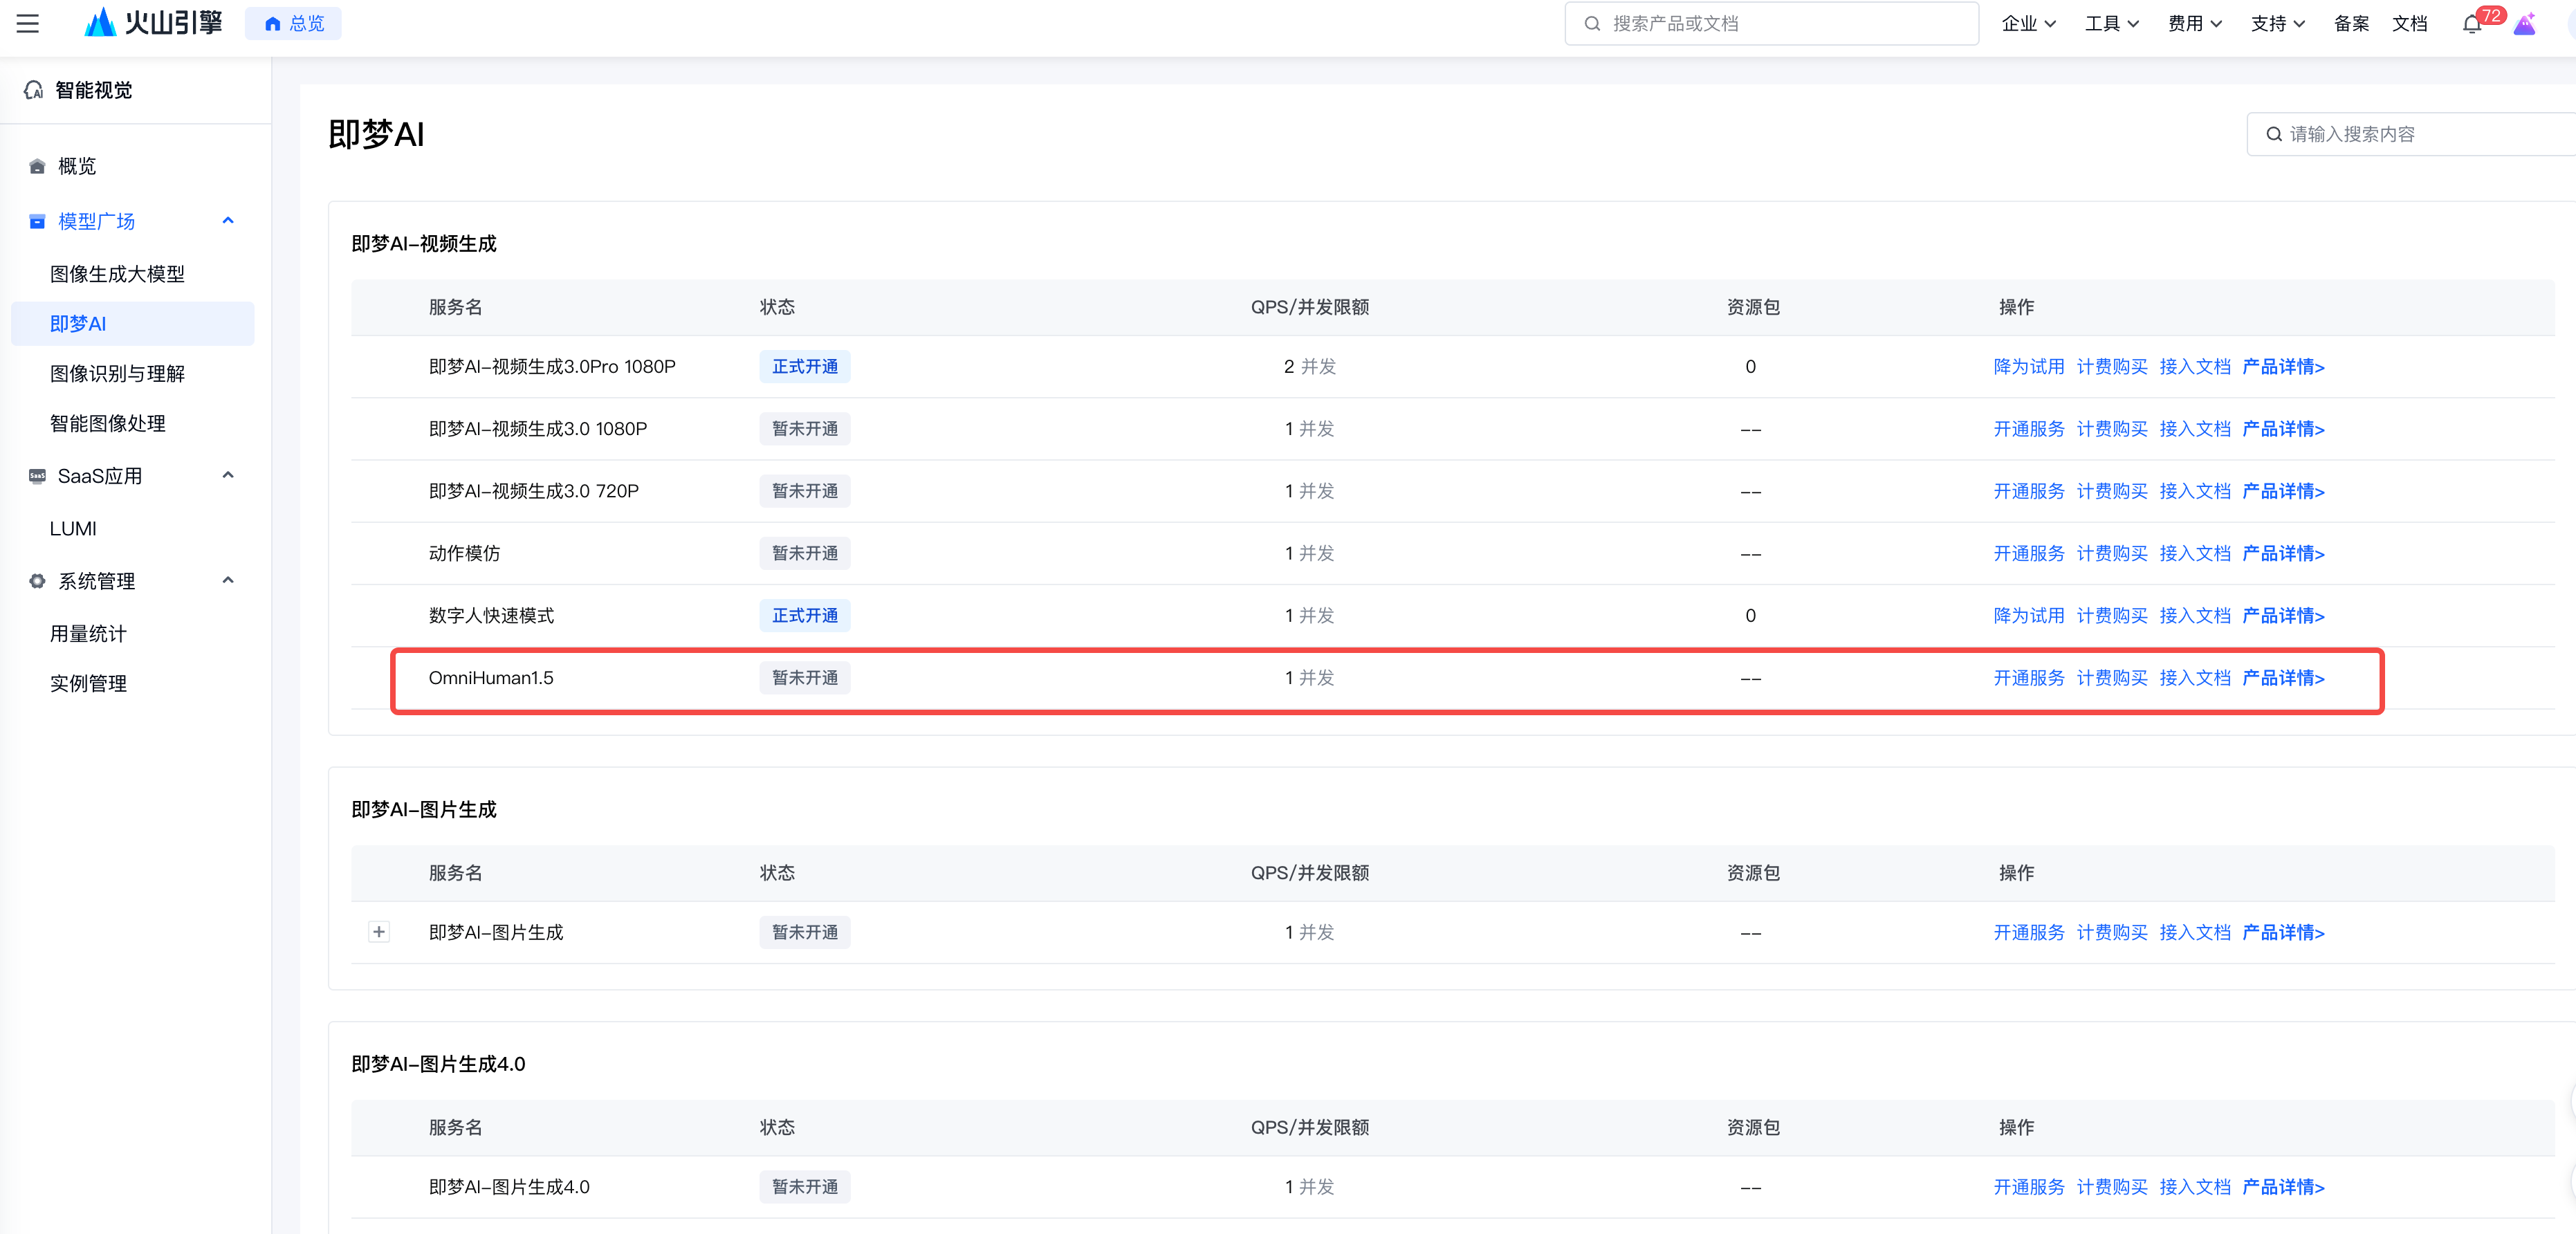
4.2 计费规则
本服务按生成视频时长计费
单价 | 并发限额 |
1 元/秒 | 1 |
4.3 欠费关停策略
- 账户可用余额不足或账户可用余额小于0被扣为负值,即为欠费。
- 账户欠费起2个小时内可正常使用服务。
- 自账户欠费起24个小时仍未能补缴所有欠费账单,视为主动放弃服务,资源将被释放且无法恢复。
最近更新时间:2026.01.19 14:57:41
这个页面对您有帮助吗?
有用
有用
无用
无用