AI 数据湖服务
AI 数据湖服务


LAS skills

请输入


- 文档首页
 AI 数据湖服务LAS skills 应用实践音频提取切分 Skill:播客剪辑/音乐创作/多人物配音分离
 复制全文
 下载 pdf
音频提取切分 Skill:播客剪辑/音乐创作/多人物配音分离
 文档反馈
 问问助手
音频切分 Skill 是 AI 数据湖服务(LAS)提供的多模态数据处理技能,目前已对接火山引擎 ArkClaw 和 OpenClaw。
Skill 优势
LAS 音频切分 Skill 可对长音频进行自动识别与精细化切分,替代传统手动拉进度条、找静音段的低效方式。基于声学特征与语音内容联合分析,音频切分 Skill 支持按静音段、说话人、语义片段等多种策略灵活切分,自动生成标准化片段信息并输出可直接用于下游生产的音频文件,适用于播客剪辑、语音课程拆条、客服录音分段、素材资产化等多种音频内容生产与运营场景。
应用场景
说明
以下为您展示示例的PDF文档解析效果,解析结果为大模型生成,每次生成结果可能不完全一致。
场景一:从视频中提取音频
场景介绍
你是一名脱口秀综艺剪辑师,需要在一集长达 8 分钟的短视频中,提取出对应的音频,并发布到博客上。
效果展示
原视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
任务示例
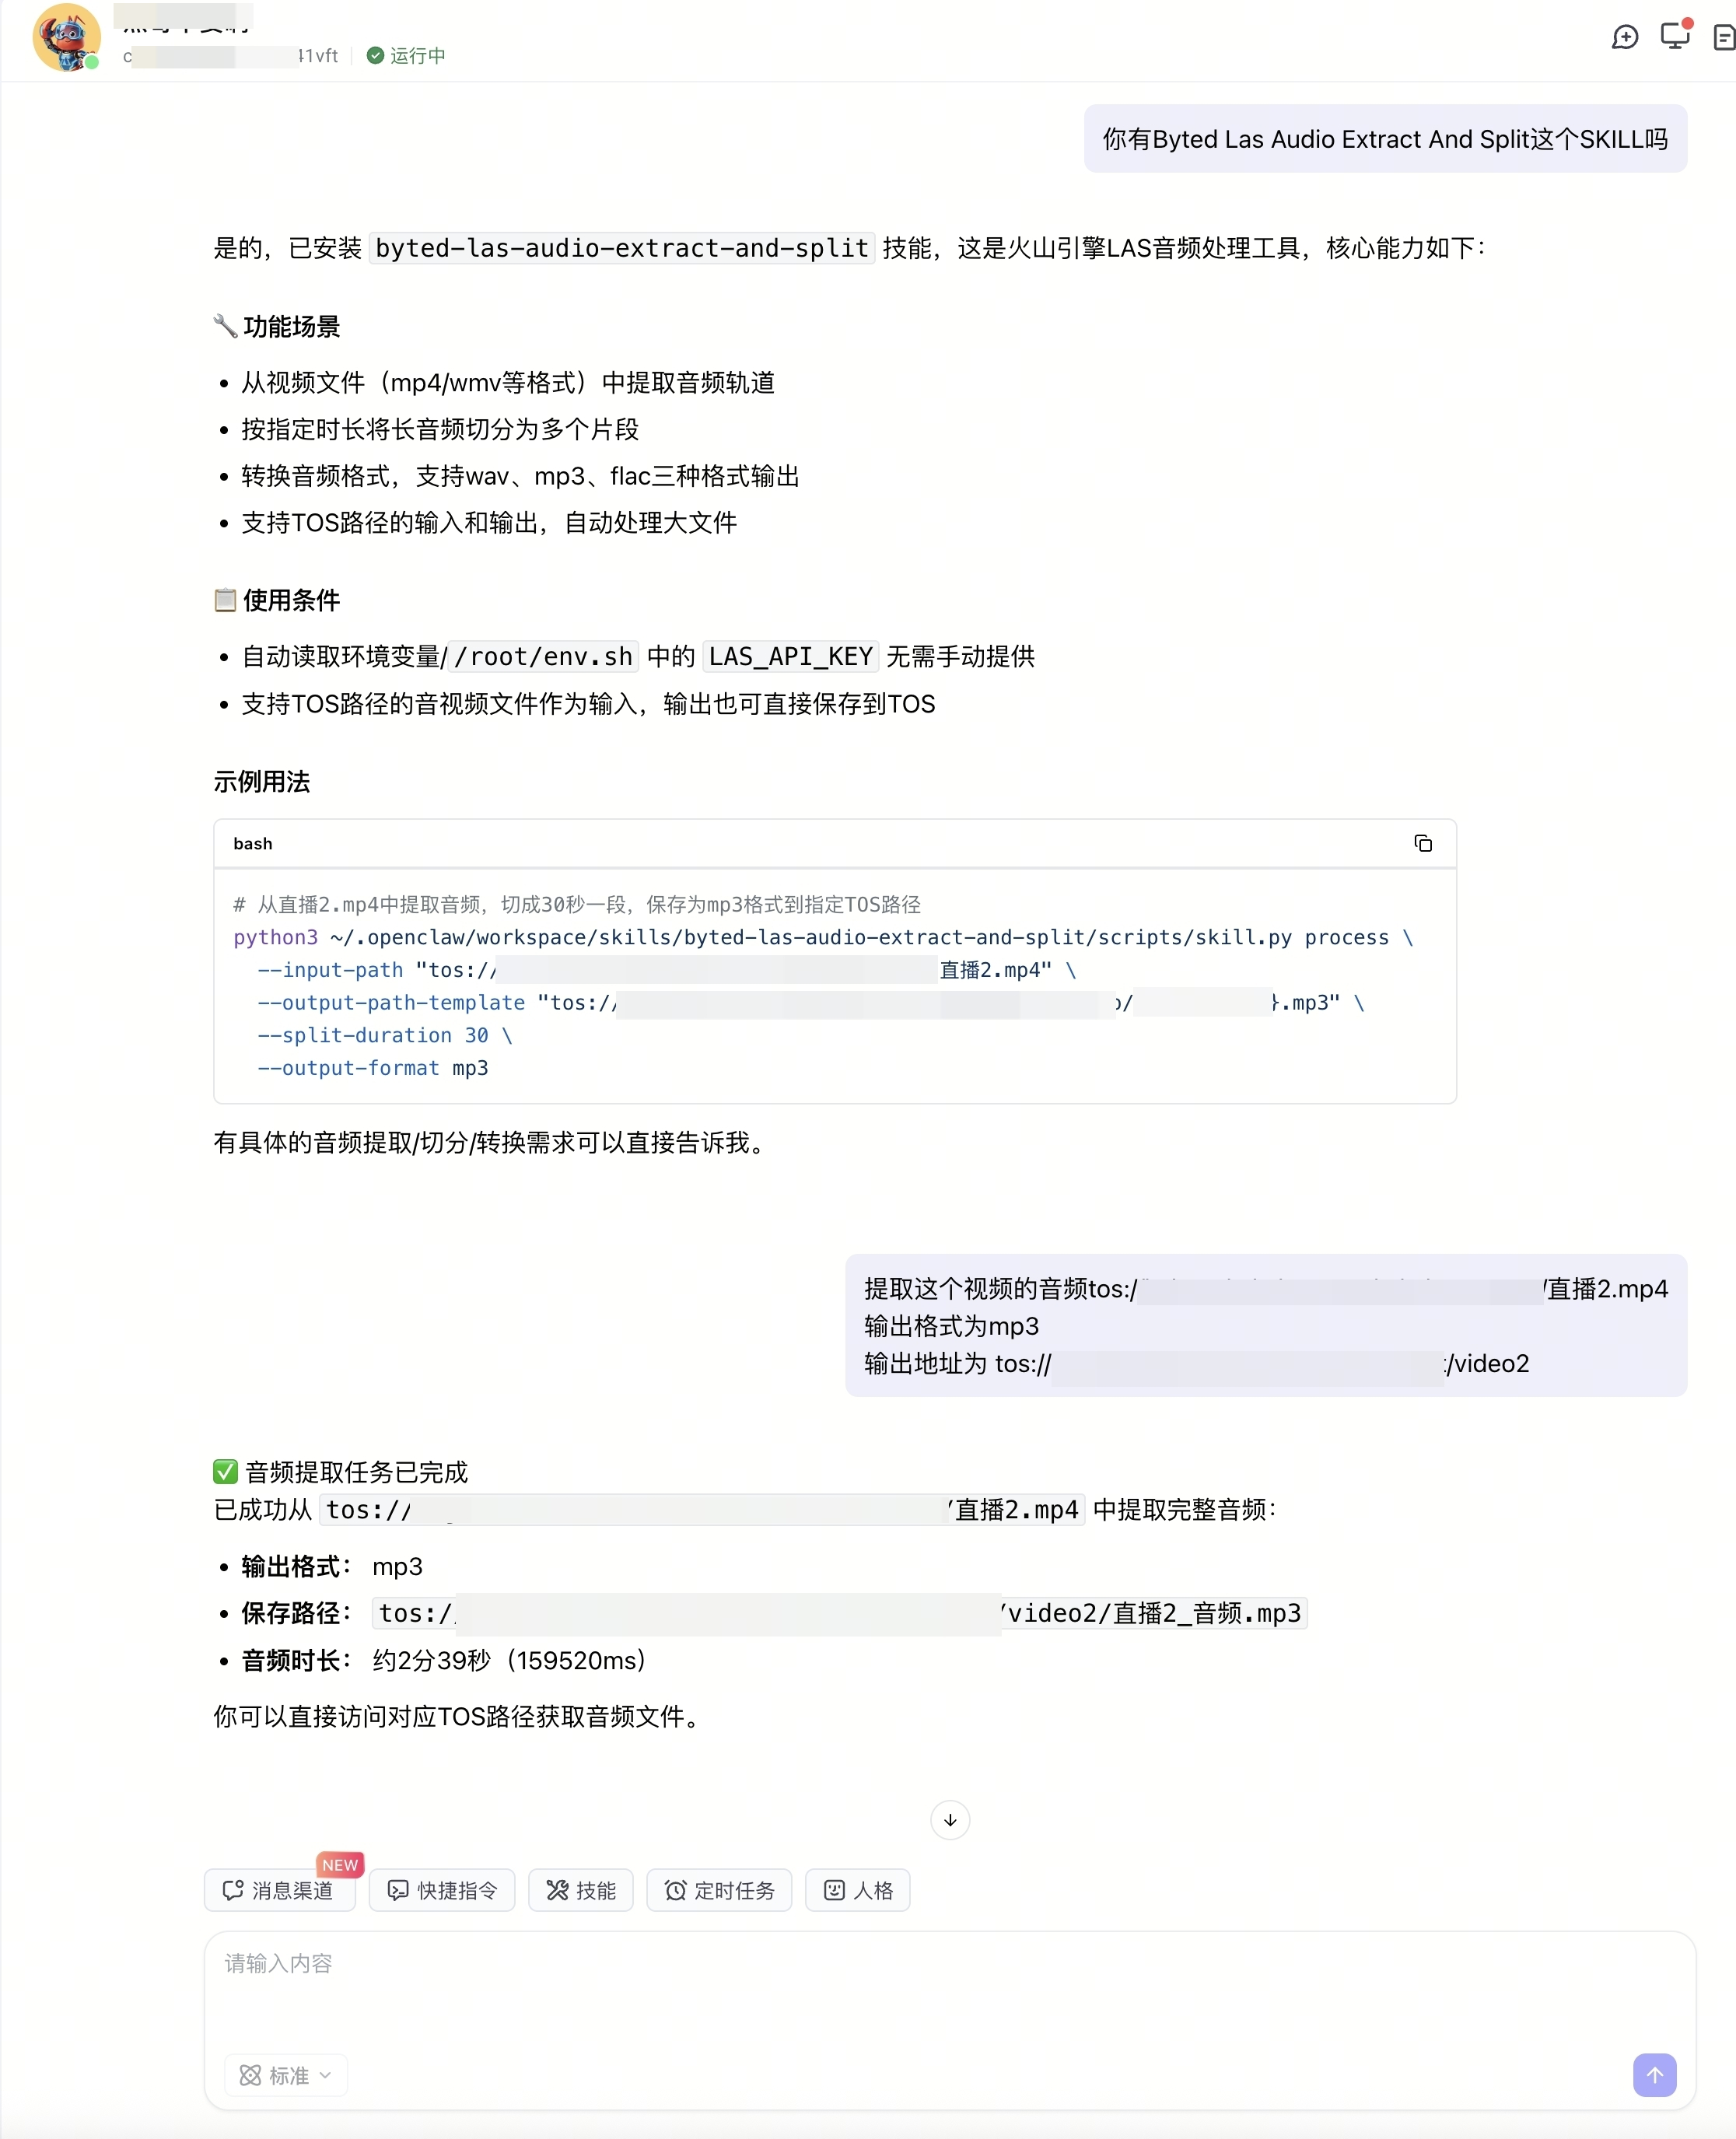
提取后的音频
场景二:将长音频进行切分
场景介绍
你是一名播客自媒体,需要将一段长达 38 分钟的音频按照时长进行等分,并加上后期制作,形成新的宣传/预告片段,做播客的引流。
效果展示
原音频
任务示例
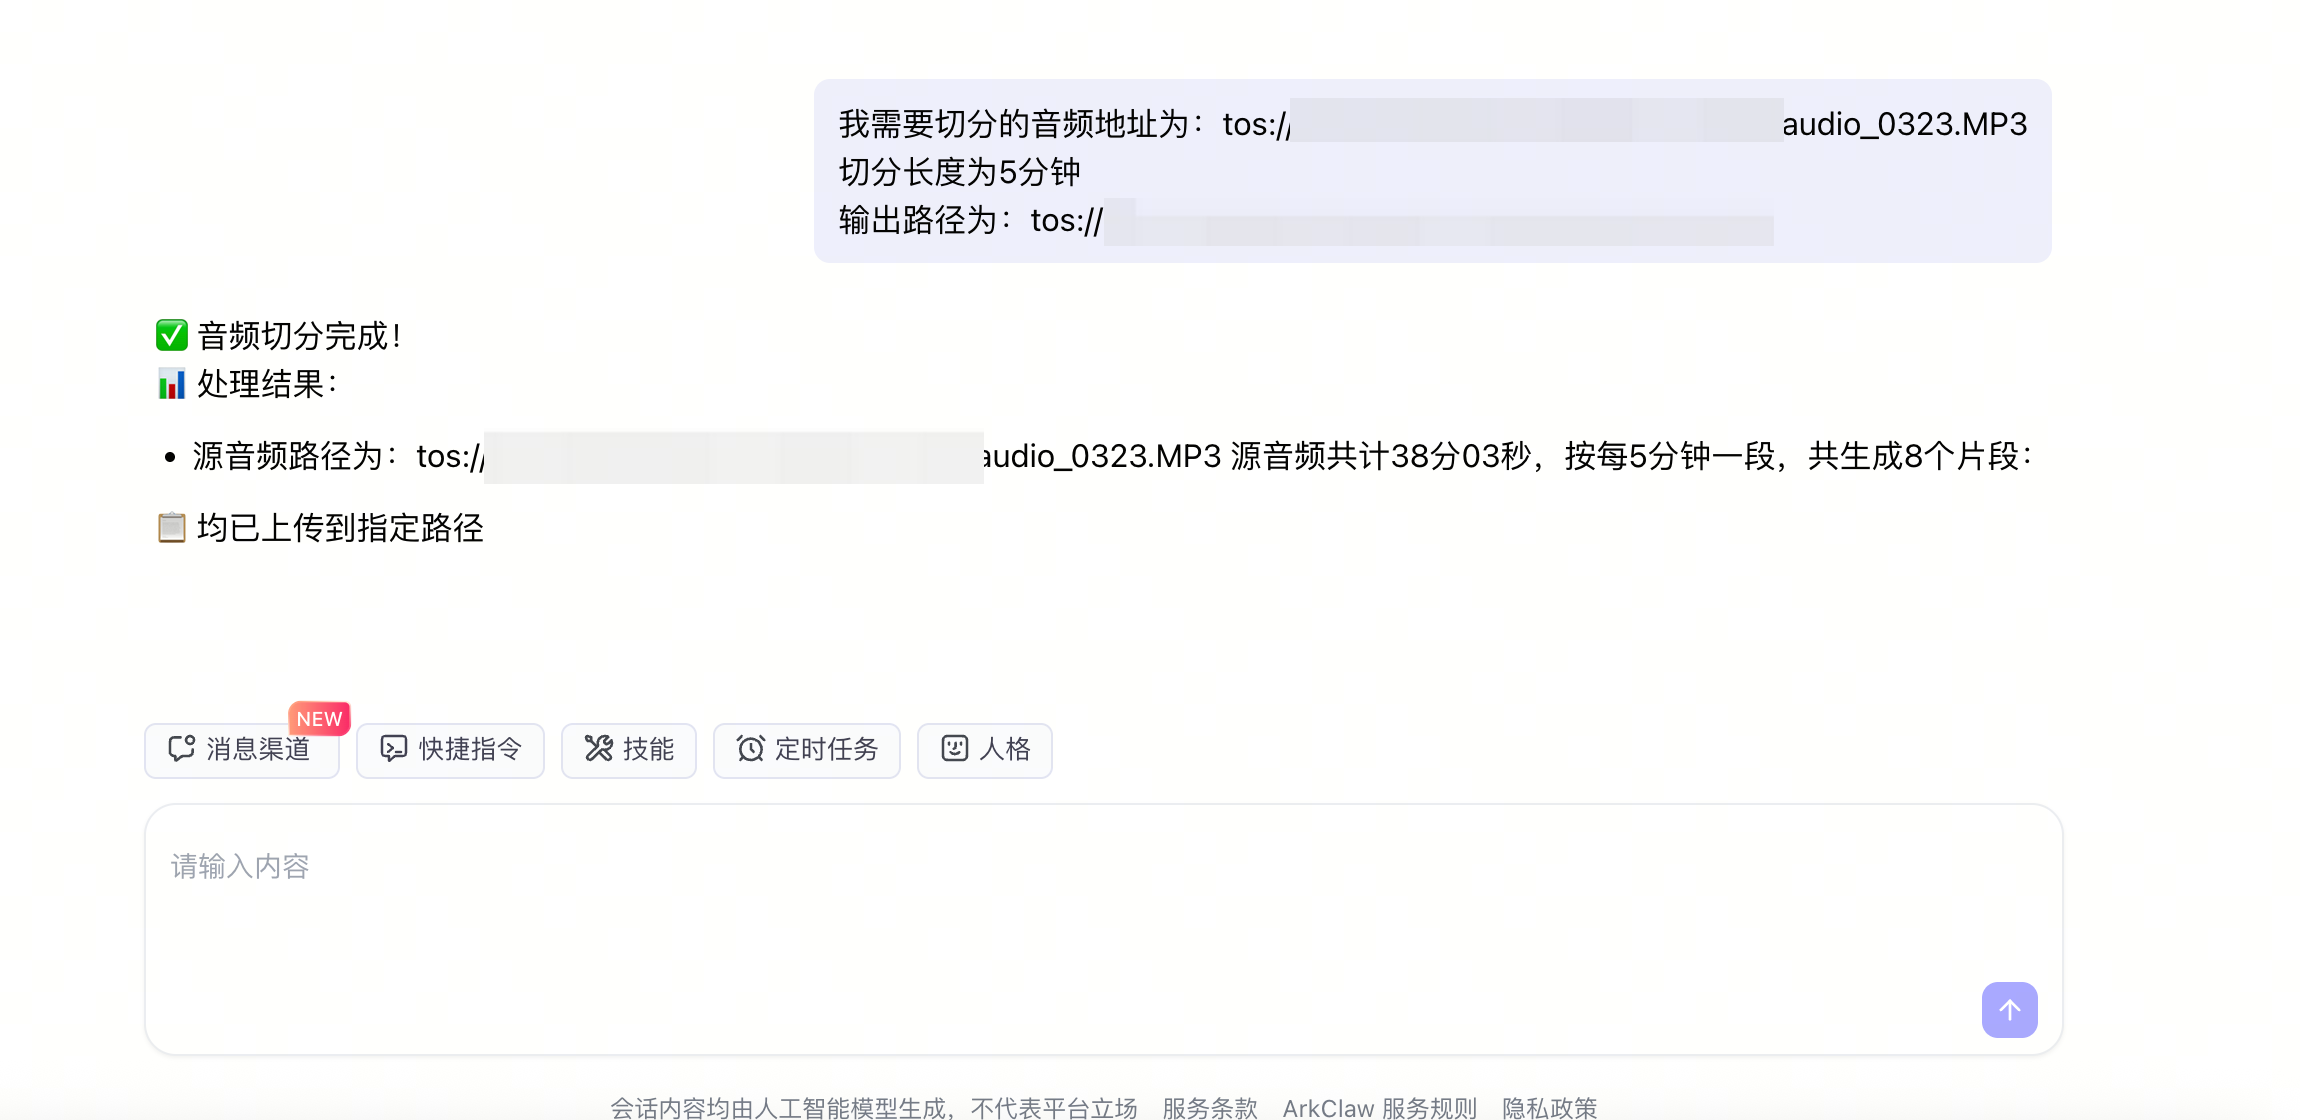
切分后的音频
最近更新时间:2026.04.01 20:58:54
这个页面对您有帮助吗?
有用
有用
无用
无用