云数据库 MySQL 版
云数据库 MySQL 版


文档指南

请输入


- 文档首页
 云数据库 MySQL 版内核功能功能向量索引
 复制全文
 下载 pdf
向量索引
 文档反馈
 问问助手
本文介绍云数据库 MySQL 版提供的向量索引的相关信息。
支持版本
- MySQL 8.0 版本,且内核小版本为 MySQL 8.0.43_20251015 及以上。
- MySQL 8.4 版本,且内核小版本为 MySQL 8.4.7_20260415 及以上。
背景信息
近几年,数据库领域已从过去严格的精确匹配查询,转变为一种更为模糊、更注重上下文感知的模式。此次模式转变的核心在于向量搜索技术,该技术使得数据库能够基于数据的语义(即其内在含义)而非字面表述来理解和查询数据。
数据被表示为向量后,向量检索的基本任务就变成了为给定的查询向量找到 k-最近邻(K-Nearest Nighbor, KNN)。这需要计算查询向量与数据集中所有其他向量之间的距离,以识别出最相似的 k 个条目。SQL 表示如下。
SELECT id
FROM tv
ORDER BY L2_distance(vector, To_vector('[1,2,3,4]'))
LIMIT 10; -- top K, K=10
这个过程在概念上很简单,但面临着一个被称为“维度诅咒 Curse of dimensionality” 的问题。由于模型生成的向量嵌入通常是高维的,常常包含数百甚至数千个维度。随着维度数量的增加,向量空间的体积呈指数级增长。在这样一个巨大而稀疏的空间里,“邻近”的概念变得不那么有意义,几乎所有的点都变得彼此等距。
对于大规模在线应用而言,进行“暴力”的 KNN 搜索在计算上是不可行的。这种搜索的时间复杂度为线性,即O(N),其中 N 为数据集中的向量数量。对于包含数百万或数十亿向量的数据集,该方法会导致业务不可接受的高延迟。“维度诅咒”由此成为一个核心的问题,这推动了学界和业界对向量搜索算法的创新与多样化。大家都在尝试回答同一个问题:“如何在一个巨大的稀疏的空间里高效地找到最近似的向量,并且避免暴力搜索?”
为了克服“维度诅咒”带来的性能限制,现代向量搜索系统绝大多数依赖于近似最近邻(Approximate Nearest Neighbor, ANN)算法。ANN 的核心原则是以牺牲少量(通常可以忽略不计)的准确性,来换取搜索速度和可扩展性的巨大提升。ANN 算法不保证找到绝对真实的最近邻,而是采用启发式方法和优化的数据结构,在极短的时间内找到“足够好”的匹配项。
特性说明
使用说明
参数说明
语法说明
通过 CREATE TABLE 语法创建一个包含向量列和向量索引的表。
语法
CREATE TABLE table_name [IF NOT EXISTS] (
[(create_definition,...)]
vector_column_name VECTOR(N) NOT NULL,
VECTOR {INDEX | KEY} [index_name] (vector_column_name)
[USING HNSW]
[SECONDARY_ENGINE_ATTRIBUTE= {...}]
) ENGINE = InnoDB;
参数说明
- 向量索引关键字(必选):VECTOR INDEX(column_name) 或者 VECTOR KEY(column_name)。
- 算法类型(可选):
- 方式 1:通过 USING [ANN_ALGORITHM] 指定 ANN 算法,如 HNSW。
- 方式 2:通过 SECONDARY_ENGINE_ATTRIBUTE 的 algorithm 字段指定索引。
- 距离计算方法(可选):EUCLIDEAN,L2,COSINE。
- 算法参数(可选):通过 SECONDARY_ENGINE_ATTRIBUTE 调整对应 ANN 算法的参数,如:
- HNSW :M 值;ef_construction 值。
示例
- 示例 1:使用系统默认的算法与参数。
- CREATE TABLE tv (pk INT,embedding VECTOR(4) NOT NULL,VECTOR INDEX (embedding) ) ENGINE=InnoDB;
- 示例 2:指定索引算法,使用默认算法参数。
- CREATE TABLE tv (pk INT,embedding VECTOR(4) NOT NULL,VECTOR INDEX (embedding) USING HNSW ) ENGINE=InnoDB;
- 示例 3:指定索引算法与参数。
- CREATE TABLE tv (pk INT,embedding VECTOR(4) NOT NULL,VECTOR INDEX (embedding) SECONDARY_ENGINE_ATTRIBUTE='{"algorithm": "hnsw", "M": "16", "distance": "cosine"}') ENGINE=InnoDB;
-
通过 CREATE INDEX 语法给含有向量类型的表创建一个向量索引。
说明
MySQL 8.0.43_20251215 及之后的内核小版本支持在已有数据上构建向量索引。您可通过查看实例信息查看实例的内核小版本。如您实例的内核小版本未在受支持的内核小版本范围内,您可手动升级实例内核小版本。
语法
CREATE VECTOR INDEX vector_index_name on table_name(vector_column_name) [USING HNSW] [SECONDARY_ENGINE_ATTRIBUTE= {...}];
参数说明
- 向量索引关键字(必选):VECTOR INDEX(column_name) 或者 VECTOR KEY(column_name)。
- 算法类型(可选):
- 方式 1:通过 USING [ANN_ALGORITHM] 指定 ANN 算法,如 HNSW。
- 方式 2:通过 SECONDARY_ENGINE_ATTRIBUTE 的 algorithm 字段指定索引。
- 距离计算方法(可选):EUCLIDEAN,L2,COSINE。
- 算法参数(可选):通过 SECONDARY_ENGINE_ATTRIBUTE 调整对应 ANN 算法的参数,如:
- HNSW :M 值;ef_construction 值。
示例
- 示例 1:使用系统默认的算法与参数。
CREATE VECTOR INDEX embedding_idx ON tv(embedding);
- 示例 2:指定算法, 使用默认参数。
CREATE VECTOR INDEX embedding_idx ON tv(embedding) USING HNSW;
- 示例 3:指定算法与参数。
CREATE VECTOR INDEX embedding_idx ON tv(embedding) SECONDARY_ENGINE_ATTRIBUTE='{"algorithm": "hnsw", "M": "16", "distance": "cosine"}';
通过 ALTER TABLE 语法给含有向量类型的表创建一个向量索引。
说明
MySQL 8.0.43_20251215 及之后的内核小版本支持在已有数据上构建向量索引。您可通过查看实例信息查看实例的内核小版本。如您实例的内核小版本未在受支持的内核小版本范围内,您可手动升级实例内核小版本。
语法
ALTER TABLE table_name ADD VECTOR {INDEX | KEY} [index_name] (vector_column_name) [USING HNSW] [SECONDARY_ENGINE_ATTRIBUTE= {...}];
参数说明
- 向量索引关键字(必选):VECTOR INDEX(column_name) 或者 VECTOR KEY(column_name)。
- 算法类型(可选):
- 方式 1: 通过 USING [ANN_ALGORITHM] 指定 ANN 算法,如 HNSW。
- 方式 2: 通过 SECONDARY_ENGINE_ATTRIBUTE 的 algorithm 字段指定索引。
- 距离计算方法(可选):EUCLIDEAN,L2,COSINE。
- 算法参数(可选):通过 SECONDARY_ENGINE_ATTRIBUTE 调整对应 ANN 算法的参数,如:
- HNSW :M 值;ef_construction 值。
示例
- 示例 1:使用系统默认算法与参数。
ALTER TABLE tv ADD VECTOR INDEX embedding_idx(embedding);
- 示例 2:指定算法,使用默认参数。
ALTER TABLE tv ADD VECTOR INDEX embedding_idx(embedding) USING HNSW;
- 示例 3:指定算法与参数。
ALTER TABLE tv ADD VECTOR INDEX embedding_idx(embedding) SECONDARY_ENGINE_ATTRIBUTE='{"algorithm": "hnsw", "M": "16", "distance": "l2"}';
通过 DROP INDEX 语法删除向量索引。
语法
DROP INDEX vector_index_name on table_name;
示例
DROP INDEX embedding_idx on tv;
查看指定向量索引信息
查看向量索引相关信息(如辅助表名,算法参数)。
语法
SELECT VECTOR_INDEX_INFO(schema_name, table_name, index_name)
示例
- 示例 1 :查看构建中的索引信息。
mysql> select vector_index_info("test", "tv", "embedding_idx");
+---------------------------------------------------------------------------------+
| vector_index_info("test", "tv", "embedding_idx") |
+---------------------------------------------------------------------------------+
| {
"index_info": {
"building": true,
"build_status": {
"phase": "build_index",
"total_vectors": 1,
"start_time_utc": "2025-12-11T 03:34:36",
"start_timestamp": 1765424076988,
"processed_vectors": 2000
}
},
"runtime_stats": {}
} |
+---------------------------------------------------------------------------------+
1 row in set (0.00 sec)
- 示例 2:查看索引的运行时信息。
mysql> select vector_index_info("test", "tv", "embedding_idx");
+---------------------------------------------------------------------------------+
| vector_index_info("test", "tv", "embedding_idx") |
+---------------------------------------------------------------------------------+
| {
"data_table": {
"name": "__bytevec_7a6658e1751dc126_hnsw_graph",
"size_bytes": 376832
},
"index_info": {
"hnsw": {
"m": 16,
"ef_construction": 10
},
"algorithm_type": "hnsw",
"distance_metric": "euclidean"
},
"runtime_stats": {
"version": 0,
"diameter": 7305.353515625,
"mem_bytes": 1048576,
"graph_size": 1015,
"search_queries": 1,
"node_cache_size": 641,
"node_cache_hit_count": 3062,
"node_cache_miss_count": 641
}
} |
+---------------------------------------------------------------------------------+
查看实例的向量索引信息
查看实例上所有使用中的向量索引相关信息,可以让用户实时追踪索引构建的进度与向量索引的资源使用。
语法
SHOW VECTOR INDEX STATUS;
示例 :查看索引构建进度与运行时信息
MySQL> SHOW VECTOR INDEX STATUS\G
*************************** 1. row ***************************
DB: test
TABLE_NAME: tv -- 用户表名
INDEX_NAME: embedding_idx -- 索引别名
ALGORITHM: HNSW -- 算法名称
DISTANCE_METRIC: L2 -- 距离度量
BASE_TABLE: tv -- 基表名
DATA_TABLE_DB: test -- 辅助表 DB名
DATA_TABLE_NAME: __bytevec_7a6658e1751dc126_hnsw_graph -- 辅助表名
REF_LENGTH: 4 -- 主键长度
BUILDING: YES -- 索引是否处于构建中
BUILD_PHASE: BUILD_INDEX -- 索引构建阶段
BUILD_TOTAL_VECTORS: 1000015 -- 构建的总向量数
BUILD_PROCESSED_VECTORS: 396000 -- 已处理的向量数
BUILD_PROGRESS_PCT: 39.599406 -- 构建进度
BUILD_START_TIME_MS: 1769159800366 -- 构建开始时间戳
RUNTIME_INFO: version=0,hits=0,misses=0,queries=0,graph_size=0,diameter=0.000000,mem_bytes=0,node_cache_size=0
1 row in set (0.004 sec)
云数据库 MySQL 版提供向量距离函数,您可以使用这些函数对实例执行近似最近邻 (ANN) 和 K 最近邻 (KNN) 向量相似度搜索。当您运行查询时,系统会将通过向量索引将向量与您数据集中的向量进行比较。距离函数使用余弦等相似度指标计算向量之间的距离。相隔距离最短的向量相似度最高,并会在搜索结果中返回。
如需执行 ANN 搜索,请在 SELECT 和 ORDER BY 子句中使用距离函数 dist_expr 。您必须在 ANN 搜索中使用 LIMIT 子句。您还可以通过将距离函数dist_expr 放入 SELECT 列表中来获取距离值。
语法
SELECT {col_name}
FROM table_name [FORCE INDEX (vector_column_name)]
[WHERE where_condition]
ORDER BY { dist_expr }
LIMIT N;
注意事项
- dist_expr:距离函数,对于 HNSW 向量索引,支持 L2_DISTANCE/EUCLIDEAN_DISTANCE(欧氏距离),COSINE_DISTANCE(余弦距离)2 种距离计算方法。
- 使用 ORDER BY ... LIMIT 时,若使用距离函数排序,系统会尝试通过向量索引 ANN 召回(近似结果)。
- 用户可使用 FORCE INDEX 指定向量索引;若未指定,优化器会自动判断是否使用索引(全表扫描 vs. ANN)。
- 若 ANN 查询与索引使用了不同的距离的距离度量,MySQL 将优先选择索引构建时使用的距离度量。
距离函数 dist_expr 示例
- 示例 1:查询向量 [1,2,3,4] 与 vector 向量列中的向量使用欧式距离 进行比较。
L2_distance(vector, To_vector('[1,2,3,4]'))
- 示例 2:查询向量 [1,2,3,4] 与 vector 向量列中归一化后的向量使用欧式距离进行比较。
L2_distance(vector_normalize(vector), To_vector('[1,2,3,4]'))
ANN 查询示例
- 示例 1:在表 tv 中搜索距离向量 [1, 2, 3, 4] 最近的 10 个向量的主键 id。
SELECT id
FROM tv
ORDER BY L2_distance(vector, To_vector('[1,2,3,4]'))
LIMIT 10;
- 示例 2:使用 FORCE INDEX 指定向量索引。
SELECT id
FROM tv FORCE INDEX(vector)
ORDER BY L2_distance(vector, To_vector('[1,2,3,4]'))
LIMIT 10;
- 示例 3:将 dist_expr 距离函数与使用标量谓词过滤查询结果的 WHERE 条件结合使用,以执行后过滤。
SELECT id
FROM tv FORCE INDEX(vector)
WHERE id > 1000
ORDER BY L2_distance(vector, To_vector('[1,2,3,4]'))
LIMIT 10;
ANN 查询计划
通过 explain 语句返回的 Extra 列是否包含 Using ANN Search 判断查询是否使用了向量索引。
mysql> EXPLAIN SELECT id, name, num, from_vector(vector), L2_DISTANCE(vector, TO_VECTOR('[1,2,3,4]')) as dist FROM tv FORCE INDEX(vector) ORDER BY dist LIMIT 10\G
*************************** 1. row ***************************
id: 1
select_type: SIMPLE
table: tv
partitions: NULL
type: index
possible_keys: NULL
key: vector
key_len: 16
ref: NULL
rows: 156
filtered: 100.00
Extra: Using ANN Search
1 row in set, 1 warning (0.01 sec)
ANN 检索流程示例
- 创建基表 ,包含一个 4 维的向量列。
CREATE TABLE tv (
id INT PRIMARY KEY AUTO_INCREMENT NOT NULL,
name VARCHAR(255),
num INT,
vector VECTOR(4) NOT NULL,
VECTOR INDEX (vector)
SECONDARY_ENGINE_ATTRIBUTE = '{"algorithm": "hnsw", "m": 4, "distance": "l2"}'
) ENGINE = InnoDB;
- 插入一些数据。
INSERT INTO tv (name, num, vector) VALUES
('ABC12345', 100, TO_VECTOR('[1,2,3,4]')), -- Perfect match (dist=0)
('XYZ98765', 200, TO_VECTOR('[2,3,4,5]')), -- Near match (dist=2.0)
('DEF45678', 300, TO_VECTOR('[5,6,7,8]')), -- Medium distance (dist=8.0)
('GHI78901', 400, TO_VECTOR('[10,11,12,13]')),-- Far distance (dist=18.0)
('JKL23456', 500, TO_VECTOR('[0,0,0,0]')), -- dist=5.477
('MNO34567', 600, TO_VECTOR('[1,1,1,1]')), -- dist=3.162
('PQR45678', 700, TO_VECTOR('[2,2,2,2]')), -- dist=2.449
('STU56789', 800, TO_VECTOR('[3,3,3,3]')), -- dist=2.449
('VWX67890', 900, TO_VECTOR('[4,4,4,4]')), -- dist=3.162
('YZA78901', 1000, TO_VECTOR('[5,5,5,5]')), -- dist=4.472
('BCD89012', 1100, TO_VECTOR('[1,3,3,5]')), -- dist=1.414
('CDE90123', 1200, TO_VECTOR('[1,2,4,4]')), -- dist=1.0
('EFG01234', 1300, TO_VECTOR('[1,2,3,5]')), -- dist=1.0
('FGH12345', 1400, TO_VECTOR('[0,2,3,4]')), -- dist=1.0
('GHI23456', 1500, TO_VECTOR('[1,2,3,3]')); -- dist=1.0
- ANN 检索距离查询向量 [1,2,3,4 ] 最近的 10 个向量(按照 dist 从小到大排序)。
mysql> SELECT id, name, num, from_vector(vector), L2_DISTANCE(vector, TO_VECTOR('[1,2,3,4]')) as dist FROM tv FORCE INDEX(vector) ORDER BY dist LIMIT 10;
+------+----------+------+---------------------------------------------------+--------------------+
| id | name | num | from_vector(vector) | dist |
+------+----------+------+---------------------------------------------------+--------------------+
| 1001 | ABC12345 | 100 | [1.00000e+00,2.00000e+00,3.00000e+00,4.00000e+00] | 0 |
| 1015 | GHI23456 | 1500 | [1.00000e+00,2.00000e+00,3.00000e+00,3.00000e+00] | 1 |
| 1013 | EFG01234 | 1300 | [1.00000e+00,2.00000e+00,3.00000e+00,5.00000e+00] | 1 |
| 1012 | CDE90123 | 1200 | [1.00000e+00,2.00000e+00,4.00000e+00,4.00000e+00] | 1 |
| 1014 | FGH12345 | 1400 | [0.00000e+00,2.00000e+00,3.00000e+00,4.00000e+00] | 1 |
| 1011 | BCD89012 | 1100 | [1.00000e+00,3.00000e+00,3.00000e+00,5.00000e+00] | 1.4142135623730951 |
| 1002 | XYZ98765 | 200 | [2.00000e+00,3.00000e+00,4.00000e+00,5.00000e+00] | 2 |
| 1008 | STU56789 | 800 | [3.00000e+00,3.00000e+00,3.00000e+00,3.00000e+00] | 2.449489742783178 |
| 1007 | PQR45678 | 700 | [2.00000e+00,2.00000e+00,2.00000e+00,2.00000e+00] | 2.449489742783178 |
| 453 | N569EYxw | 509 | [2.65090e+00,2.07250e+00,2.40990e+00,5.83180e+00] | 2.536618978960259 |
+------+----------+------+---------------------------------------------------+--------------------+
10 rows in set (0.00 sec)
RAG 框架集成
为了方便在 Python 应用中使用云数据库 MySQL 版的向量检索能力,我们提供了 LangChain 与 LlamaIndex 开源 RAG 框架的集成,它将底层的 SQL 操作封装为简单易用的 vector_store 接口。您可以将云数据库 MySQL 版无缝集成为 LangChain 的一个向量存储后端。它负责处理数据库连接、表和索引的创建、数据的增删改查以及相似度搜索,让您无需编写原生 SQL 即可完成常见的 RAG(检索增强生成)流程。
安装
- Python ≥ 3.8。
pip install langchain-volcengine-mysql
- 代码中导入云数据库 MySQL 版向量存储模块。
from langchain_volcengine_mysql import mysql
快速步骤
- 开启内核参数:确保云数据库 MySQL 版实例参数 loose_vector_index_enabled 已设置为 ON。
- 通过 mysql.configure() 配置 MySQL 实例信息,包括使用的 DB 名,表名和向量化函数。
- 数据注入与查询: 调用 add_texts 或 from_texts 等方法,将文本和外部计算的向量注入数据库。调用 similarity_search 或 similarity_search_by_vector 执行 ANN 查询。
代码示例
- 通过 similarity_search 进行向量检索 。
- 通过 get_relevant_documents 进行相关文档搜索。
from langchain_core.embeddings import FakeEmbeddings
from langchain_volcengine_mysql import mysql
# 1. Configure the connection and embedding function
embeddings = FakeEmbeddings(size=1024)
mysql.configure(
host="your-mysql-host.example.com",
port=3306,
user="your_user",
password="your_password",
database="your_db",
table_name="langchain_vectors",
embedding_function=embeddings,
)
# 2. Access the vector store and retriever
vector_store = mysql.vector_store
retriever = mysql.retriever
# 3. Add texts and perform searches
vector_store.add_texts(
["Example sentence one.", "Example sentence two."],
metadatas=[{"source": "demo1"}, {"source": "demo2"}],
)
# Similarity search via vector store
print(vector_store.similarity_search("Example", k=2))
# Retriever usage: fetch relevant documents
docs = retriever.get_relevant_documents("Example")
print([d.page_content for d in docs])
LangChain RAG 实战
安装
- Python ≥ 3.8。
pip install llama-index-vector-stores-volcengine-mysql
- 代码中导入云数据库 MySQL 版向量存储模块。
from llama_index.vector_stores.volcengine_mysql import VolcengineMySQLVectorStore
快速步骤
- 开启内核参数:确保云数据库 MySQL 版实例参数 loose_vector_index_enabled 已设置为 ON。
- 通过 VolcengineMySQLVectorStore.from_params 配置向量查询的后端数据库,包括数据库连接信息,表名、索引类型以及距离度量。
- 通过 from_documents 将文档向量化后插入索引。
- 使用 VectorStoreQuery 构建查询,并通过 vector_store.query 发起查询。
代码示例
from llama_index.core import Document, StorageContext, VectorStoreIndex, Settings
from llama_index.core.embeddings import BaseEmbedding
from llama_index.core.vector_stores.types import VectorStoreQuery
from llama_index.vector_stores.volcengine_mysql import VolcengineMySQLVectorStore
# Create Vector store backend
vector_store = VolcengineMySQLVectorStore.from_params(
host="your-mysql-host.example.com",
port=3306,
user="your_user",
password="your_password",
database="your_db",
table_name="llamaindex_demo",
embed_dim=EMBED_DIM, # 向量维度,需要提前定义变量,例如 EMBED_DIM = 1024
# Override default SSL‑related connect args to match the direct
# PyMySQL usage that already works for you.
connection_args={"read_timeout": 30},
ann_index_algorithm="hnsw",
ann_index_distance="l2",
ann_m=16,
ef_search=20,
perform_setup=True,
debug=False,
)
storage_context = StorageContext.from_defaults(vector_store=vector_store)
index = VectorStoreIndex.from_documents(
docs, # Documents to search
storage_context=storage_context,
embed_model=embed_model,
)
# Demonstrate direct vector‑store query
question = "What is veDB for MySQL?"
query_embedding = embed_model.get_text_embedding(question)
vs_query = VectorStoreQuery(
query_embedding=query_embedding,
similarity_top_k=3,
)
# Query to get result
result = vector_store.query(vs_query
注意事项
- 外部 Embeddings :数据库不负责文本向量化,需在应用层提前用外部 Embeddings 计算向量。
- 存储引擎与索引限制:仅支持 InnoDB;不支持分区表与虚拟列。
- 索引使用:可建议使用 FORCE INDEX 保证 ANN;可设置 force_index=False 让优化器自行选择;可用 EXPLAIN 验证查询计划中是否出现 Using ANN Search。
- 距离度量:索引构建与查询尽量保持一致(如 l2);若不一致,以索引构建时的度量为准。
- 删除与回收站:含向量索引的基表不进回收站;DROP TABLE 会直接删除基表。
- 复制与开关:向量数据会复制到所有只读节点;仅开启 loose_vector_index_enabled 的节点会自动创建向量索引。
- 持久性与事务:与基表一致,具备 ACID;回滚主事务时索引数据同步回滚。
- 内存限制:单个 HNSW 内存使用受到 loose_hnsw_max_cache_size 参数限制,请合理设定此值避免内存不足。
性能数据
MySQL 从索引构建速度、索引的大小、索引查询性能三个方面,横向对比了与MariaDB 13.1 (同属 MySQL 生态)和 pgvector 0.8.2 (PostgreSQL 生态中最受欢迎的向量索引扩展)的差异,具体结果如下。
测试规格
- 性能基准:VectorDBBench。
- 数据集:Performance1536D50K(1536 维度 5 万行数据)与 Performance768D1M(768 维度 100 万行数据)。
- 测试用 CPU 规格: Intel(R) Xeon(R) Platinum 8457C CPU @ 2.60GHz,16 核。
- HNSW 索引缓存参数配置:loose_hnsw_max_cache_size = 2GB。
测试结果
索引的构建速度:提升 4~6 倍
MariaDB 的向量索引都是采用串行索引构建的,这就导致了构建大量向量索引的耗时极长。而火山引擎依靠自研的高性能并行构建引擎,打破了向量索引构建的瓶颈,即使是百万级向量数据,也可以快速构建向量索引。
本次测试使用参数 m=16、ef_construction=128 的 HNSW 索引配置,选取两组不同向量维度的数据集,统计了从向量数据载入至索引构建的整体耗时。
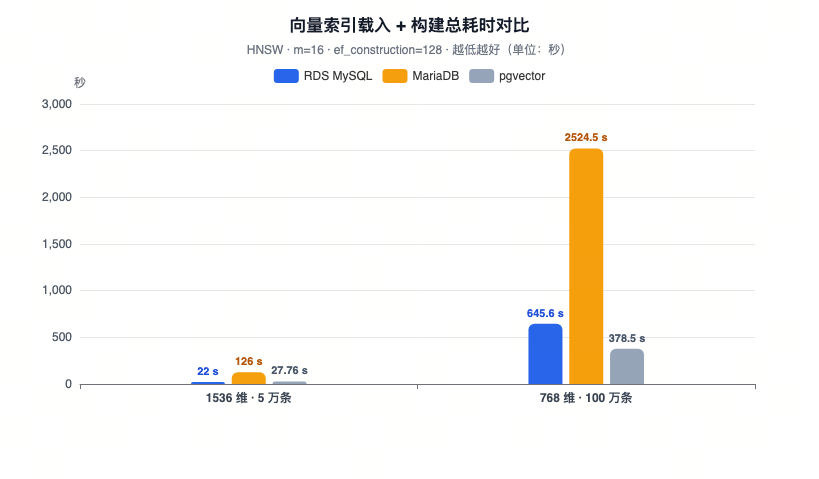
根据柱状图的对比数据,可以得出以下结论:
- 1536 维、5 万条向量数据: MariaDB 构建索引耗时 126 秒,pgvector 构建索引耗时 27.76 秒,火山引擎 RDS MySQL 构建索引耗时 22 秒。火山引擎 RDS MySQL 构建索引的速度相比 MariaDB 提升约 6 倍。
- 768 维、100 万条向量数据: MariaDB 构建索引耗时 2524.5 秒,pgvector 构建索引耗时 378.5 秒,火山引擎 RDS MySQL 构建索引耗时 645.6 秒。火山引擎 RDS MySQL 构建索引的速度相比 MariaDB 提升约 4 倍。
向量数据集越大,并行构建向量索引的效率提升越明显,在百万级向量索引构建场景下,索引的构建时间从 42 分钟缩短到至 11 分钟以内。
索引的大小:减少2~4倍
原生 pgvector 仅支持 Float32 向量存储,构建的索引占用的磁盘空间较大。而火山引擎 RDS MySQL 提供 SQ16、SQ8 两种标量量化,用更紧凑的方式存储向量索引。
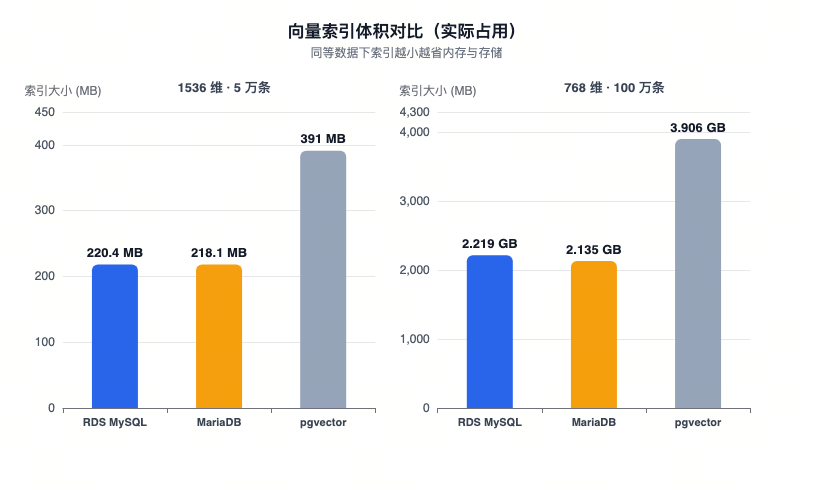
结合上述柱状图对比数据,可以得出以下结论:
- 1536 维、5 万条向量数据: MariaDB 构建的索引大小为 218.1 MB,pgvector 构建的索引大小为 391 MB,火山引擎 RDS MySQL 构建的索引大小为 220.4 MB。
- 768 维、100 万条向量数据: MariaDB 构建的索引大小为 2.135 GB,pgvector 构建的索引大小为 3.906 GB,火山引擎 RDS MySQL 构建的索引大小为 2.219 GB。
相比 pgvector,开启 SQ16 量化后索引大小可缩减至 1/2,SQ8 量化后进一步缩减至 1/4,可以有效减少向量索引占用的磁盘空间,降低存储成本。
索引的查询性能:高召回下查询吞吐领先 2~3 倍
本次性能测试使用行业公认基准工具 VectorDBBench 执行,基于高召回率的实用业务区间,统计各数据库向量检索吞吐(QPS)指标。
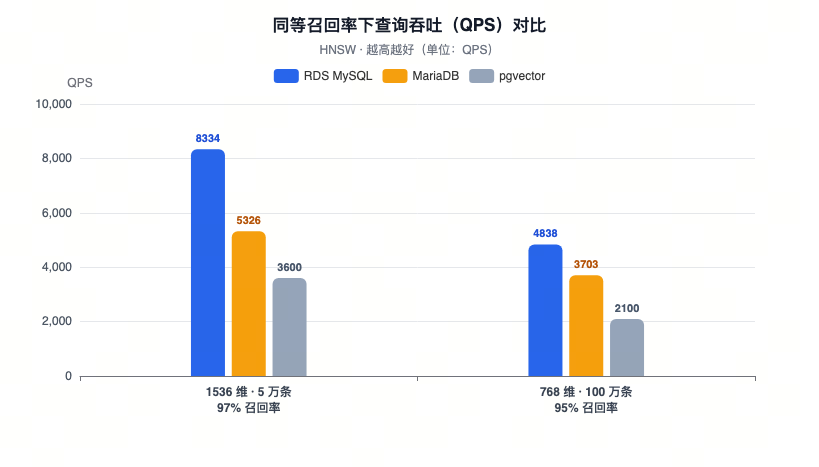
结合上述柱状图对比数据,可以得出以下结论:
- 1536 维 5 万条向量数据、97% 召回率: MariaDB 向量检索吞吐(QPS)为 5326,pgvector 向量检索吞吐(QPS)为 3600,火山引擎 RDS MySQL 向量检索吞吐(QPS)为 8334。相比之下,火山引擎 RDS MySQL 的向量吞吐(QPS) 约为 MariaDB 的 1.6 倍、pgvector 的 2.3 倍。
- 768 维 100 万条向量数据、95% 召回率: MariaDB 向量检索吞吐(QPS)为 3703,pgvector 向量检索吞吐(QPS)为 2100,火山引擎 RDS MySQL 向量检索吞吐(QPS)为 4838。相比之下,火山引擎 RDS MySQL 的向量吞吐(QPS) 约为 MariaDB 的 1.3 倍、 pgvector 的 2.3 倍。
最近更新时间:2026.08.31 16:40:02
这个页面对您有帮助吗?
有用
有用
无用
无用