豆包语音
豆包语音


文档指南

请输入


- 文档首页
 豆包语音接入必读端到端实时语音
 复制全文
 下载 pdf
端到端实时语音
 文档反馈
 问问助手
简介
豆包实时语音模型 3.0(Seeduplex)是一款全双工端到端语音大模型,支持低延迟、多模态、语音到语音(S2S)的实时对话能力。本协议采用标准化的 Realtime 事件语义与字段结构,通过 WebSocket 以纯 JSON 文本帧进行数据收发,旨在帮助客户端以最小改动、统一范式接入豆包模型
协议设计原则
核心设计理念:事件语义标准化,专有能力通过 extension 透传
- 标准化事件命名:上行事件包括 session.create、input_audio_buffer.append 、 conversation.item.create 、 response.cancel 等,下行事件包括 session.created 、 response.output_audio.delta 、 response.done 等
- 结构化字段组织:session 对象内含 audio.input 、 audio.output 、instructions 、 tools等字段,层次清晰、便于扩展
- 专有能力通过 extension 透传:唱歌、联网搜索、克隆音色、热词、上下文初始化等模型专有能力,统一收敛至 extension(包含 asr 、 tts 、 dialog),其内部结构与原 端到端模型的StartSessionPayload 完全一致,存量配置可直接复用
- 纯 JSON 文本帧:所有事件均以 JSON 文本通过 WebSocket Text Message 收发,事件类型由type字段标识;音频数据以Base64编码内嵌于对应事件的 audio / delta 字段中
消息帧格式
协议采用纯 JSON 文本帧传输:每个事件均为一条 JSON 字符串,通过 WebSocket Text Message 收发,无需二进制封装。事件类型由顶层type字段标识
- 一帧一事件:每条 WebSocket Text Message 承载且仅承载一个完整事件 JSON
- type 路由:客户端与服务端均按顶层 type 字段(如 session.create、response.output_audio.delta)进行分发处理
- event_id(可选):上行事件可在event_id字段携带客户端生成的幂等标识;服务端会在相关下行事件中回带,便于链路追踪与排障
- session 标识:会话建立后,服务端通过session.created下行返回session.id(即 dialog.id);接续历史会话时,在session.update的 session.id 字段中回传
- 音频承载方式:音频不走独立的二进制通道,而是以 Base64 编码字符串的形式内嵌于 JSON 事件字段中
音频约束
输入音频
- 格式约束:
- PCM/Opus(由服务端自动转为PCM)、单声道、16000Hz、int16、小端序
- 推荐按 20 ms 分包(16k /int16 格式下每包 640 字节)
- 音频字节经 Base64 编码后放入 audio 字段
- 质量约束:
- 人声强度 RMS(纯人声部分)
- 推荐范围:-31.7 ~ -23.9 dBFS,中心目标约 -27.6 dBFS
- 最低准入:不低于 -37 dBFS,低于此值将影响模型效果;不高于 -19.5 dBFS,峰值应控制在 ≤ -1 dBFS
- 背景噪声 RMS(纯背景噪声部分)
- 推荐范围:不高于 -50 dBFS,且SNR(信噪比)为20~30 dB,中心目标约 -52.6 dBFS
- 最低准入:不高于 -45 dBFS,且 SNR 不低于 15 dB
注意
- 音频分片建议以20 ms 为单位(16k /int16 格式下每包 640 字节),并严格按照实时音频流的节奏发送,发送速率偏离实际节奏(过快或过慢)都将触发服务端错误
- 模型依赖上行音频流保活。客户端关闭麦克风后若不再发送音频帧,须主动发送静音事件input_audio_mute.commit,恢复麦克风时发送取消静音事件input_audio_unmute.commit,否则服务端会因持续收不到音频输入触发超时,导致模型无响应
- 人声过轻或背景噪声过大均会影响模型效果,请尽量将输入音频调整至上述推荐范围内
输出音频
- 支持在session.audio.output配置输出音频格式,默认返回Ogg Opus格式的音频
- 音频数据以 Base64 编码在 delta 字段下行
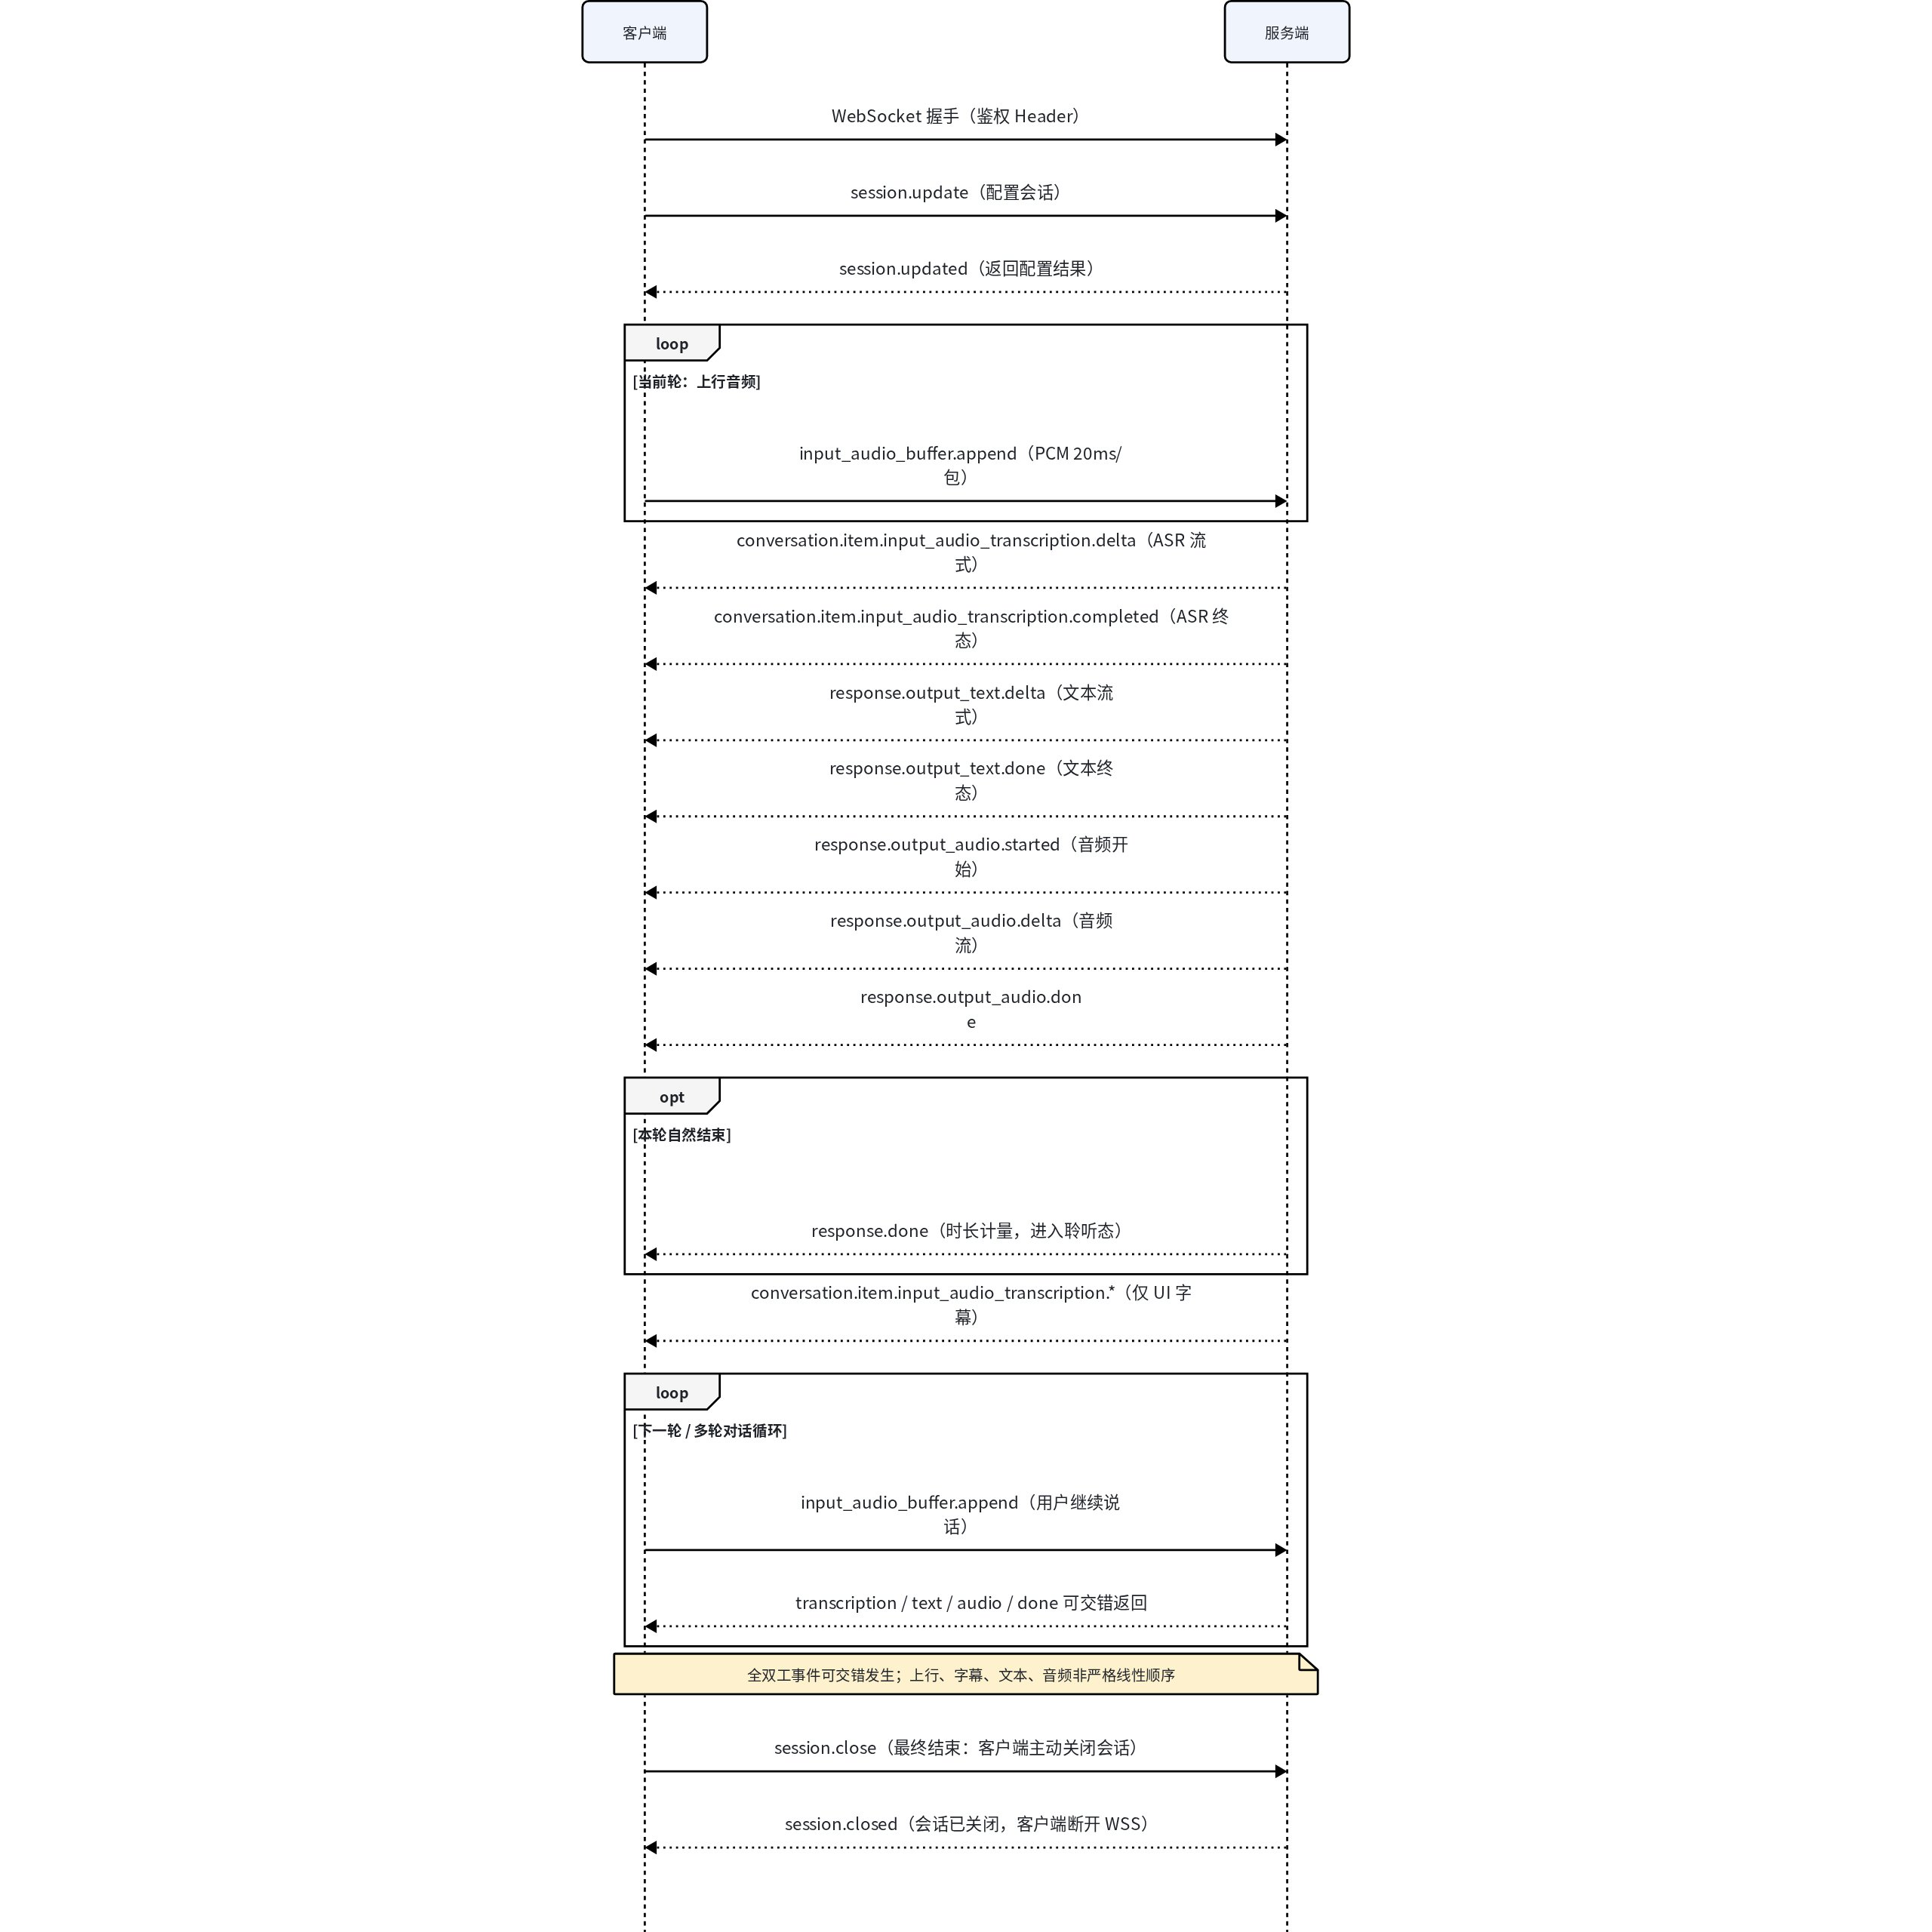
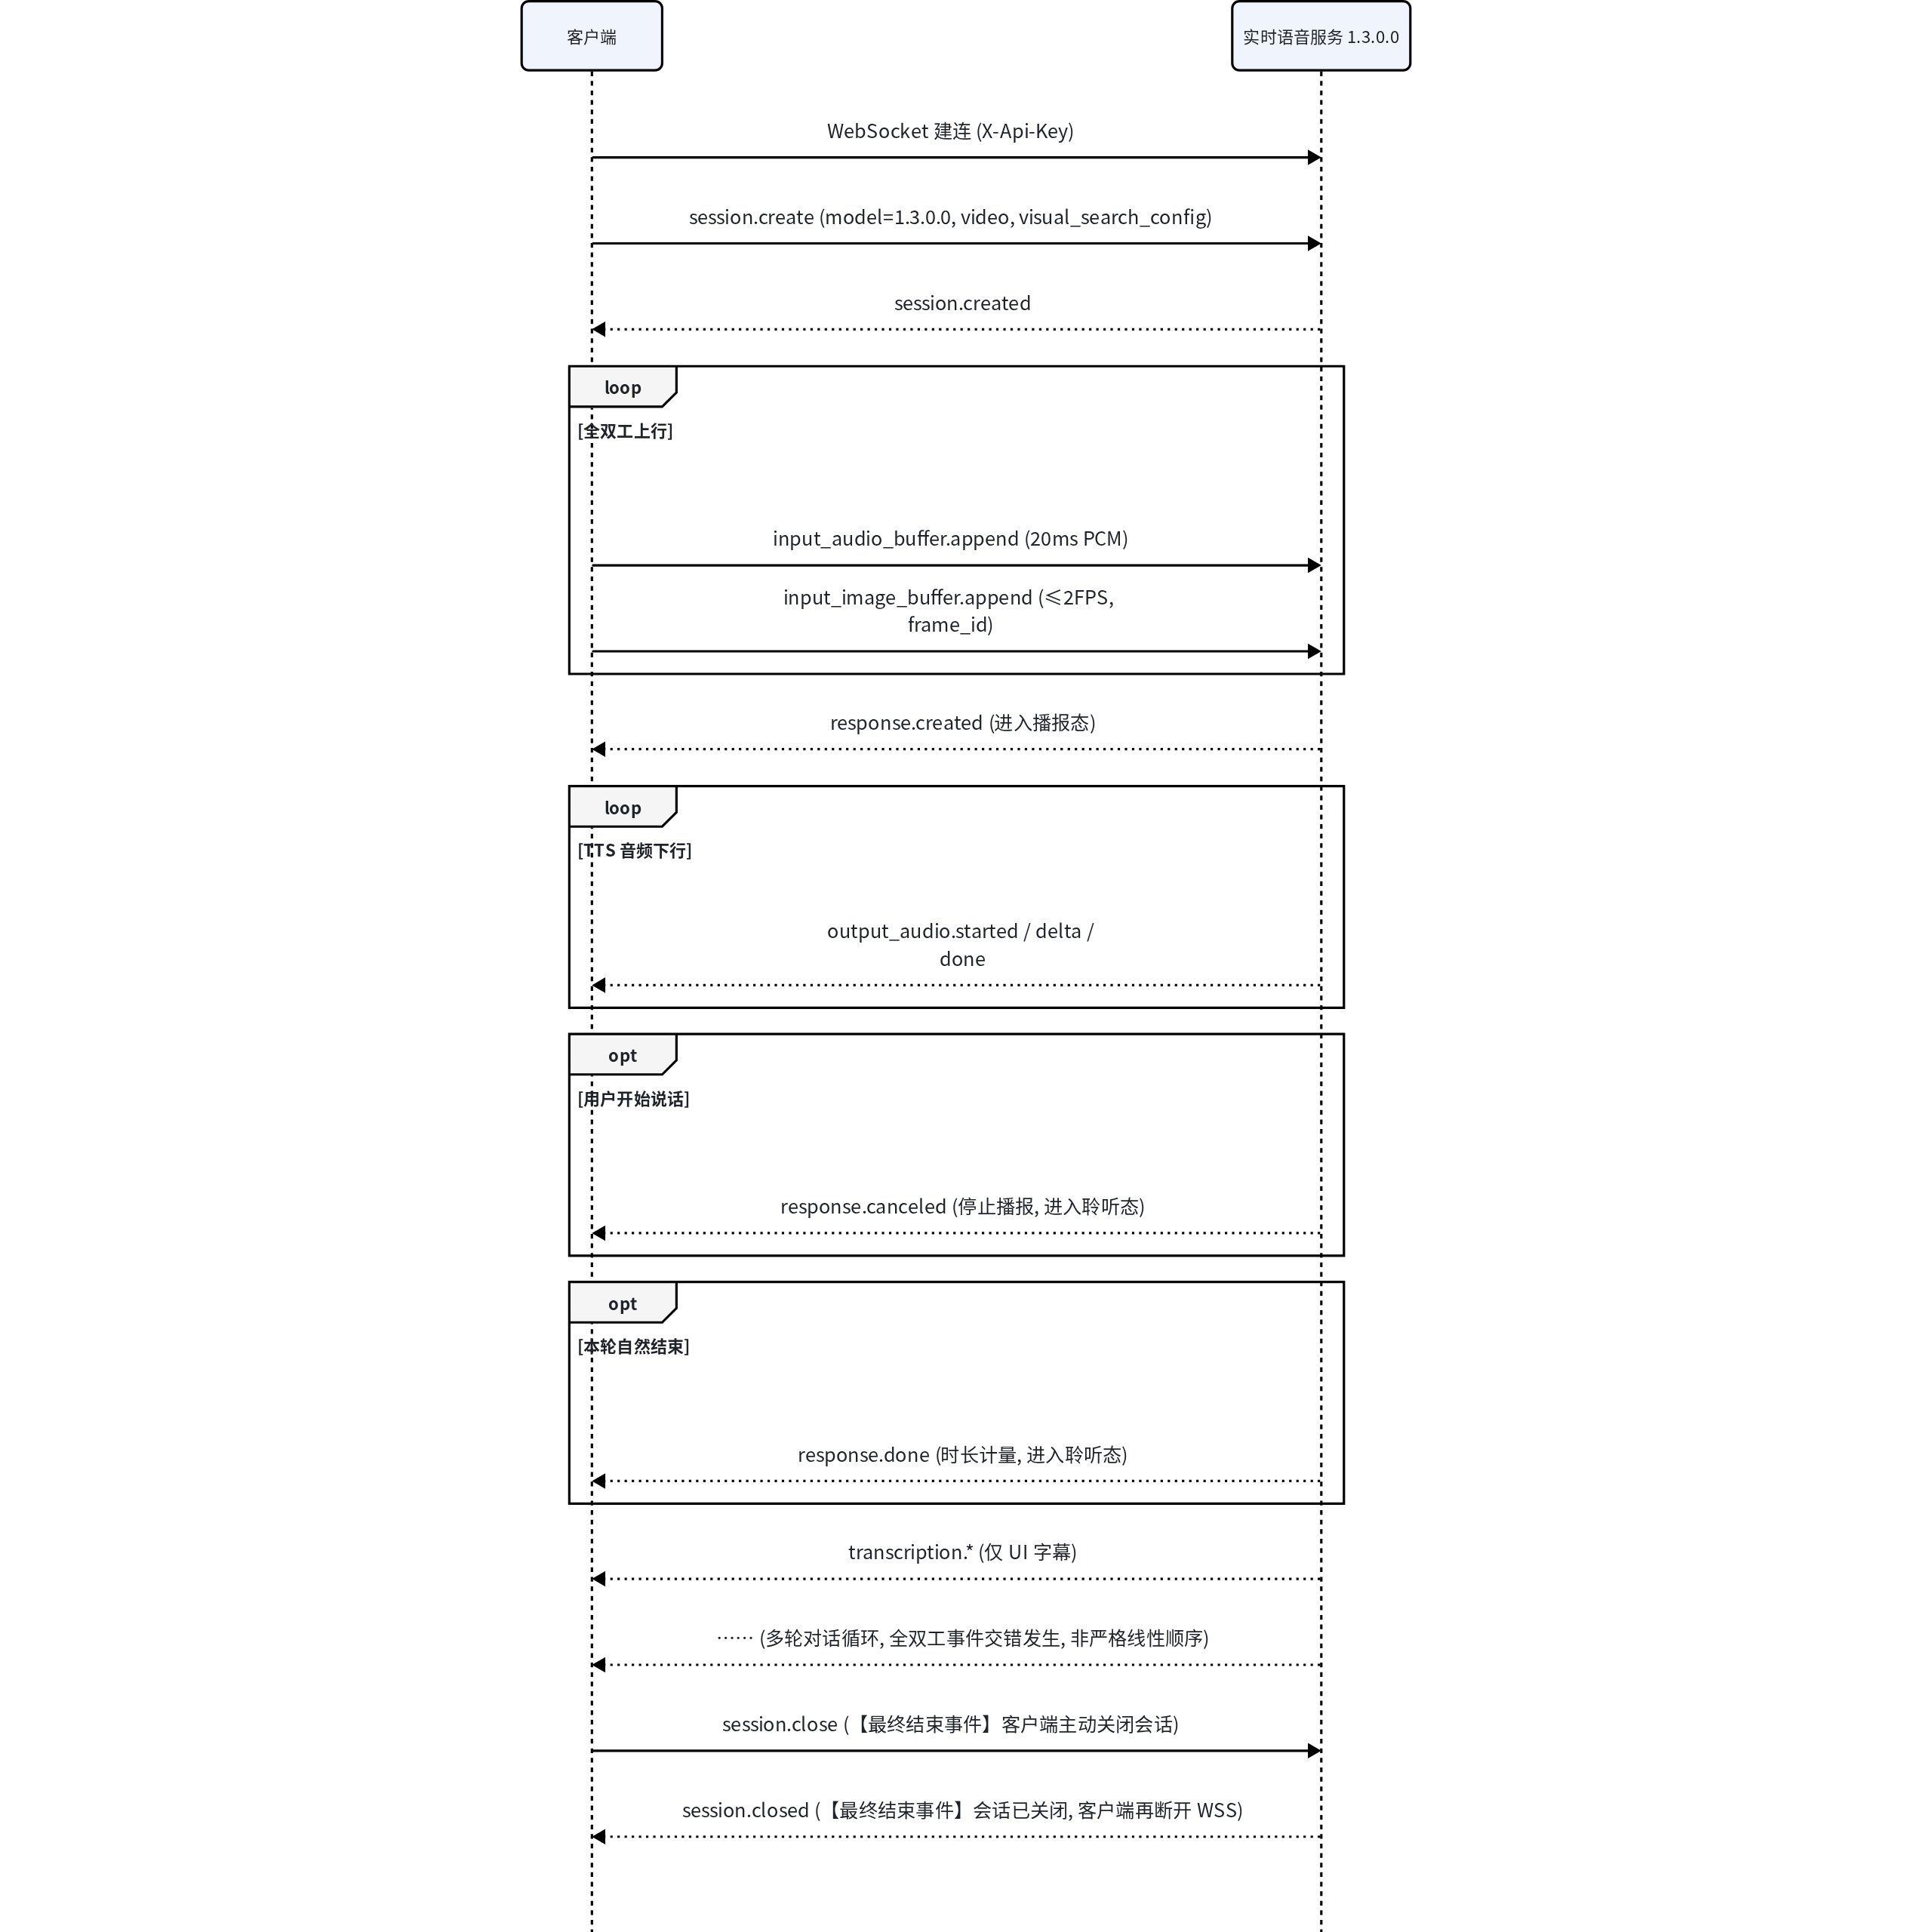
最简交互示例图
Seeduplex
Doubao-Seed-Realtime-1.0
最佳实践
接口迁移
若已完成端到端实时语音识别的接入,现需升级至全双工版本,建议按以下步骤迁移:
- 事件改名优先,配置后置:建议先将客户端收发的事件名从实时语音版本切换为全双工版本,再将 asr / tts / dialog 配置迁入 extension,可显著降低迁移风险
- extension 直接复用存量配置:原StartSessionPayload 中的 asr / tts / dialog 字段无需改造,按原格式整体移入 extension 即可
- 携带 event_id:推荐所有上行事件在 optional字段携带 event_id 与 session id,将状态管理复杂度交由服务端处理,便于链路追踪与排障
- model 固定单值: session.model固定填写 1.2.6.1(全双工版本),无需再在 extension.dialog.extra 配置 model 选路
上下文管理
- 初始化历史:通过 conversation.item.create 注入历史问答对
说明
- 上下文须按 user /assistant 成对提交,数组长度为偶数
- 时间戳需统一:要么全部携带(严格递增、不超过当前时间),要么全部不携带
- 接续历史对话:复用上次 session.created 返回的 session.id(即 dialog.id)即可接续,服务端默认保留最近 20 轮问答记录
Function Calling 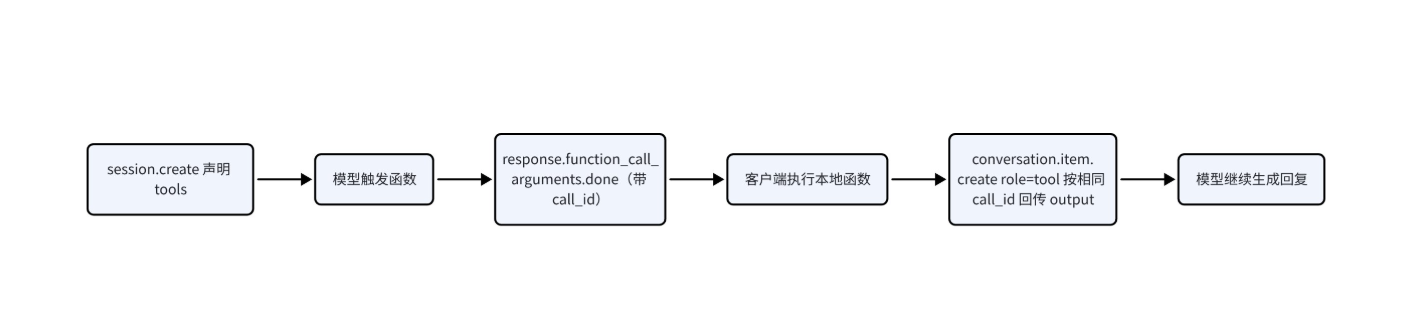
- 工具声明:在 session.update 的 tools 字段中以标准 JSON Schema 结构声明(type = function + parameters);会话过程中可再次发送 session.update 动态增删工具
注意
session.update动态增删工具,为全量覆盖,非增量更新
- 按 call_id 配对回传:下行事件 response.function_call_arguments.done 的每个调用项均携带唯一 call_id。客户端执行完本地函数后,须通过 conversation.item.create 回传结果(role=tool,结果放入content 数组),并在回传项中携带相同的call_id;服务端据此将函数输出与对应调用配对
注意
call_id不一致会导致结果无法匹配、回复异常
- 并行调用:单次 response.function_call_arguments.done 的 items 可能包含多个函数调用,需按每个call_id 分别执行,并将结果聚合后一次性回传;全部回传完成后,模型才会继续生成最终回复
- output 序列化为字符串:函数执行结果建议序列化为 JSON 字符串后放入output字段,结构清晰,便于模型解析
稳定性与限流
- 优雅关闭:务必先发送session.close(即FinishSession)并收到服务端回复后,再关闭 WebSocket 链接;直接断开会触发 ContextCanceled错误(错误码为55000001)
- 5xx 重连:遇到服务端 5xx 错误时,应统一触发重连逻辑
- 限流说明:限流纬度包括 QPM(每分钟 StartSession 调用次数,默认 60)与 TPM(每分钟 token 消耗量,默认 10 万),按 AppID/项目维度计算。
注意
若预估用量将超过配额,请提前联系对应商务沟通扩容
视频帧采集最佳实践(推荐 720p)--仅针对Doubao-Seed-Realtime-1.0
推荐基线:采集 720p(短边 720:竖屏 720×1280,横屏 1280×720)、JPEG 编码、质量 75、帧率不超过 2 FPS。该档位在视觉理解精度、带宽与服务端处理时延之间性价比最高。
附:错误码说明
客户端应对所有下行 error 事件做统一捕获与日志记录:
- 遇服务端 5xx 错误统一触发重连
- 遇鉴权/参数类错误(4xx)应停止重试并核对配置
推荐在每条上行事件中携带 event_id,以便结合服务端返回的 X-Tt-Logid 进行精准的问题定位与链路追踪
附:事件对照表
下表为端到端实时语音 - 全双工版本与原版本的上行、下行事件对照说明
上行事件
下行事件
最近更新时间:2026.10.26 10:29:18
这个页面对您有帮助吗?
有用
有用
无用
无用