AI 数据湖服务
AI 数据湖服务


开发参考

请输入


- 文档首页
 AI 数据湖服务组件操作指南Apache GravitinoApache® Gravitino 概述
 复制全文
 下载 pdf
Apache® Gravitino 概述
 文档反馈
 问问助手
在当今企业的数据环境中,其复杂性日益增加,数据分散于不同的数据库、数据湖、消息队列乃至 AI 平台,进而形成了“元数据孤岛”。传统解决方案通常需开展大规模的数据迁移工作,不仅成本高昂,而且风险巨大。
Apache® Gravitino 的诞生旨在解决这一难题。其核心目标并非移动数据,而是统一元数据,致力于成为一个“目录的目录”(Catalog of Catalogs)。它旨在构建一个高性能、支持地理分布的联合元数据湖(Federated Metadata Lake),为企业所有的数据和 AI 资产提供统一的发现、管理和治理入口,成为多云、多区域数据架构的单一事实来源(Single Source of Truth)。本文将全面概述 Apache Gravitino 的核心概念、主要功能及架构设计。
"Apache Gravitino, the names of other Apache projects, and the ASF logo are either registered trademarks or trademarks of the Apache Software Foundation in the United States and/or other countries."
主要功能和特点
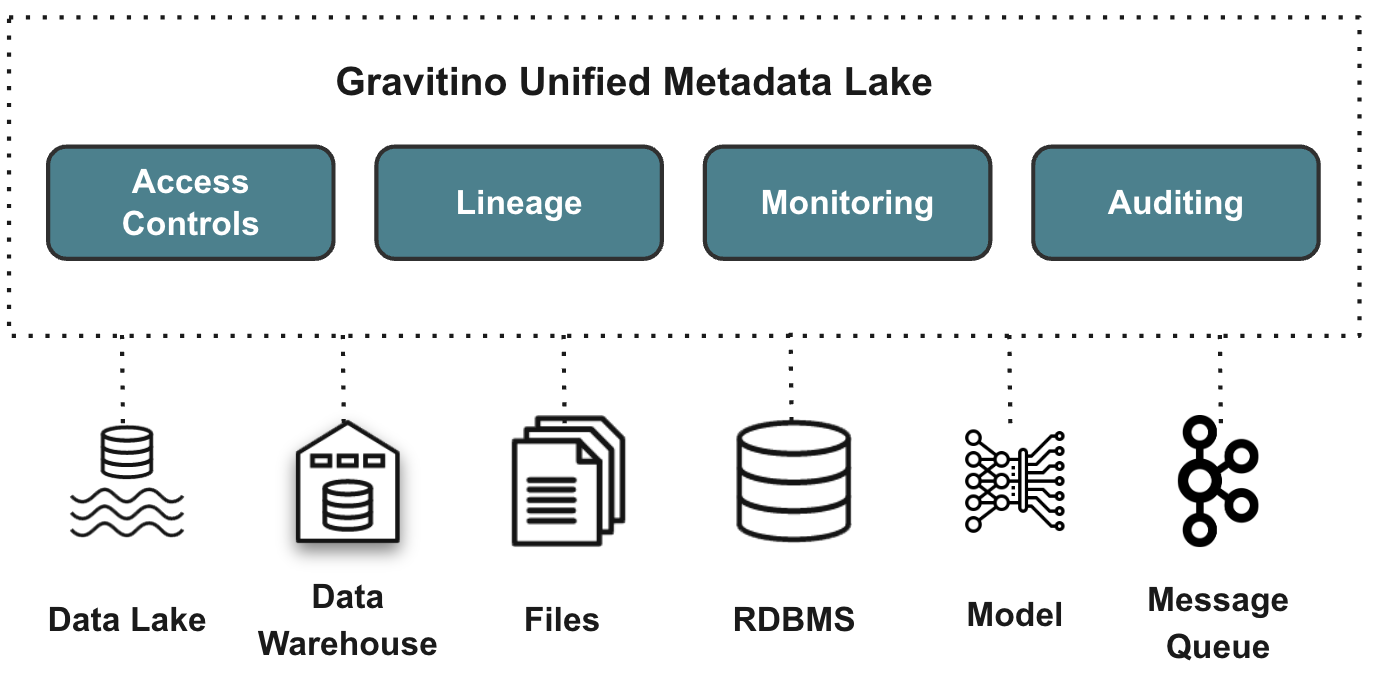
图一 Gravitino 统一管理多种数据源
Gravitino 的核心特性可概括为以下几点:
- 统一元数据管理:借助抽象的元数据模型,支持对异构数据源的统一管理,涵盖关系型数据库(如 MySQL、PostgreSQL)、数据湖(如 Hive、Iceberg)、文件系统(如 HDFS、S3)、消息队列(如 Kafka)以及 AI/ML 模型。
- 直接管理与实时同步:与传统元数据系统通过拉取或推送方式被动收集元数据不同,Gravitino 通过连接器直接管理底层数据源。在 Gravitino 中进行的任何元数据变更都会实时反映到下层系统中。
- 端到端数据治理:提供统一的治理层,集中实现访问控制(RBAC)、审计日志、数据标记和发现等功能,确保策略在所有连接的系统中得到一致执行。
- 多引擎支持:计算引擎(如 Trino、Spark、Flink)可通过 Gravitino 的连接器访问所有纳管的数据,无需修改现有的 SQL 方言或代码。
- 地理分布支持:架构设计支持跨区域、跨云部署,不同地区的 Gravitino 实例可以互联,从而提供全局统一的元数据视图。
- 元数据驱动的行动系统:这是 1.0 版本的核心亮点,标志着 Gravitino 从一个被动的元数据存储,演进为一个主动的、可执行自动化任务的“数据大脑”。
核心架构与设计
整体架构
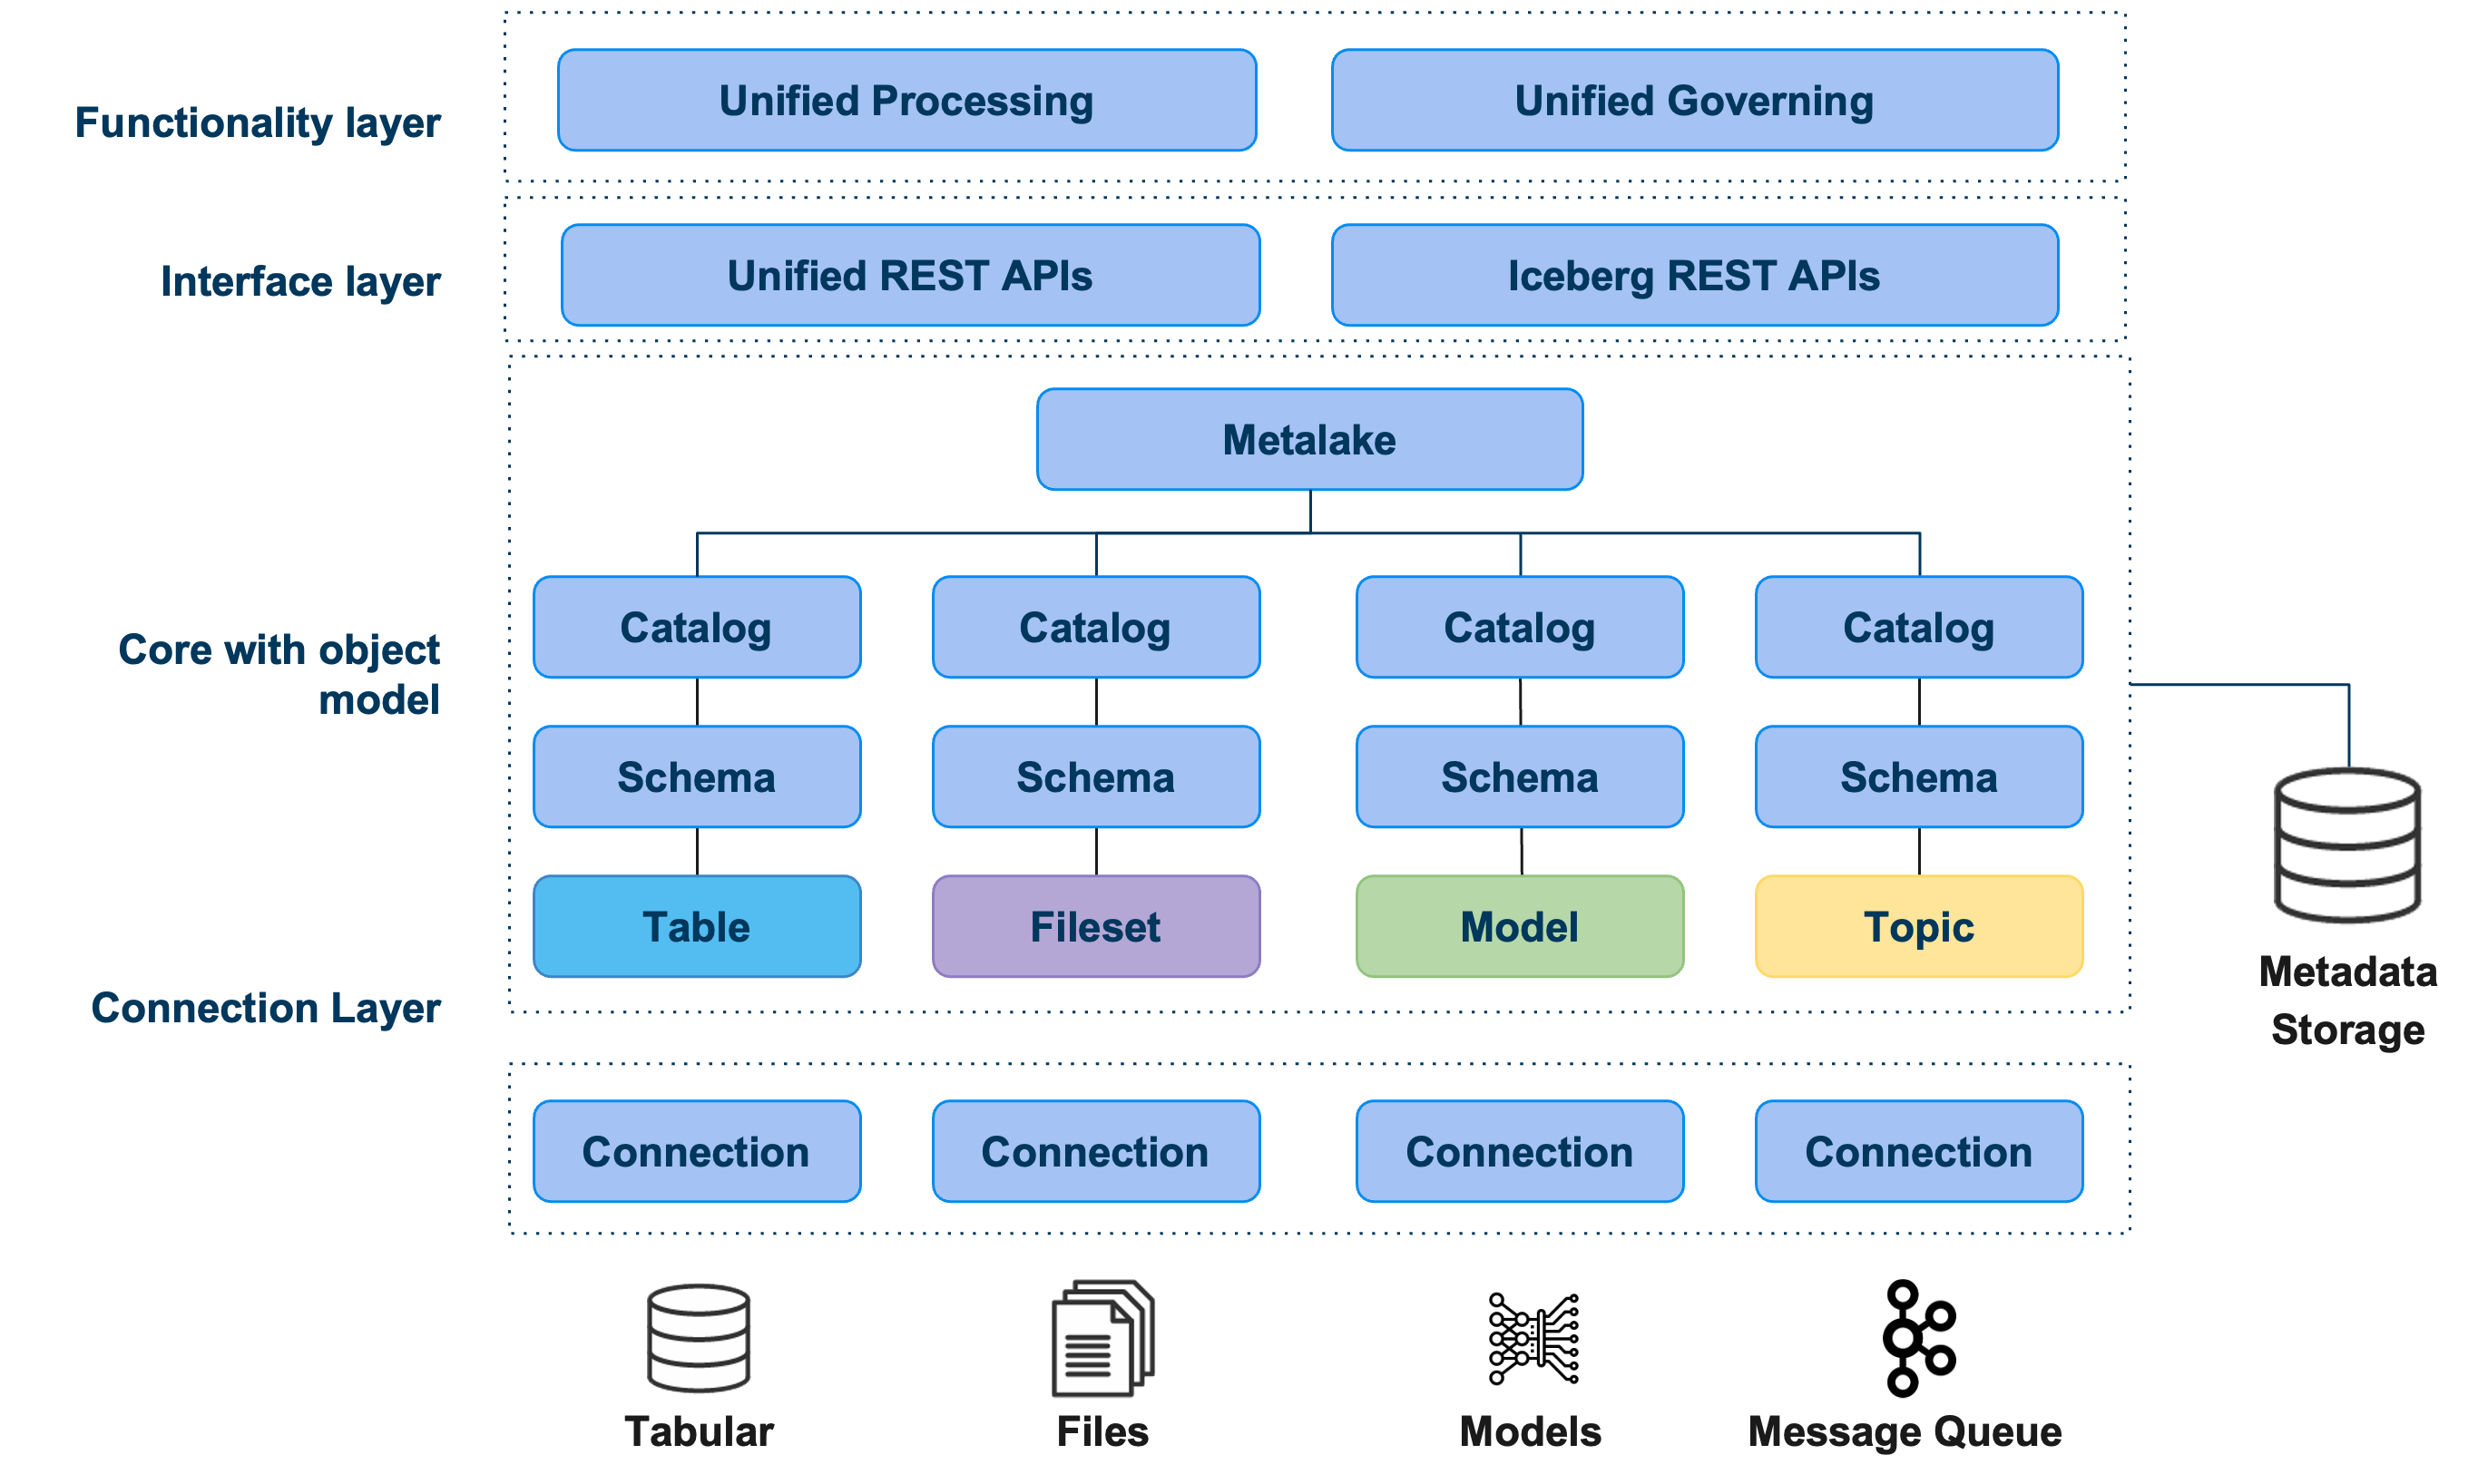
图二 Gravitino 整体架构分层设计
Gravitino 采用了清晰的分层架构设计,以确保其具备高度的可扩展性和灵活性:
- 接口层 (Interface Layer):主要为用户和应用提供标准的 REST API 接口。未来计划支持 Thrift 和 JDBC 等接口。
- 功能层 (Functionality Layer):提供元数据管理(CRUD)和元数据治理(访问控制、审计、发现等)的核心 API。
- 核心对象模型 (Core Object Model):定义了一套通用的元数据对象模型以屏蔽底层差异,主要包括以下层级:
- Metalake:元数据湖,是 Gravitino 管理的顶层容器,用于隔离不同的业务或环境。
- Catalog:数据目录,对应一个外部数据源,例如一个 Hive Metastore 或一个 PostgreSQL 数据库。
- Schema:数据库或模式,是表的集合,在 Catalog 内部提供命名空间。
- Table:表,定义了数据的结构化视图。
- Fileset:文件集,用于管理非结构化数据,如 HDFS 或 S3 上的文件集合。
- Model:模型,用于管理机器学习模型的元数据。
- Topic:主题,用于管理消息队列(如 Kafka)的元数据。
- 连接层 (Connection Layer):包含一系列可插拔的连接器(Connectors),负责与具体的外部数据源(如 Hive Metastore (HMS)、PostgreSQL)进行通信和元数据操作。
企业级 Iceberg REST Catalog 实现
Gravitino 不仅遵循了 Iceberg REST Catalog 的开放规范,还提供了一个专为企业生产环境打造的、功能增强的实现。
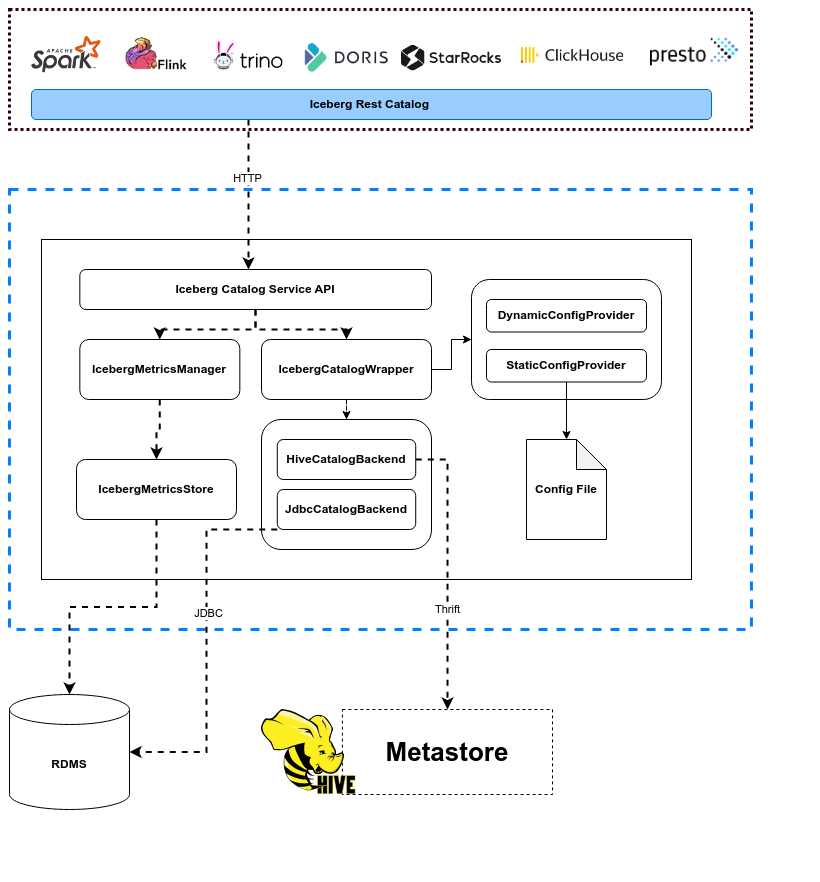
Gravitino Iceberg REST Catalog 架构
- 性能与可靠性:内置了智能缓存、连接池和故障转移机制,为大规模生产环境提供稳定性和高可用性保障。
- 企业级可观测性与治理:原生集成了 Prometheus 和 Grafana 进行全面监控,提供完整的审计日志和事件框架,允许企业注入自定义业务逻辑。
- 统一且强大的安全模型:复用平台统一的安全框架,支持 OAuth 2.0、Kerberos 等企业级认证,并通过凭证分发 (Credential Vending) 机制,安全地为客户端申请访问云存储的临时令牌,极大提升了云上数据访问的安全性。
- 广泛的后端兼容性:可将任何 Gravitino 支持的 Catalog(如 Hive Metastore、JDBC Catalog)作为其后端存储,并通过标准的 REST 接口统一暴露,实现了在不改造现有元数据基础设施的前提下,享受现代化 REST Catalog 的所有优势。
火山生态集成
Gravitino 作为开放的元数据管理核心,与火山引擎 LAS Catalog 深度集成,为企业提供一站式的数据与 AI 资产管理能力。
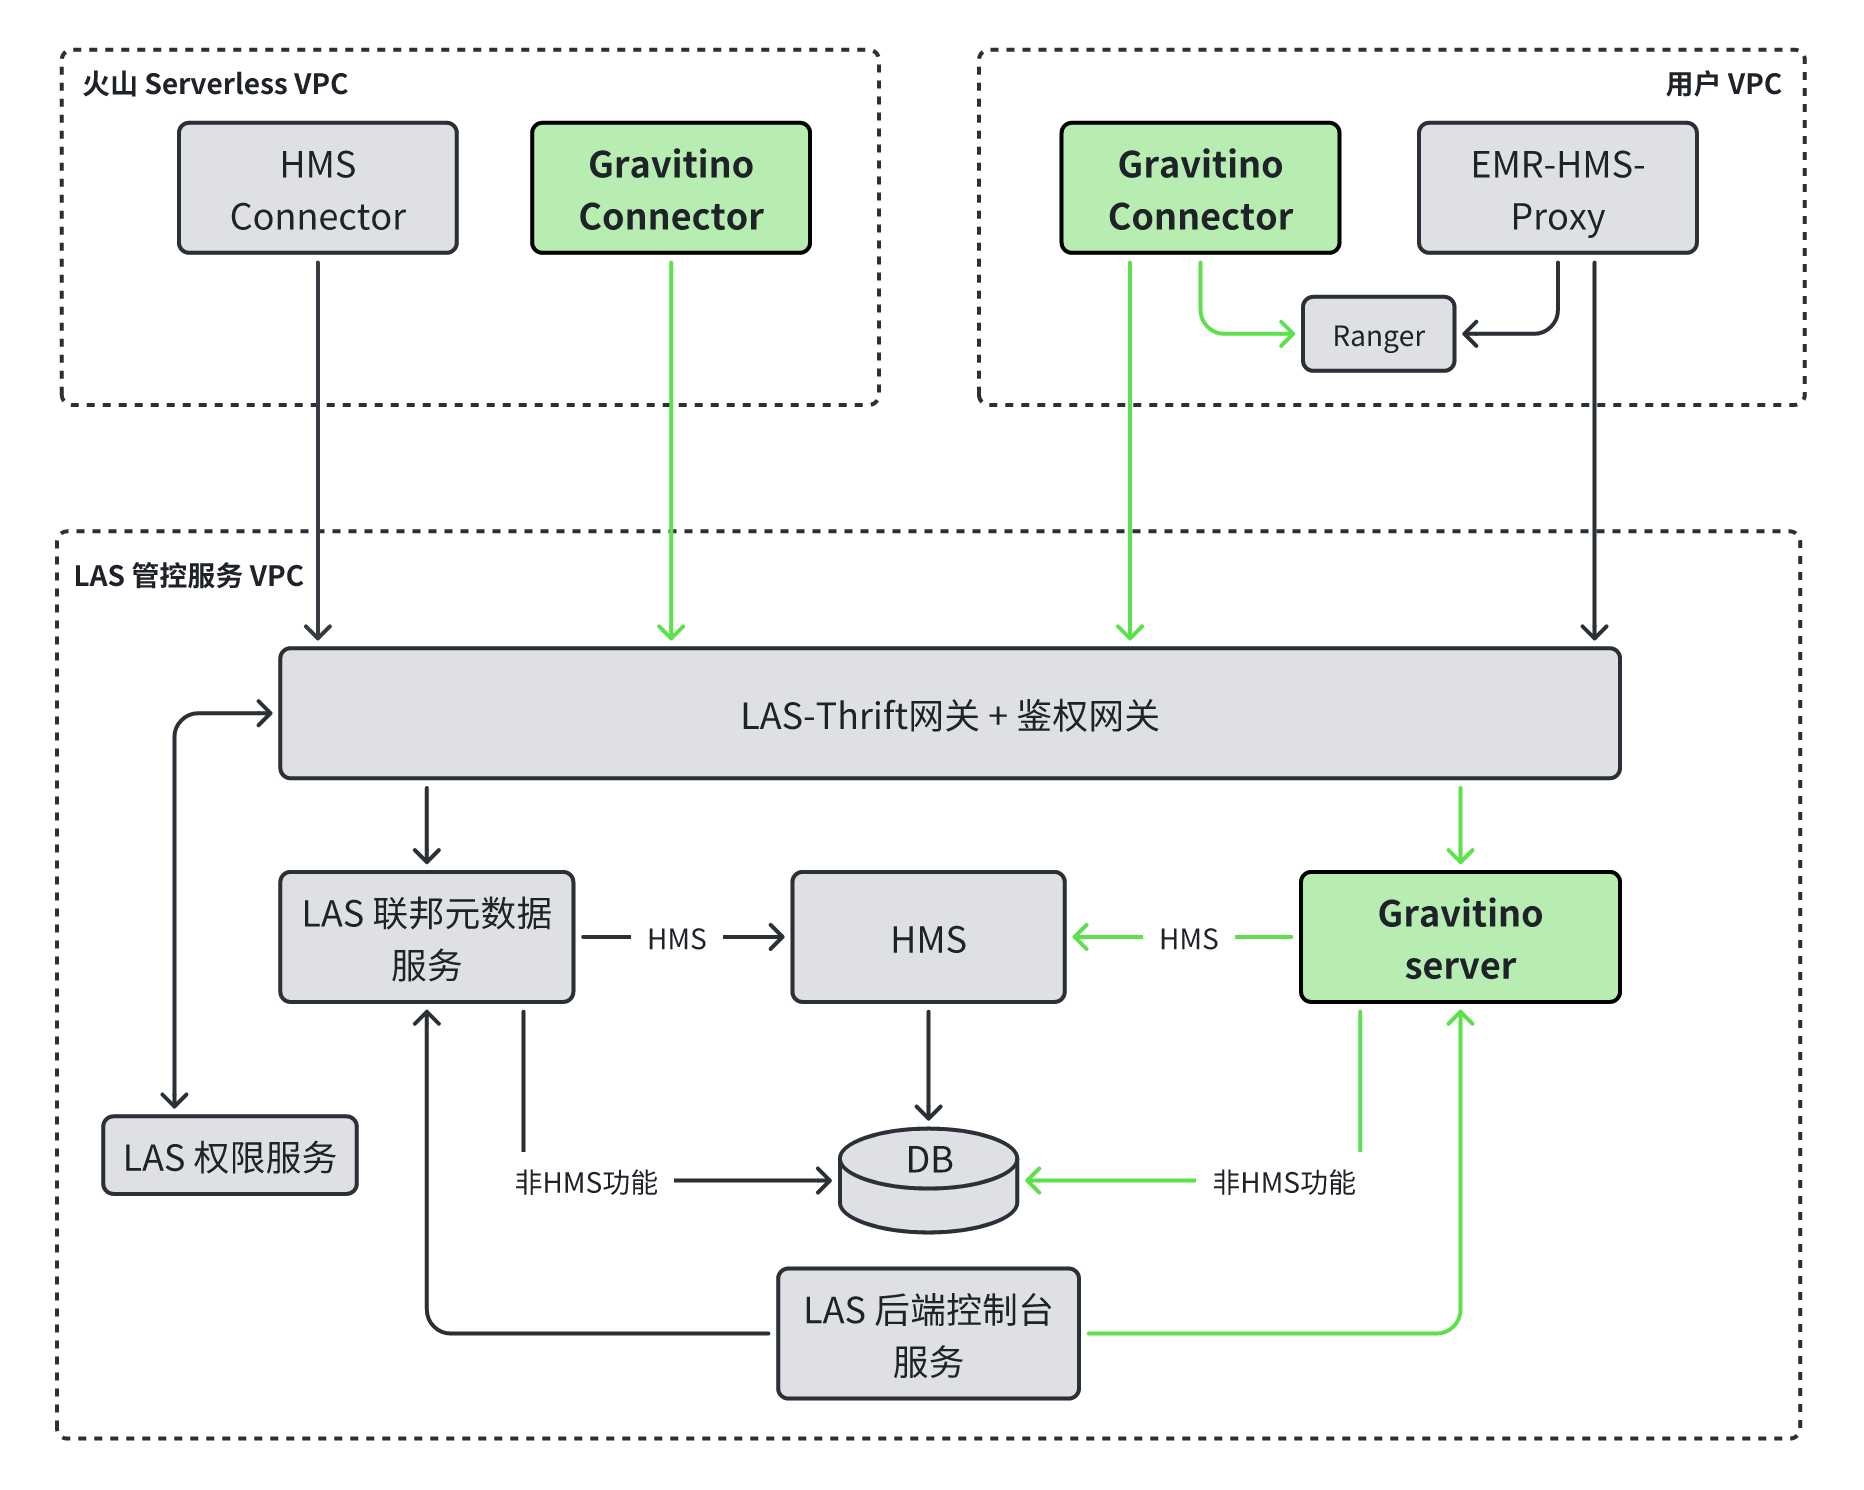
图三 Gravitino 与火山引擎 LAS Catalog 集成
Gravitino 与火山引擎 LAS Catalog 集成,旨在为用户带来以下核心价值:
- 开放与标准:在兼容存量 Hive Metastore (HMS) 的基础上,引入业界领先的 Gravitino 作为元数据管理核心,提供基于开源标准的开放体验。
- 现代数据湖能力:原生支持 Iceberg、Paimon 等主流数据湖格式,并提供标准 Iceberg REST Catalog 服务,以及统一的访问控制与审计能力。
- 多模态元数据:扩展支持 Fileset(文件集)与 Model(AI 模型)等非结构化和 AI 资产的元数据管理。
使用限制
当前仅华北2(北京)及华东2(上海)区域支持 Gravitino 与火山引擎生态的集成。
相关文档
最近更新时间:2026.04.13 08:51:01
这个页面对您有帮助吗?
有用
有用
无用
无用