You need to enable JavaScript to run this app.
文档中心
云数据库 MySQL 版

云数据库 MySQL 版

复制全文
下载 pdf
最佳实践
基于 MySQL 使用 LangChain 框架搭建一个 RAG 应用
复制全文
下载 pdf
基于 MySQL 使用 LangChain 框架搭建一个 RAG 应用
概述​
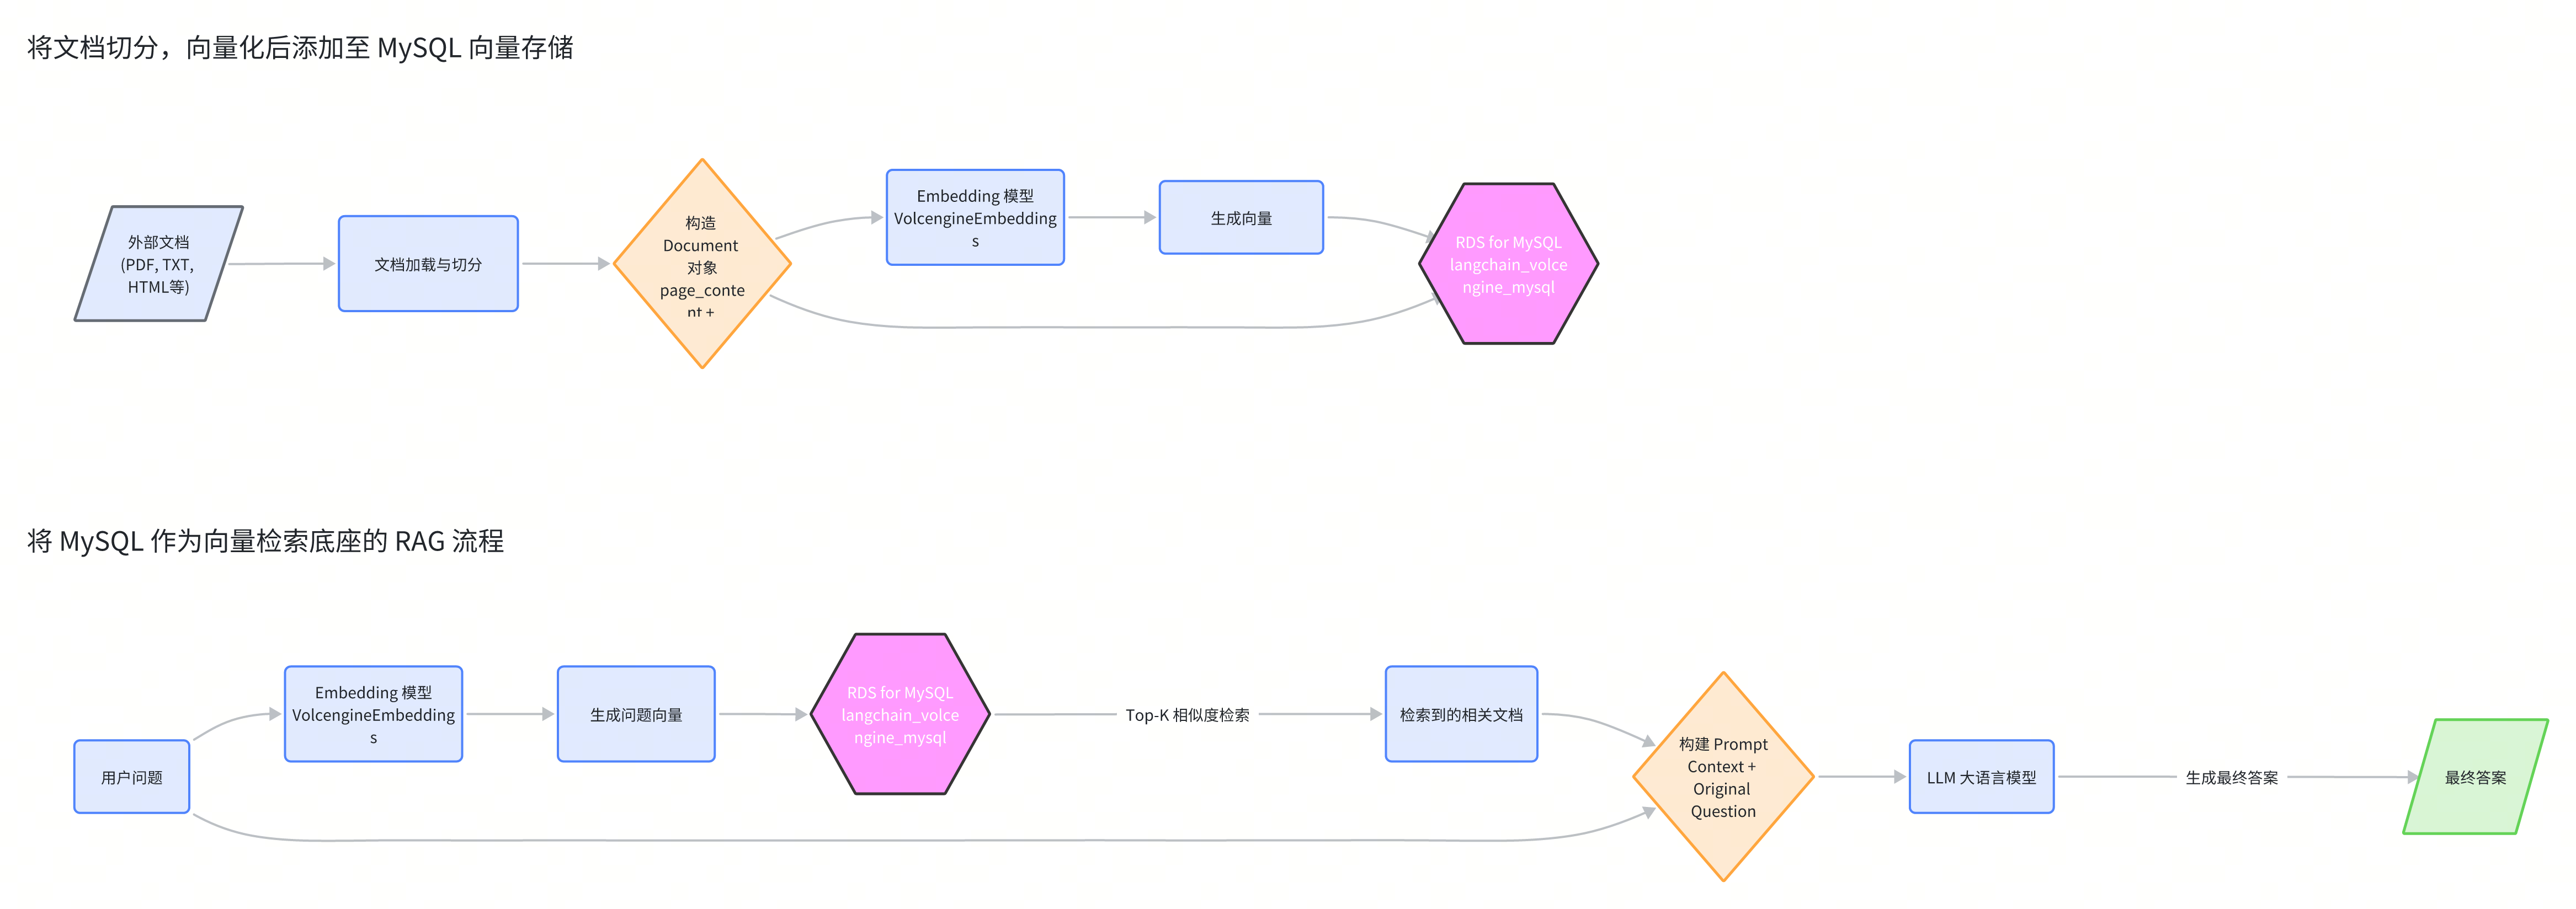
本教程将一步步指导您如何利用 LangChain 框架,将火山引擎 RDS for MySQL 数据库作为向量存储,搭建一个完整的检索增强生成(RAG)应用。我们将使用火山引擎方舟(Ark)提供的 Embedding 和 LLM 模型,并通过 langchain-volcengine-mysql 这个集成库来简化操作。​
读完本教程,您将掌握从环境准备、数据入库、向量检索到搭建完整问答(QA)链的全过程,并了解生产部署中的一些最佳实践。​
整体架构​
​​​
操作步骤​
  1. 环境准备与依赖安装​
在开始之前,请确保您已安装 Python 3.8 或更高版本。然后,我们需要安装所有必需的依赖库。这些库包括 LangChain 核心组件、火山引擎 Ark SDK 以及我们为 MySQL 打造的 LangChain 集成库。​
打开您的终端,执行以下命令:​
​
pip install langchain langchain-core langchain-classic langchain-volcengine-mysql pymysql​
​
pip install --upgrade "volcengine-python-sdk[ark]"​
​
依赖库说明​
  • langchain, langchain-core, langchain-classic: LangChain 的核心框架,提供了构建 RAG 应用的各种工具。​
  • volcengine-python-sdk[ark]": 火山引擎方舟平台的官方 Python SDK,用于调用 Embedding 和 LLM 模型。​
  • langchain-volcengine-mysql: 本次实战的核心,提供了将 RDS MySQL 用作 LangChain 向量存储和 Retriever 的能力。​
  • pymysql: Python 连接 MySQL 数据库的驱动程序。​
  1. 安全配置:设置环境变量​
为了保障您的密钥和数据库凭证安全,强烈建议您使用环境变量来管理这些敏感信息,而不是将它们硬编码在代码中。这不仅更安全,也使得在不同环境(开发、测试、生产)中切换配置变得更加容易。​
  1. 设置环境变量​
请在您的开发环境中设置以下环境变量。您可以将它们添加到您的 .bashrc、.zshrc 文件中,或者在运行脚本前手动导出。​
​
# 火山引擎 Ark API Key​
export ARK_API_KEY="YOUR_ARK_API_KEY"​
​
# RDS MySQL 数据库连接信息​
export MYSQL_HOST="YOUR_MYSQL_HOST"​
export MYSQL_PORT="3306" # 通常是 3306​
export MYSQL_USER="YOUR_MYSQL_USER"​
export MYSQL_PASSWORD="YOUR_MYSQL_PASSWORD"​
export MYSQL_DATABASE="YOUR_MYSQL_DATABASE"​
​
# 火山引擎模型配置​
export EMBEDDING_MODEL="YOUR_EMBEDDING_MODEL_ENDPOINT_ID"​
export LLM_MODEL="YOUR_LLM_MODEL_ENDPOINT_ID"​
​
说明​
  • ARK_API_KEY:请访问火山引擎方舟控制台获取。​
  • MYSQL_*:这些是您 RDS for MySQL 实例的连接信息。​
  • EMBEDDING_MODEL 和 LLM_MODEL:这些是您在方舟平台上部署的模型的 Endpoint ID。​
  1. 在代码中读取环境变量​
在 Python 脚本中,我们可以使用 os 模块来轻松读取这些环境变量。​
​
import os​
​
# 读取 Ark API Key​
ARK_API_KEY = os.getenv("ARK_API_KEY")​
​
# 读取数据库配置​
MYSQL_CONFIG = {​
"host": os.getenv("MYSQL_HOST"),​
"port": int(os.getenv("MYSQL_PORT", 3306)),​
"user": os.getenv("MYSQL_USER"),​
"password": os.getenv("MYSQL_PASSWORD"),​
"database": os.getenv("MYSQL_DATABASE"),​
}​
​
# 读取模型配置​
EMBEDDING_MODEL = os.getenv("EMBEDDING_MODEL")​
LLM_MODEL = os.getenv("LLM_MODEL")​
​
  1. 初始化客户端与 Embeddings​
接下来,我们需要初始化与火山引擎方舟服务的连接,并创建一个自定义的 Embedding 类来处理向量生成过程中的速率限制问题。​
  1. 初始化 Ark 客户端​
​
from volcenginesdkarkruntime import Ark​
​
# 初始化 Ark 客户端​
# SDK 会自动从环境变量 `ARK_API_KEY` 读取密钥​
ark_client = Ark()​
​
  1. 自定义 Embeddings 类​
虽然 LangChain 提供了官方的火山引擎 Embedding 封装,但在实际调用中,我们可能会遇到因为请求频率过高而被限流的情况。为了让我们的应用更健壮,可以创建一个包装类,在其中加入自动重试和指数退避逻辑。​
​
import time​
from typing import List​
from langchain_core.embeddings import Embeddings​
​
class CustomArkEmbeddings(Embeddings):​
"""带有限流重试逻辑的火山引擎 Ark Embeddings 封装"""​
​
def __init__(self, client: Ark, model: str):​
self.client = client​
self.model = model​
​
def embed_documents(self, texts: List[str]) -> List[List[float]]:​
max_retries = 3​
retry_delay = 2 # seconds​
​
for attempt in range(max_retries):​
try:​
resp = self.client.embeddings.create(​
model=self.model,​
input=texts​
)​
return [data.embedding for data in resp.data]​
except Exception as e:​
if attempt == max_retries - 1:​
raise​
print(f"请求被限流,将在 {retry_delay} 秒后重试... (尝试次数 {attempt + 1}/{max_retries})")​
time.sleep(retry_delay)​
retry_delay *= 2 # 指数退避​
​
def embed_query(self, text: str) -> List[float]:​
return self.embed_documents([text])[0]​
​
# 实例化我们自定义的 Embeddings​
embeddings = CustomArkEmbeddings(client=ark_client, model=EMBEDDING_MODEL)​
​
  1. 配置 MySQL 向量库​
这是将 MySQL 融入 LangChain 生态的关键一步。langchain-volcengine-mysql 提供了一个非常便捷的 mysql.configure 函数,只需几行代码即可完成所有配置。​
  1. 使用 mysql.configure​
这个函数会根据您的配置,自动在数据库中创建或连接到指定的表,并准备好 vector_store 和 retriever 对象。​
​
from langchain_volcengine_mysql import mysql​
​
# 配置向量库​
mysql.configure(​
host=MYSQL_CONFIG["host"],​
port=MYSQL_CONFIG["port"],​
user=MYSQL_CONFIG["user"],​
password=MYSQL_CONFIG["password"],​
database=MYSQL_CONFIG["database"],​
table_name="rag_tutorial_documents", # 自定义表名​
embedding_function=embeddings, # 传入我们实例化的 embedding 对象​
embedding_dim=1024 # **重要**:必须与您选择的 Embedding 模型维度一致​
)​
​
# 从 mysql 模块获取 vector_store 和 retriever​
vector_store = mysql.vector_store​
retriever = mysql.retriever​
​
print("✓ RDS MySQL 向量库配置成功!")​
print(f"使用的表名: {vector_store.table_name}")​
​
mysql.configure 参数详解​
  • host, port, user, password, database: 标准的数据库连接参数。​
  • table_name: 用于存储向量和文档的表名。如果该表不存在,库会自动创建。​
  • embedding_function: LangChain 的 Embeddings 对象,用于将文本转换为向量。这里我们传入之前创建的 CustomArkEmbeddings 实例。​
  • embedding_dim: Embedding 模型的输出维度。这是一个非常重要的参数,必须与您在 EMBEDDING_MODEL 中指定的模型维度完全匹配,否则会导致数据库错误。例如,bge-large-zh 模型的维度是 1024。​
  1. 准备与写入文档数据​
配置好向量库后,我们就可以向其中添加文档了。数据入库的过程主要包括:构造 Document 对象列表,然后调用 vector_store.add_documents 方法。​
  1. 构造 Document 列表​
每个 Document 对象包含 page_content(文档正文)和 metadata(元数据)两个部分。元数据对于后续的过滤和溯源非常有用。​
​
from langchain_core.documents import Document​
​
test_data = [​
{​
"content": "veDB for MySQL 是火山引擎提供的一种云原生、高性能的数据库服务。它为现代应用提供了自动扩缩容、高可用和卓越的性能。",​
"metadata": {"source": "product_docs", "category": "database", "version": "1.0"}​
},​
{​
"content": "LangChain 是一个用于构建大语言模型应用的框架。它提供了处理 LLM、向量存储、嵌入和构建复杂链的工具。",​
"metadata": {"source": "tech_blog", "category": "framework", "version": "0.1"}​
},​
{​
"content": "向量数据库能够为 AI 应用实现高效的相似性搜索。它们存储高维向量,并允许使用 HNSW 等算法快速检索相似向量。",​
"metadata": {"source": "research_paper", "category": "ai", "version": "2.0"}​
}​
]​
​
documents = [Document(page_content=doc["content"], metadata=doc["metadata"]) for doc in test_data]​
​
  1. 添加入库并验证​
调用 add_documents 方法,它会将文档内容转换为向量并与元数据一同存入 MySQL 表中。​
​
# 将文档添加到向量库​
document_ids = vector_store.add_documents(documents)​
print(f"成功添加 {len(document_ids)} 个文档。")​
​
# 等待片刻,确保数据写入完成​
import time​
time.sleep(2)​
​
# 进行一次相似性搜索来验证​
query = "什么是 veDB?"​
results = vector_store.similarity_search(query, k=1)​
​
print(f"\n对查询 '{query}' 的搜索结果:")​
for doc in results:​
print(f"- 内容: {doc.page_content[:50]}...")​
print(f" 来源: {doc.metadata['source']}")​
​
  1. 搭建 RAG 问答链​
现在,我们已经拥有了一个填充了知识的向量库。最后一步是将 retriever、LLM 和一个 PromptTemplate 组装成一个完整的 RAG 问答链。​
  1. 初始化 LLM​
首先,我们需要一个 LLM 来生成最终的答案。这里我们同样封装一个简单的 VolcengineLLM 类。​
​
from langchain_core.runnables import Runnable​
from typing import Optional, Any​
​
class VolcengineLLM(Runnable):​
def __init__(self, client: Ark, model: str):​
self.client = client​
self.model = model​
​
def invoke(self, input: Any, config: Optional[dict] = None, **kwargs) -> str:​
prompt = str(input)​
try:​
completion = self.client.chat.completions.create(​
model=self.model,​
messages=[{"role": "user", "content": prompt}]​
)​
return completion.choices[0].message.content​
except Exception as e:​
print(f"调用 LLM 时出错: {e}")​
raise​
​
llm = VolcengineLLM(client=ark_client, model=LLM_MODEL)​
​
  1. 创建 Prompt 模板​
一个好的 Prompt 模板能够指导 LLM 如何利用我们检索到的上下文来回答问题。​
​
from langchain_core.prompts import PromptTemplate​
​
prompt_template = """你是一个乐于助人的人工智能助手。请根据以下上下文信息来回答问题。​
如果根据上下文无法回答,就说你不知道,不要编造答案。​
​
上下文:​
{context}​
​
问题: {question}​
​
回答:"""​
​
PROMPT = PromptTemplate(​
template=prompt_template, input_variables=["context", "question"]​
)​
​
  1. 组装并测试 QA 链​
LangChain 的 RetrievalQA 链能够非常方便地将所有组件整合在一起。​
​
from langchain_classic.chains import RetrievalQA​
​
qa_chain = RetrievalQA.from_chain_type(​
llm=llm,​
chain_type="stuff", # "stuff" 类型会将所有检索到的文档内容塞入 Prompt​
retriever=retriever,​
return_source_documents=True, # 同时返回源文档,便于溯源​
chain_type_kwargs={"prompt": PROMPT}​
)​
​
# 测试我们的 RAG 链​
question = "veDB for MySQL 有哪些特点?"​
result = qa_chain.invoke({"query": question})​
​
print(f"问题: {question}")​
print(f"\n答案: {result['result']}")​
print("\n来源文档:")​
for doc in result['source_documents']:​
print(f"- [{doc.metadata['source']}] {doc.page_content[:60]}...")​
​
  1. 清理与生产注意事项​
langchain-volcengine-mysql 提供了清理数据的方法,但在生产环境中需要谨慎使用。​
  1. 按 ID 删除​
如果您想删除特定的文档,可以使用 delete 方法并传入文档 ID 列表。​
​
# 删除之前添加的文档​
print(f"准备删除 {len(document_ids)} 个文档...")​
vector_store.delete(ids=document_ids)​
print("✓ 文档已删除。")​
​
  1. 删除整张表​
drop_table 方法会彻底删除存储向量的整张表。这是一个危险操作,请仅在测试和开发环境中使用。​
​
# 警告:此操作会删除整个表!​
print(f"准备删除表 '{vector_store.table_name}'...")​
# vector_store.drop_table()​
print("✓ 表已删除(操作已注释)。")​
​
生产环境最佳实践​
  • 逻辑删除:在生产环境中,通常建议使用逻辑删除(在元数据中添加一个 is_deleted 字段)而不是物理删除,以便于数据恢复和审计。​
  • 权限控制:确保您的数据库用户权限最小化,仅授予其执行 RAG 所需的 SELECT, INSERT, UPDATE, DELETE 权限,避免授予 DROP 或 CREATE 等高风险权限。​
  • 备份:定期备份您的数据库。​
常见问题与排查​
​
问题分类​
可能原因与解决方案​
连接失败​
  • 检查网络:确保您的应用服务器可以访问 RDS MySQL 实例的地址和端口。​
  • 核对凭证:仔细检查 host, port, user, password, database 是否正确无误。​
  • 白名单:检查 RDS MySQL 的 IP 白名单设置,是否已将应用服务器的 IP 加入。​
权限或表不存在​
  • 权限不足:确认数据库用户是否具有对目标表的 SELECT, INSERT, UPDATE, DELETE 权限,以及在首次创建表时可能需要的 CREATE 权限。​
  • 表名错误:检查 table_name 是否与数据库中实际的表名一致。​
Embedding 维度不匹配​
  • 错误信息:通常会看到类似 Vector dimension mismatch 的数据库错误。​
  • 解决方案:确认 mysql.configure 中的 embedding_dim 参数值与您使用的 Embedding 模型(EMBEDDING_MODEL)的实际输出维度完全一致。这是最常见的配置错误之一。​
模型或 API Key 错误​
  • 无效的 Endpoint ID:确认 EMBEDDING_MODEL 和 LLM_MODEL 的值是正确的模型 Endpoint ID。​
  • 无效的 API Key:确认 ARK_API_KEY 是有效的,并且有权限调用您指定的模型。​
依赖版本冲突​
  • 检查环境:使用 pip freeze 检查当前环境中的库版本是否与要求兼容。​
  • 创建虚拟环境:最佳实践是为每个项目创建一个独立的 Python 虚拟环境,以避免不同项目间的依赖冲突。​
​
​
最近更新时间:2026.01.30 10:41:22
这个页面对您有帮助吗?
有用
有用
无用
无用