You need to enable JavaScript to run this app.
文档中心
流式计算 Flink版

流式计算 Flink版

复制全文
下载 pdf
Paimon Compaction
Flink 分离式 Compaction 策略
复制全文
下载 pdf
Flink 分离式 Compaction 策略
本文重点介绍分离式 Compaction 作业,即 Dedicated Compaction Job 作业类型。​
Compaction 模式对比​
我们可以从以下几个方向对比使用默认模式和分离式 Compaction 的特点:​
​
​
默认模式(Compaction 包含在写作业)​
分离式 Compaction(独立 Flink 任务 Compaction)​
是否影响写入吞吐量​
是​
否​
多 Flink 作业并发写入​
不支持​
支持​
配置复杂度​
低​
相对略高​
写入作业稳定性​
小数据量下相对稳定,大数据量下容易导致作业反压严重,OOM等问题;​
大数据量下作业稳定,内存模型简单,易于横向扩展;​
整体资源消耗​
资源消耗较难估算,在考虑作业稳定下需要叠加 write + compact 并行的峰值进行估算​
Write + Compact 作业可以分别根据消费能力和小文件容忍度进行单独横向扩展​
​
可以看出我们在以下情况下建议选择分离式 Compaction 任务​
  1. 多任务场景:多任务写入同一张 Paimon 表​
  1. 实时性要求高:Flink 写入实时性要求很高,不能容忍 Compaction 的任务影响 Flink 写入性能(例如下游需要 1 分钟以内流式消费最新的数据)​
  1. 可扩展性:Flink 写入一般是增量写入,Compaction 是内存、I/O 密集型作业,如果使用分离式 Compaction 可以独立使用不同规格进行横向扩展​
配置示例​
前置准备​
TOS 桶要求​
以下条件满足任一即可:​
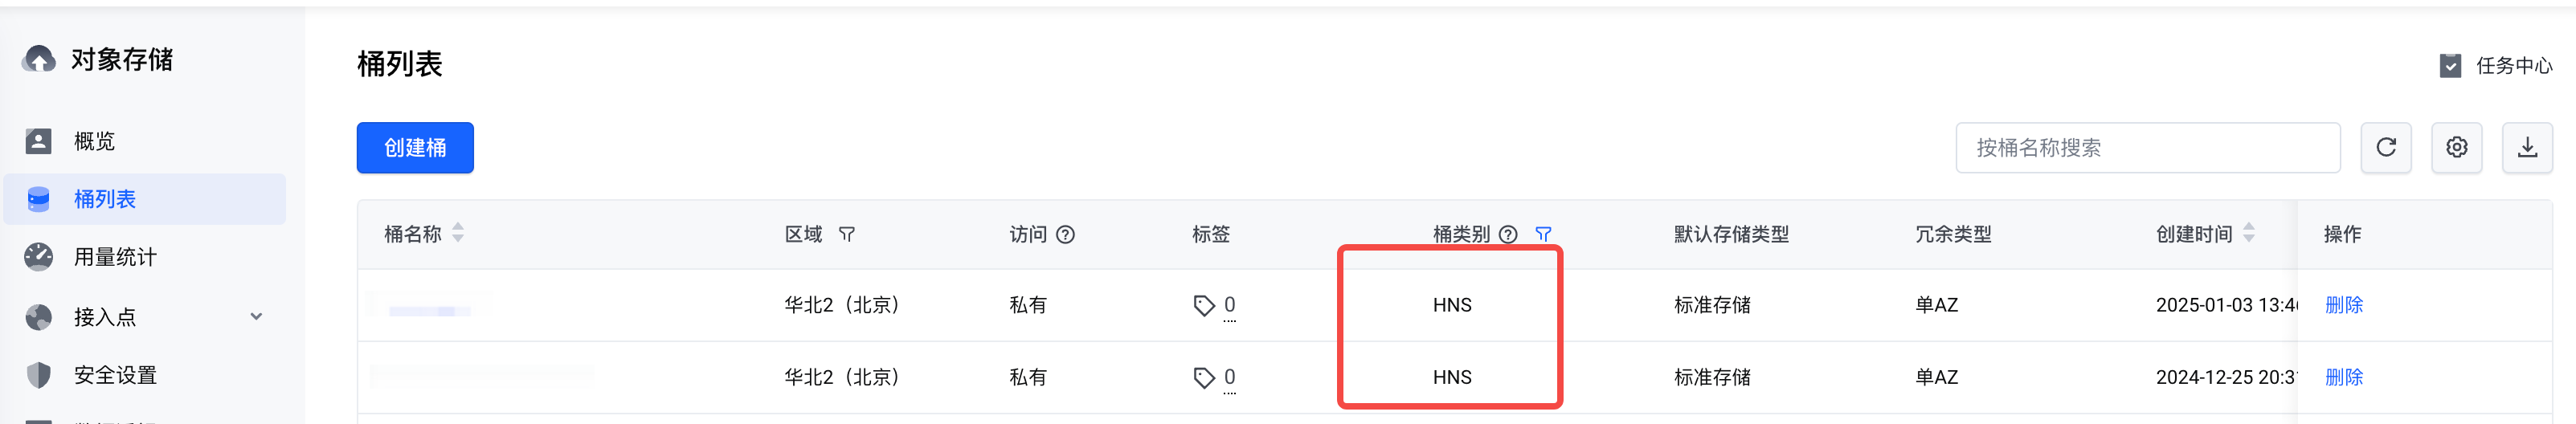
  1. (推荐⭐️⭐️⭐️)写入目标桶是 HNS 类型;​
​​​
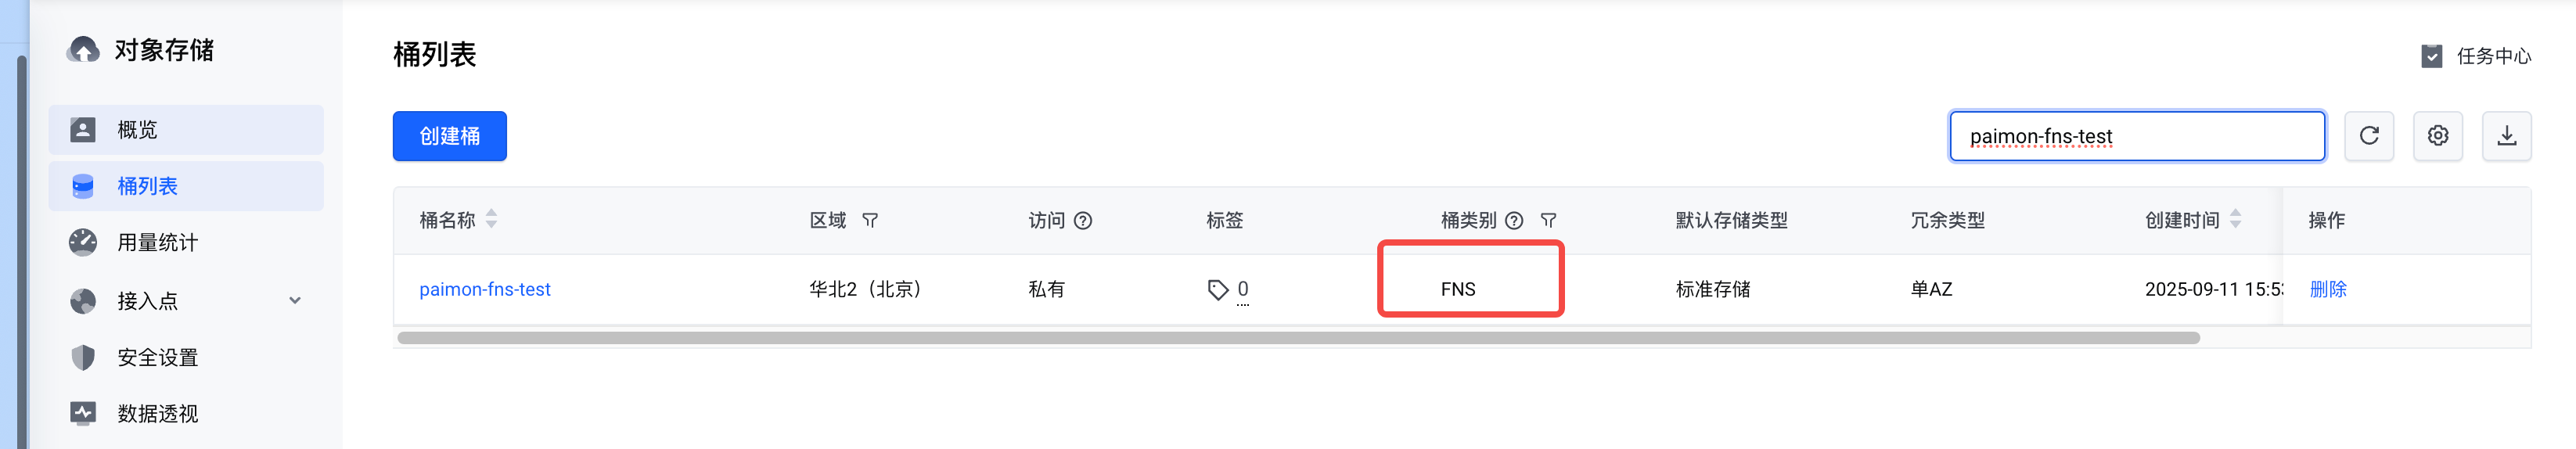
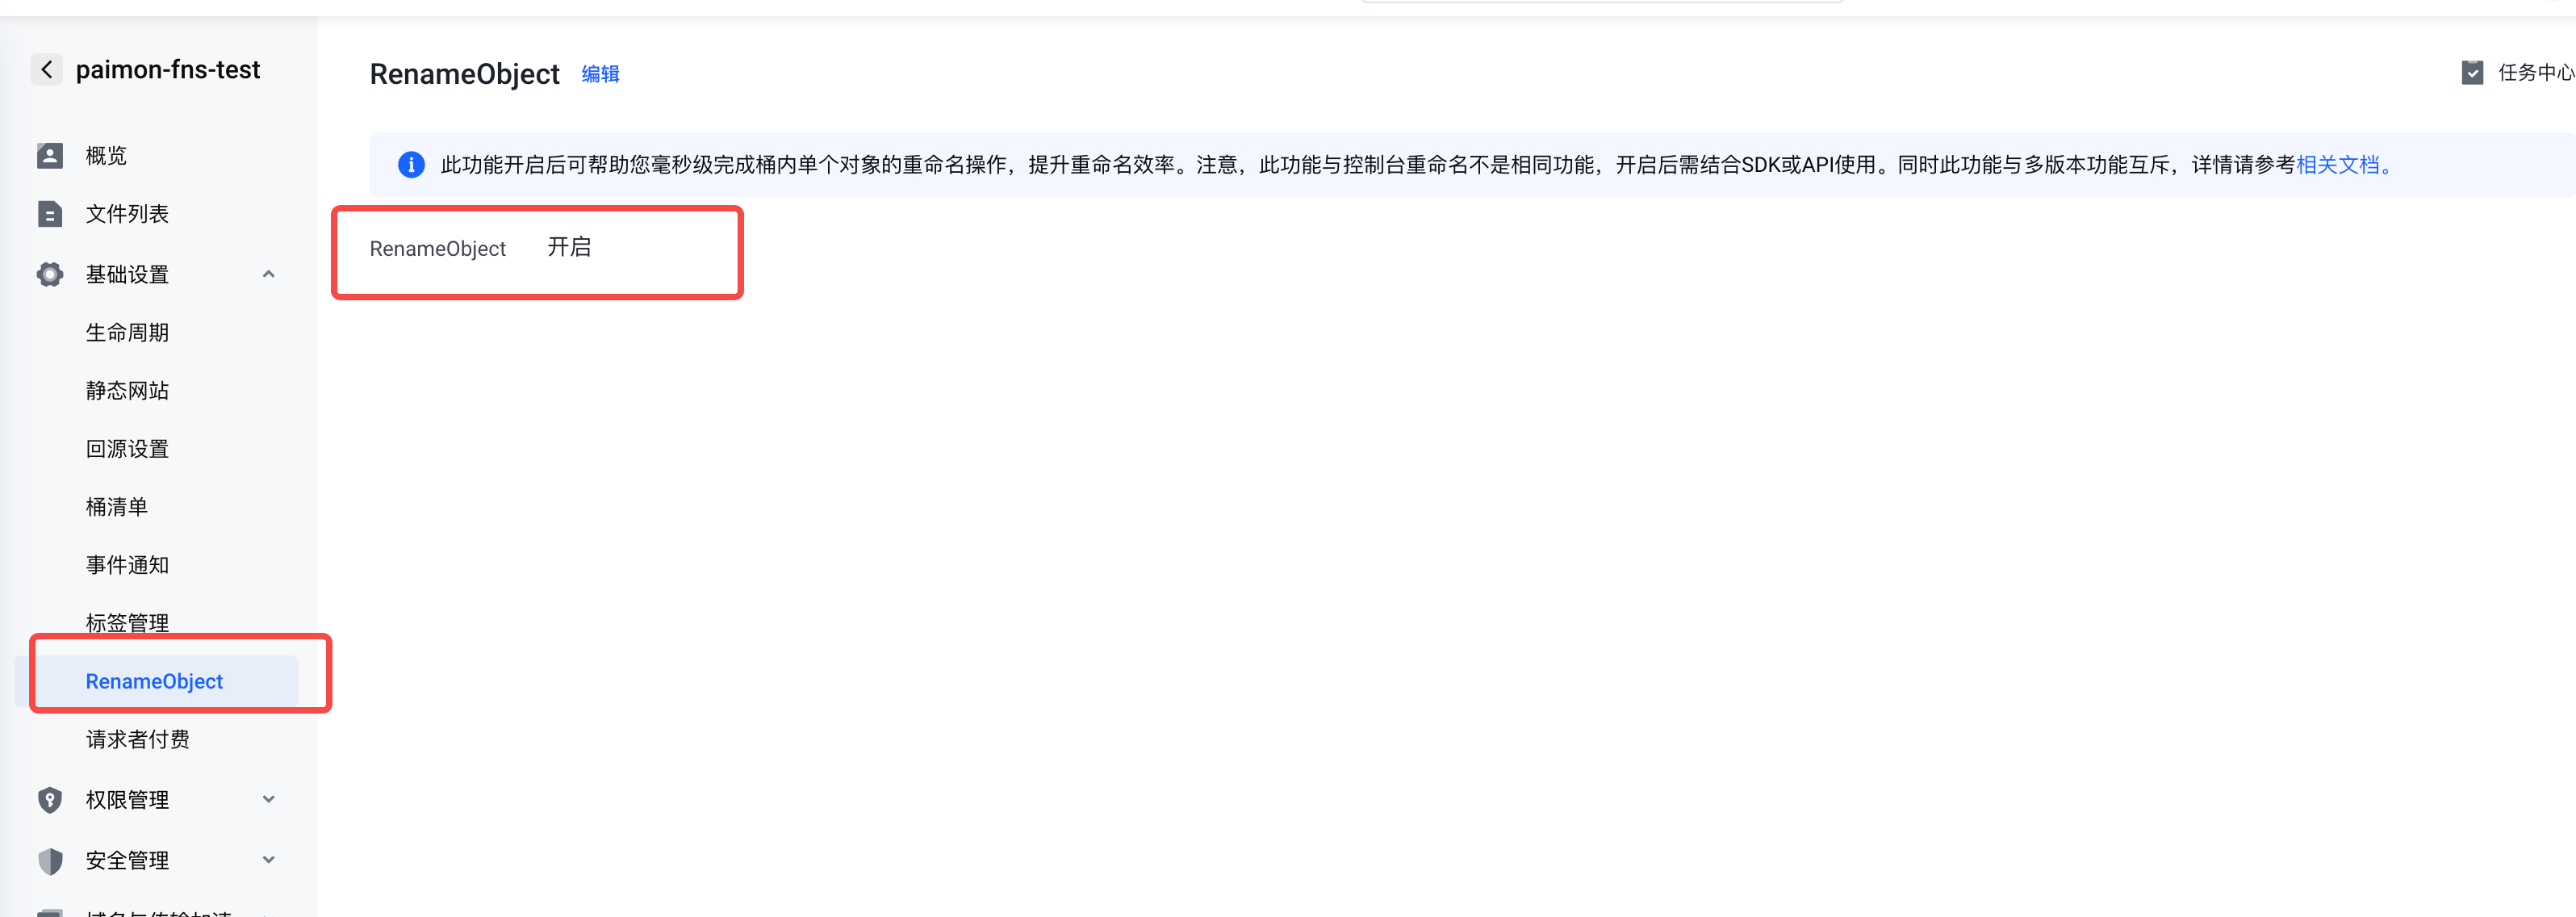
  1. 写入目标桶是 FNS 类型,但已开启 Rename 原子性(注:Rename 同 TOS 版本控制互斥使用 RenameObject--对象存储-火山引擎)​
​​​
​​​
表类型要求​
  1. 仅限固定分桶表:表参数设置 bucket 个数 > 0 即为固定分桶表;​
Flink 版本要求​
需要依赖 Flink 1.16 及以上版本,当前建议使用 Flink 1.17 版本。​
作业配置过程​
写作业配置​
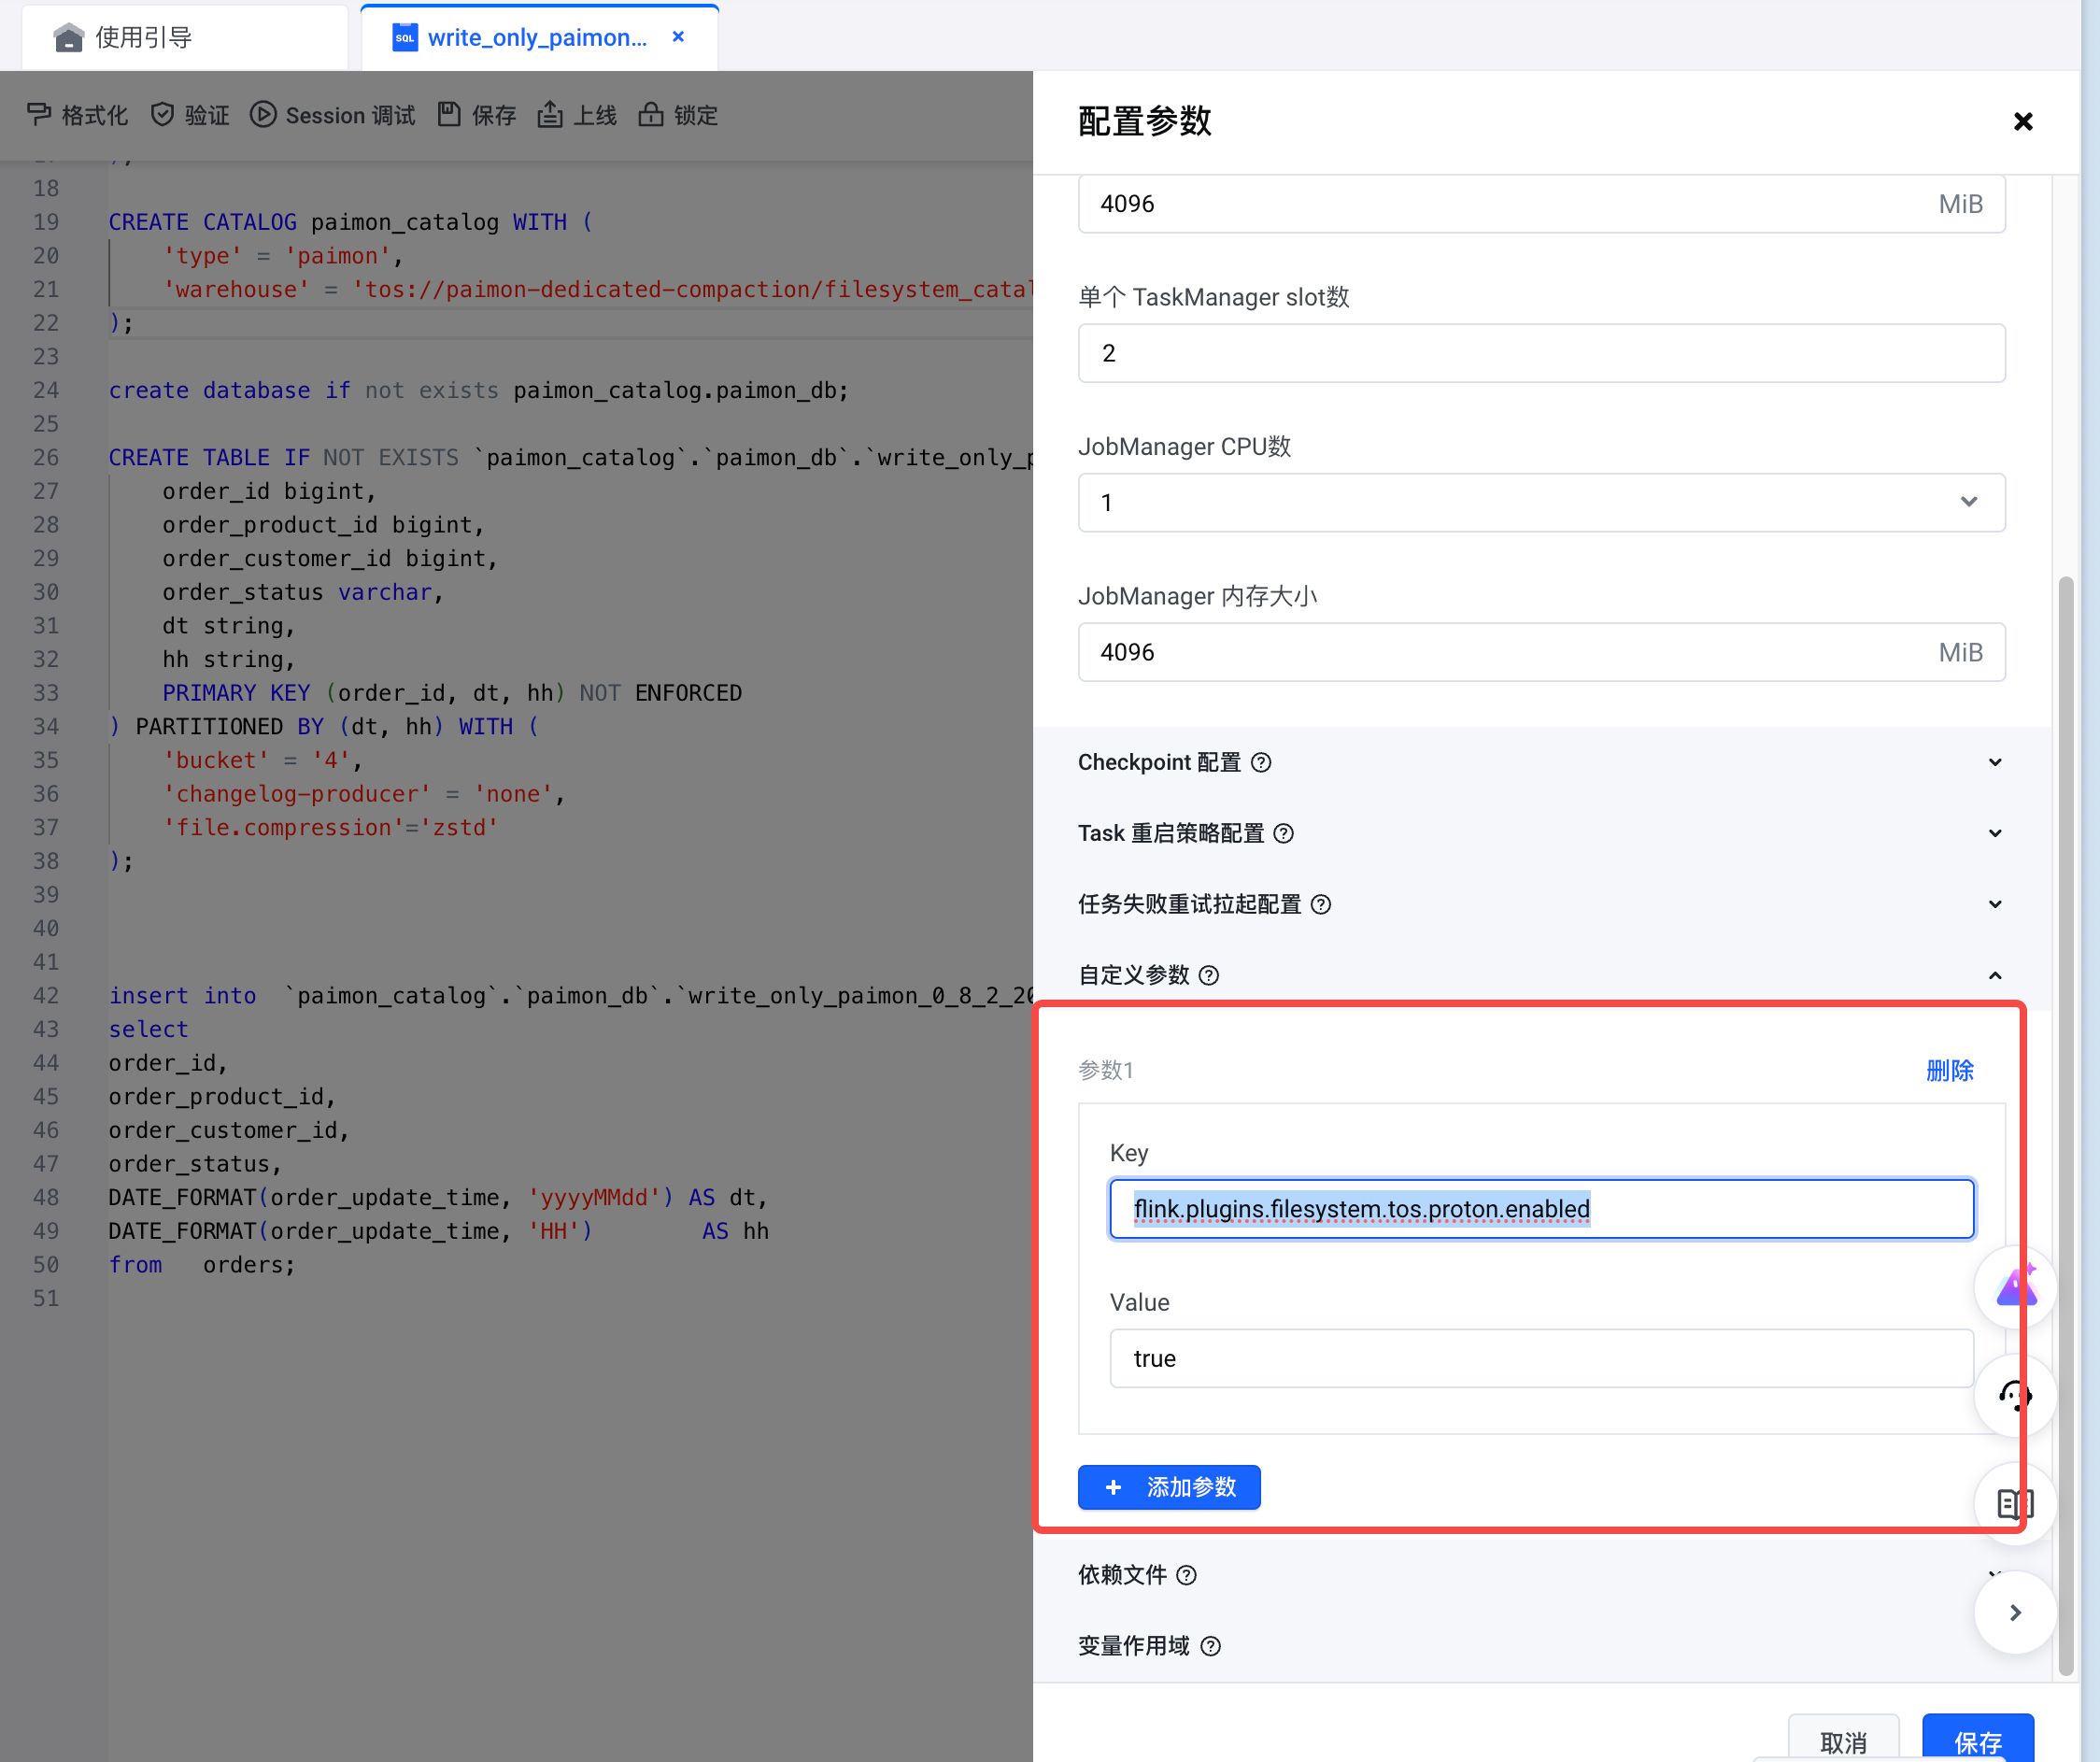
  1. 写作业增加自定义参数支持 HNS 桶写入(兼容 FNS)​
​
flink.plugins.filesystem.tos.proton.enabled: true​
​
​​​
  1. 如果是 FNS 桶开启 Rename 原子性额外参数(HNS 桶可忽略)​
​
flink.hadoop.fs.tos.rename.enabled: true​
​
  1. SQL Hint 追加表级参数(write-only)​
*/*+ OPTIONS('write-only'='true') /​
​
create temporary table orders (​
order_id bigint,​
order_product_id bigint,​
order_customer_id bigint,​
order_status varchar,​
order_update_time as localtimestamp​
) WITH (​
'connector' = 'datagen',​
'rows-per-second'='100',​
'fields.order_status.length' = '3',​
'fields.order_id.min' = '1',​
'fields.order_id.max' = '10000',​
'fields.order_product_id.min' = '1',​
'fields.order_product_id.max' = '100',​
'fields.order_customer_id.min' = '1',​
'fields.order_customer_id.max' = '1000'​
);​
​
CREATE CATALOG paimon_catalog WITH (​
'type' = 'paimon',​
'warehouse' = 'tos://paimon-dedicated-compaction/filesystem_catalog'​
);​
​
create database if not exists paimon_catalog.paimon_db;​
​
CREATE TABLE IF NOT EXISTS `paimon_catalog`.`paimon_db`.`write_only_paimon_0_8_2_20250911` (​
order_id bigint,​
order_product_id bigint,​
order_customer_id bigint,​
order_status varchar,​
dt string,​
hh string,​
PRIMARY KEY (order_id, dt, hh) NOT ENFORCED​
) PARTITIONED BY (dt, hh) WITH (​
'bucket' = '4',​
'changelog-producer' = 'none',​
'file.compression'='zstd'​
);​
​
-- 注意设置 write-only 参数​
insert into `paimon_catalog`.`paimon_db`.`write_only_paimon_0_8_2_20250911` /*+ OPTIONS('write-only'='true') */​
select ​
order_id,​
order_product_id,​
order_customer_id,​
order_status,​
DATE_FORMAT(order_update_time, 'yyyyMMdd') AS dt,​
DATE_FORMAT(order_update_time, 'HH') AS hh​
from orders;​
​
写作业配置 Check​
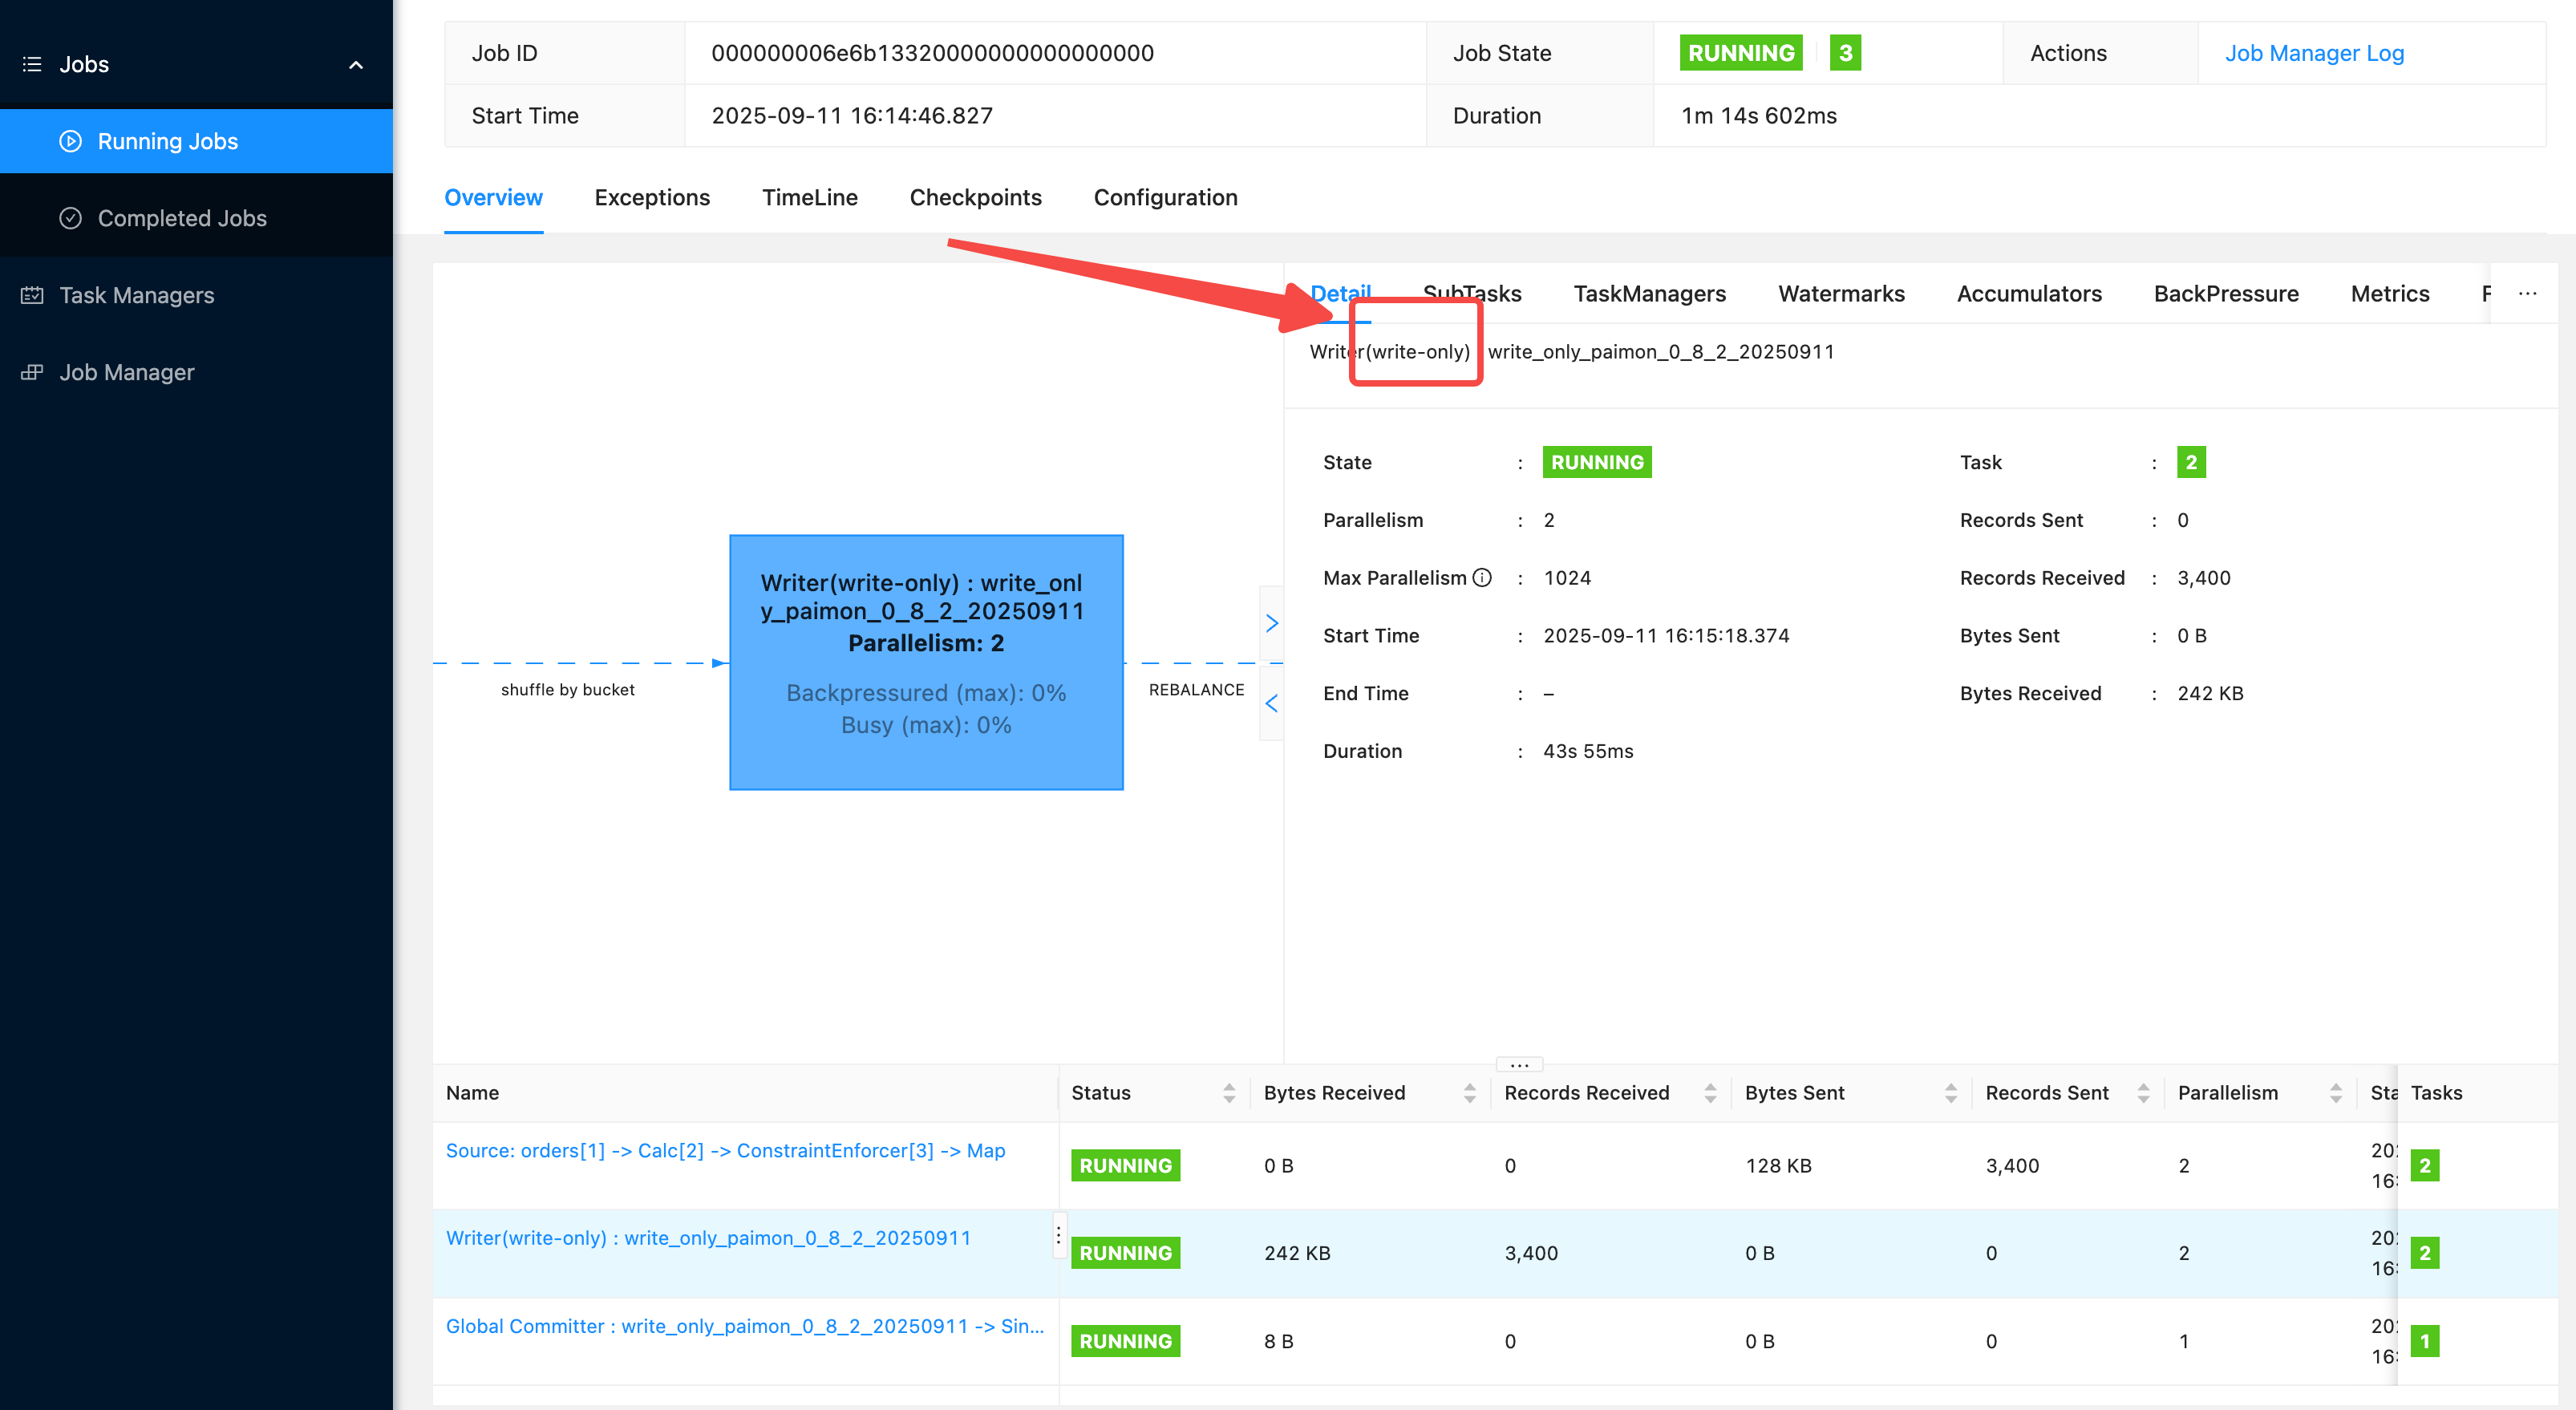
  1. 拉起作业后,可以查看 FlinkUI 的拓扑图确认 Writer 算子包含 write-only 名称即可;​
​​​
Compaction 作业配置​
说明​
通过 Flink SQL 或者 Jar 作业都可以单独配置 Compaction 作业,两者在运行时无任何区别。从维护成本看, Flink SQL 更简单容易一些,更推荐使用;​
方案一:Flink SQL 作业配置(推荐)​
  1. 创建 Flink Streaming SQL 作业​
​
CREATE CATALOG paimon_catalog WITH (​
'type' = 'paimon',​
'warehouse' = 'tos://paimon-dedicated-compaction/filesystem_catalog'​
);​
​
USE CATALOG paimon_catalog;​
​
CALL sys.compact(​
'paimon_db.write_only_paimon_0_8_2_20250911', -- 表名, 格式为 db.table​
'', -- 分区(可选,不填则不限制分区)​
'', -- 排序策略(可选) ​
'', -- 排序字段(可选)​
'consumer.mode=at-least-once,consumer-id=your-consumer-id,sort-spill-threshold=5,num-sorted-run.stop-trigger=2147483647' -- 任务级新增表参数(可选)​
);​
​
​
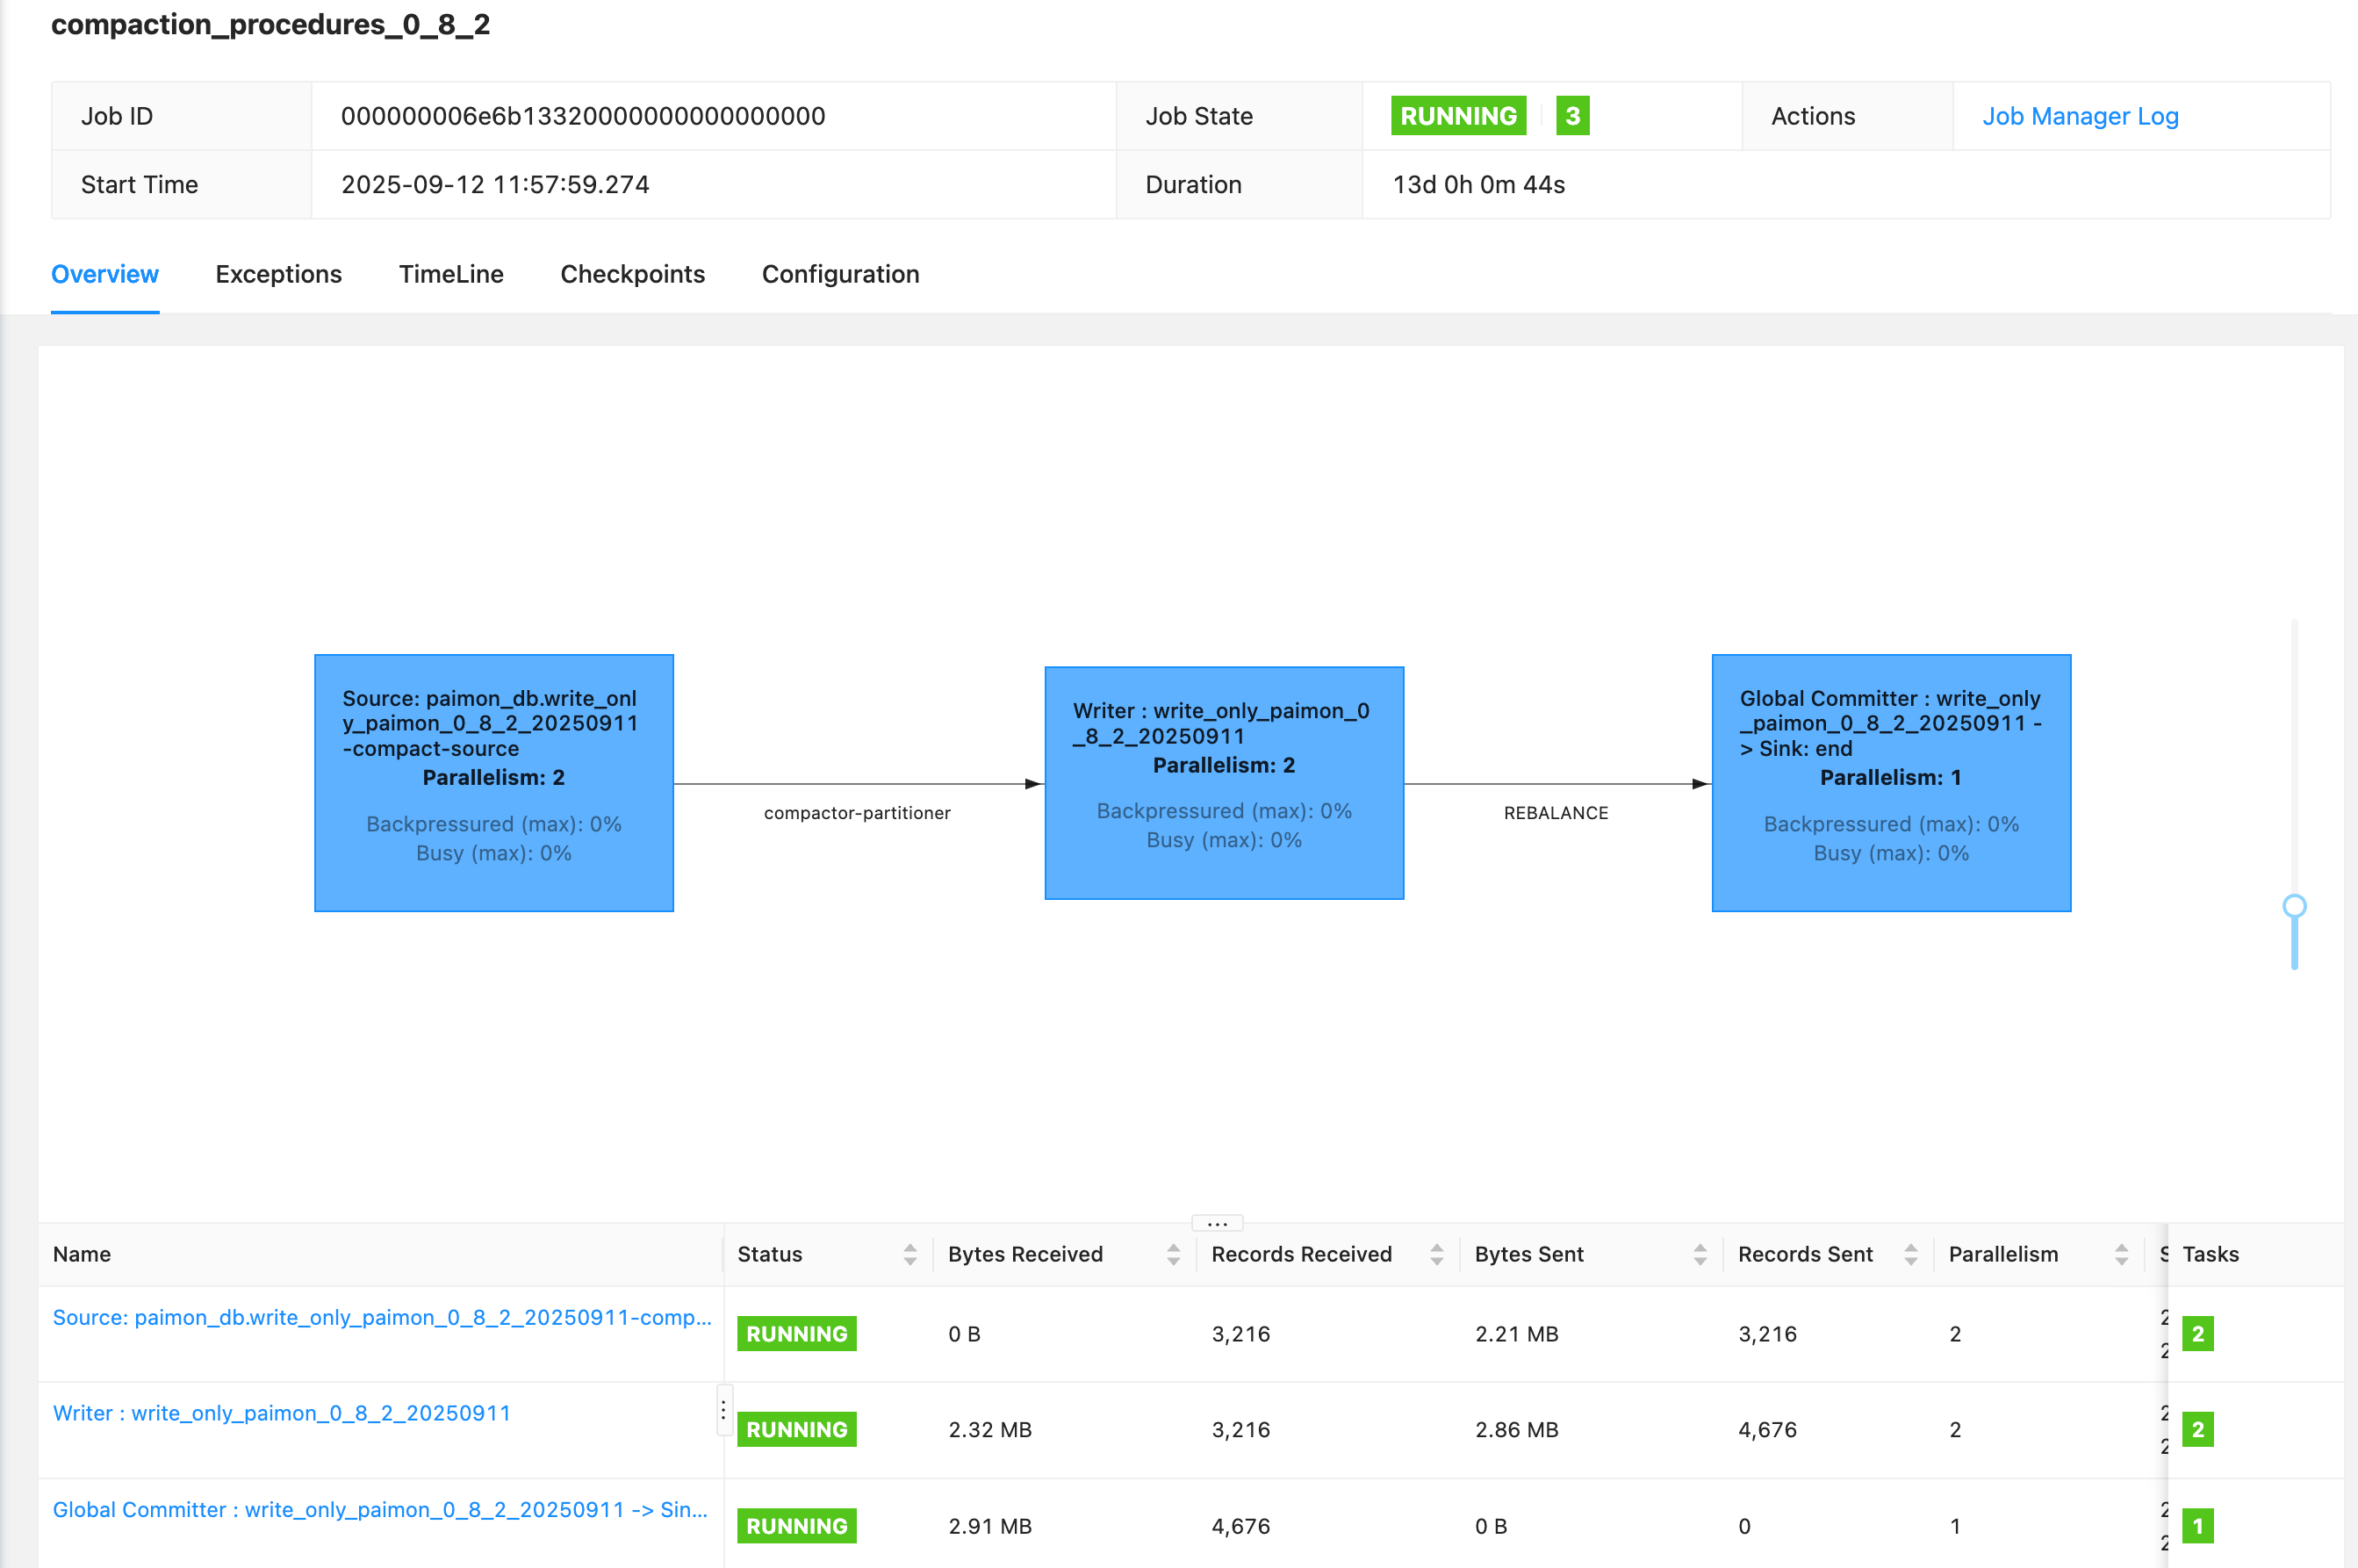
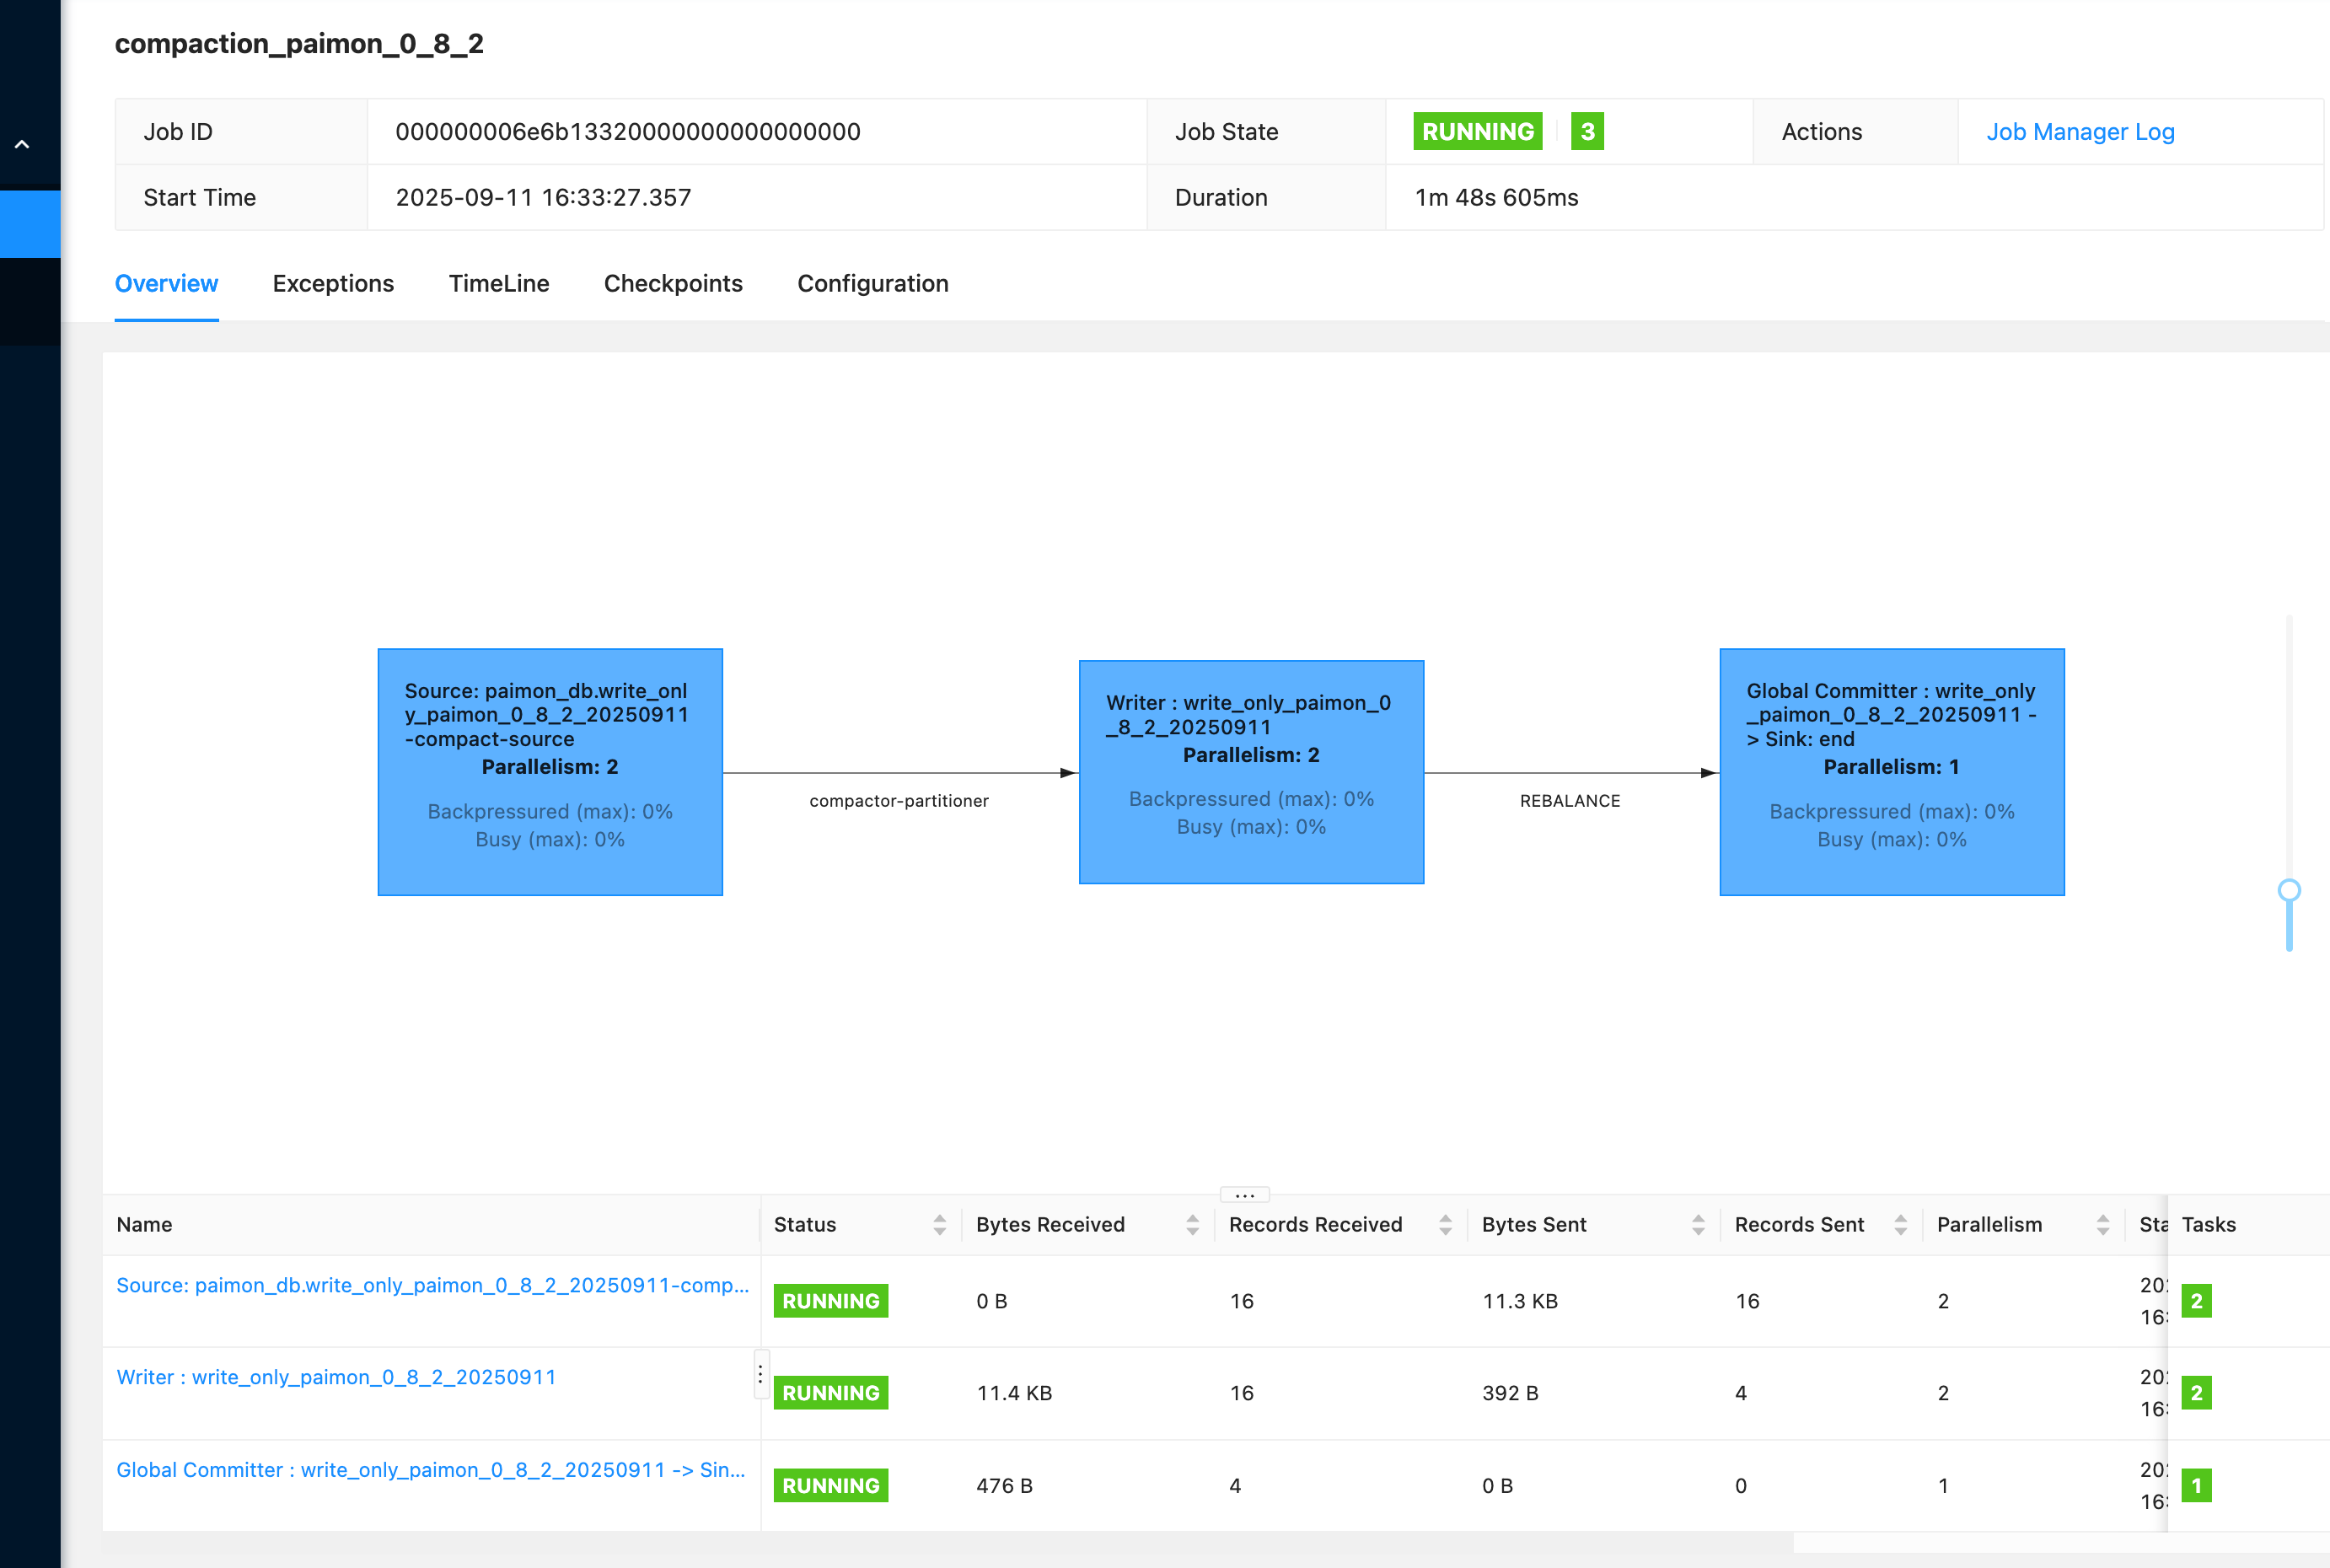
  1. 任务上线后可以正常运行, Flink UI 运行正常​
​​​
​​​
方案二:Flink Jar 作业配置​
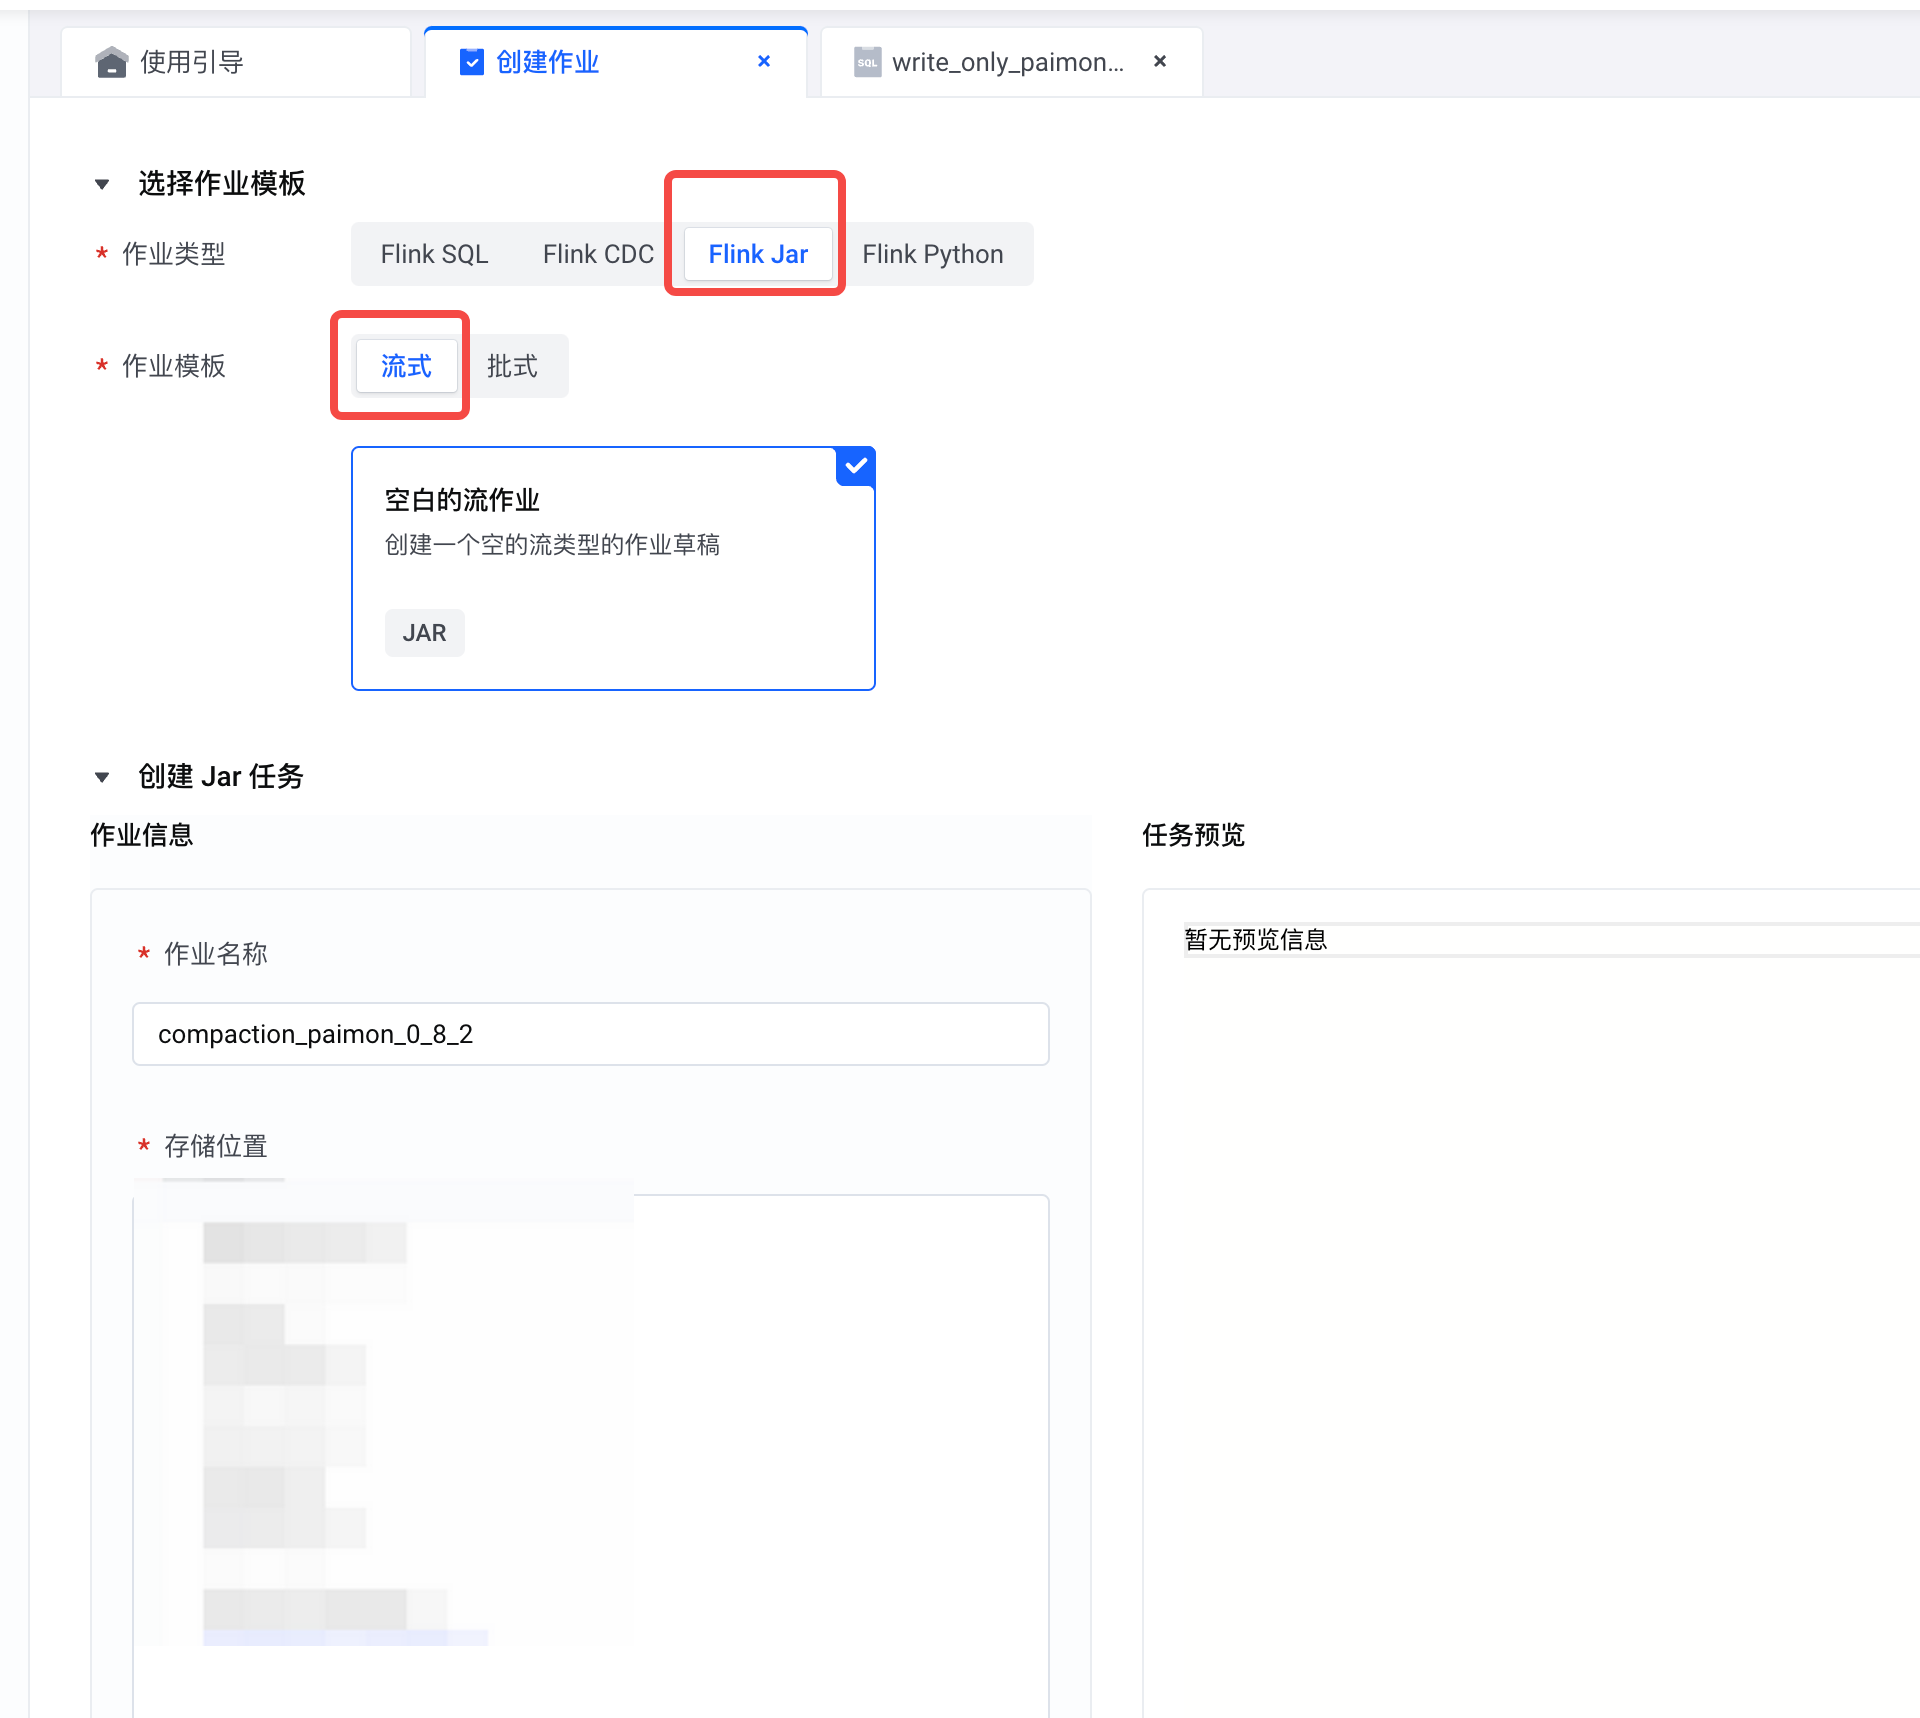
  1. 创建 Flink Streaming Jar 作业​
​​​
  1. 依赖 Jar 包上传​
  • Paimon 0.8.2 版本​
​
​
paimon-flink-1.17-0.8.2-byted-release-tob-20250904.jar
​
​
  • Paimon 1.1 版本​
当前可以可以前往官方 maven 仓库下载 Jar 包:​
https://repo.maven.apache.org/maven2/org/apache/paimon/paimon-flink-1.17/1.1.1/paimon-flink-1.17-1.1.1.jar​
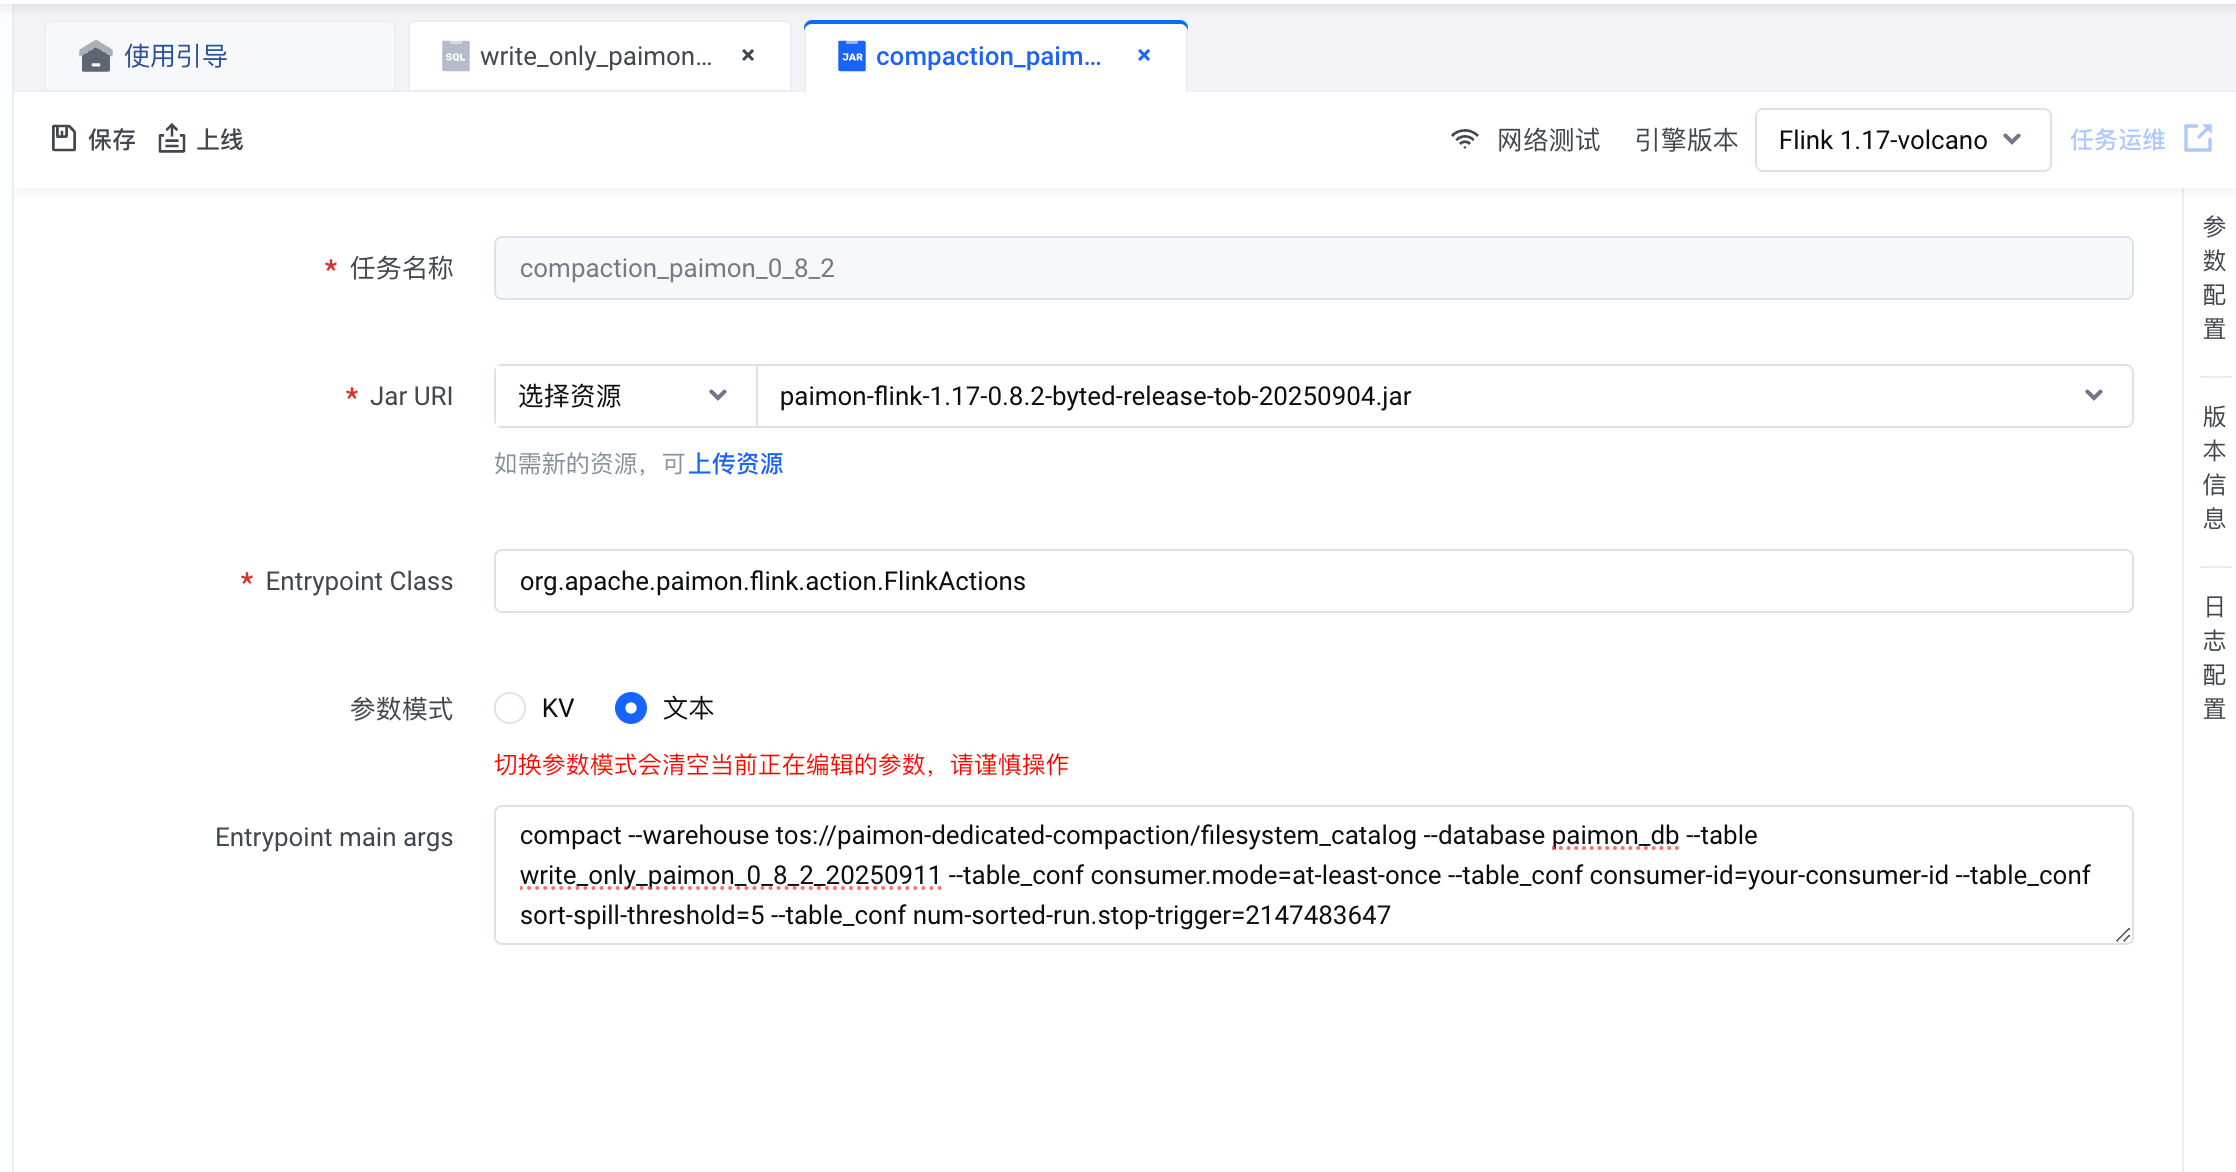
  1. 任务配置​
  • Jar URI 资源选择上述 Jar 包;​
  • Entrypoint Class 固定值: org.apache.paimon.flink.action.FlinkActions​
  • Entrypoint main args 示例:​
​
## --table_conf 为追加表级参数,视具体场景进行调整​
compact --warehouse tos://paimon-dedicated-compaction/filesystem_catalog --database paimon_db --table write_only_paimon_0_8_2_20250911 --table_conf consumer.mode=at-least-once --table_conf consumer-id=your-consumer-id --table_conf sort-spill-threshold=5 --table_conf num-sorted-run.stop-trigger=2147483647​
​
​​​
  • 自定义参数配置,同写作业一样,以下两种参数根据实际情况选择合适的选项设置在任务的自定义参数中​
​
# 两种方案​
# 方案一:HNS 桶开启​
flink.plugins.filesystem.tos.proton.enabled: true​
​
# 方案二:FNS 桶 + RENAME 原子性​
flink.hadoop.fs.tos.rename.enabled: true​
​
Compaction 作业配置 Check​
  1. 确认作业能够正常拉起;​
​​​
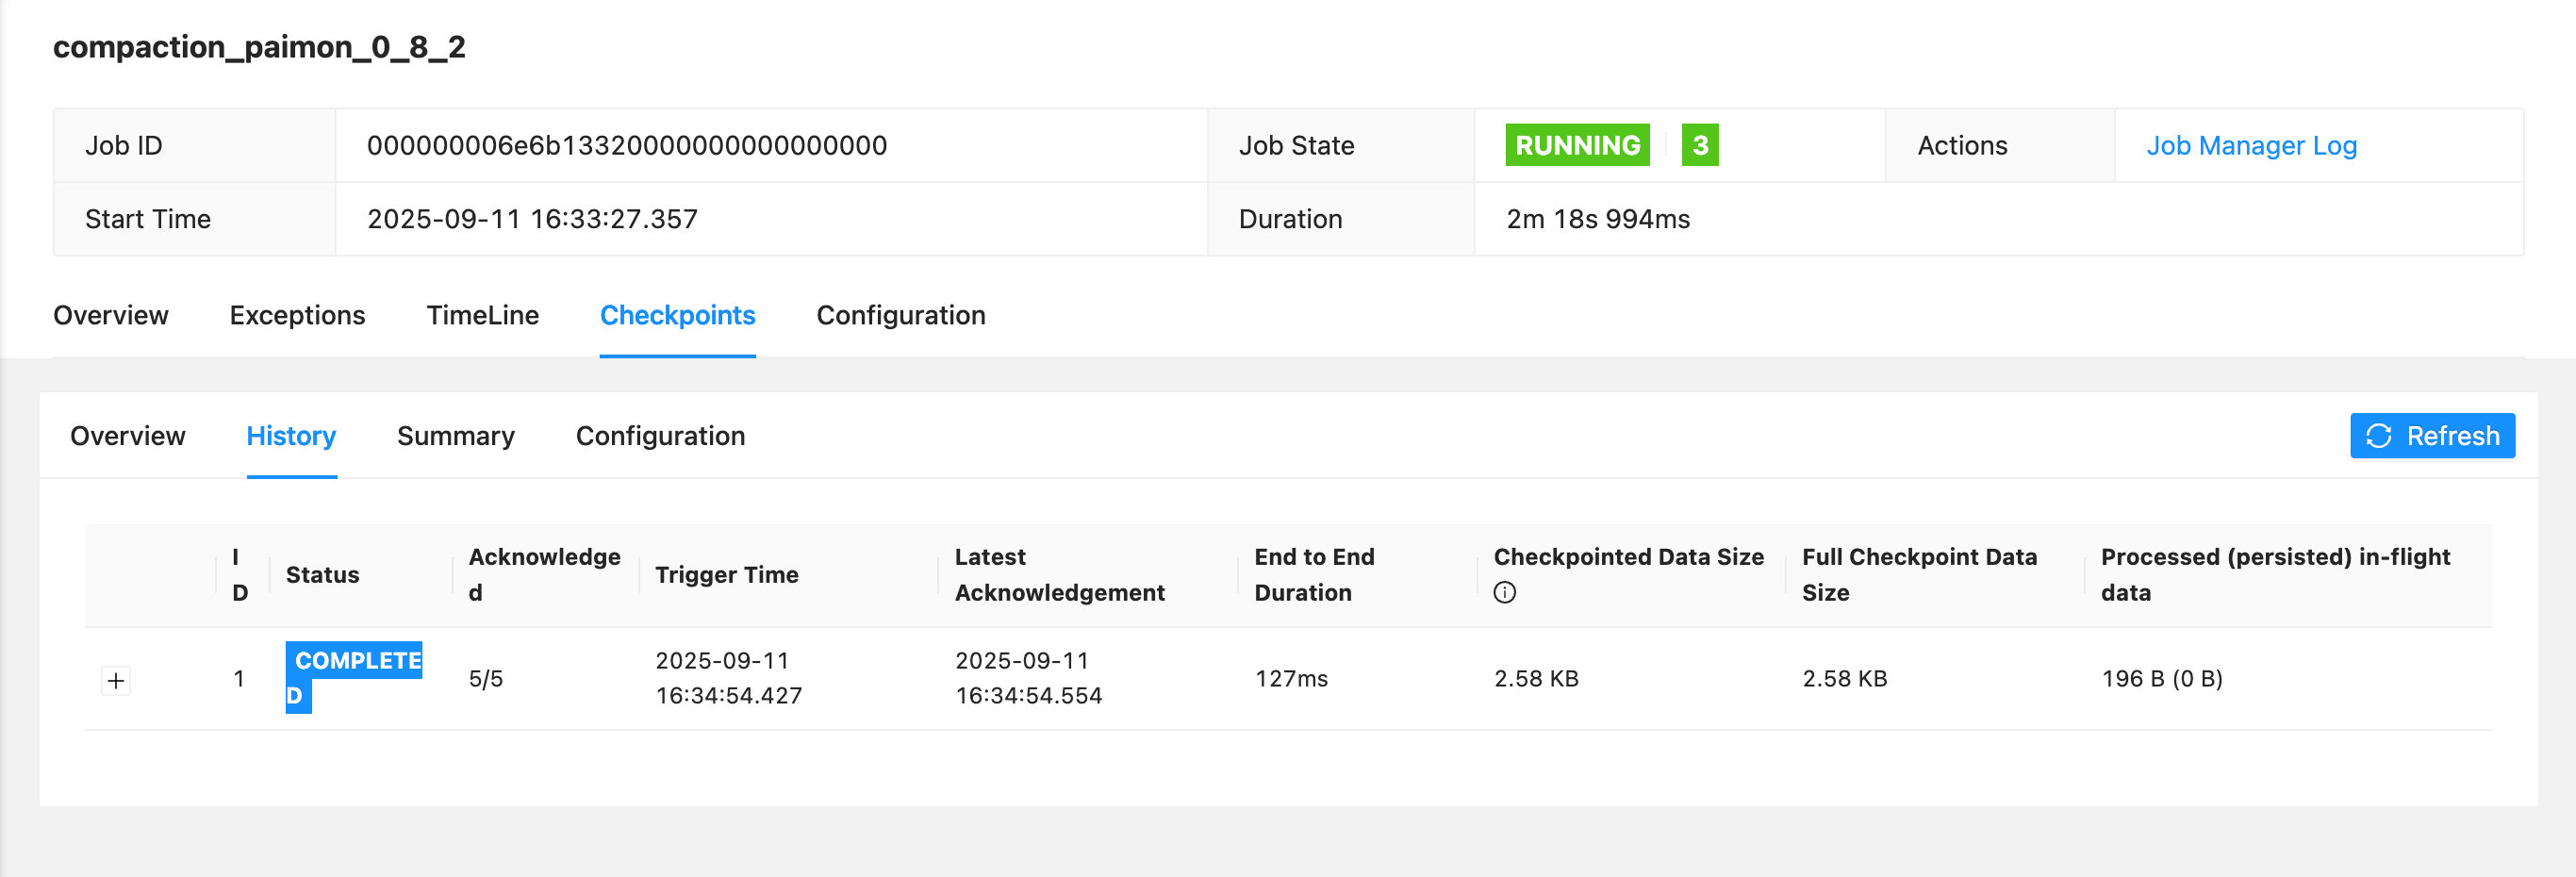
  1. Checkpoint 能够正常制作​
​​​
  1. 延迟情况可以查看作业列表的业务延迟;​
这里的延迟展示的是上游的写作业生成的文件在多久后被 Compaction 作业接收到并即将进行小文件合并;​
​​​
常见问题 Q & A​
Paimon 元数据使用 LAS 存储如何配置 ?​
  • 上传并且设置依赖的 LAS Connector 与 hive-site.xml 文件​
  • Compaction 作业除了上述的 Jar 包以外,需要依赖额外的 LAS Connector + hive-site.xml 文件配置上传, 参考如下:3.1 任务上传依赖文件​
Flink SQL 方案​
需要参考如下配置,增加 metastore 类型 hive 等配置参数:​
​
CREATE CATALOG paimon_catalog WITH (​
'type' = 'paimon',​
'metastore' = 'hive',​
-- uri 填写 LAS 的内网地址如下​
'hive-conf-dir' = '/opt/tiger/workdir',​
'warehouse' = 'tos://paimon-dedicated-compaction/filesystem_catalog'​
);​
​
USE CATALOG paimon_catalog;​
​
CALL sys.compact(​
'paimon_db.write_only_paimon_0_8_2_20250911', -- 表名, 格式为 db.table​
'', -- 分区(可选,不填则不限制分区)​
'', -- 排序策略(可选) ​
'', -- 排序字段(可选)​
'consumer.mode=at-least-once,consumer-id=your-consumer-id,sort-spill-threshold=5,num-sorted-run.stop-trigger=2147483647' -- 任务级新增表参数(可选)​
);​
​
Flink JAR 方案​
需要参考如下配置,增加 metastore 类型 hive 等配置参数:​
​
compact --warehouse tos://paimon-dedicated-compaction/filesystem_catalog --database paimon_db --table write_only_paimon_0_8_2_20250911 --table_conf consumer.mode=at-least-once --table_conf consumer-id=your-consumer-id --table_conf sort-spill-threshold=5 --table_conf num-sorted-run.stop-trigger=2147483647 --catalog_conf metastore=hive --catalog_conf hive-conf-dir=/opt/tiger/workdir ​
​
​
最近更新时间:2025.12.29 11:42:32
这个页面对您有帮助吗?
有用
有用
无用
无用