云数据库 veDB MySQL 版
云数据库 veDB MySQL 版


文档指南

请输入


- 文档首页
 云数据库 veDB MySQL 版用户指南veDB-SearchveDB-Search 介绍
 复制全文
 下载 pdf
veDB-Search 介绍
 文档反馈
 问问助手
veDB-Search 是基于云数据库 veDB MySQL 版和云搜索服务(Cloud Search),面向 AI 检索场景,联合打造的一款支持标量、向量、全文混合检索的混合检索服务。其内置 veDB MySQL 到 Cloud Search 之间的自动数据同步,可降低传统数据链路维护成本。在 AI 检索场景中,用户仅使用 SQL 即可实现向量 + 全文 + 标量数据的管理与混合检索,助力用户检索提效。用户可以基于 AI 向量检索等能力,构建智能推荐、RAG 知识库、Agent 记忆库等 AI infra 基础设施。
产品架构
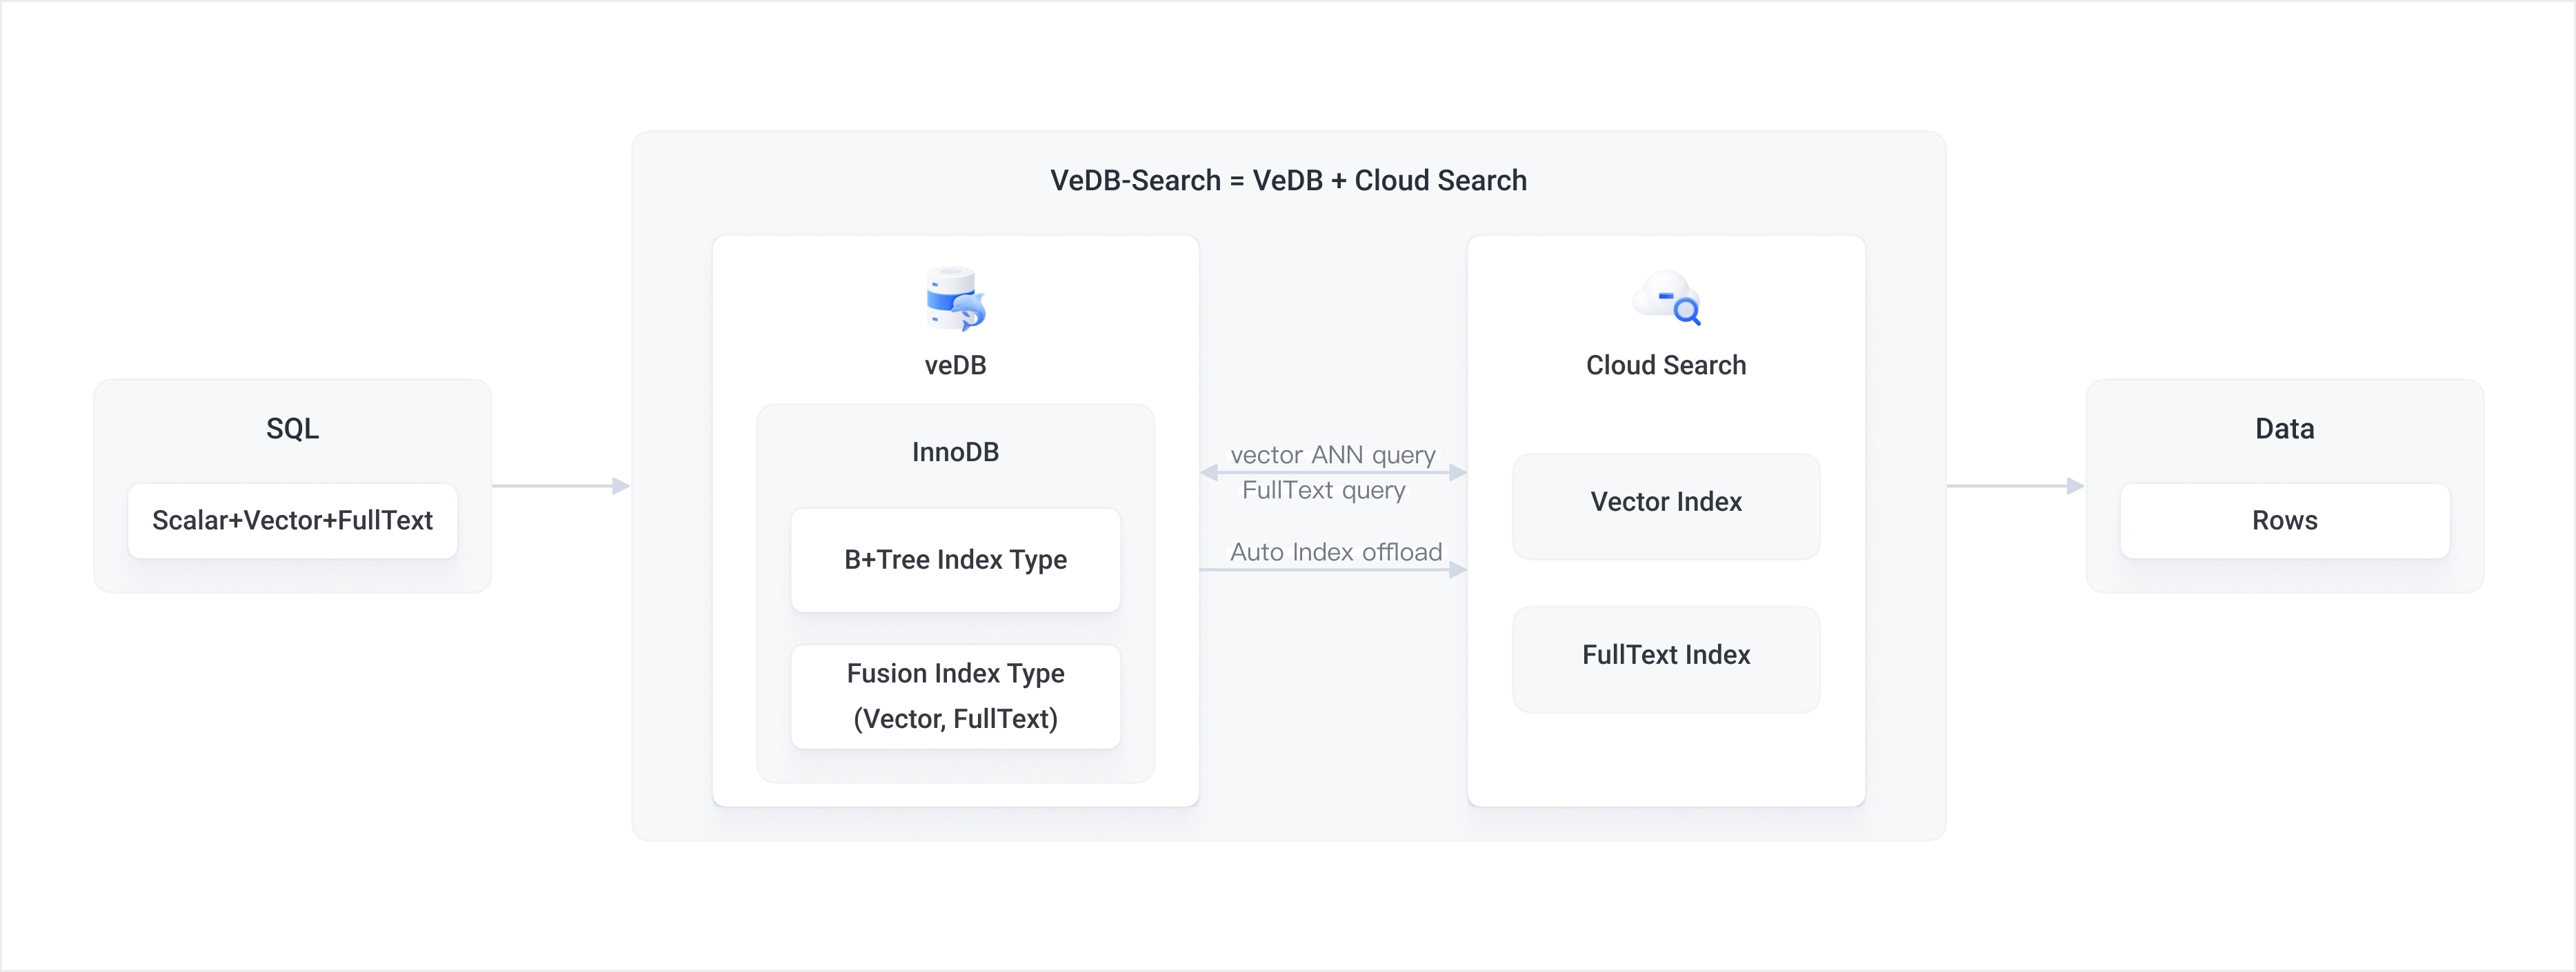
veDB-Search 基于分布式共享存储和云原生计算存储分离架构,深度融合自主研发的智能检索引擎和 Cloud Search,完全兼容 MySQL 语法,用户使用 SQL 即可完成纯标量谓词查询、纯向量 TopK 检索、标量 + 向量混合检索、标量 + 向量 + 全文混合检索、向量 + 全文多路召回的能力。
视频介绍
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
核心优势
- 内置数据同步
- 可通过执行 CREATE ANN INDEX 对 vector 或 text 列创建二级索引,系统会自动将索引数据同步至 Cloud Search。数据延迟通常处于百毫秒级别,全过程对用户透明,不需要用户自行构建数据同步链路。
- 智能检索引擎
- 直接执行 SQL 语句,优化器会判断查询条件是否涉及向量列或全文列,自动选择对应的索引。veDB MySQL 自动根据执行计划完成 ES 索引扫描和算子执行。如此一来,仅需使用 MySQL 协议即可实现向量、全文检索,极大地简化了开发复杂度。
- 具备极致性能与高性价比的向量数据库能力
- veDB-Search 通过将向量数据同步到 Cloud Search 中构建对应的向量索引,利用 Cloud Search 提供的 DiskkAN 算法和 RabitQ 量化机制,为用户提供海量、高召回率、低时延的向量检索能力。
适用场景
- 电商:基于用户兴趣向量和关键词搜索推荐商品。
- 知识库:实现 PDF、Word 等文档内容的全文检索与文档召回;图片特征向量化存储,支持相似图片搜索。
- Agent 记忆库
- 短期记忆:例如当前对话的上下文内容、会话上下文信息、临时变量等。
- 长期记忆:存储用户偏好、历史查询内容、大语言模型(LLM)参数等长期交互数据。
计费说明
使用 veDB-Search 功能,需要支付 veDB MySQL 实例和 ES 实例的费用。关于 veDB MySQL 实例和 ES 实例的计费项及价格,请参见 veDB MySQL 计费项与价格和 ES 计费项说明。
注意事项
使用说明
您可以按照以下步骤使用 veDB-Search 功能。
- 在创建 veDB MySQL 实例时,需选择具备 veDB-Search 功能的内核版本,即小版本选择 veDB MySQL 3.3。
- 开通 veDB-Search 功能,并绑定云搜索服务实例。
- 可以选择绑定与 veDB MySQL 实例相同地域下的存量云搜索服务实例,或创建新的云搜索服务实例进行绑定,详情请参见创建实例。
说明
仅支持绑定版本为 OpenSearch 2.9.0 的云搜索服务实例。OpenSearch 2.9 版本支持向量和文本混合搜索,支持 DiskANN 算法,AI 场景。
- 连接实例
最近更新时间:2025.10.17 14:22:42
这个页面对您有帮助吗?
有用
有用
无用
无用