You need to enable JavaScript to run this app.
文档中心
数据库传输服务

数据库传输服务

复制全文
下载 pdf
数据迁移最佳实践
MySQL 数据库双向同步
复制全文
下载 pdf
MySQL 数据库双向同步
数据传输服务 DTS 支持 MySQL 类型数据库双向同步。MySQL 类型数据库双向同步适用于异地多活(单元化)、数据异地容灾等多种应用场景。
双向同步拓扑
拓扑类型
拓扑图
特点
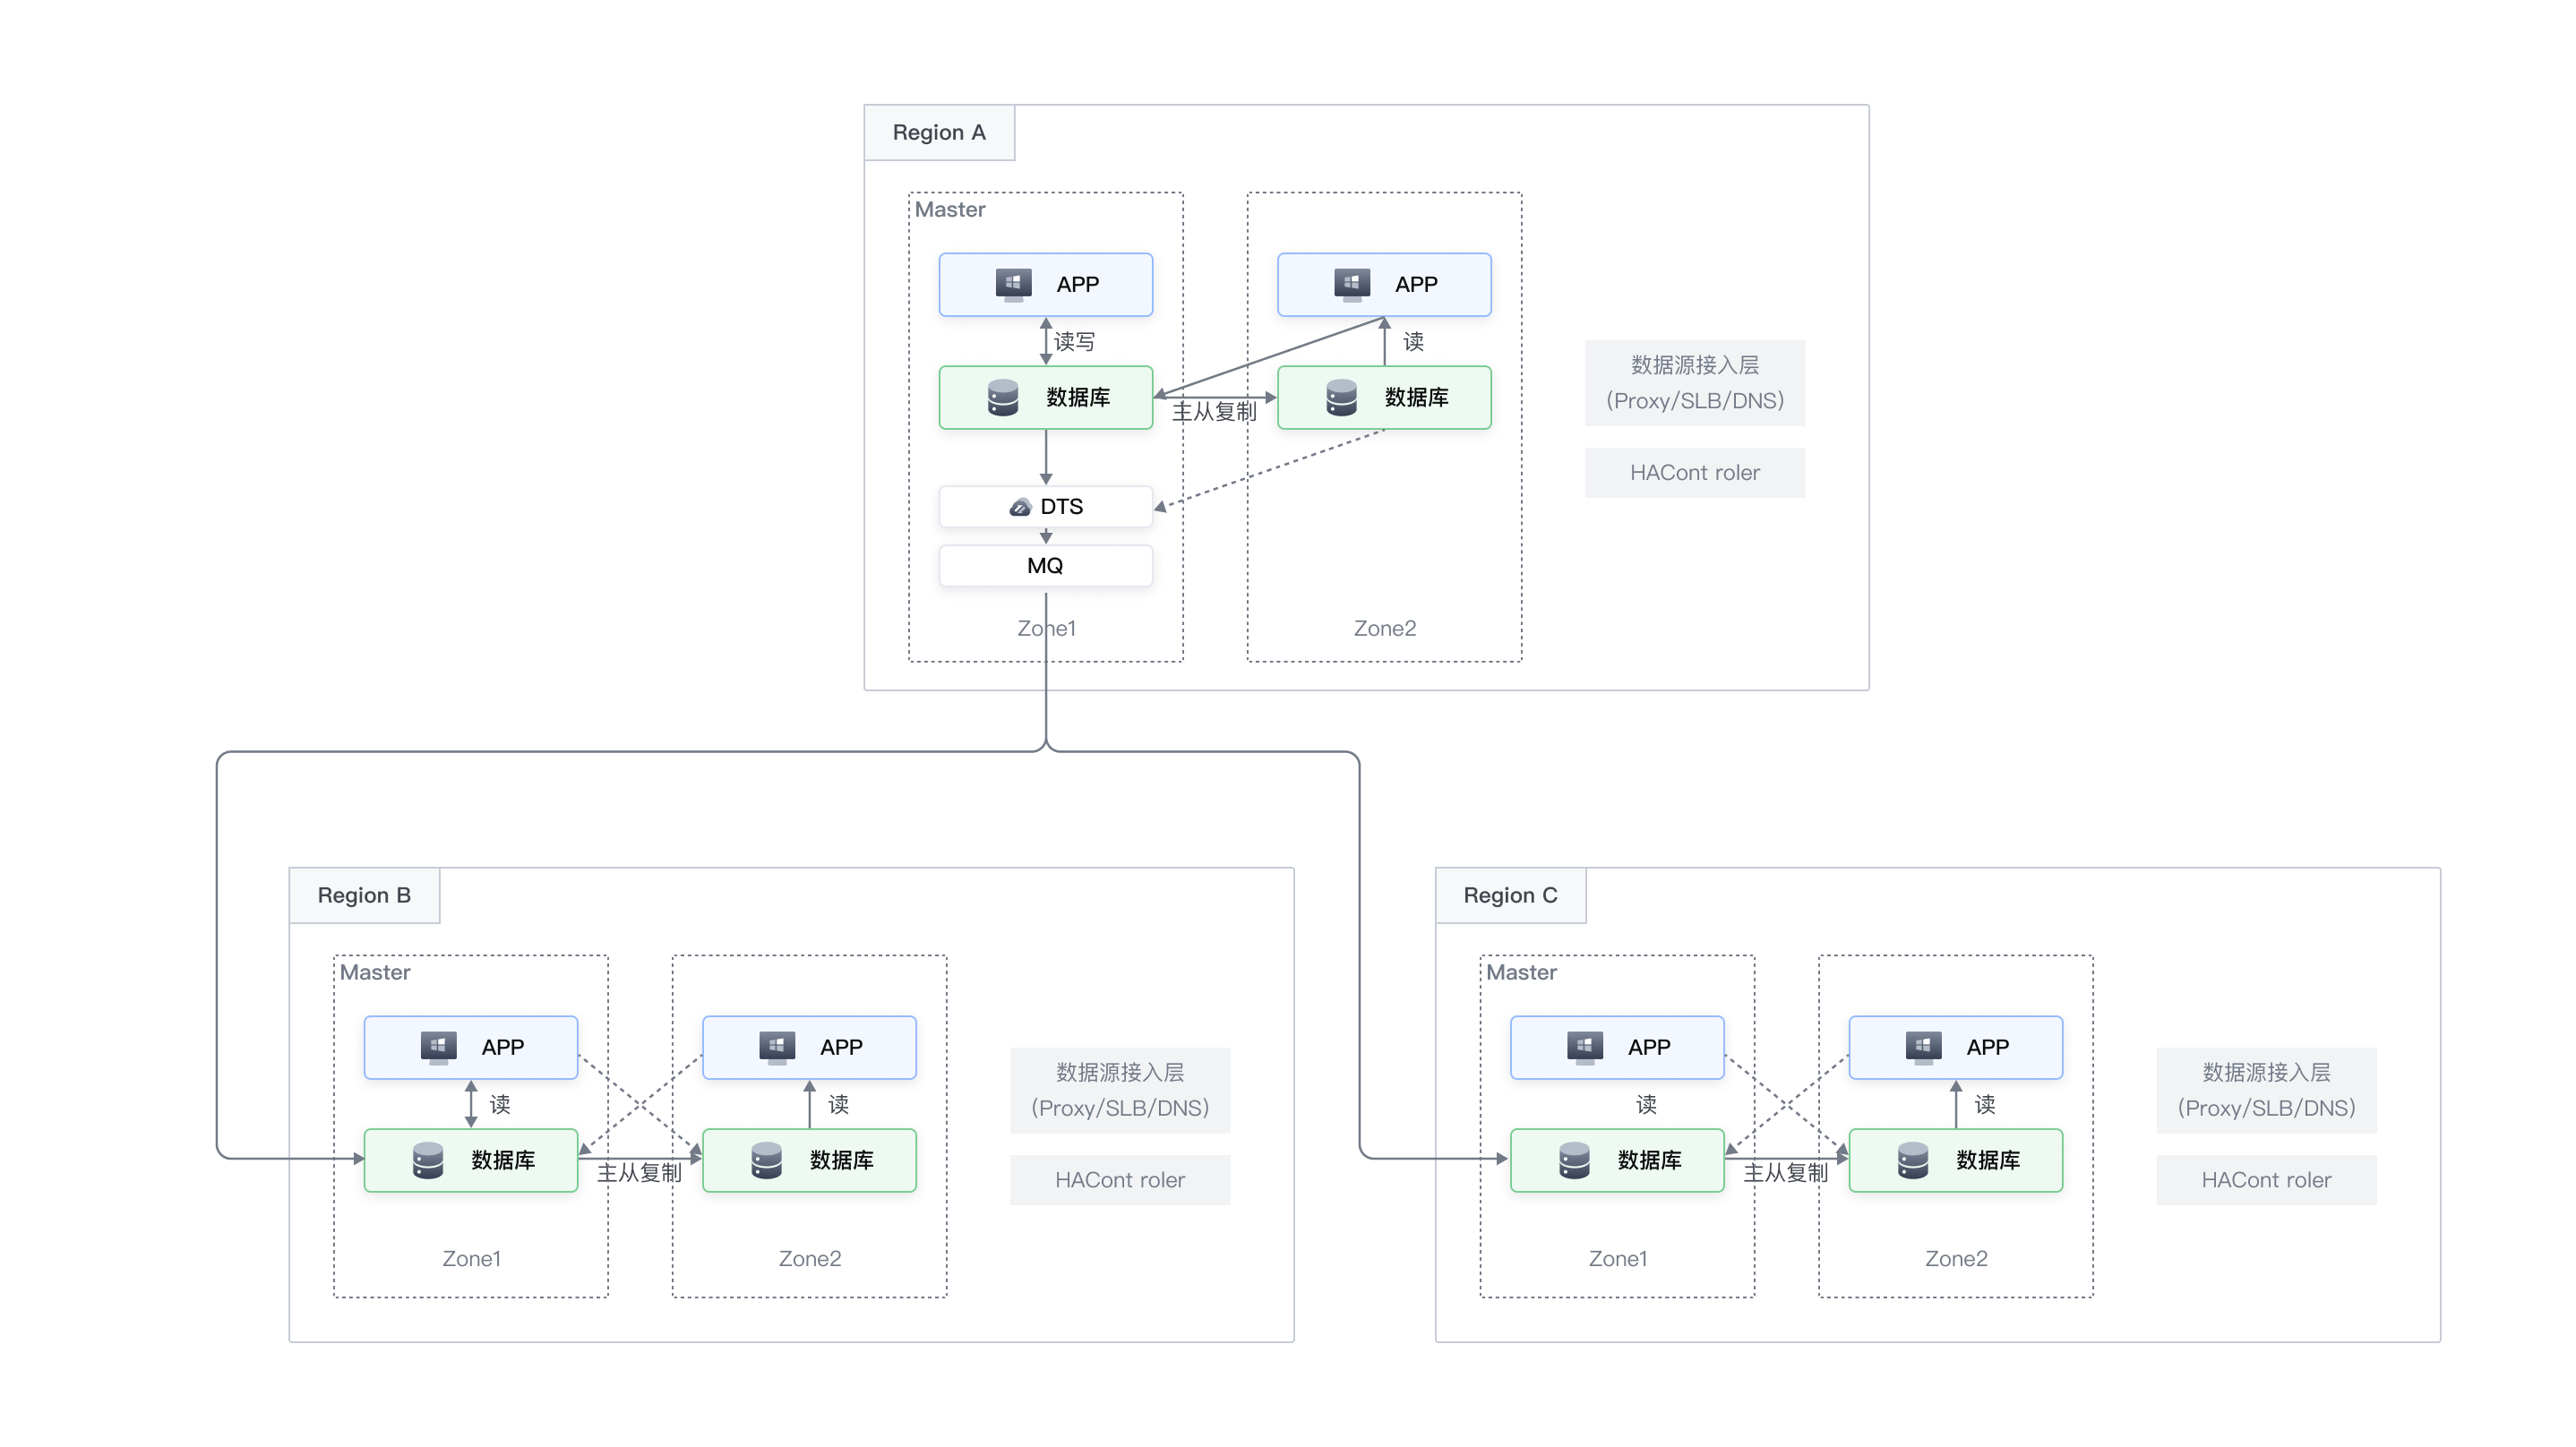
单写多读
单写多读架构的主要特点如下。
  • 主地域负责写入服务,并将写入数据通过以异步方式同步到其他从地域。
  • 从地域提供读取服务。如果从地域有数据需要写入,则需通过主地域写入。
  • 单写多读架构不适合对读写敏感度较高的业务。跨 Region 数据传输面临的问题和影响因素较多,容易产生时延;对数据读取一致性要求较高的业务,建议构建跨域回访主地域机制。
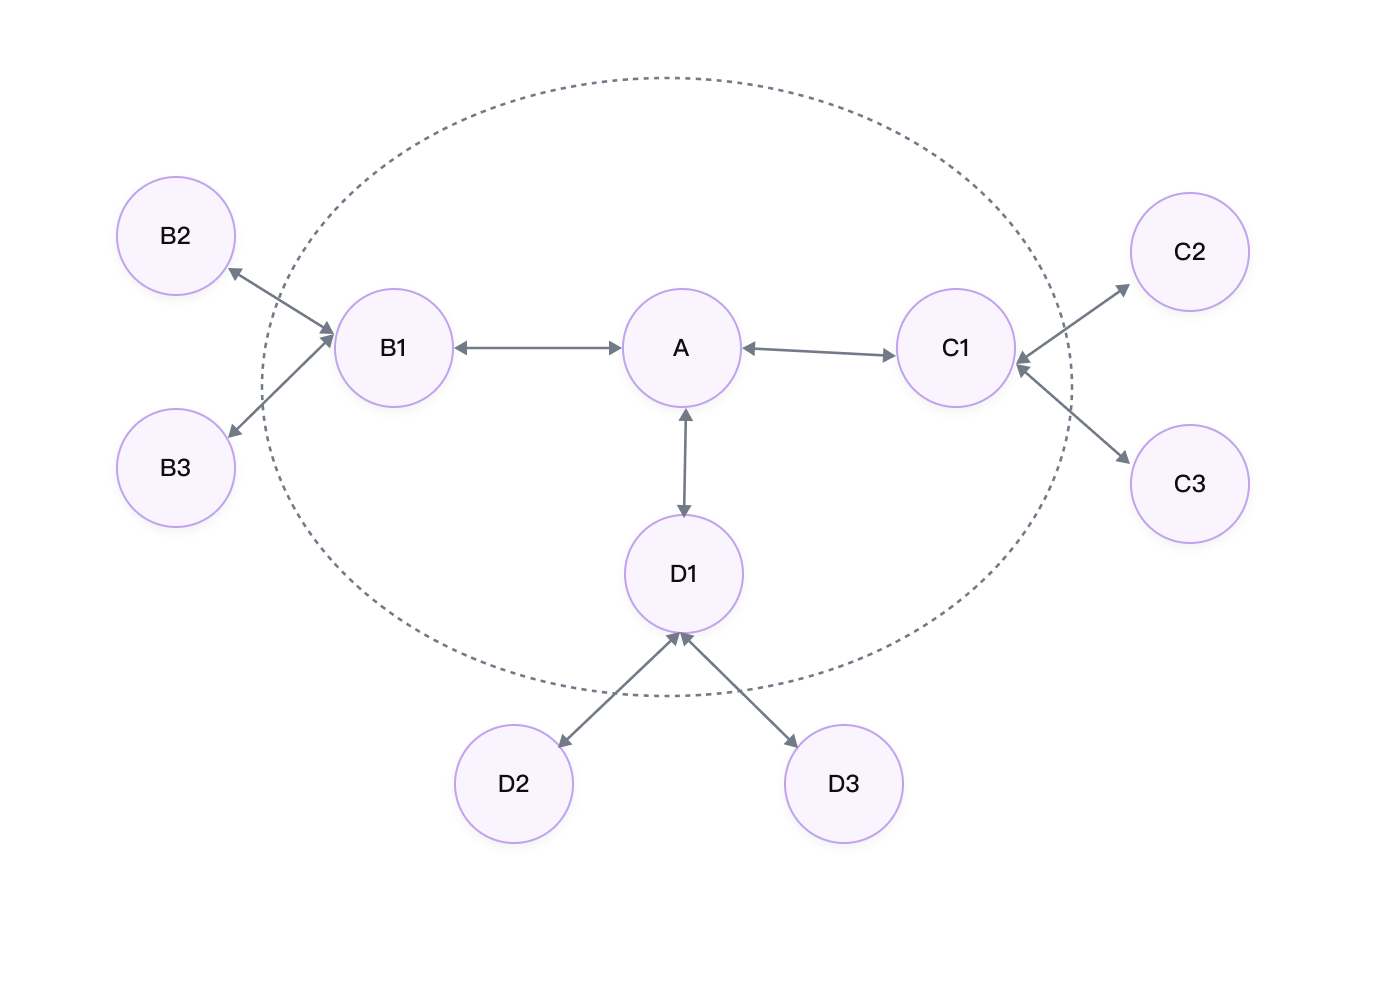
多写多读
多写多读架构的主要特点如下。
  • 支持多地域写入,借助数据同步拓扑链路进行逐级同步。
数据整体时延与拓扑结构复杂度有关,拓扑结构越复杂,时延越大。
  • 采用单元化读写模式。在一般场景中,业务会在本地域进行读写操作,单元模块内实现读写闭环。为避免本地域写入后跨地域读取的情况,其他地域更新的数据将通过同步链路同步至关联地域。
  • 业务端需按照特定规则(例如用户 ID 分布)将流量分配至不同地域。应避免在多个地域对同一元素进行更新,访问同一元素需路由至对应单元。
说明
多写多读拓扑需对业务做单元化改造,更多信息,请参考业务单元化拆分
冲突处理策略
冲突处理策略
说明
推荐程度
冲突覆盖
当源端数据与目标端数据冲突时,源端的数据会覆盖目标端的数据。
说明
在大多数情况下,选择冲突覆盖得到的数据是业务想要的数据,但也有特殊情况。比如在 A 和 B 双向同步的场景中,如果 A 写入数据的时间是 t1,B 写入数据的时间是 t2(t1 比 t2 晚),在 A 的反向链路场景里,B 的数据传到A 这边时,就会把 A 在 t1 时刻后写入的数据覆盖掉。
优先推荐
冲突忽略
当源端数据与目标端数据冲突时,忽略冲突,源端数据与目标端各自写入数据。
说明
冲突忽略会造成源端和目标端的数据不一致。
不推荐
冲突报错
当源端数据与目标端数据冲突时,需手动修改冲突数据,否则同步任务会暂停并且报错。
说明
  • 当出现数据冲突时,将暂停数据同步。待手动解决冲突数据,并且业务校验通过后,才可以继续迁移或同步任务。
  • 此种场景下的可以保障数据的一致性,但会出现任务暂停,假设某端极端场景下出现事故,后续所有数据无法访问的问题。
仅测试环境中推荐
双向同步流程
创建 MySQL 双向同步任务
注意事项
  • 在双向同步 MySQL 时,请勿同时在源端和目标端做 DDL 操作,否则可能会导致同步任务失败。双向同步任务仅支持将正向任务的 DDL 操作同步到目标库,暂不支持同步反向任务的 DDL。如果需要同步反向任务的 DDL 操作,可以先调整双向同步任务的 DDL 同步方向,然后再执行 DDL 操作,以确保数据的一致性。
  • 为保障数据一致性,建议存在同主键值的行只在一个实例中更新。如果同时更新,则会按照配置数据同步任务时选择的主键冲突处理方法进行处理。
  • 当执行 OnlineDDL 时,需保证向前兼容,比如不能修改字段类型、不能删减字段等,否则可能会出现同步断流或数据不一致。表结构向前兼容 DDL 列表:create table、add column、modify column(增加字段长度)、create index、 drop index。
  • 不建议使用公网进行双向同步,因为公共网络容易出现性能瓶颈。
步骤一:创建同步任务
您可以根据您的数据库源库类型和目标库类型,选择对应的参考文档,创建数据同步任务。
在创建双向同步任务时,同步拓扑选择双向同步,更多信息请参见数据同步拓扑
源库类型
源库版本
同步类型
目标库类型
配置文档
火山引擎版 MySQL
  • MySQL 5.7
  • MySQL 8.0
  • 全量初始化
  • 增量同步
  • 结构初始化
MySQL
火山引擎版 veDB MySQL
MySQL 8.0
MySQL
公有网络 MySQL
  • MySQL 5.5
  • MySQL 5.6
  • MySQL 5.7
  • MySQL 8.0
MySQL
专有网络 MySQL
  • MySQL 5.6
  • MySQL 5.7
  • MySQL 8.0
MySQL
步骤二:配置正向同步
双向同步任务创建完成后,您可以通过 DTS 配置数据正向同步任务,更多信息请参见配置正向同步
步骤三:配置反向同步
当正向同步任务进入增量同步阶段后,您可以配置反向同步任务。配置方法,请参见配置反向同步
切流
  1. 在所有的切流之前,都应建好双边链路。请勿在切流时启停、创建 DTS 链路,否则会增加切流复杂度,使切流过程不可控。
  1. 切流启动时,触发源端 DB 禁写,避免同一时刻链路两端均有业务写入。
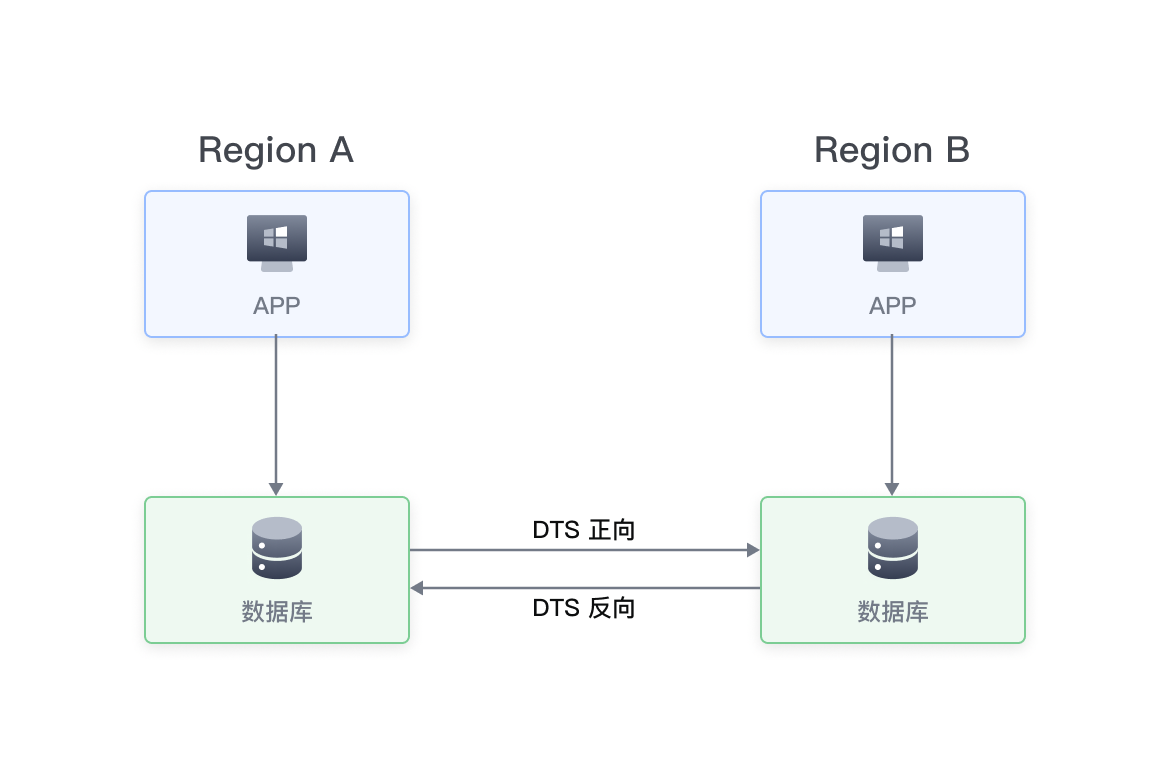
单向切流
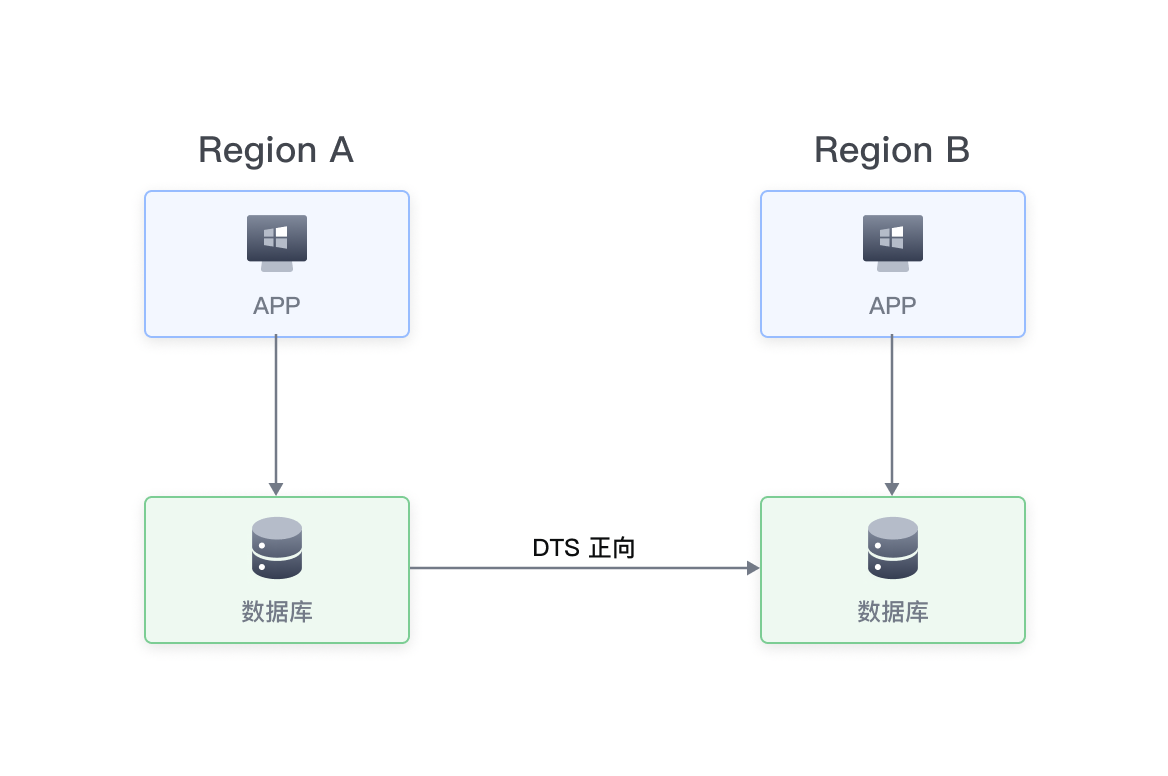
正常切流流程
异常切流流程
  1. 确认 DTS 延时在 1 秒内。
  1. 禁止源端 DB 写入,确认 DTS 无延时。
  1. 开放目标端 DB 业务写入。
  1. 根据 DTS 延时,决策是否切流(保可用性,还是接受少量数据不一致)。
  1. 开放目标端 DB 业务写入。
双向切流
正常切流流程
异常切流流程
  1. 确认 DTS 延时在 1 秒内。
  1. 禁止源端 DB 写入,确认 DTS 无延时。
  1. 开放目标端 DB 业务写入。
  1. 对于双向同步,按用户分批切流(双写一般是按用户切流,确保同一用户不会同时在两边写入)。
  1. 关闭用户在源端的流量写入路由(用户写入会短暂失败)。
  1. 等待几秒钟,等待时间大于 DTS 延时时间。
  1. 将用户在源端的流量路由更改到目标 DB。
  1. 发生故障
  • A 地域网络异常或机房故障,导致 A 地域少量堆积数据未同步到 B 地域。
  • 源端机房业务流量下跌,未必跌 0。
  1. 判断是否需要切流
  1. 检测 DTS 延时,DTS 返回断网时刻的延时状态。
  1. 根据延时状态判断是否堆积过多数据,并决策是否应急切流。
  1. 切流流程
  1. 禁止源端 DB 写入。如果网络不通,导致禁止源端 DB 写入失败,则可以考虑跳过这一步(此时业务也无法写入)。
  1. 对目标端的部分应用开启应用禁写,比如锁单:在 A 地域创建的订单,在切流后避免在 B 地域产生重复付款动作、重复发货动作。
  1. 切写到 B 地域。
  1. 检查 B 地域应用水位和业务成功率,并判断是否恢复。
附录
业务单元化拆分
所谓单元化,是指将业务依据特定维度划分为若干小型业务单元,单元内部涵盖业务所需的全部服务,并能够独立处理整个业务流程。每个单元仅存储部分数据,所有单元的数据整合后构成完整数据。“单元”可作为相对独立的整体进行迁移,也可将部分单元部署至异地。
  • 业务单元化拆分,应遵循以下原则,以避免数据冲突。
  • 禁止使用数据库自增 ID,应采用第三方 ID 生成器。
  • 应确保各业务单元的数据相互独立,尽量不存在交集。
  • 双向链路应从两端的读写节点建立,此举可能会影响业务的读写性能。
业务单元化拆分背景
现有痛点
业务单元化改造后
数据库连接瓶颈
数据库连接属于极为宝贵的资源。业务单元化改造后,每个单元内的数据读写都是内网自闭环,这样能够减少数据库连接。
机房延时
如果单元化做的比较好,即业务只会在单元内访问自己。每个单元内的数据读写都是内网自闭环,无跨机房调用。
流量入口
用户通过路由网关,每次都会请求到自己所在单元的数据中心。比如用户在 A 中心,单元化后,用户 A 的请求都会路由到 A 中心,不会路由到 B 中心。从入口流量到分布式服务,全链路消除了单点。
数据冲突
将用户按某个规则进行分组,每组用户写入数据时只能写入到指定的数据中心,相当于将用户与数据中心进行绑定,这样就保证了在双向同步之前不同用户组的数据不会冲突。
业务单元化拆分方案
拆分方案
业务场景
业务单元化分析
方案一
某客户是物流供应商,提供淘宝、京东等多个电商平台的物流服务,其业务关键表订单表概要字段如下所示。
  • 订单 ID(OrderID)
  • 订单来源(Platform)
  • 物流地址(Address)
客户在数据库 A 中存储来自淘宝的订单,在数据库 B 中存储来自京东的订单,此时可针对数据库 A 和 B 构建一条双向同步链路。由于淘宝端的订单变更(INSERT/UPDATE/DELETE)仅源自数据库 A,京东端的订单变更(INSERT/UPDATE/DELETE)仅源自数据库 B,数据依据“订单来源”进行天然分区,不会引发数据冲突。
方案二
某客户是 C 端运动 App,由于用户量巨大,客户使用了数据库 A、B 来存储用户数据,其 User 表关键字段如下所示。
  • 用户 ID(UserID)
  • 用户信息(UserInfo)
  • UserID 为 32 位字符串(仅含小写字母),客户在其用户流量入口进行了写分区操作,若 UserID 以 a ~ n 开头,则写入库 A;若以 o ~ z开头,则写入库 B。此时可建立双向同步链路,确保从数据库 A 或数据库 B 中均可读取到全量用户数据。
  • 鉴于以 a ~ n 开头的用户数据仅会写入库 A,以 o ~ z 开头的用户数据仅会写入库 B,因此该双向同步链路不会出现数据冲突。
方案三
某客户是国际化 B 端 Saas 提供商,国内租户数据写入 CN 库,国外租户数据写入 US 库,其租户表大致如下所示。
  • 租户 ID(TenantID)
  • 租户名(TenantName)
  • 租户数据(Data)
  • 客户可使用 DTS 构建 CN 与 US 之间的双向同步链路,确保从任意一个库读取数据时均可获取全量数据,即读操作获取全量数据,写操作进行区分。
  • 鉴于数据写入完全依据租户 ID 分区至 CN 或 US,因此不会产生冲突。
最近更新时间:2026.01.27 19:47:53
这个页面对您有帮助吗?
有用
有用
无用
无用