E-MapReduce
E-MapReduce


Serverless 队列

请输入


- 文档首页
 E-MapReduceEMR Serverless 队列最佳实践Spark在 EMR Serverless Spark 运行 TPC-DS Benchmark
 复制全文
 下载 pdf
在 EMR Serverless Spark 运行 TPC-DS Benchmark
 文档反馈
 问问助手
背景信息
TPC-DS(Transaction Processing Performance Council Decision Support Benchmark)是一个以决策支持为重点的基准测试,旨在评估数据仓库和分析系统的性能。它是由 TPC(Transaction Processing Performance Council)组织开发的,用于比较不同系统在处理复杂查询和大规模数据分析方面的能力。
TPC-DS 的设计目标是模拟现实世界中的复杂决策支持工作负载。它通过一系列复杂的查询和数据操作来测试系统的性能,包括联接、聚合、排序、过滤、子查询等。这些查询模式涵盖了从简单到复杂的各种场景,如报表生成、数据挖掘、OLAP(联机分析处理)等。
本文档主要介绍 EMR Serverless Spark 在 TPC-DS 1TB 规模上的测试结果,包含标准测试数据集上的 99 个查询耗时。
前提条件
- 已安装 Spark-Submit 工具,详细操作请参考:Spark-submit 工具使用说明。
- 已开通 EMR Serverless 服务,详细操作请参考:EMR Serverless 快速入门。
- 已开通 AI 数据湖服务和对象存储 TOS服务 。
- 下载如下 TPC-DS Benchmark 工具包,下载之后将工具包上传到您的TOS中的tos://{bucket-path}/tpcds/tools路径下。
操作流程
步骤一:数据处理
生成并加载数据
- 使用如下命令在本地执行脚本。
spark-submit --name make_tpcds_data --archives tos://{bucket-path}/tpcds/tools/tpcds-kit.zip#tpcds-kit --conf spark.driver.userClassPathFirst=false --conf spark.executor.userClassPathFirst=false --conf spark.sql.parquet.compression.codec=zstd --conf spark.other-config.xxxx=xxxx --class com.databricks.spark.sql.perf.tpcds.GenTPCDSData tos://{bucket-path}/tpcds/tools/spark-sql-perf-assembly.jar --location tos://{bucket-path}/tpcds/tpcds_1000_parquet_zstd --scaleFactor 1000 --dsdgenDir ./tpcds-kit/tools --format parquet --useDoubleForDecimal false --useStringForDate false --overwrite true --master k8s --numPartitions 128
- 使用命令中关键参数说明:
参数名称 | 含义 |
--location | 生成的数据在HDFS/对象存储上的目录 |
--scaleFactor | 数据规模,单位G,1000代表1000G |
--format | 数据存储格式,推荐 parquet |
--queue | (可选)指定使用的队列,默认使用公共队列 |
spark.sql.parquet.compression.codec | 数据压缩格式,推荐 zstd |
如下是生成1TB数据的示例参数:
Spark参数:
{
"spark.driver.userClassPathFirst": "false",
"spark.executor.userClassPathFirst": "false",
"las.spark.jar.depend.archives": "[{\"fileName\":\"tos://ceshi/tpcds/tools/tpcds-kit.zip#tpcds-kit\"}]",
"serverless.spark.secret.key": "xxxxxxxxxxxxxxx",
"serverless.spark.access.key": "xxxxxxxxxxxxxxx",
"spark.dynamicAllocation.maxExecutors": "100",
"spark.sql.parquet.compression.codec": "zstd",
}
程序自定义参数:
--location tos://ceshi/tpcds/tpcds_1000_parquet_zstd --scaleFactor 1000 --dsdgenDir ./tpcds-kit/tools --format parquet --useDoubleForDecimal false --useStringForDate false --overwrite true --master k8s --numPartitions 128
建表
说明
通过如下脚本会自动创建数据库和表,请勿提前创建数据库。
使用生成的数据创建hive表,并且刷新分区,spark-submit 命令如下:
spark-submit --name create_table --archives tos://{bucket-path}/tpcds/tools/tpcds-kit.zip#tpcds-kit --conf spark.driver.userClassPathFirst=false --conf spark.executor.userClassPathFirst=false --conf spark.sql.parquet.compression.codec=zstd --conf spark.other-config.xxxx=xxxx --class com.databricks.spark.sql.perf.RegisterTables tos://{bucket-path}/tpcds/tools/spark-sql-perf-assembly.jar --location tos://{bucket-path}/tpcds/tpcds_1000_parquet_zstd --scaleFactor 1000 --dsdgenDir ./tpcds-kit/tools --format parquet --useDoubleForDecimal false --useStringForDate false --overwrite true --master k8s --numPartitions 128 --database tpcds_1000_parquet_zstd
关键参数说明:
参数名称 | 含义 |
--location | 生成的数据在HDFS/对象存储上的目录 |
--database | 数据库名称 |
如下是在数据库tpcds_1000_parquet_zstd生成表的示例参数:
Spark参数:
{
"spark.driver.userClassPathFirst": "false",
"spark.executor.userClassPathFirst": "false",
"las.spark.jar.depend.archives": "[{\"fileName\":\"tos://ceshi/tpcds/tools/tpcds-kit.zip#tpcds-kit\"}]",
"serverless.spark.secret.key": "xxxxxxxxxxxxxxxxx",
"serverless.spark.access.key": "xxxxxxxxxxxxxxxxx"
}
程序自定义参数:
--location tos://ceshi/tpcds/tpcds_1000_parquet_zstd --database tpcds_1000_parquet_zstd
获取表统计信息
推荐使用ANALYZE TABLE命令获取Hive表统计信息,可以加快后续SQL的查询速度。
set tqs.query.engine.type = sparkcli;
use tpcds_1000_parquet_zstd;
ANALYZE TABLE call_center COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE catalog_page COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE catalog_returns COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE catalog_sales COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE customer COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE customer_address COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE customer_demographics COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE date_dim COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE household_demographics COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE income_band COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE inventory COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE item COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE promotion COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE reason COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE ship_mode COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE store COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE store_returns COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE store_sales COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE time_dim COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE warehouse COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE web_page COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE web_returns COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE web_sales COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE web_site COMPUTE STATISTICS FOR ALL COLUMNS;
ANALYZE TABLE catalog_returns PARTITION (cr_returned_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE catalog_sales PARTITION (cs_sold_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE inventory PARTITION (inv_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE store_returns PARTITION (sr_returned_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE store_sales PARTITION (ss_sold_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE web_returns PARTITION (wr_returned_date_sk) COMPUTE STATISTICS;
ANALYZE TABLE web_sales PARTITION (ws_sold_date_sk) COMPUTE STATISTICS;
步骤二:执行 TPC-DS 查询数据
spark-submit --name run_tpcds_benchmark --conf spark.driver.userClassPathFirst=false --conf spark.executor.userClassPathFirst=false --conf spark.otherconfig.xxxx=xxxx --class com.bytedance.emr.spark.SparkSqlTpcds tos://{bucket-path}/tpcds/tools/playground-1.0-SNAPSHOT.jar --resultFilePrefix tos://{bucket-path}/tpcds/results/SPARK-TPCDS-1T-128CU --database tpcds_1000_parquet_zstd --rounds 1
关键参数说明:
参数名称 | 含义 |
--resultFilePrefix | 生成的tpcds测试报告结果存储的路径前缀 |
--database | 数据库名称 |
--rounds | 测试轮次 |
--sqls | 自定义指定多个sql,用&分割,不设置默认跑全部sql,如:q1.sql&q3.sql |
如下是用128CU运行的示例参数:
Spark参数:
{
"serverless.spark.secret.key": "xxxxxxxxxxxxxxxxx",
"serverless.spark.access.key": "xxxxxxxxxxxxxxxxx",
"spark.executor.instances": "32",
"spark.dynamicAllocation.enabled": "false",
"spark.executor.cores": "4",
"spark.executor.memory": "12g",
"spark.executor.memoryOverhead": "4g"
}
如果用Native Engine的话需要额外添加如下配置(注意Java跑不要添加):
{
"emr.serverless.bolt.enabled": "true"
}
程序自定义参数:
--resultFilePrefix tos://ceshi/tpcds/results/SPARK-TPCDS-1T-128CU --database tpcds_1000_parquet_zstd --rounds 3
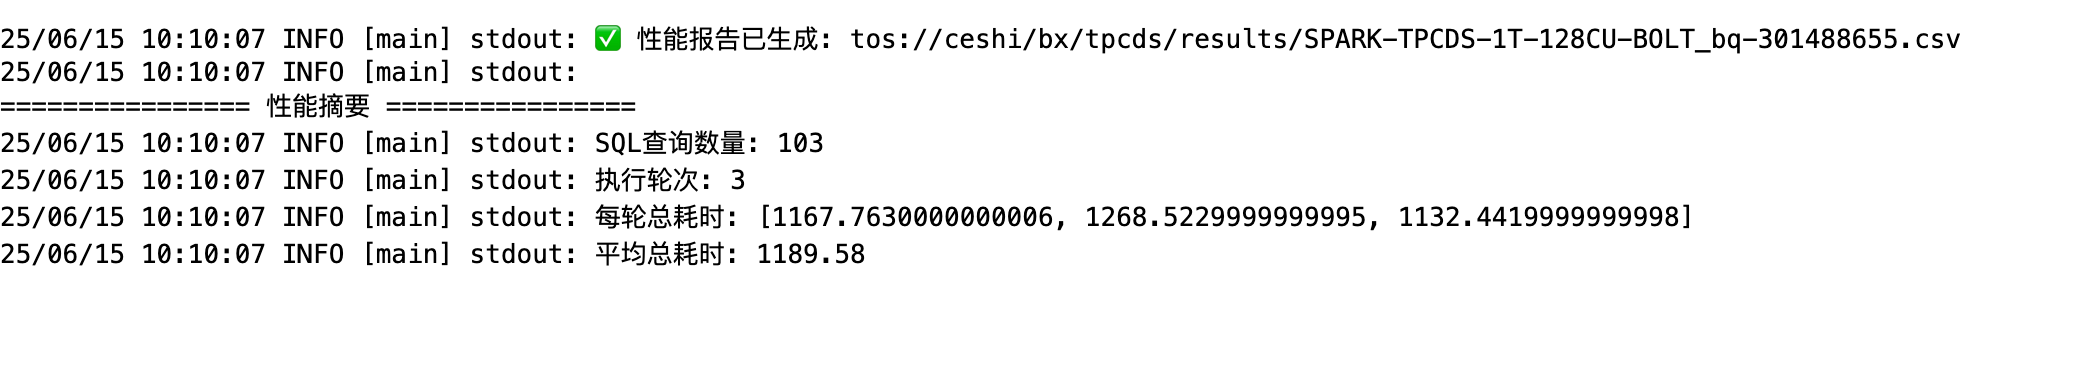
测试结果获取
测试结果可查看日志:
最近更新时间:2026.02.09 18:26:30
这个页面对您有帮助吗?
有用
有用
无用
无用