智能视觉服务
智能视觉服务


文档指南

请输入


- 文档首页
 智能视觉服务炉米LUMI用户指南LoRA模型训练Seedance LoRA训练
 复制全文
 下载 pdf
Seedance LoRA训练
 文档反馈
 问问助手
上新:Seedance mini1.0上新 t2v LoRA训练!
Seedance mini1.0 t2v[新]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
Seedance 1.0 i2v
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
T2V任务适用模型 | I2V任务适用模型 | 首尾帧任务适用模型 |
[上新]Seedance mini t2v 1.0 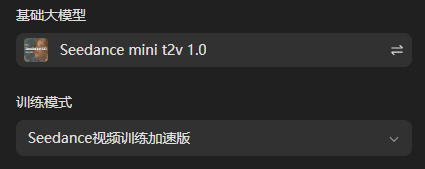 |
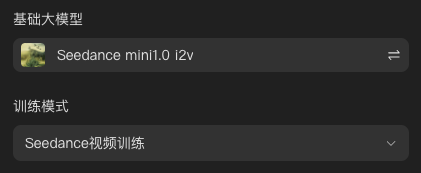
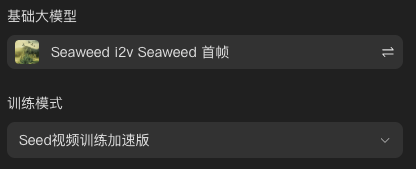 |
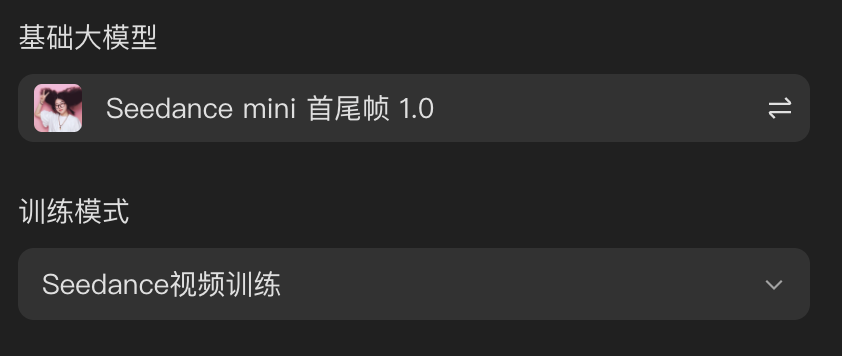
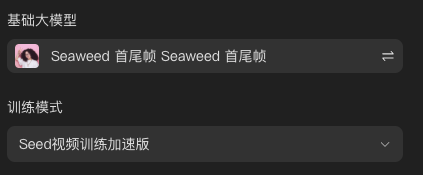 |
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
- LoRA训练
目前,视频LoRA主要支持T2V、I2V和首尾帧任务。可用于特定真实行为(如拥抱、贴贴、亲脸)或者特定变化(如捏扁、膨胀、变身、换装等)的学习。对于T2V、I2V和首尾帧这两种视频LoRA,首尾帧LoRA稳定性更高,训练起来更加容易,在尾帧可以通过图像算法生成的情况下,尽量构造首尾帧任务用于视频LoRA的训练。
- T2V:在应用层面,用户输入文字,模型根据文字描述生成视频
- I2V:在应用层中,用户输入图片,将用户输入图给模型生成变化
- 首尾帧:学习首帧到尾帧的变化,首尾帧的差异尽可能大。在应用层中,用户输入首帧,底层可调用seededit等模型生成尾帧,最后将首尾帧一起输入给模型
功能教程
视频LoRA训练主要包含训练集收集、训练集前处理、文本打标、设置LoRA训练参数四个步骤,前三个步骤对于目标效果起决定性作用。
训练集
视频通用训练素材集「收集方式与标准」
素材标准
- 变化过程必须符合目标效果定义,且尽可能统一,如差别较大,需分类后打标
- 对于首尾帧任务,需要保证尾帧样式和目标尾帧基本一致
- 覆盖场景尽可能丰富,如人像、宠物、风景、近景、远景、特写等
- 视频长度小于或者等于期望生成效果的目标长度
- 分辨率越高越好,长宽比多样性越强越好
- 素材量在保证符合以上标准的情况下越多越好,一般要求大于40条
训练参数
参数名称 | 对应图 |
Save_every_n_steps(每N steps自动保存一次模型): 小素材集一般设置为1000-1500左右,大素材集一般设置为2000-2500左右,控制模型的中间状态(ckpt)的保存频率 | 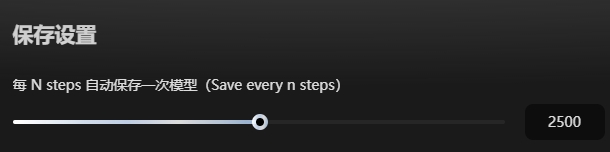 |
max_train_steps(训练轮次): 一般设置为20000-40000左右,在20000左右就会有不错效果,可以用于前期效果迭代,终版可以迭代更多步数,挑选最优迭代次数 | 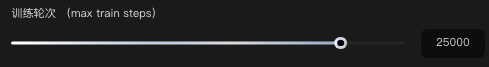 |
network_dim(网络维度):一般设置为64-192,复杂任务增大network_dim,想要过拟合增大network_dim | 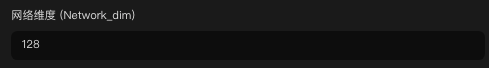 |
learning rate(学习率):一般设置为0.00001-0.0001,可以根据训练任务的难度等进行调整 |  |
分辨率:主要影响训练速度,建议采用480P训练,暂不支持480p以上的高分辨率训练。目前上线效果均采用480P推理。 |  |
视频总帧数:视频的总帧数,5S的视频对应121帧,3S的视频对应73帧 |  |
视频切片帧数:从训练视频中切片的长度,数值需要<=视频总帧数的数值,一般视频切片帧数=视频总帧数 |  |
最近更新时间:2025.08.05 12:20:21
这个页面对您有帮助吗?
有用
有用
无用
无用