图像生成大模型
图像生成大模型


文档指南

请输入


- 文档首页
 图像生成大模型SaaS应用炉米LUMI用户指南LoRA模型训练SeedEdit图像编辑LoRA训练
 复制全文
 下载 pdf
SeedEdit图像编辑LoRA训练
 文档反馈
 问问助手
使用方式
- 基础文生图
- 选择模型,输入prompt指令即可
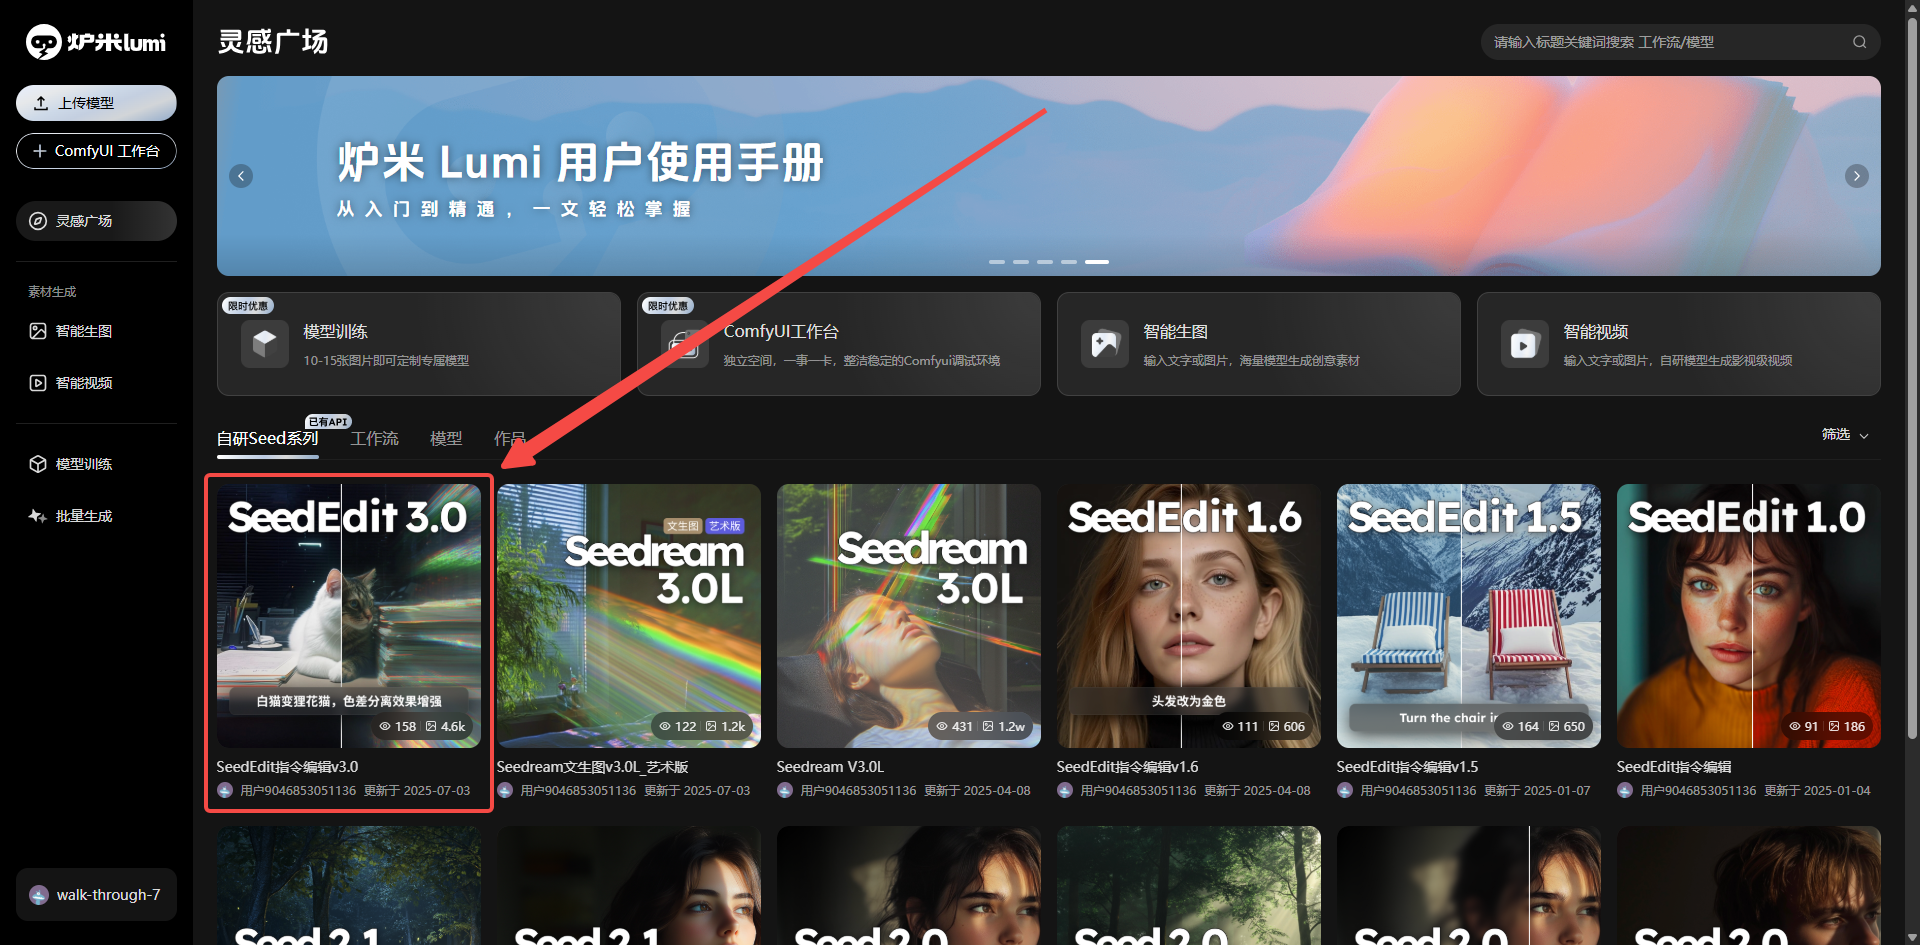
- LoRA训练-可支持2048分辨率训练
训练教程
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
数据集压缩包示例
配对数据构建
数据标准
- 变化过程必须符合目标效果定义,且尽可能统一,如差别较大,需分类后打标
- 对于原图和目标图,除需要改变的属性之外,尽可能保持图像信息高度一致(如清晰度、人脸、背景、服饰、颜色风格、纹理等一致性)
- 覆盖场景尽量符合落地场景,若希望全场景覆盖,可构建人像、宠物、风景、近景、远景、特写等配对数据
- 分辨率高于1k,长宽比尽量贴近落地场景。(可考虑使用AIGC SR服务提升分辨率)
- 数据量在保证符合以上标准的情况下越多越好,一般要求大于50对
配对数据构建方式
- 可以搜集目标图(或输入图),然后始终seededit/dreamedit workflow生成输入图(或目标图),从而构建配对数据。
- 也可以训练t2i lora通过controlnet/inpainting等worfklow链路构建配对数据
编辑区域 | 技术链路 | 数据链路 |
风格化 | t2i lora + controlnet workflow | 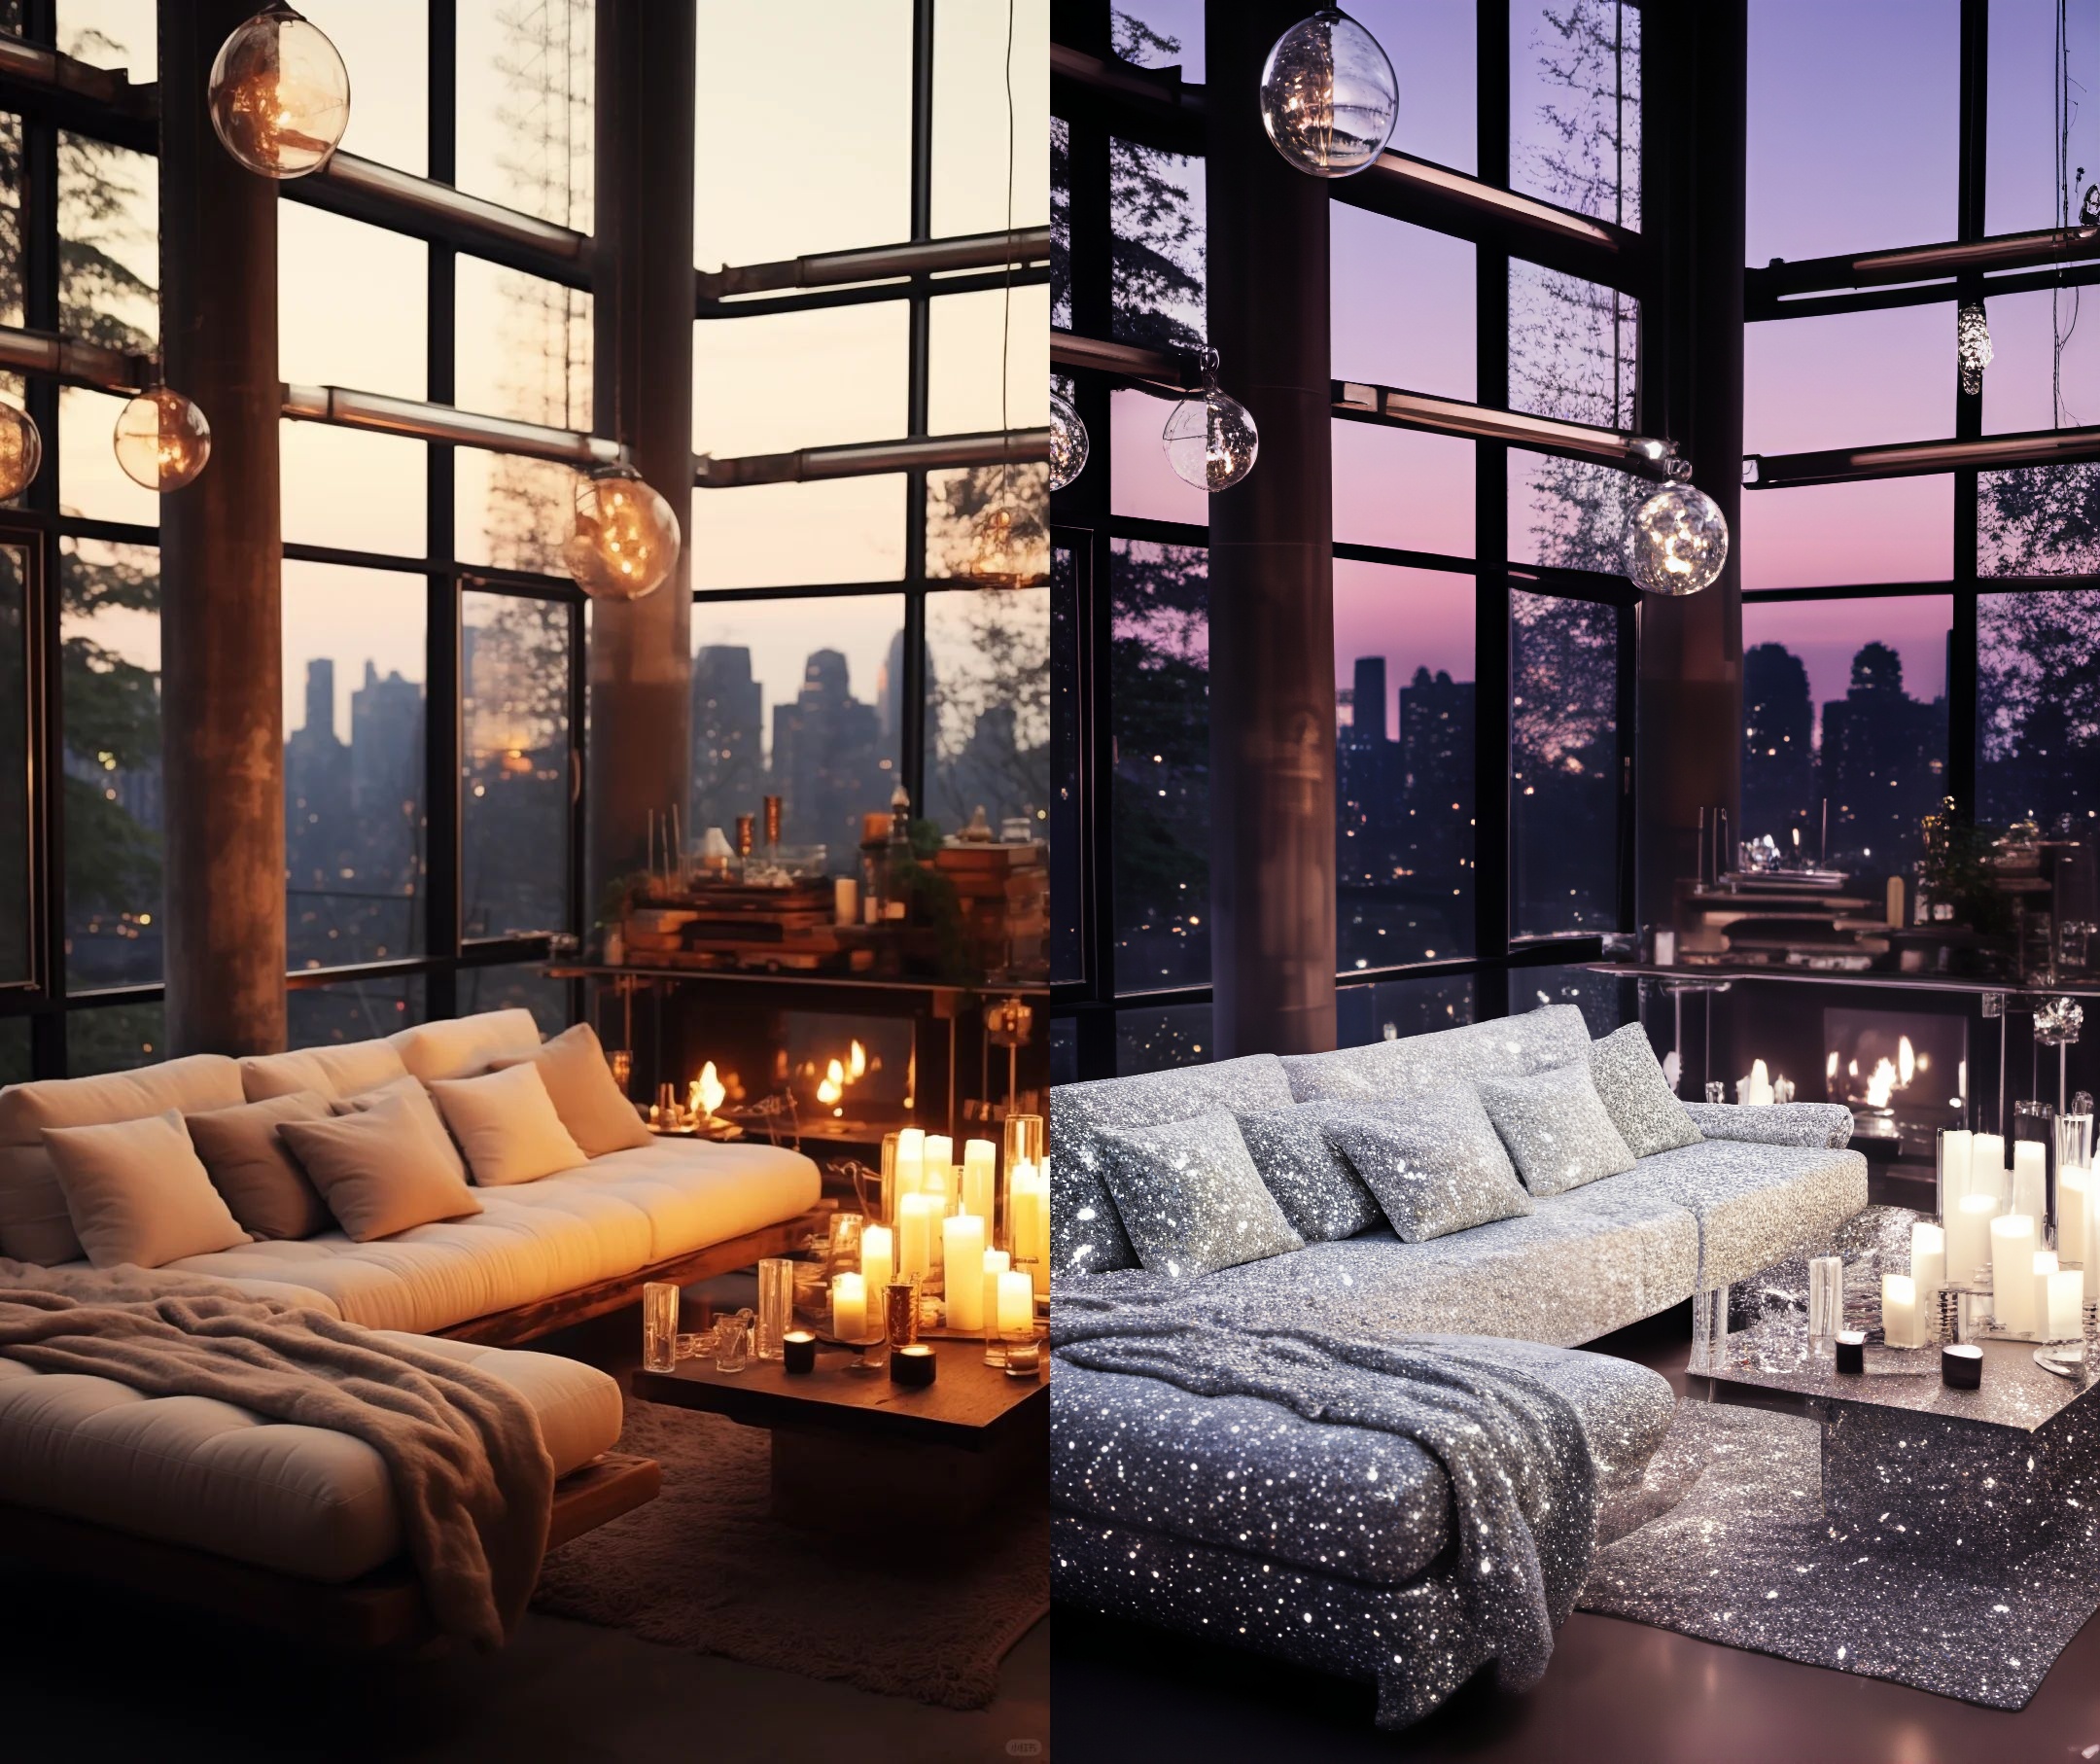 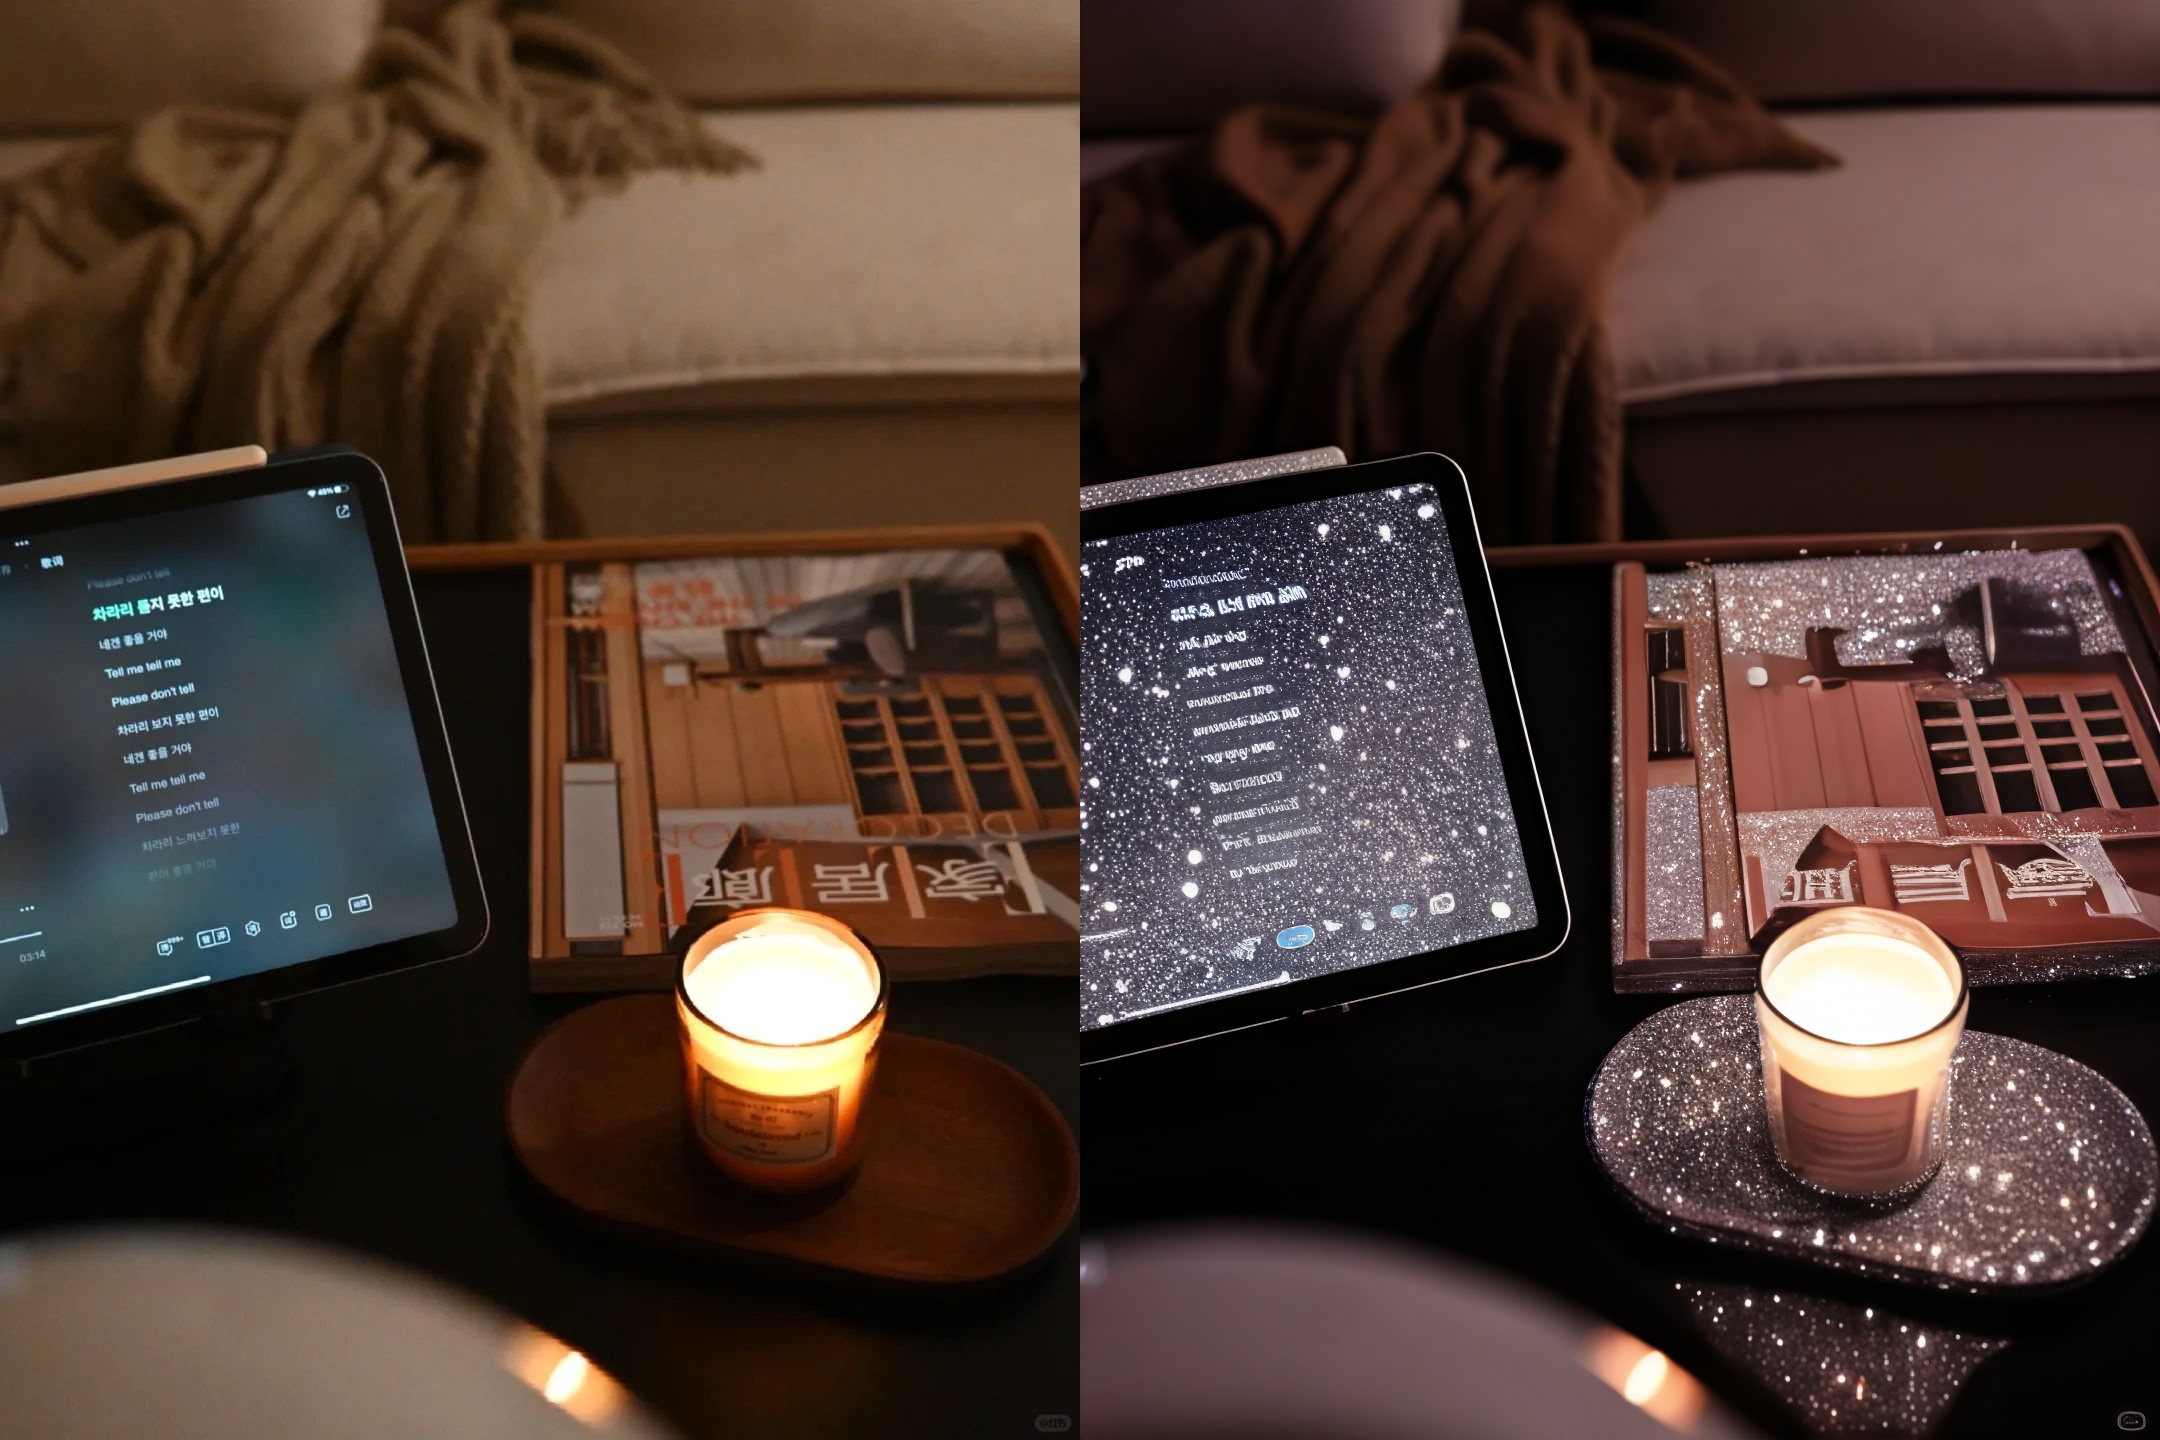 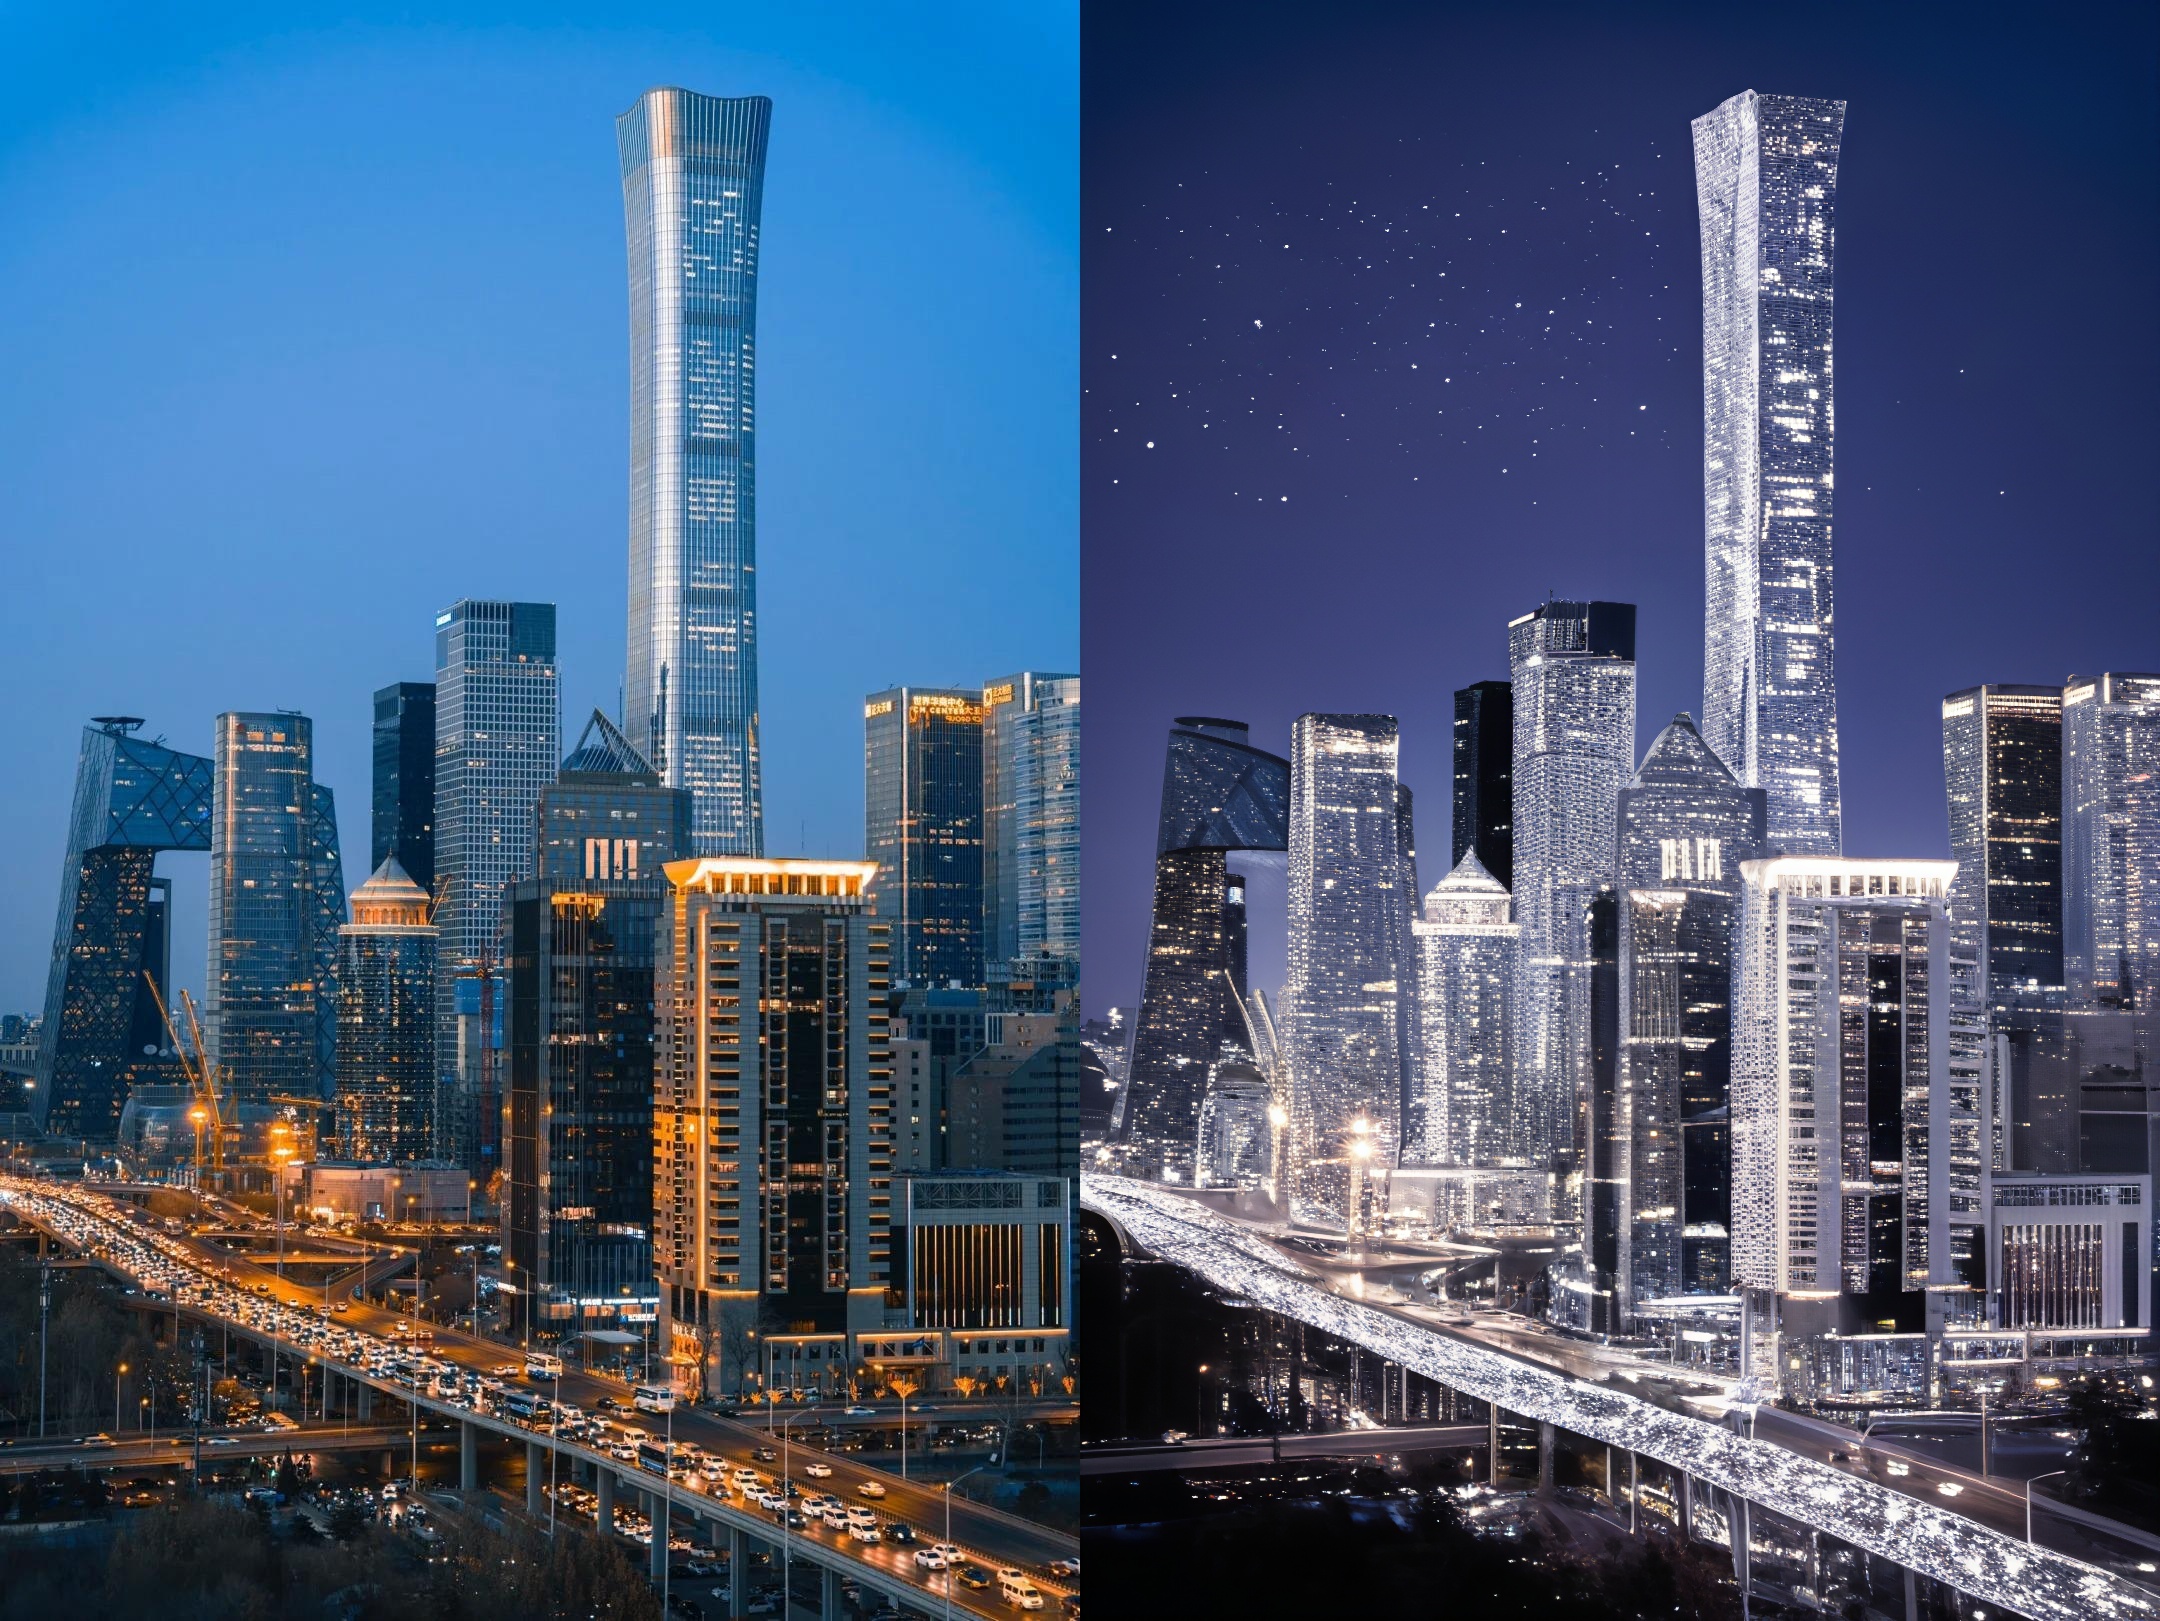 |
只变局部区域 | t2i lora + inpainting | 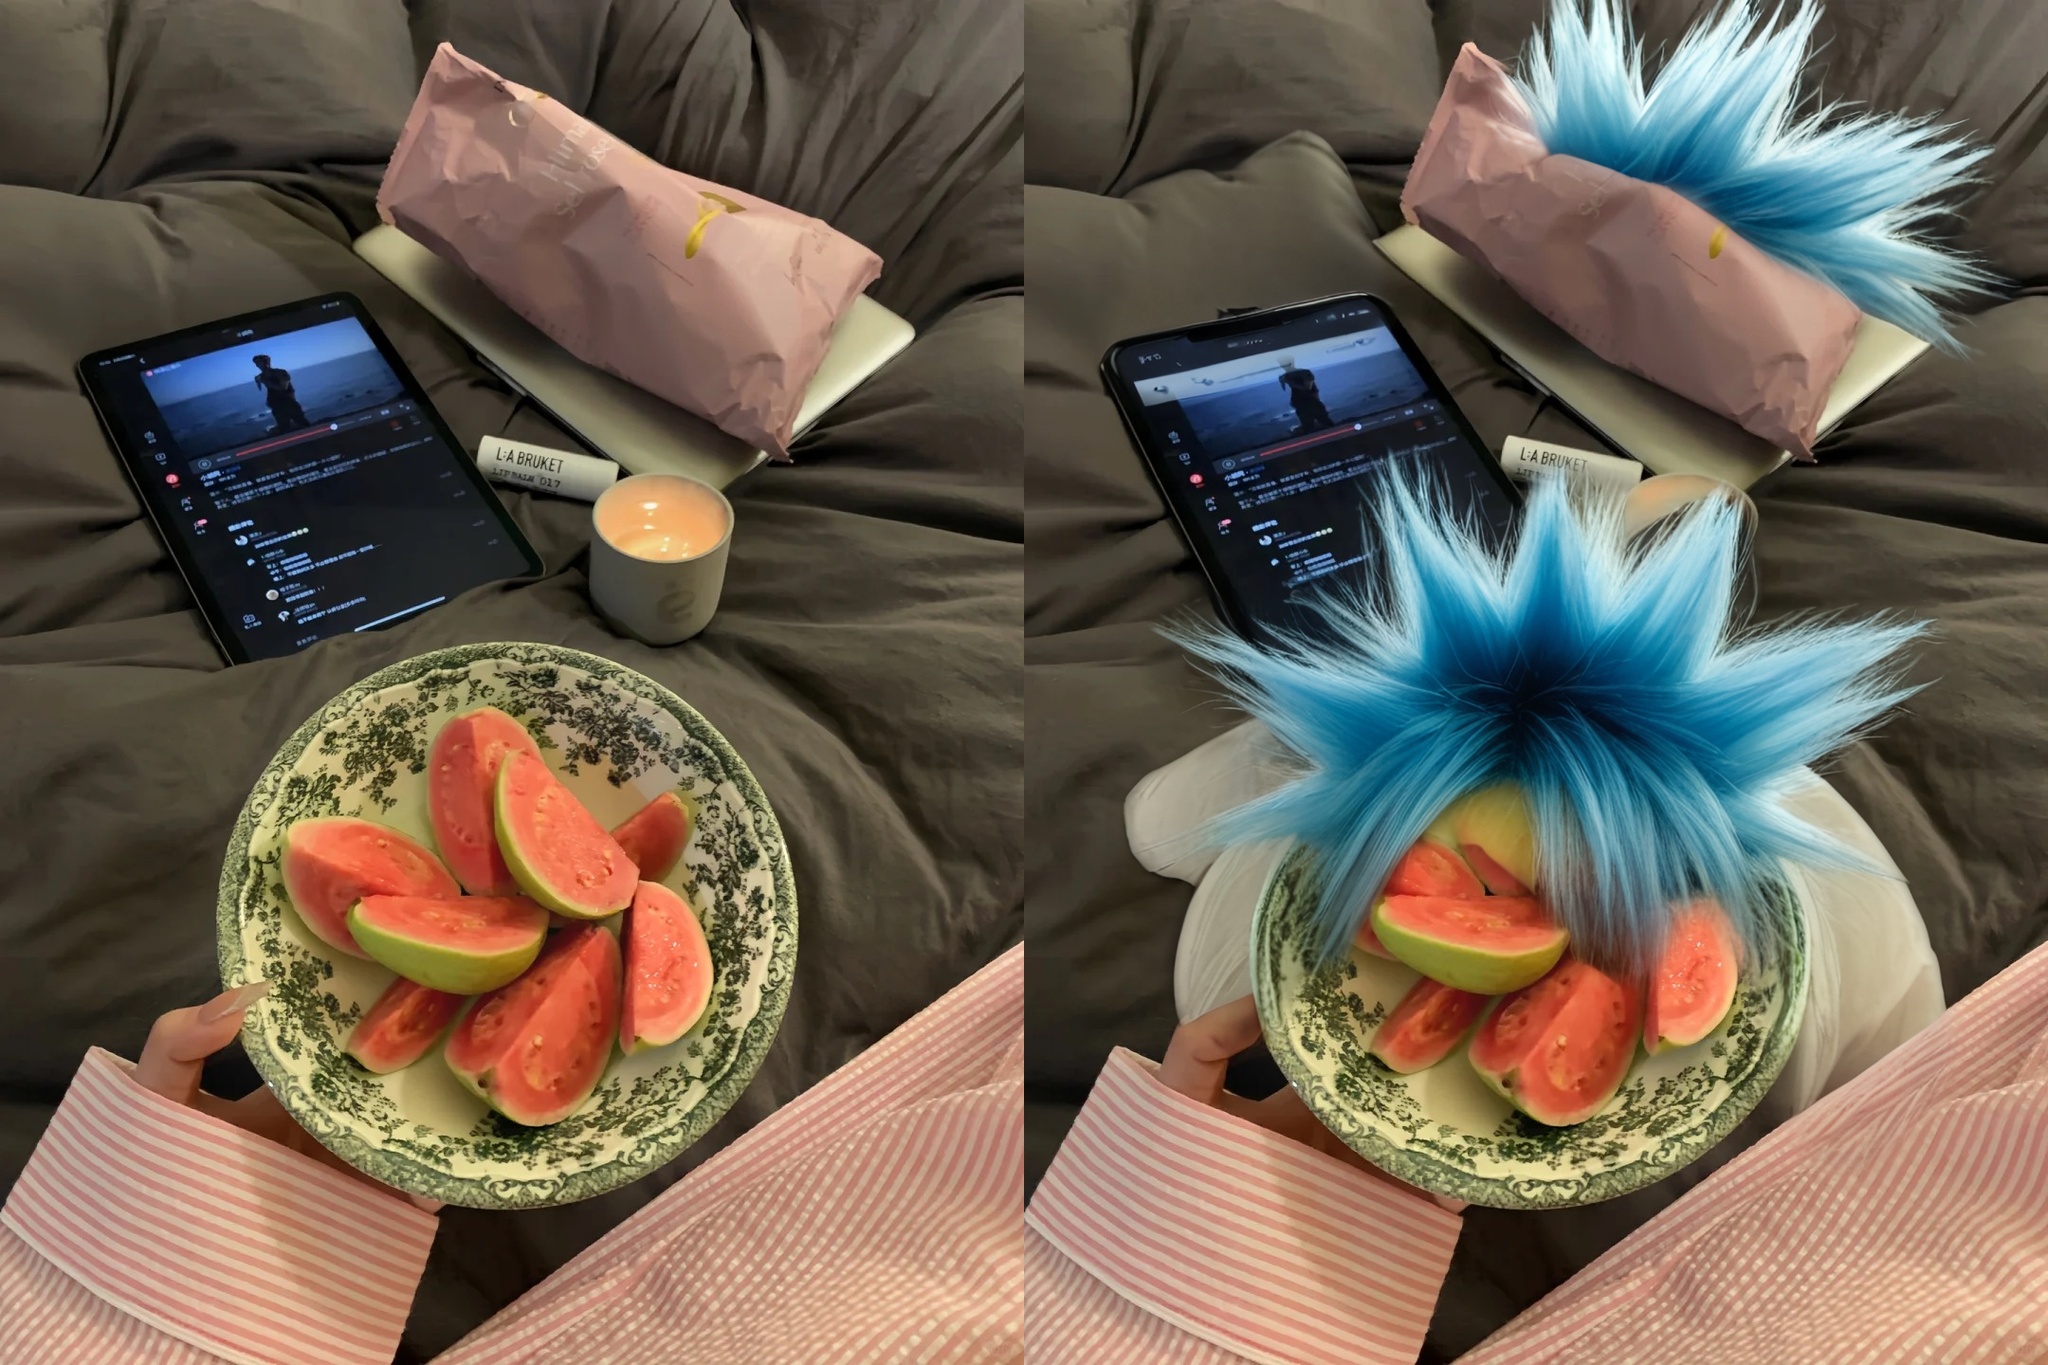 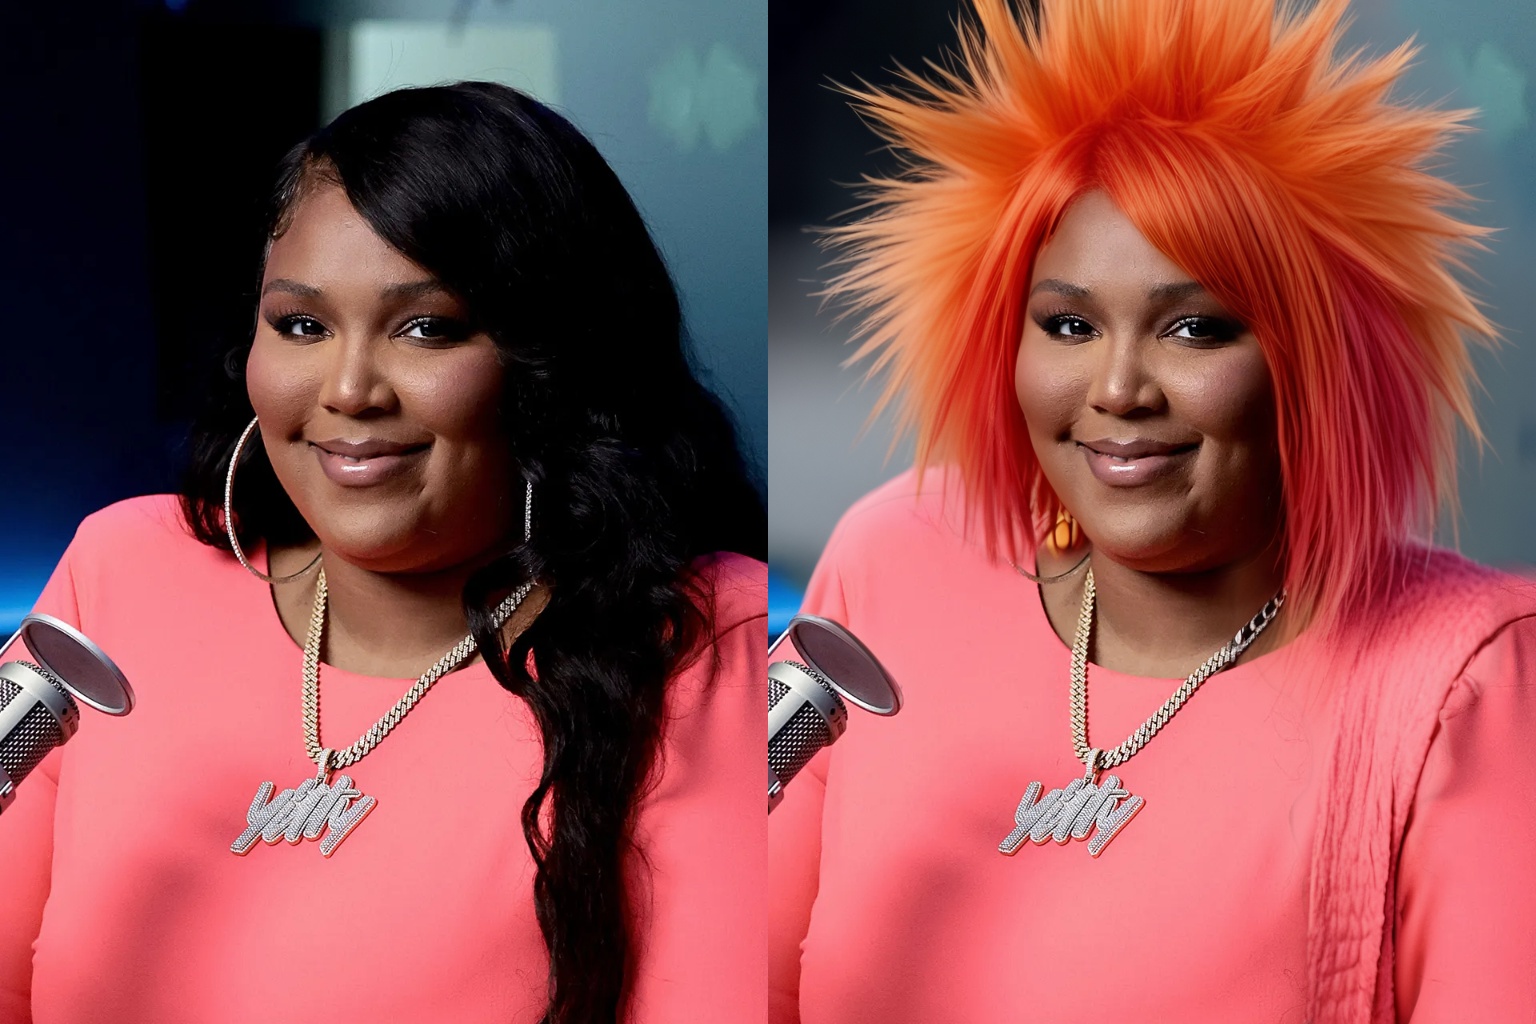 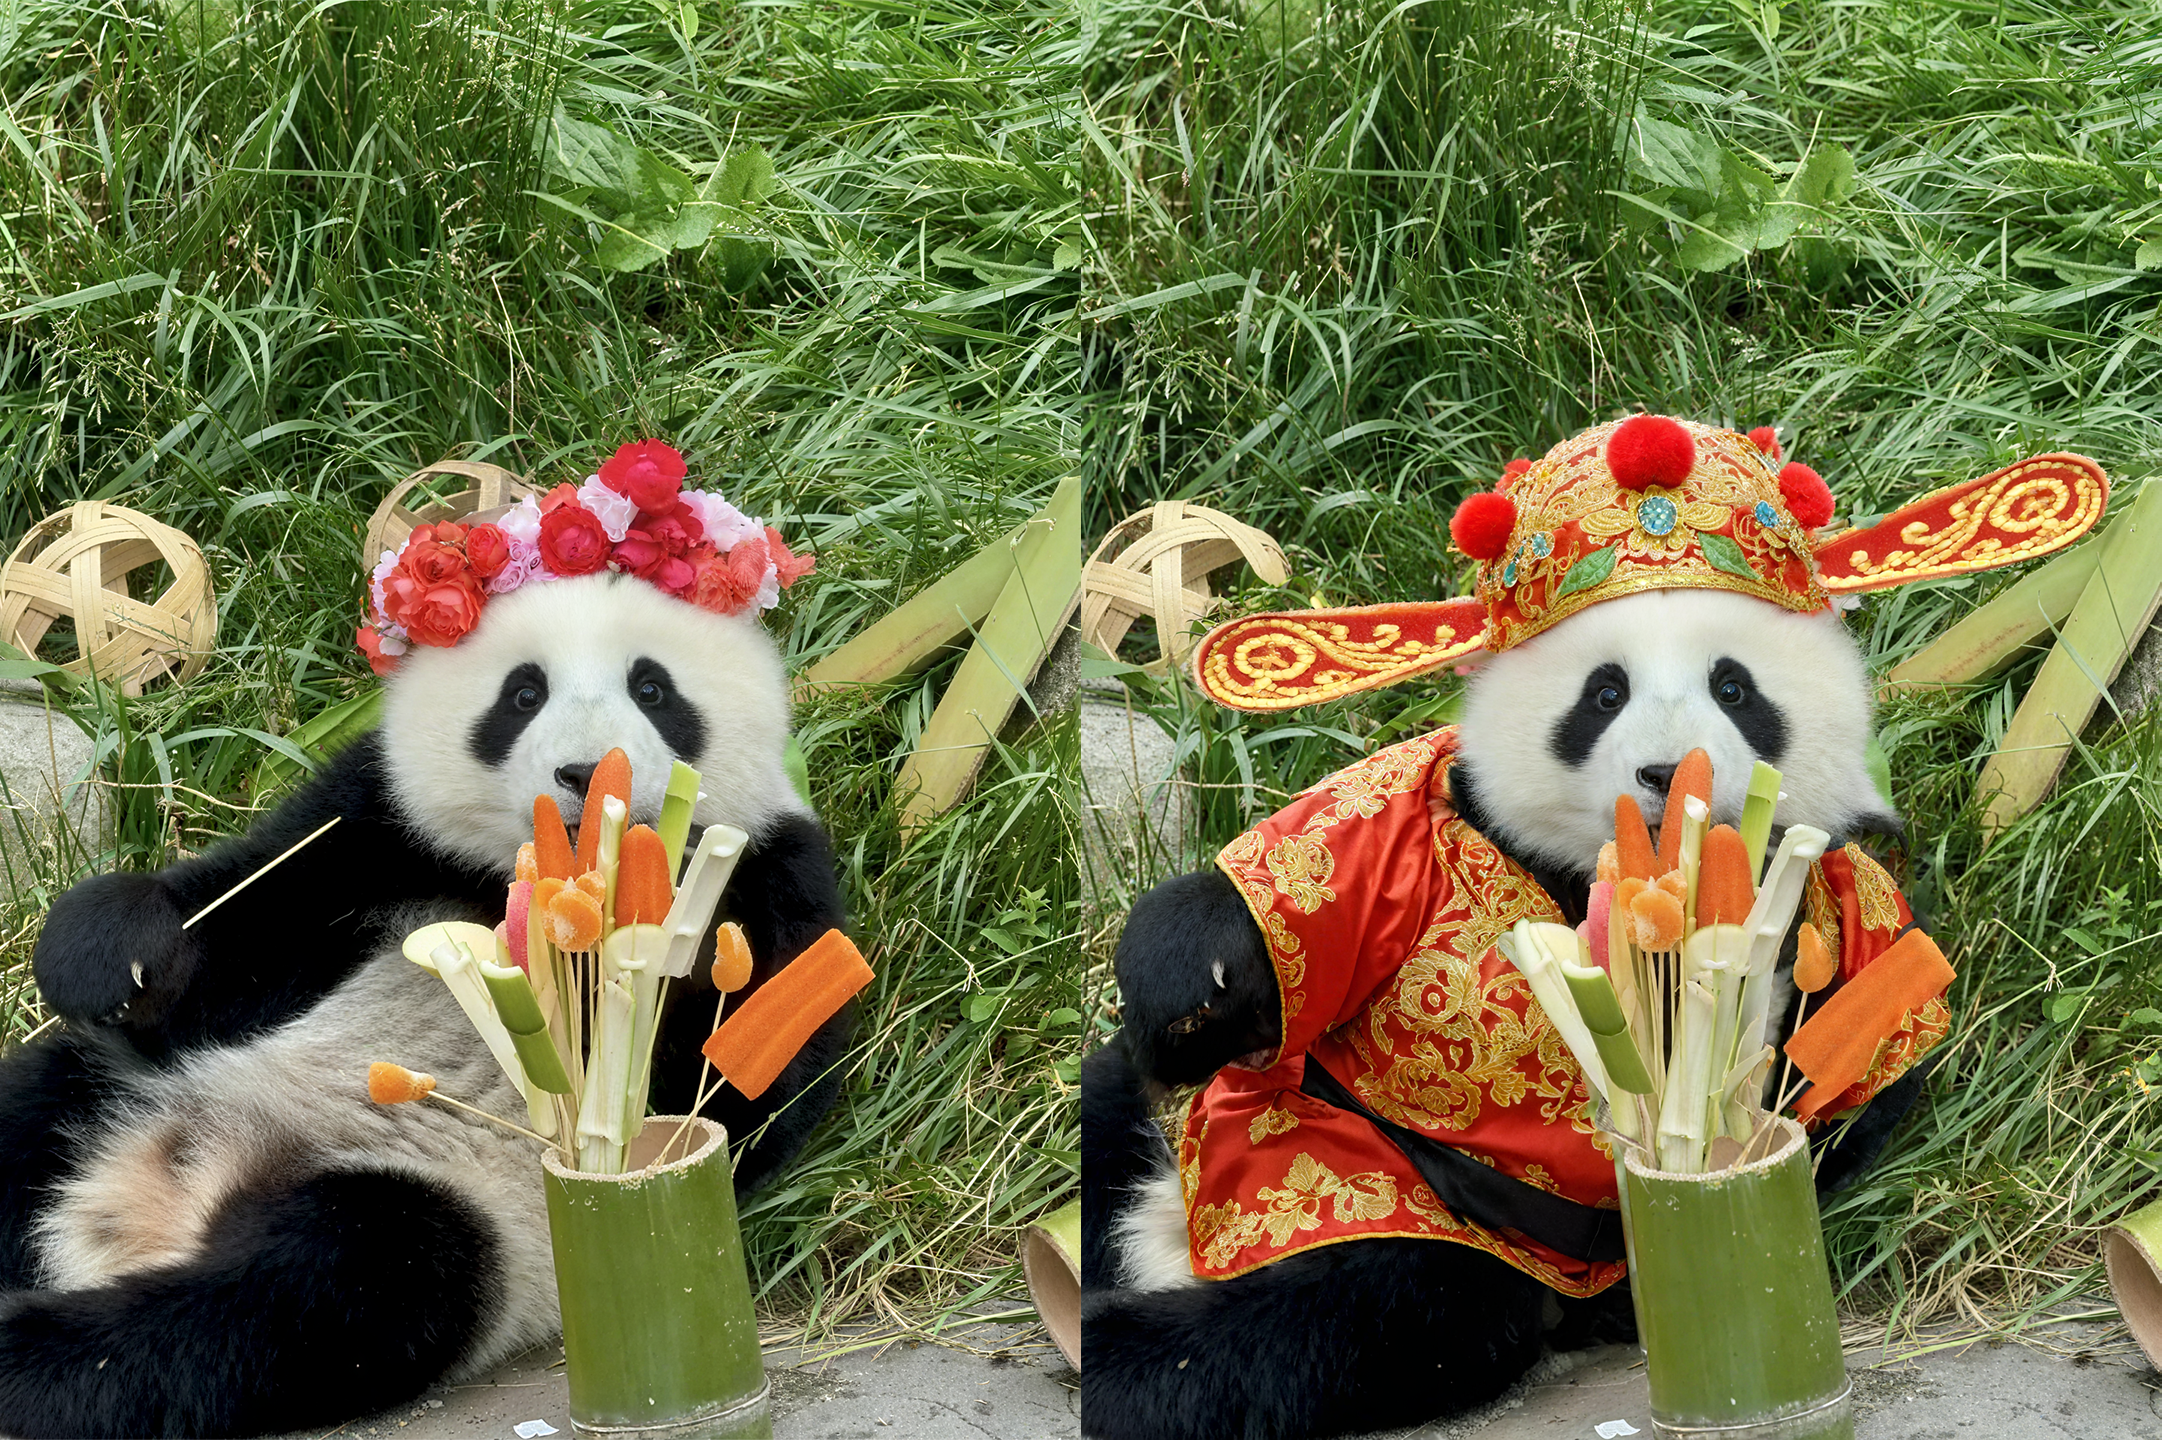 |
只变局部区域 | Dreamedit反向造数据 | 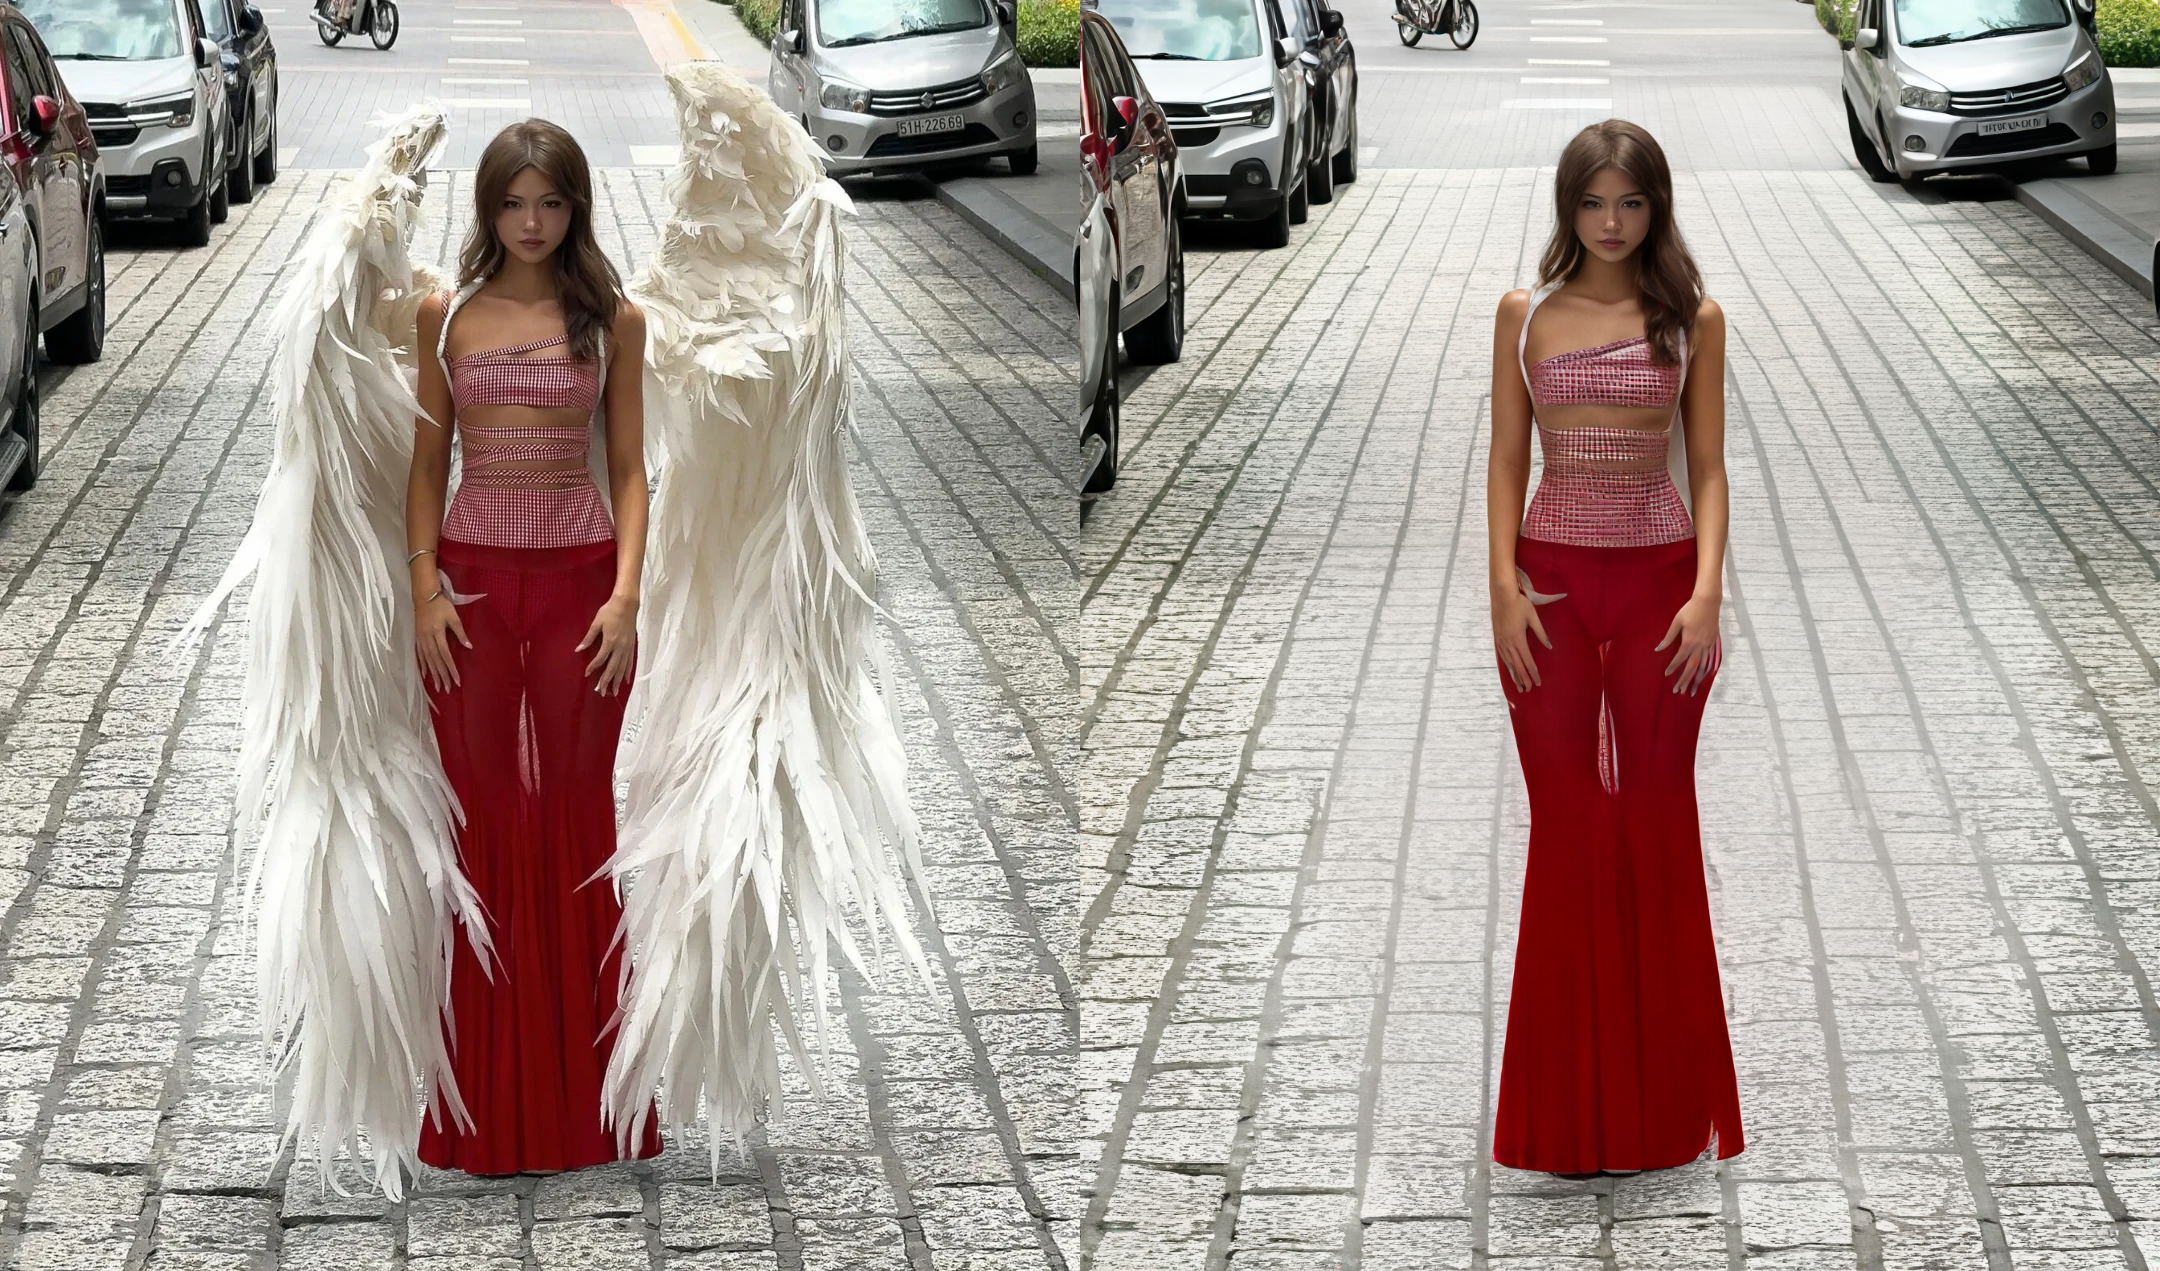 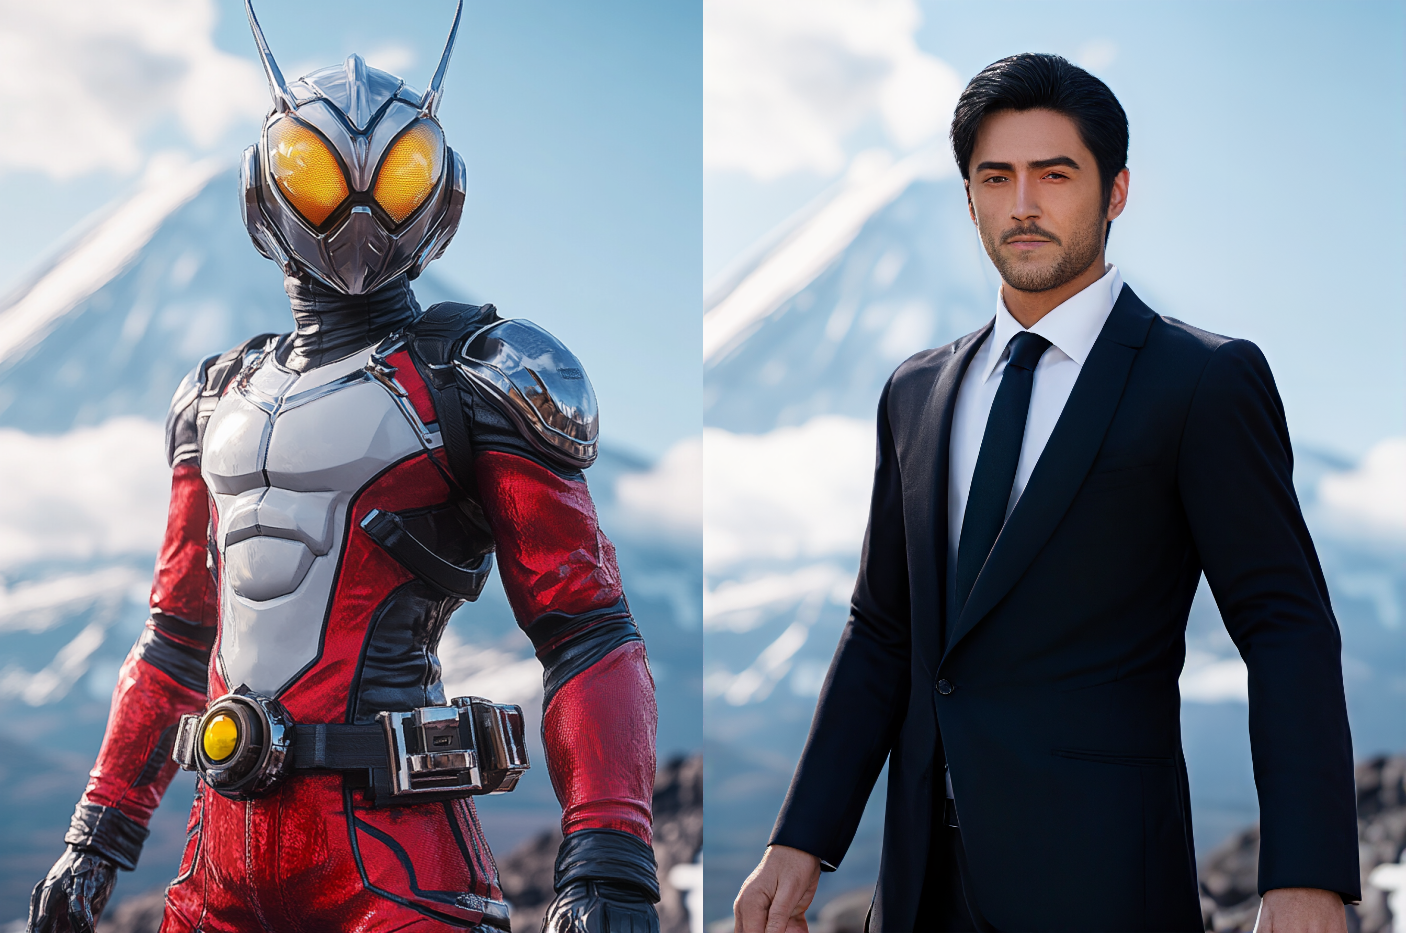 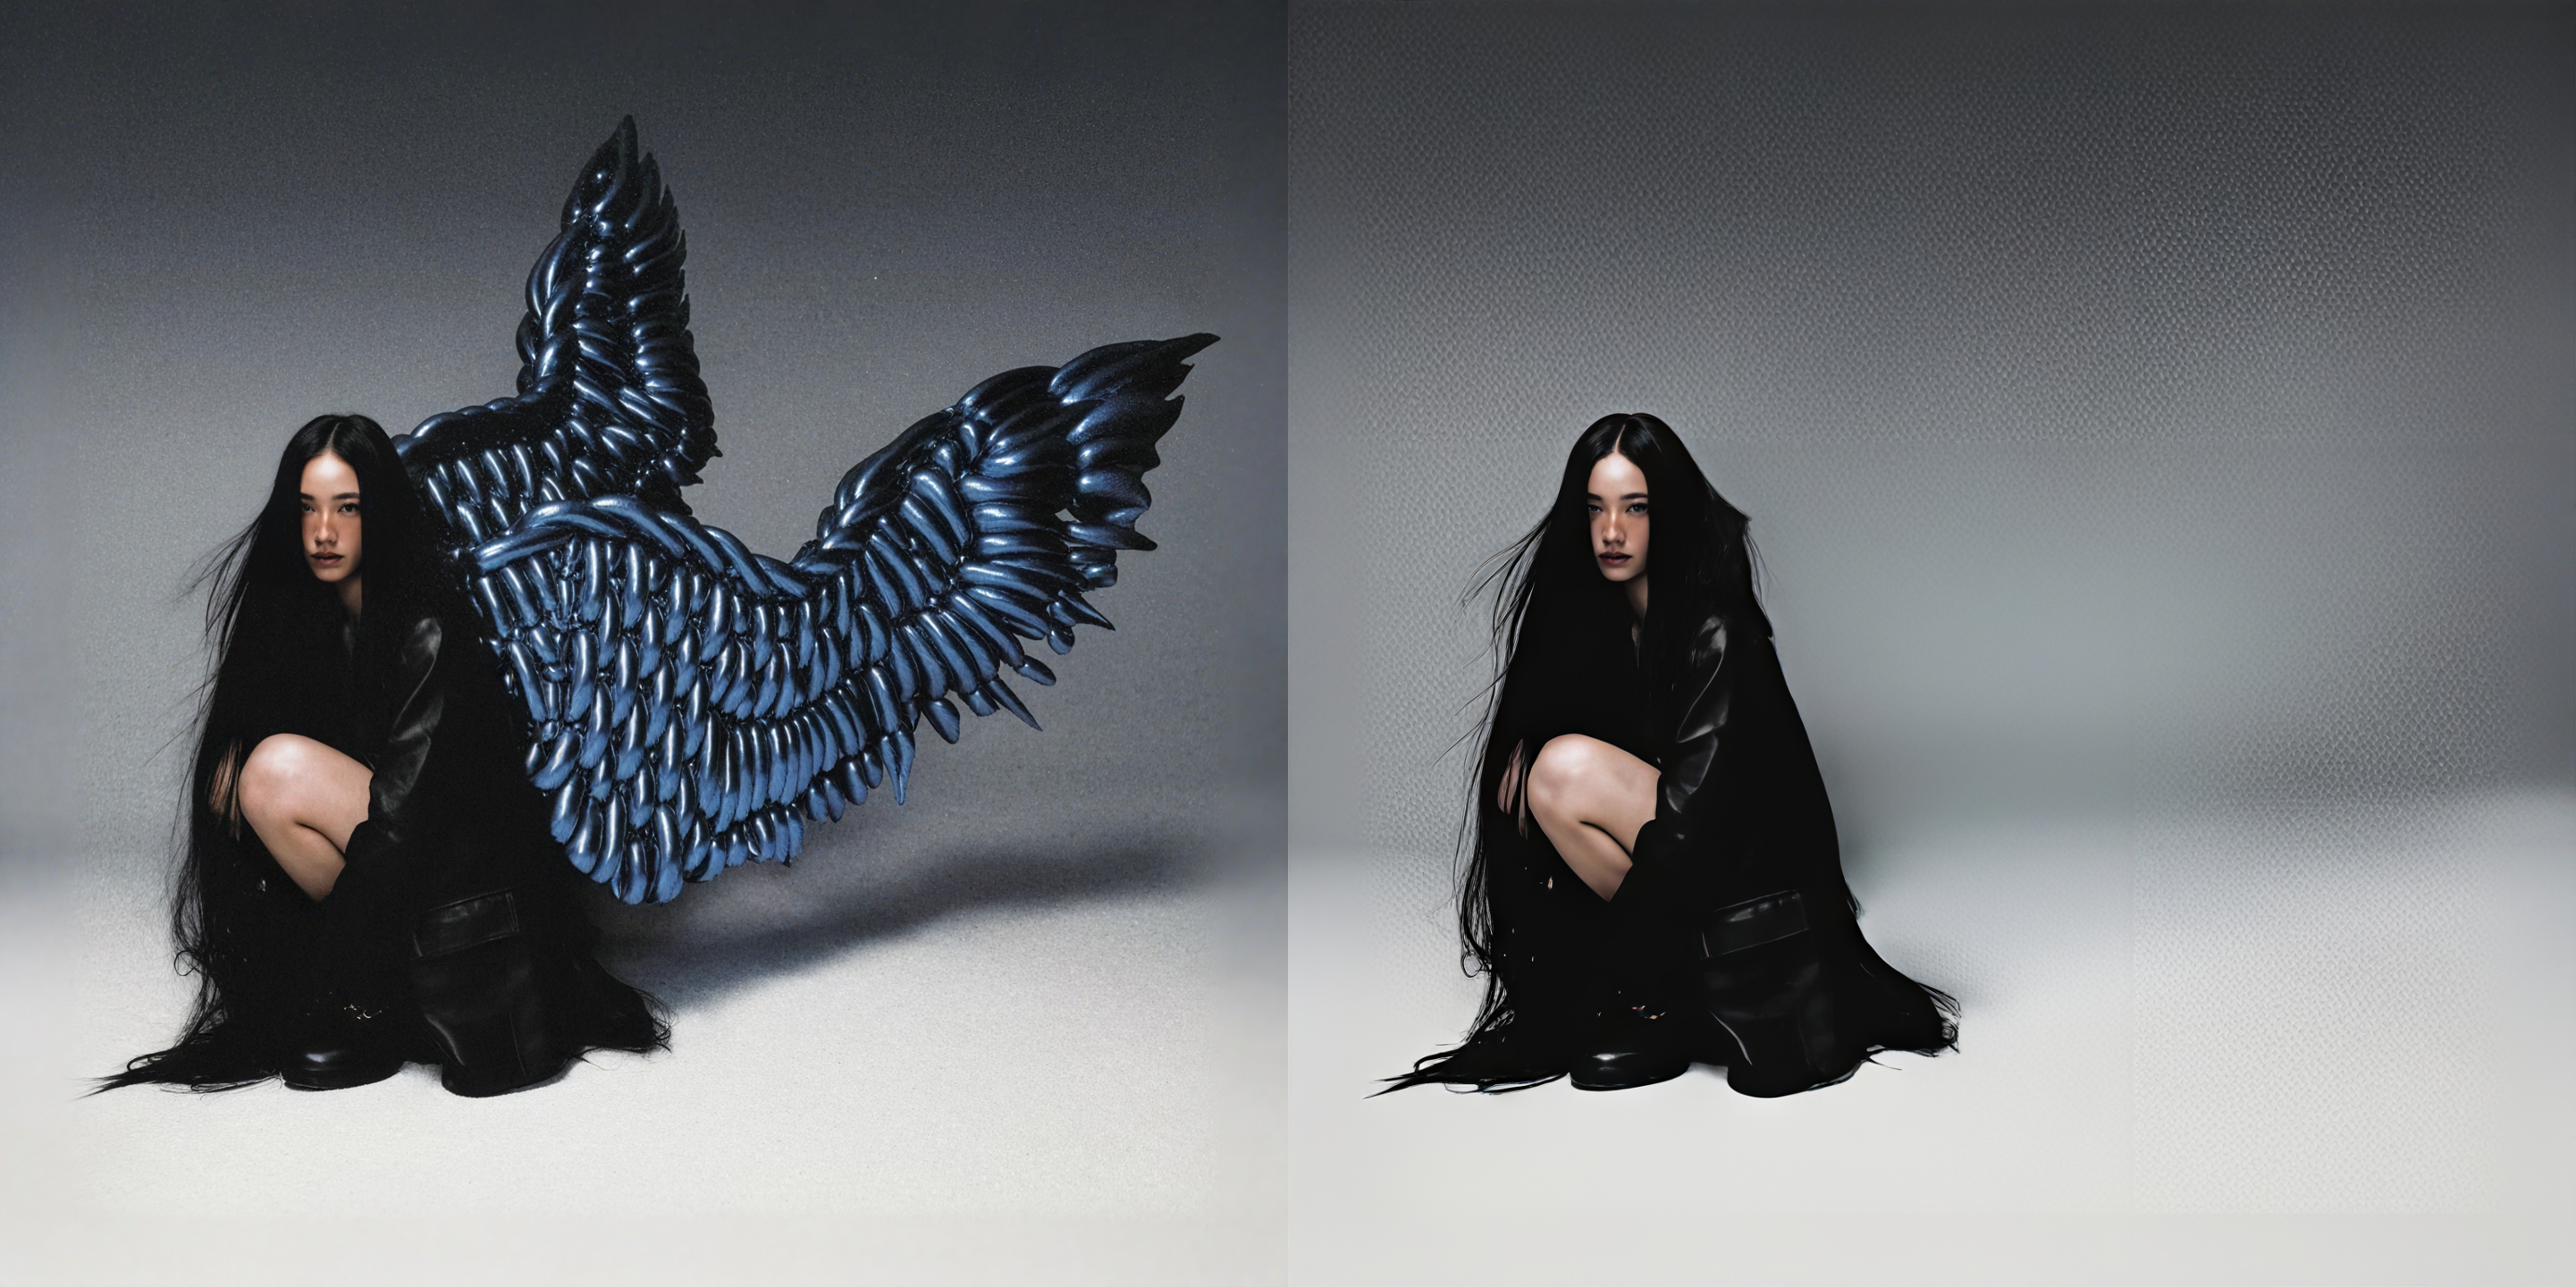 |
文本打标
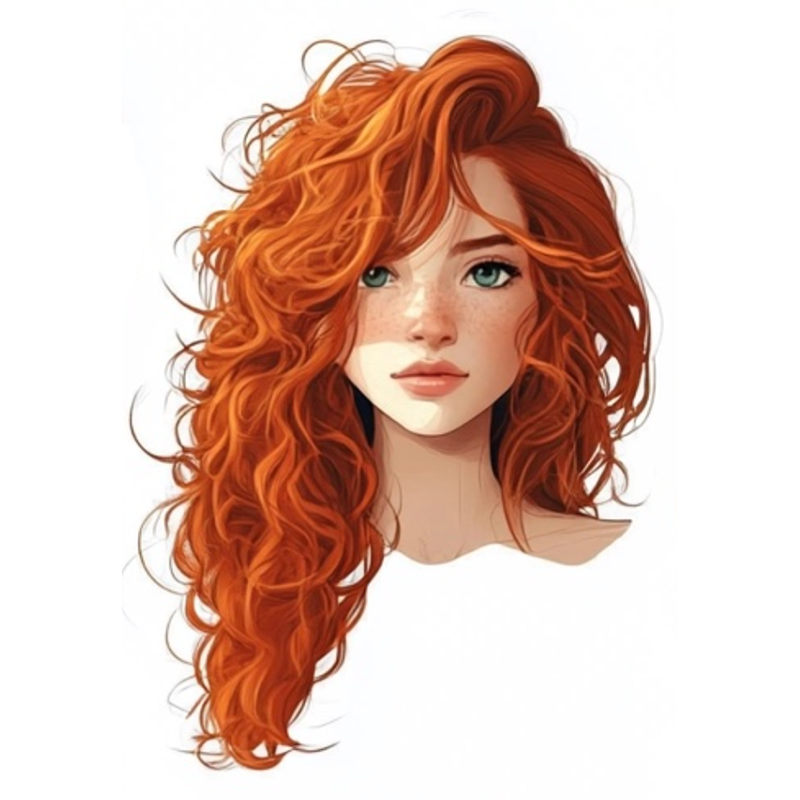
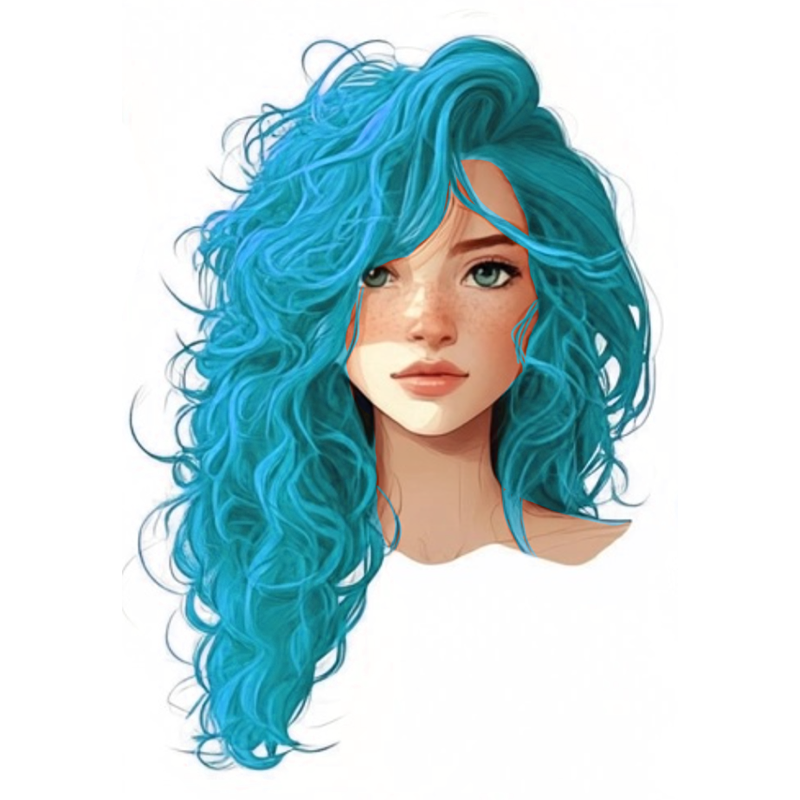
文本打标方式,分为普通标和特殊标,以下图配对数据为例,打标可有两种方式,
- 特殊标:把头发变成dasfafwrqwewq
- 普通标:把头发变成杀马特
以经验来看,越贴合编辑模型直出的描述会越容易学会(lora只作为一个加强效果和提高稳定性的功能)。
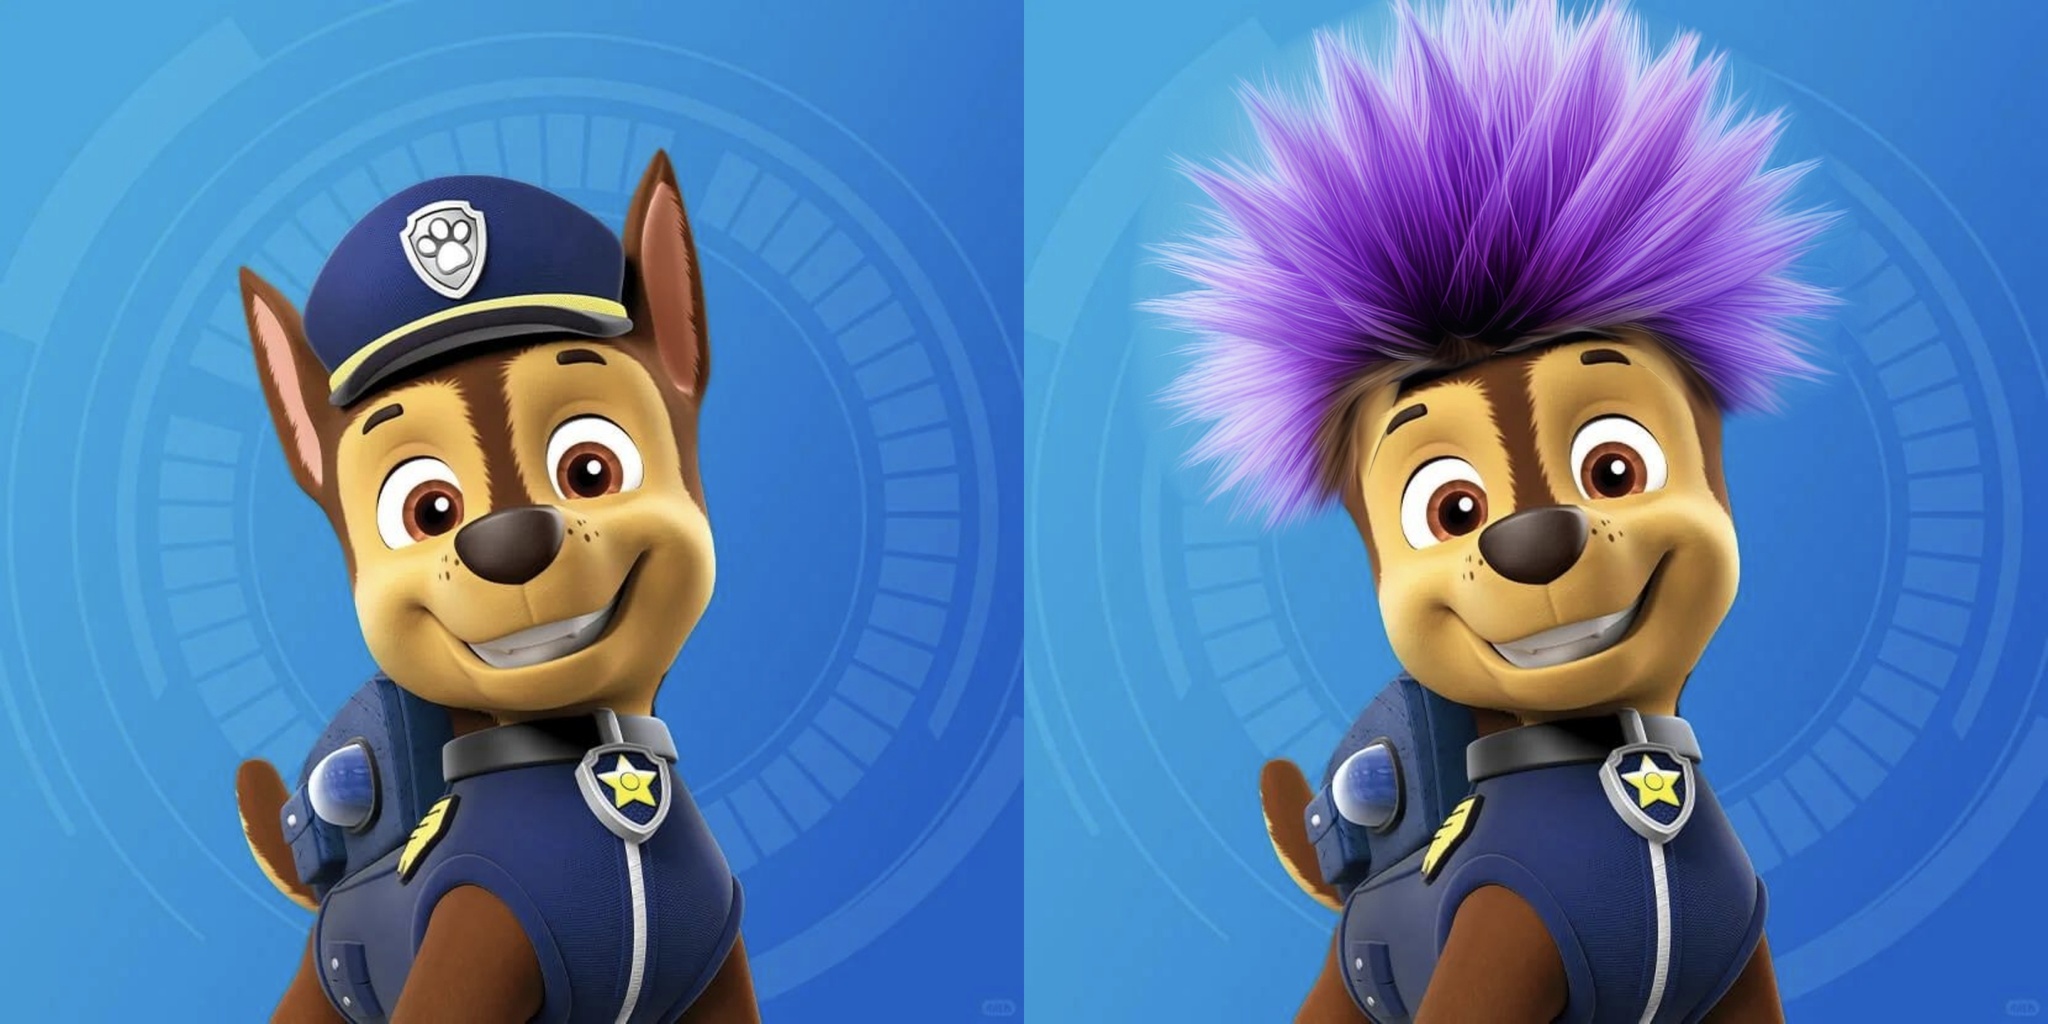
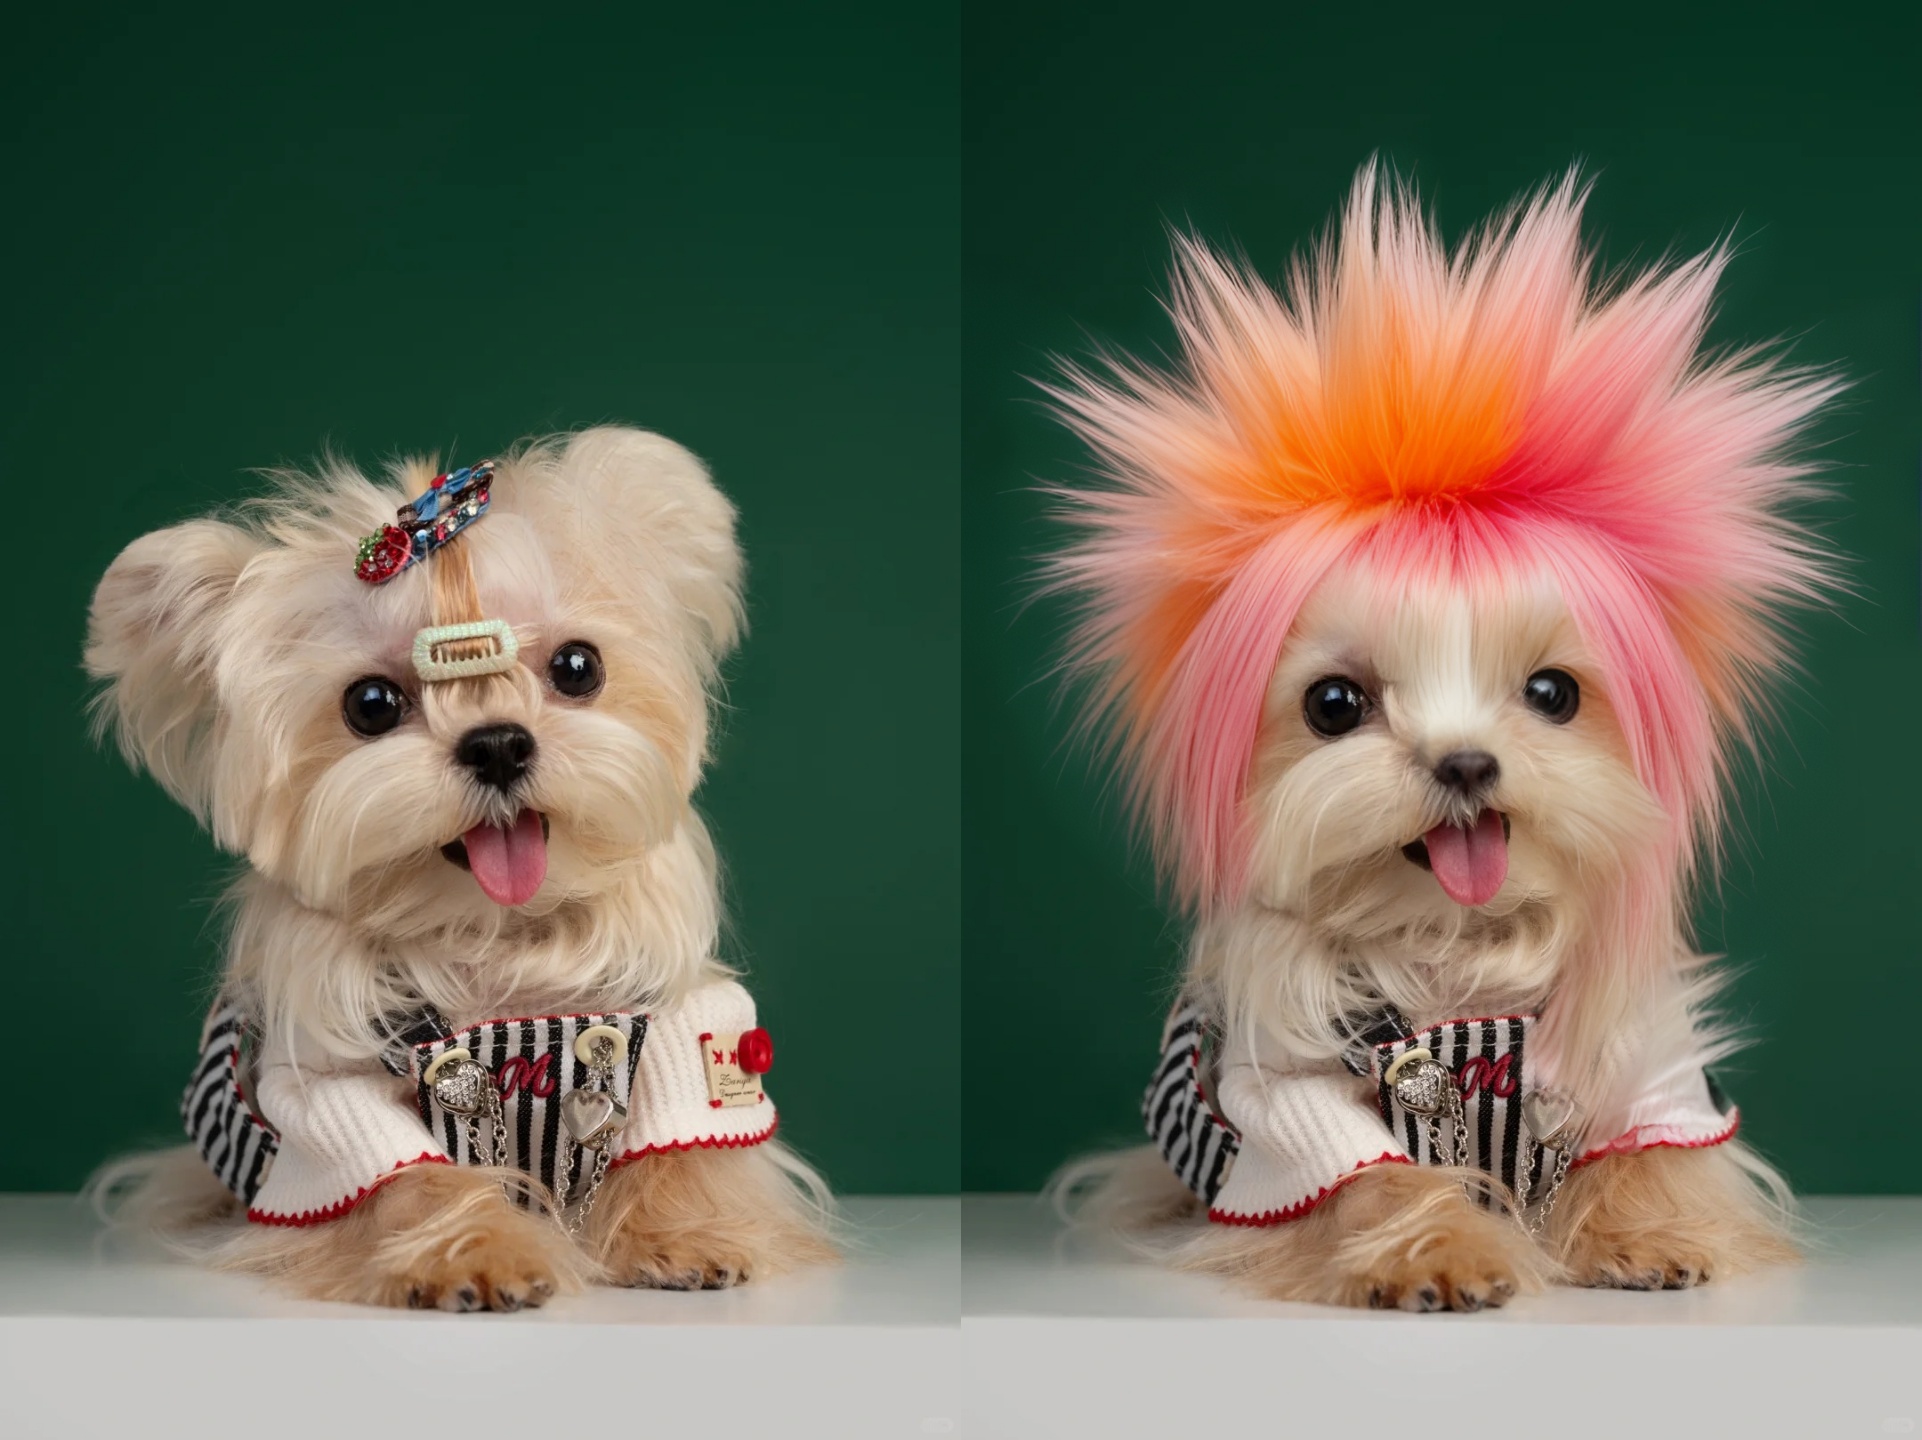
- 编辑指令尽可能简洁、直接,可以描述一个general的编辑目标:比如美化人像、美化人脸,也可以是一个具体的目标:比如将发型变成波波卡。before caption 是详细的输入图描述,after caption 是详细的输出图描述;其中,after caption 和 before caption 的句式结构、语法相似,只在描述编辑内容的区域有差异。
- 指令可以理解为遗忘训练lora的触发词,可以是固定的(对应打标的图像+指令),也可以是不固定的(对应打标的图像模式);不固定的指令应该拥有相似的句式:比如“把xxx变成xxx”。
- 推理时,设计师需要定制PE节点,根据输入图和lora,调教VLM能够输出类似训练数据的 before caption、after caption;如果编辑指令不固定,还要求 vlm 输出对应 before/after 差异、且结构相似的指令。
训练参数
参数模块 | 参数名称(中英文) | 对应基模 | 图片 | 组件形式 | 参数释义 | 参数范围 | 默认值 |
训练参数 | 批量大小(gradient_accumulation_steps) | SeedEdit 1.6 | 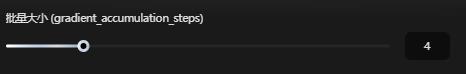 | 横杆拖拉 | 每一步迭代的批处理文件量,即train batch size | Int 1-16 | 4 |
| 训练步数 (num_training_steps) | SeedEdit 1.6/3.0 | 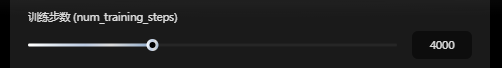 | 横杆拖拉 | 最大训练迭代数,训练累积到该步数即结束,按照经验3000-4000步lora效果最佳, 换算公式epoch = (step*batch_size) / (图片数量 * repeat) | Int 1000-10000 | 4000 |
| DiT 学习率 (learning_rate) | SeedEdit 1.6/3.0 |  | 输入框 | DiT模型学习率 | float 0-1 | 0.00001 |
| VLM 学习率 (vlm_learning_rate) | SeedEdit 1.6 |  | 输入框 | VLM(可以理解为就是语言模型部分)模型学习率 | float 0-1 | 0.000001 |
| 网络维度 (lora_rank) | SeedEdit 1.6/3.0 | 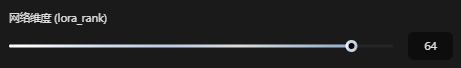 | 横杆拖拉 | 较大的网络维度会增加模型的大小,有助于捕获更多的特征和细节,但太大会导致过拟合。较小的网络维度值可能会减少模型的大小,适用于小数据集的情况。 | 1-1024 | 64 |
| 参数版本(dit_lora_mode) | SeedEdit 1.6 |  | 下拉框选择 | 可选["v1", "v2", "v3"],参数量v1<v2<v3,通常使用v1,数据量较大可以尝试v2、v3 | str ["v1", "v2", "v3"] | "v1" |
训练结果可视化和保存 | 每N步保存一个LoRA(save_model_steps) | SeedEdit 1.6/3.0 |  | 横杆拖拉 | 每N步保存一个LoRA | 100-10000 | 1000 |
| 测试步数(test_steps) | SeedEdit 1.6/3.0 |  | 横杆拖拉 | 中间可视化输出使用的模型推理步数 | Int 8-30 | 16 |
| 训练集测试步数(val_per_iters) | SeedEdit 1.6 |  | 横杆拖拉 | 支持训练过程中的中间模型可视化结果输出,该参数代表每间隔多少步使用当前模型推理一次训练集结果 | Int 100-10000 | 1000 |
最近更新时间:2025.08.29 22:56:38
这个页面对您有帮助吗?
有用
有用
无用
无用