大数据文件存储
大数据文件存储


文档指南

请输入


- 文档首页
 大数据文件存储最佳实践配置 Flink 访问 CloudFS
 复制全文
 下载 pdf
配置 Flink 访问 CloudFS
 文档反馈
 问问助手
Flink 是一个面向有限流和无限流有状态计算的分布式计算框架,它能够支持流处理和批处理两种应用类型。
本文介绍如何配置 EMR 中的 Flink 服务使用和访问 CloudFS。
前提条件
- 开通大数据文件存储服务 CloudFS 并创建文件存储,获取挂载信息。详细操作请参考创建文件存储实例。
- 完成 E-MapReduce 中的集群创建。具体操作,请参见 E-MapReduce 集群创建。
- 准备一个测试文件。
步骤一:配置 CloudFS 服务
说明
集群所有节点都要修改如下配置。
- 连接 E-MapReduce 集群,连接方式如下:
- 使用本地终端 SSH 连接集群节点管理 master 的公网 IP 地址。
- 使用同区域下的云服务器实例连接集群节点管理 master 的内网 IP 地址。
- 执行以下命令,下载 1.5.3.49 版本的 CloudfsSDK 包。
-
- 执行以下命令,解压 CloudfsSDK 包。
-
- 将解压文件cloudfs-client/lib/cloudfs-sdk-1.5.3.49.jar拷贝至集群/share/hadoop/hdfs路径下。
-
- 配置core-site.xml文件。
- 执行以下命令打开 Hadoop 安装目录下的core-site.xml文件:
- vim {hadoop_安装目录}/hadoop/conf/core-site.xml
- 在core-site.xml中添加配置:
-
步骤二:配置 Flink
- 将解压后的 SDK 目录下的cloudfs-client/lib/cloudfs-sdk-1.5.3.49.jar文件复制到Flink lib文件夹下。
-
- 重启 Flink 服务。
- 登录火山引擎 E-MapReduce 控制台。
- 在集群管理页面,找到目标 E-MapReduce 集群。
- 单击服务列表找到 Flink 服务。
- 单击列表页面右侧重启按钮,选择重启全部组件。重启后需重新连接集群。
步骤三:验证 Flink 配置
说明
需自行上传测试数据。
- 准备测试数据。
-
- 执行 Flink 计算命令。
-
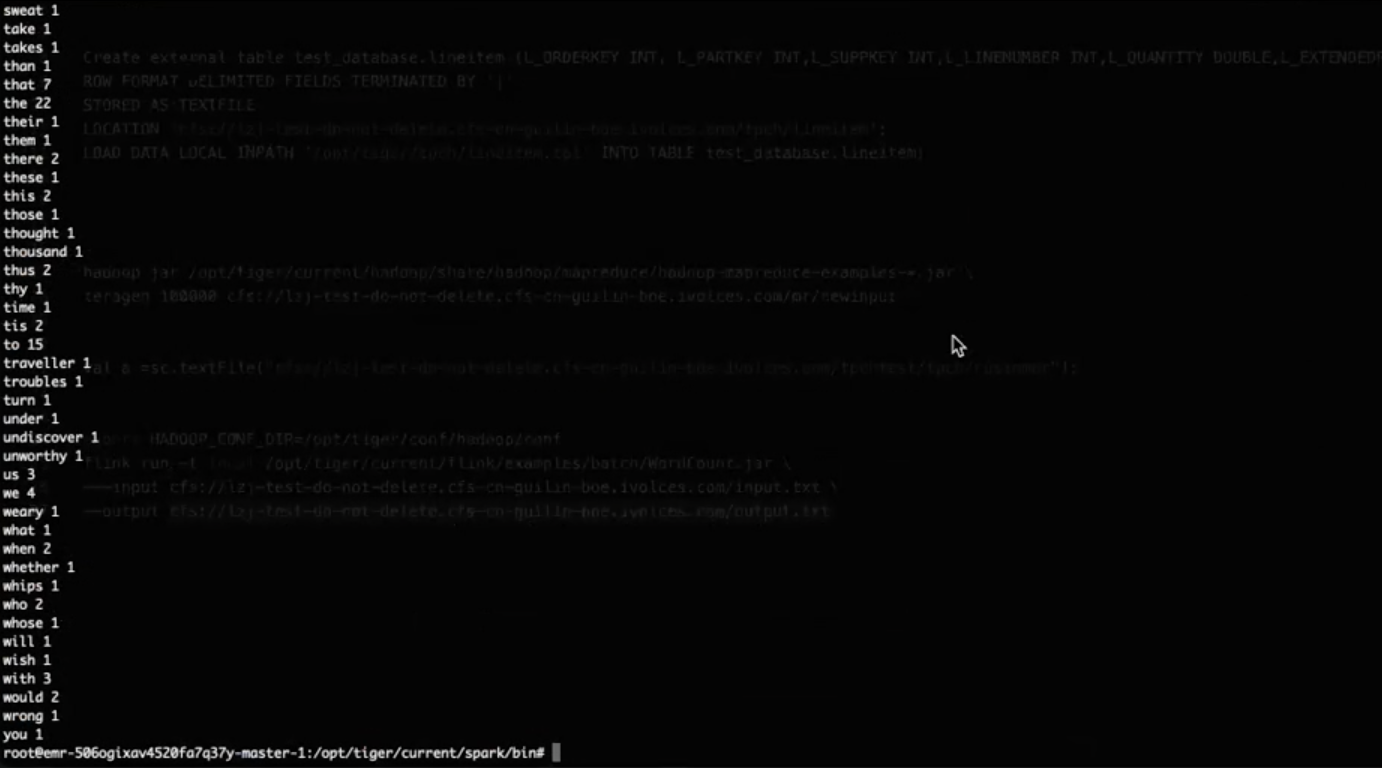
- 查看计算结果。
-
- 返回如下图类似信息,则表示配置 Flink 成功。
-
最近更新时间:2025.07.25 18:37:27
这个页面对您有帮助吗?
有用
有用
无用
无用