大数据文件存储
大数据文件存储


文档指南

请输入


- 文档首页
 大数据文件存储用户指南使用指引
 复制全文
 下载 pdf
使用指引
 文档反馈
 问问助手
CloudFS 适用于需要海量数据存储与高性能分析的大数据和 AI 场景。如果您正在使用或计划使用 Hadoop 生态(Hive、Spark、Flink 等)处理数据,或需要从自建 HDFS 迁移上云,CloudFS 可以为您提供兼容 HDFS 协议的托管文件存储服务。
选择使用模式
CloudFS 提供两种访问模式,请根据您的业务场景选择合适的模式:
使用流程
CloudFS 主要解决大数据场景下海量数据存储和数据分析问题,您可以将本地自建的 HDFS 文件系统无缝迁移到火山引擎 CloudFS。
创建火山引擎大数据文件存储实例后,您就可以在火山引擎云服务器 ECS 和容器等计算资源内通过 HDFS 协议接口访问 CloudFS 文件存储实例,从而实现文件的访问及共享。
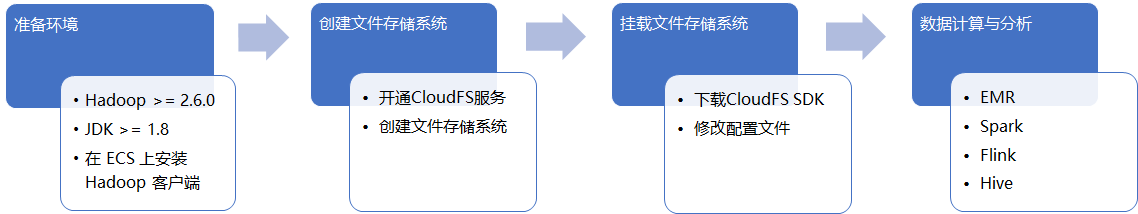
- 关于如何配置、挂载文件存储实例,请参见挂载文件存储实例。
- 默认火山引擎主账号有 CloudFS 的全部操作权限。IAM 用户(子用户)在使用 CloudFS 前,需要配置授权策略。如何为 IAM 配置权限,请参见授权策略概述。
- 如何与大数据计算服务结合,请参考:
核心能力概览
使用限制
使用 HDFS 协议访问 CloudFS 文件存储实例时,请务必了解各命令的支持情况。
- 不支持 WebHDFS REST API
最近更新时间:2026.06.04 16:14:11
这个页面对您有帮助吗?
有用
有用
无用
无用