缓存数据库 Redis 版
缓存数据库 Redis 版


文档指南

请输入


- 文档首页
 缓存数据库 Redis 版最佳实践结合 LLM 构建长会话 Chatbot
 复制全文
 下载 pdf
结合 LLM 构建长会话 Chatbot
 文档反馈
 问问助手
本文介绍基于 Valkey-Search 与 LLM 构建支持长会话的 Chatbot 解决方案。
方案目标
随着大语言模型(LLM)在自然语言处理领域的深入应用,基于 LLM 的智能对话系统已成为人机交互的重要组成部分。然而,当前主流 LLM 受限于单次请求所能处理的 Token 数量(通常为数千 Token),在处理长程多轮对话时,往往因历史记录累积而超出模型 Token 承载上限,导致关键上下文信息丢失,影响对话的连贯性与准确性。
为应对这一挑战,缓存数据库 Redis 版提供了基于 Valkey-Search 模块的向量化对话记忆管理方案。该方案利用 Valkey-Search 高效的向量存储与检索能力,将历史对话内容转化为向量形式并持久化存储在 Redis 实例,构建一个具备“长记忆”的 Chatbot 系统。用户每次输入时,Redis 可通过向量相似度计算,动态检索与当前对话最相关的历史片段,并将其作为上下文信息整合至模型输入中。该方案不仅突破了单次请求的 Token 数量限制,还提升了长对话中信息关联的精准度与系统响应质量,为实现可持续、高一致性的多轮对话交互提供可靠技术支撑。
方案架构
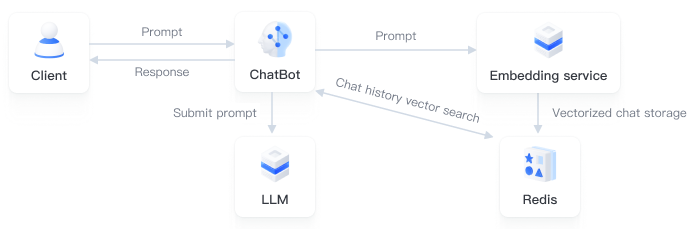
在当前方案架构中,用户的历史对话记录被统一存储于具备状态保持能力的 session 中。每个 session 除保存对话文本内容外,还支持配置存活时间(Time to live,简称 TTL)等动态过期机制,这样既能保障数据的时效性,也可以实现存储资源的合理分配。借助 TTL 机制,系统能够自动清理长时间未活跃的会话数据,有效控制系统负载,同时强化用户隐私保护。
在每次向大语言模型发起请求前,系统会优先基于 Valkey-Search 提供的向量检索能力,对当前用户的历史会话内容执行语义层面的相似性搜索。具体流程如下:将每条历史对话通过嵌入(Embedding)模型转化为高维向量,并持久化存储在 Redis 数据库中。当用户发起新一轮对话输入时,系统会将该输入实时向量化,并以此为查询条件,在 Redis 中检索出语义关联度最高的历史对话片段。
检索所得的相关上下文经过筛选与排序后将进入 prompt 优化模块。该模块负责将检索结果与当前用户输入进行逻辑拼接与结构化组织,构建出符合大语言模型输入规范、上下文衔接自然的完整 prompt。通过这一优化机制,不仅提升了 prompt 的语义清晰度与逻辑一致性,也有助于模型更精准地把握对话脉络与用户意图,从而生成更符合预期的回复。
最终,经过上下文增强的 prompt 将被提交至大语言模型进行推理与内容生成。该架构实现了长对话场景下的上下文感知能力,使聊天机器人能够突破单次请求的 Token 数量限制,在持续多轮交互中保持对话连贯性与个性化,提升用户体验和交互质量。
基于 Valkey-Search 与 LLM 构建支持长 session 的 Chatbot 系统架构设计如下图所示。
方案实现
准备工作
您需要提前准备如下资源并为各资源设置相关配置。
操作步骤
- 登录已安装对应环境的 ECS 实例。ECS 实例登录方法,请参见登录实例。
- 在 ECS 的命令行窗口或命令终端工具中,执行如下命令克隆代码。
- git clone https://github.com/volcengine/cache_for_redis_examples/tree/main/chatbot
- 进入 Chatbot 项目的目录,从 chatbot.py 文件代码中找到创建 Redis client 的部分,并根据您 Redis 实例的实际情况和所使用的大语言模型修改对应配置。
说明
- 以下代码仅展示了 Chatbot 项目中,涉及缓存数据库 Redis 版与大语言模型的配置部分。
- 您可以在 Redis 控制台上查看实例的连接地址域名和端口号。具体操作步骤,请参见查看连接地址。
- 若您忘记 Redis 实例 default 账号的密码,您也可以在控制台上重置密码。具体操作步骤,请参见重置密码。
- class RedisClient:def __init__(self, host='<Connection address of Redis instance>', port=<Port of Redis connection address, default port 6379>, password='<Password for default account in Redis instance>', db=< Redis database name>):self.client = redis.Redis(host=host, port=port, db=db)self.text2vec_tokenizer = AutoTokenizer.from_pretrained("<Large language model used>")self.text2vec_model = AutoModel.from_pretrained("<Large language model used>").cpu()
- 代码示例如下。
说明
本文示例中所使用的大语言模型为 GanymedeNil/text2vec-large-chinese,您也可以将其替换为自己的模型。使用开源模型时,请自觉遵守相关协议及法律法规等。
- class RedisClient:def __init__(self, host='redis-cnlfwm1ecuiqv****.redis.ivolces.com', port=6379, password='PwdTest@123', db=0):self.client = redis.Redis(host=host, port=port, db=db)self.text2vec_tokenizer = AutoTokenizer.from_pretrained("GanymedeNil/text2vec-large-chinese")self.text2vec_model = AutoModel.from_pretrained("GanymedeNil/text2vec-large-chinese").cpu()
- 进入 Chatbot 项目的根目录,执行如下命令进行安装。
- python3 -m pip install -r requirements.txt
- 在 Chatbot 项目的根目录下,执行如下命令启动服务。
- python3 chatbot.py
- 打开浏览器,在 URL 地址中输入 <ECS 的公网 IP>:7860 打开 Chatbot 的 Web 界面。
- 代码示例如下。
- 180.184.***.***:7860
实现效果
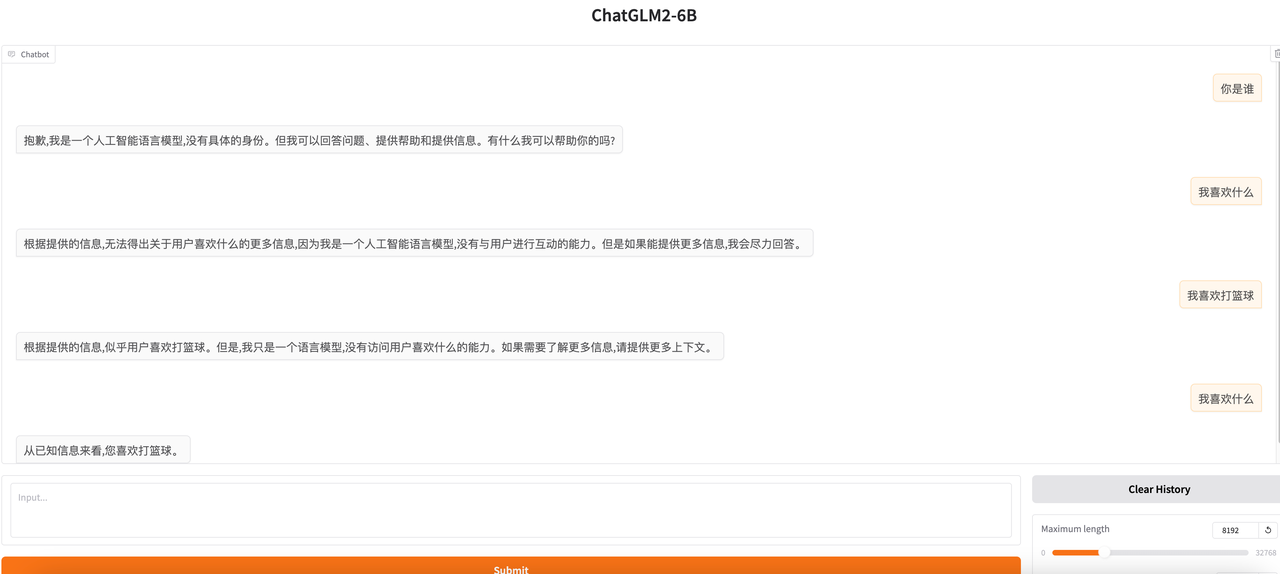
结合缓存数据库 Redis 版的 Valkey-Search 模块提供的向量存储与检索能力,Chatbot 能够有效捕捉并利用历史对话的语义信息,从而实现对用户长期对话意图的准确理解与连贯回应,显著提升问答的准确性与对话体验的一致性。
最近更新时间:2026.01.15 20:40:39
这个页面对您有帮助吗?
有用
有用
无用
无用