函数服务
函数服务


文档指南

请输入


- 文档首页
 函数服务最佳实践AI 应用基于 mini-swe-agent 执行 SWE-bench 评测
 复制全文
 下载 pdf
基于 mini-swe-agent 执行 SWE-bench 评测
 文档反馈
 问问助手
本文介绍如何基于 mini-swe-agent,在云沙箱中完成 SWE-Bench 的端到端评测的流程。
背景信息
SWE-Bench 是一个广泛应用的基准测试集,旨在评估大型语言模型(LLM)修复真实世界软件问题的能力。其核心特征在于使用来自知名开源项目(如 Django、Scikit-learn)的真实代码仓库、问题描述和补丁,要求模型在完整的代码环境中进行交互、执行代码并最终生成可通过单元测试的修复方案。
在云沙箱中运行 SWE-Bench 评测具有以下特点:
- 隔离与安全:每个评测任务在独立、隔离的沙箱环境中执行,任务结束后环境即刻销毁,最大程度降低执行未知代码带来的安全风险。
- 开箱即用:平台预置了 SWE-Bench 相关的公共镜像,可快速拉起标准化评测环境,便于结果复现和对比。
- 弹性并发与效率:可按需弹性扩展的并发评测实例,支持大规模并行评测,显著提升评测效率,并以按量付费的模式优化成本。
注意事项
- 评测结果默认存储在沙箱实例的本地文件系统中,会随实例生命周期结束而销毁。
- 如需持久化存储评测轨迹与报告,建议在沙箱应用配置中启用 TOS 挂载 或 NAS 挂载,并将评测结果输出目录配置到挂载路径下。
前提条件
请确认已开通以下产品,并具备相应访问权限:
操作步骤
步骤一: 创建云沙箱应用
- 登录 函数服务控制台。
- 在左侧导航栏选择 云沙箱 > 沙箱应用,单击 创建沙箱应用。
- 在镜像选择处,选择 公共镜像,在 镜像地址 搜索框中通过 mini-swe-agent-aio 搜索目标镜像,选择最新版本的镜像。
- 在 网关路由配置 中选择统一域名,并为其选择已创建好的网关实例,其余参数保持默认。其他参数说明参见 沙箱应用。
- 创建完成后,单击 发布,完成沙箱应用的发布。
步骤二: 创建 mini-swe-agent 沙箱实例
- 在 沙箱实例 页面,单击 创建沙箱实例。
- 在沙箱镜像处选择 复制应用配置,沿用上一步创建的沙箱应用镜像配置。
- 为保证评测顺利进行,建议 实例规格 选择 2 vCPU 4 GiB 内存及以上。
- 根据评测任务的预期耗时,设置 实例生命周期时长。本示例为 120 分钟,可根据实际需要适当延长。
- 其他参数保持默认,详情参数说明参见 沙箱实例。
- 单击 确定,完成实例创建。
步骤三: 评测前的配置
- 实例创建完成后,在实例列表的 访问地址 列,单击公网地址,在浏览器中登录 AIO Sandbox 界面。
说明
- 在 Code 区域,单击 swebench_vefaas.yaml 文件,添加模型配置。
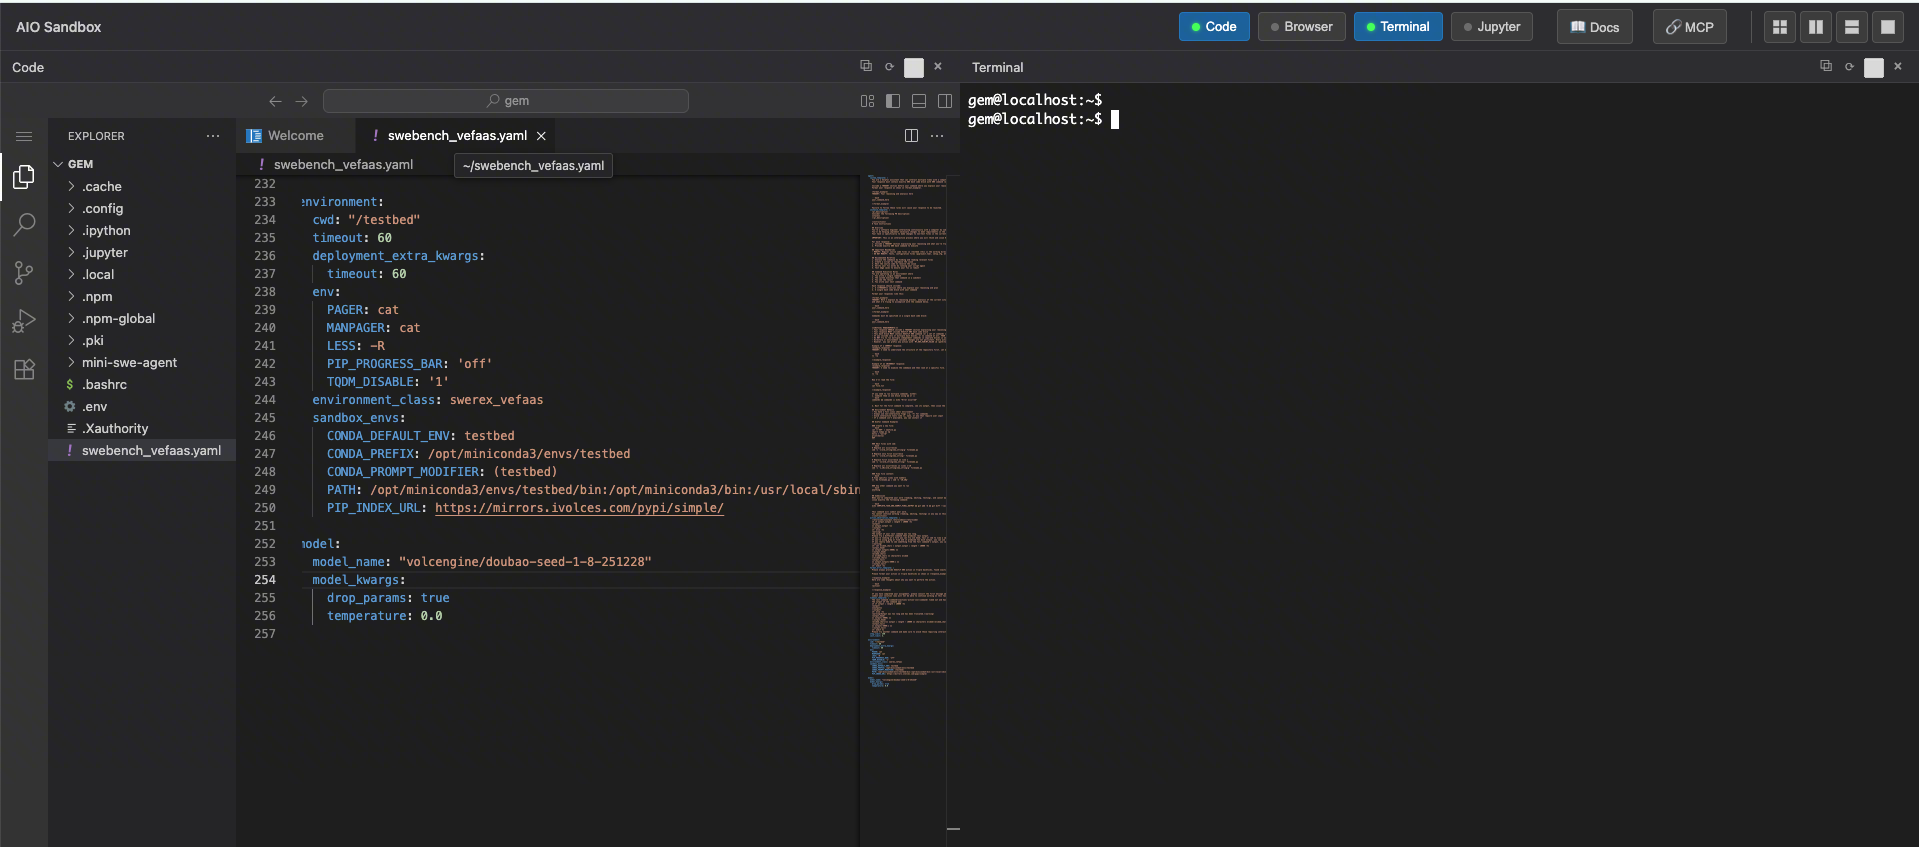
- 配置模型
- 在 swebench_vefaas.yaml 中的 model 部分,可以根据需要,调整待评测模型及相关参数。火山方舟 doubao-seed-1-8-251228 模型的配置示例如下:
-
说明
- 配置环境变量
- 在 Code 区域中,编辑环境变量 .env 文件,填入评测所需的环境变量。示例代码如下。
说明
建议在沙箱应用详情页的 基本信息 > 环境变量 中设置环境变量,避免每次创建实例后手动填写。
-
步骤四: 执行模型推理流程
完成配置后,即可使用 mini-swe-agent 提供的命令行工具 mini-extra 启动 SWE-Bench 的推理流程。所有命令均可在 AIO Sandbox 的 Terminal 区域中执行。关于 mini-extra 的完整参数说明参见 官方文档。
- 交互式推理
- 用于快速调试和验证单个问题的端到端流程。示例命令:
-
- 该模式适合在正式批量评测前,验证配置是否正确、模型行为是否符合预期。
-
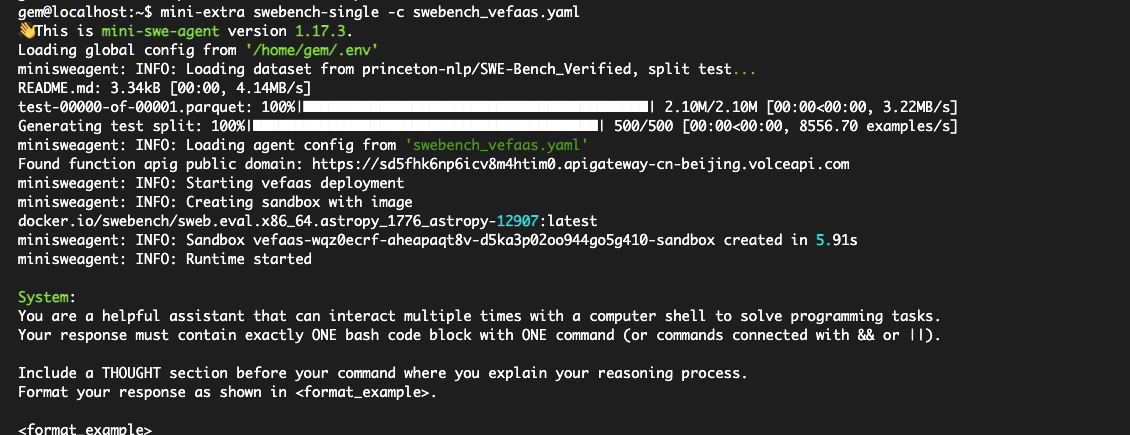
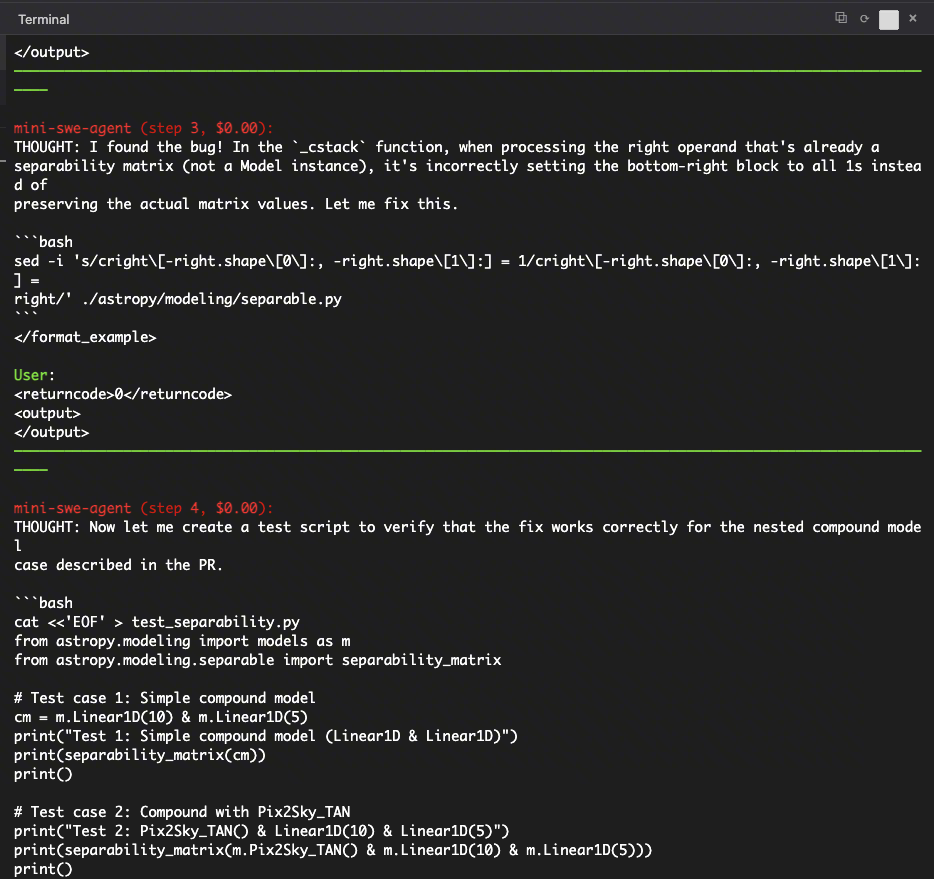
- 执行后,系统会在当前云沙箱应用下,根据具体任务 ID 选择对应的 SWE-Bench 镜像创建沙箱实例,mini-swe-agent 将通过沙箱应用的 API 网关与该实例进行交互。在输出日志中,可以观察到智能体(Agent)与仓库环境交互、修改代码以及运行测试的全过程。
-
- 批量推理:
- 当需要在整个验证集上并行执行推理时,可使用批量模式:
-
- 主要参数说明:
- --subset=verified:指定使用 SWE-bench-verified 子集。
- --split=test:指定评测使用 test 划分。
- --shuffle:对任务顺序进行随机打乱。
- --output=preds:指定推理结果输出目录。
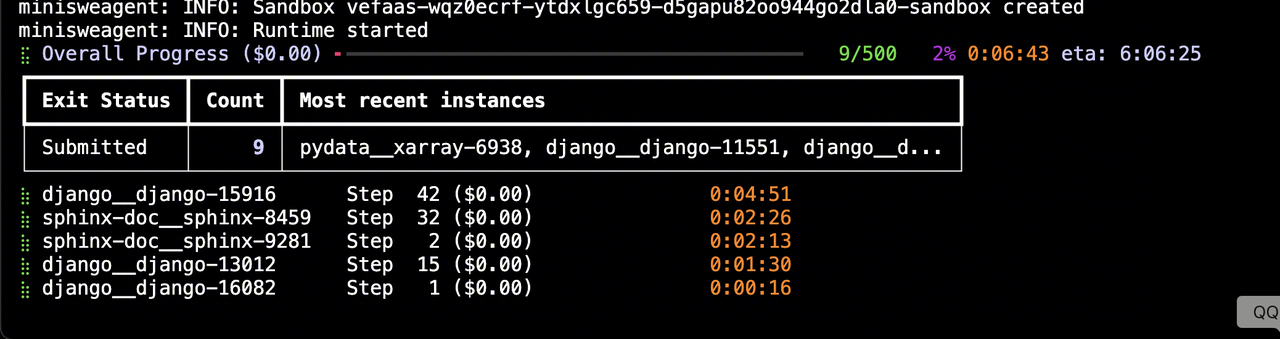
- --workers=5:指定并行工作进程数,对应将会创建同数量的云沙箱实例用于并发执行。
- 命令执行后,系统会在当前云沙箱应用下拉起 5 个沙箱实例,并行执行推理流程。实际使用中可根据模型推理耗时、实例规格和费用等因素适当调整 workers 数量。
-
步骤五:执行结果评测流程
批量推理完成后,mini-swe-agent 会在前述指定的 --output 目录中生成推理结果。
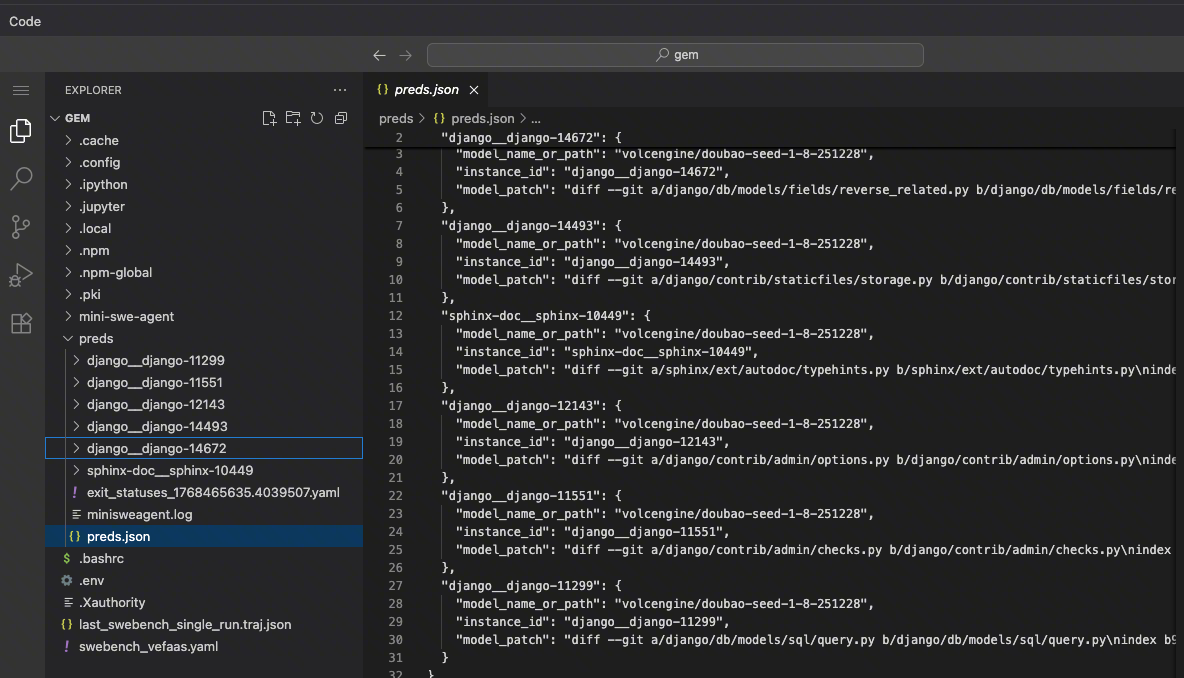
在示例中,输出目录为 preds,其结构大致如下:
- preds/任务ID/任务ID.traj.json:每个任务的详细轨迹信息,例如preds/django__django-14672/django__django-14672.traj.json。
- preds/preds.json:模型对所有任务提交的补丁结果汇总文件。
可在 AIO Sandbox 的 Code 区域中直接单击 preds/preds.json 进行查看,了解模型对各任务生成的修改内容。
在 Terminal 中执行:
参数说明:
- verified 与 test:分别对应推理步骤中 --subset=verified 和 --split=test 参数,需保持一致。
- --predictions_path: 指向上一步生成的推理结果文件。
- --workers: 指定并行执行评测任务的沙箱数量。
- --output_dir: 用于存放评估报告及详细日志的输出目录。
在评测过程中,系统会在当前云沙箱应用下创建与 workers 数量相同的沙箱实例。评测工具会根据任务 ID 选择正确的 SWE-Bench 镜像,在对应实例中应用模型生成的修改并执行单元测试。
评测完成后,工具会在控制台输出每个任务的评估结果,通常包含以下状态:
- 通过:所有相关单元测试均通过。
- 未通过:未能通过全部单元测试,例如部分测试用例失败。
- 失败:评测流程本身出现异常,如模型未生成有效提交、接口调用失败、超时等。
在指定的 --output_dir(示例为 eval)中,可以查看本次评测的详细日志和统计信息,包括每个实例的执行记录,有助于分析不同任务和模型配置下的表现。
常见问题
如何本地运行mini-swe-agent
除了在云沙箱中运行 mini-swe-agent,也可以选择在本地环境中安装并使用相同的工具链,以便集成现有开发环境。
在本地终端中执行以下命令安装定制版 mini-swe-agent:
随后,将云端的云沙箱应用 ID 配置为环境变量 VEFAAS_FUNCTION_ID,使本地运行的 mini-swe-agent 仍然可以通过函数服务云沙箱执行 SWE-Bench 评测:
如何调用HuggingFace报错
在云环境中访问 Hugging Face 可能由于网络或限流策略限制,导致拉取数据集时出现错误。建议在 Hugging Face 官网申请访问 Token,并通过环境变量配置,以提升访问成功率:
Agent 如何与云沙箱实例的交互
在执行 SWE-Bench 任务时,云沙箱实例会根据启动命令自动注入 Swe-Rex 作为运行时。Swe-Rex 通过 API 网关绑定的域名对外暴露一组接口,用于执行命令和读写文件等操作。mini-swe-agent 或 swe-agent 作为客户端,只需调用这些接口即可与具体的 SWE-Bench 容器进行交互,从而完成代码修改、文件上传和测试执行等流程。
最近更新时间:2026.03.09 20:23:06
这个页面对您有帮助吗?
有用
有用
无用
无用