全站加速
全站加速


- 文档首页
 全站加速AI 加速网关产品简介什么是 AI 加速网关
 复制全文
 下载 pdf
 文档反馈
 问问助手
AI 加速网关是基于全站加速(DCDN)边缘网络构建的模型服务网关,为大模型服务(MaaS)的 API 调用提供统一入口与加速能力。您可以将火山引擎方舟、第三方模型服务商及自部署的大模型 API 统一接入网关,通过全球加速节点就近转发请求以降低跨地域调用延迟,并借助模型路由、语义缓存、限流、预算管理和用量监控等能力,简化大模型应用的开发与运维。
为什么需要 AI 加速网关
在业务中集成多个大模型时,开发者通常会遇到几类共性问题,而 AI 加速网关正是围绕这些问题设计的:
常见问题 | 网关对应能力 |
|---|---|
🔄 协议不兼容 | 将多家模型收敛到一个入口,客户端通过统一的 OpenAI 兼容协议即可调用任意后端模型。 |
🌐 跨域高延迟 | 依托加速节点就近接入并优化回源链路,降低调用延迟与丢包。 |
⚠️ 单点故障风险 | 支持在实例内配置多个同类模型,通过主备容灾与负载均衡策略保障高可用。 |
💰 成本失控风险 | 通过语义缓存、工具精选降低单位请求开销,并以预算管理为用量设置上限、主动控制成本。 |
概括来说,AI 加速网关提供一个统一的流量入口,让“接入多家模型、就近加速、容灾高可用、成本可控”这些原本需要自行拼接和维护的能力,收敛为一处配置即可获得。
工作原理
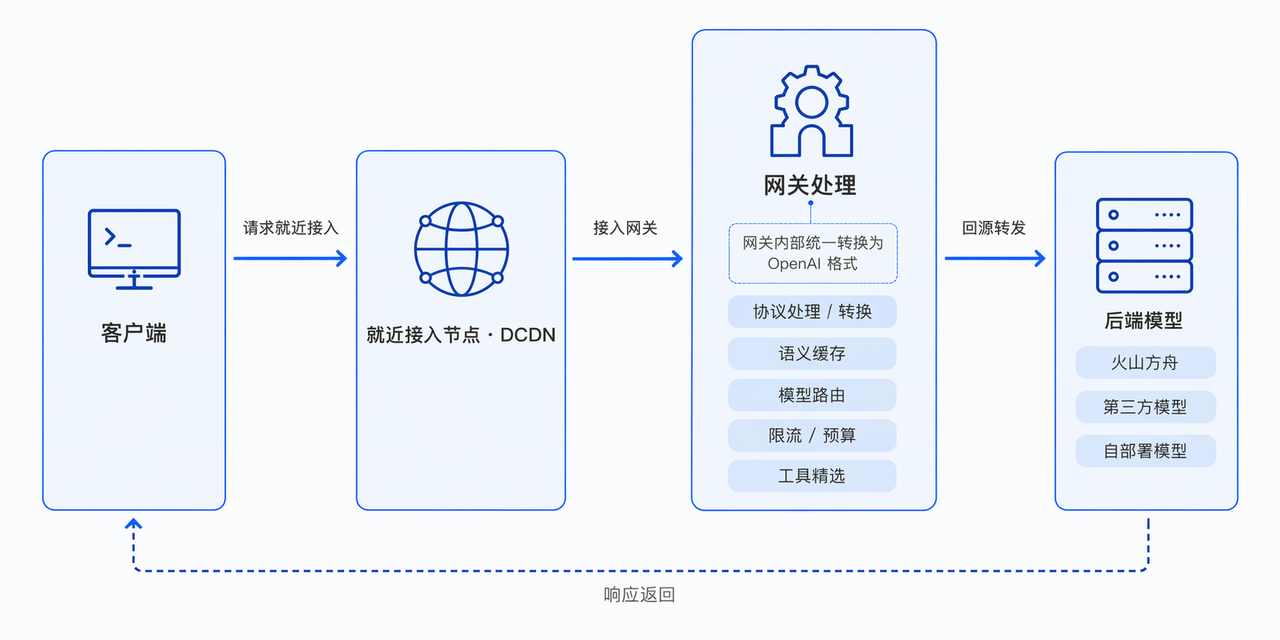
AI 加速网关作为客户端与后端大模型之间的中间层,一次完整的调用会经过以下环节:
- 就近接入:客户端将请求发送到网关实例的服务地址(
BaseUrl,由实例的加速域名构成)。请求经 DCDN 全球加速节点就近接入,并通过优化的回源链路转发,降低跨地域传输延迟。 - 协议处理:在 OpenAI 兼容协议 方式下,网关将请求统一转换为标准 OpenAI 格式,屏蔽各厂商协议差异;在 协议透传 方式下,网关原样转发厂商原生协议,仅提供请求加速。
- 网关能力处理:对于 OpenAI 兼容协议的请求,网关在转发前依次应用已配置的能力——命中语义缓存则直接返回缓存结果,不再回源;对携带大量工具的请求执行工具精选;按模型路由策略选择目标模型;并结合限流与预算管理进行流量和用量管控。
- 回源与返回:网关将处理后的请求转发给选定的后端模型,接收响应后(必要时转换回统一格式)返回给客户端,同时记录请求数、Token 用量等指标供监控查询。
其中,模型路由、语义缓存、限流、预算管理、工具精选等能力均依赖网关的协议转换,仅在 OpenAI 兼容协议下可用;协议透传方式仅提供请求加速。两种方式的差异详见调用方式说明。
参考信息
了解 AI 加速网关的核心概念、产品定位、能力与费用,可参考以下文档:
- 基本概念:AI 加速网关涉及的核心术语与概念说明。
- 产品优势:相比自建方案,选择 AI 加速网关的核心理由。
- 功能特性:模型服务支持、调用方式、路由、缓存与限流、预算管理、工具精选、监控等能力模块。
- 调用方式说明:OpenAI 兼容协议与协议透传的差异、能力对照与选型建议。
- AI 加速网关计费说明:计费项、计费方式、刊例价与资源包。
操作指引
按使用阶段,可参考以下文档完成从上手到进阶的操作:
- 快速上手 MaaS API 加速:创建并配置第一个网关实例,完成一次实际调用以验证加速效果。
- 控制台操作指南:创建实例、查询监控数据、获取模型调用密钥等控制台操作。
- 实践教程:多模型路由、预算管理、缓存与限流、工具精选、自部署模型接入等场景化配置教程。
- 开发指南:模型调用示例代码、自部署模型接入协议规范、Realtime API 调用等开发参考。