全站加速
全站加速


- 文档首页
 全站加速AI 加速网关实践教程配置多模型路由
 复制全文
 下载 pdf
 文档反馈
 问问助手
当您在单个 AI 加速网关实例中接入多个模型时,可以通过配置模型路由策略,将请求按规则分发到不同模型,从而实现流量的负载均衡、服务的主备容灾或按性能动态择优。本教程介绍如何为网关实例配置多模型路由。
适用场景
- 负载均衡:将请求按权重分散到多个同类模型,平摊单模型的调用压力,适用于高并发或多供应商成本分摊场景。
- 性能择优:网关基于各模型近期线上调用的首 Token 时延(Time To First Token,TTFT)表现,自动将请求路由到当前响应最快的模型,适用于对流式输出“首字等待”体感敏感的文本生成场景。
- 主备容灾:为核心服务配置备用模型,在主模型故障或超时时自动切换,保障业务连续性。
使用须知
- 模型路由属于 OpenAI 兼容协议下的网关能力。协议透传方式不经过网关的路由处理逻辑,不支持负载均衡、主备容灾与性能择优。
- 路由策略仅在同一调用类型的模型之间生效。不同调用类型(如文本生成与图像生成)的模型独立调度,不互相容灾或均衡。
- 接入火山方舟 Agent Plan 时,Agent Plan 作为一个整体维度参与负载均衡与主备容灾(不适用于性能择优),默认权重分配和主备目标均指向语言模型
ark-code-latest,不拆分为多个模型条目。
前提条件
- 已完成 快速上手 MaaS API 加速,即已创建 AI 加速网关实例并获取到
BaseUrl和API Key。本教程在该实例基础上配置多模型路由,不再重复实例的创建步骤。 - 已准备至少两个同一调用类型(如均为文本生成)的模型及其 API Key。
操作步骤
步骤一:进入实例编辑页面
- 登录 全站加速控制台。
- 在左侧导航栏,选择 AI 加速网关 > 实例管理。
- 找到目标实例,在 操作 列单击 编辑。您也可以在 实例详情 页面单击右上角的 编辑。
步骤二:选择路由策略并添加模型
在 模型配置 区域完成以下配置。
选择 模型路由策略:
- 负载均衡:为每个模型设置 权重(1-100 的整数),网关按权重比例分配请求。
- 性能择优:无需设置权重或调整顺序,网关依据各模型近期线上调用的首 Token 时延(TTFT)动态择优,自动将请求路由到当前响应最快的模型。
说明
性能择优策略仅对已开启流式响应的文本生成模型生效;实例内的非流式或非文本模型将回退按主备容灾策略调用。
- 主备容灾:按模型顺序(可拖拽调整)调用,主模型失败或超时后自动切换到下一优先级的备用模型。
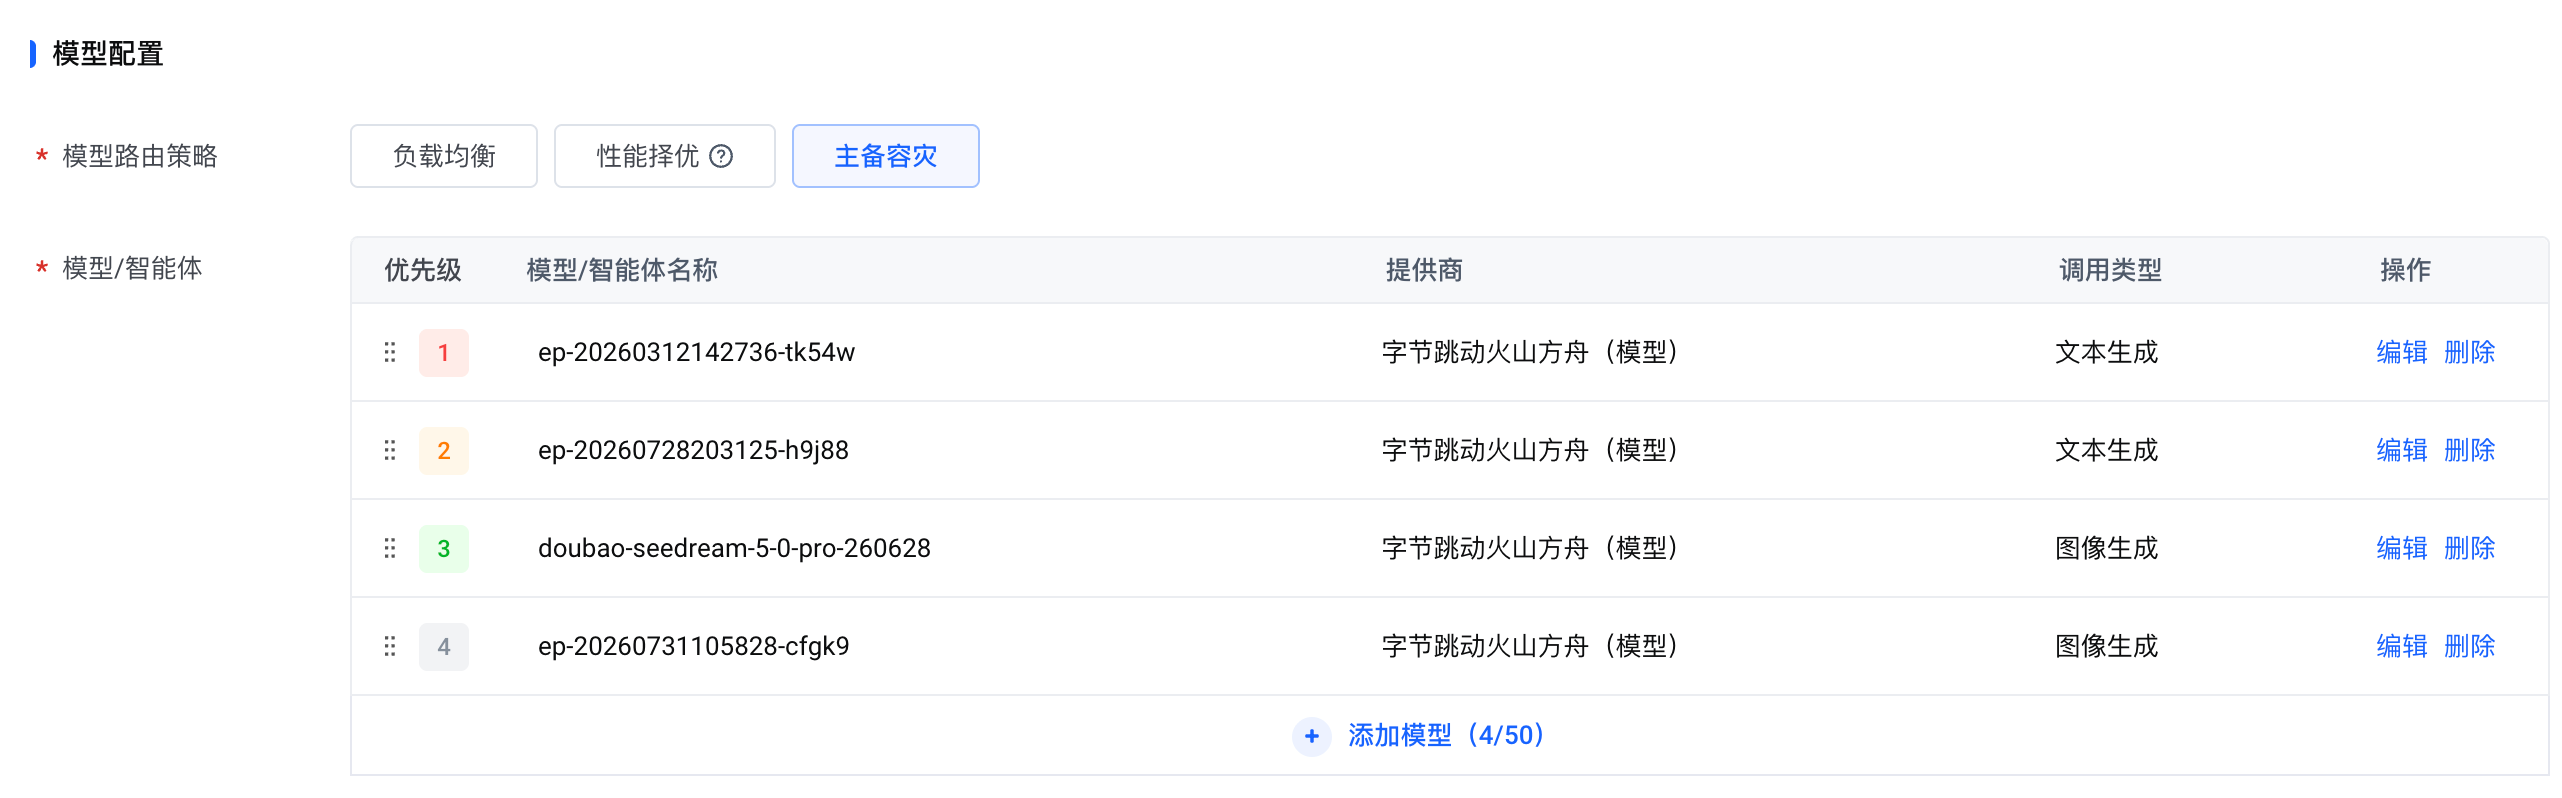
单击 添加模型,接入至少两个同一调用类型的模型。各模型类型的配置项详情,请参见创建 AI 加速网关实例的配置说明。
单击 确认 保存配置。
步骤三:获取调用示例并选择模型
在 实例详情 页面的 请求方式 区域,可以获取实例的 BaseUrl、API Key 以及 Curl、Python 调用示例。当实例绑定了多个模型时,选择不同模型会影响调用示例中的 model 字段取值,进而影响实际的路由行为。建议根据所配置的路由策略选择相应取值。
路由策略 | 模型选择( | 网关行为 |
|---|---|---|
主备容灾 | 选择您最希望优先访问的模型名称。 | 网关按配置的主备顺序调度,主模型失败或超时后自动切换到备用模型。 |
性能择优 | 无需特殊设置。无论填写任一已配置模型,还是留空或设置为 | 对已开启流式响应的文本生成请求,网关忽略 |
负载均衡 | 建议留空或设置为 |
|
说明
路由策略仅在同一调用类型(如文本生成、图像生成、语音识别等)的模型之间生效。不同调用类型的模型独立调度,不互相容灾或均衡。
常见问题
Q:刚切换到性能择优策略后,请求好像没有明显路由到更快的模型?
性能择优存在冷启动过程。网关需要先积累各模型近期线上调用的 TTFT 样本,样本积累期间会在同一调用类型的模型之间随机分发请求;待样本充足后,才会稳定地将请求路由到当前响应最快的模型。因此在刚启用策略、或某个模型长期无流量后重新参与调度时,短期内可能观察不到明显的择优效果,属于正常现象。
Q:如何确认某次请求实际命中了哪个模型、以及触发的路由行为?
网关会在响应头中返回本次请求的实际路由结果,可用于排查与观测:
| 响应头 | 说明 |
|---|---|
X-Gw-Picked-Model | 本次请求实际命中的模型,格式为 供应商:模型。 |
X-Gw-Pick-Reason | 性能择优策略下本次选模的原因标识,取值含义见下表。 |
X-Gw-Pick-Reason 的取值及含义如下:
| 取值 | 含义 |
|---|---|
argmin | 常态择优。本次选中的是当前首 Token 时延最低(响应最快)的模型。 |
stale_random | 补样本调度。存在样本不足的模型(如刚接入、冷启动或近期无流量),本次随机选中以补充其首 Token 时延样本。 |
epsilon | 探索性调度。为避免长期锁定单一模型、及时发现表现反超的模型,本次随机选取一个模型复测。 |
single | 当前调用类型下仅有一个可用模型,无需择优,直接使用该模型。 |
all_unhealthy | 当前所有候选模型近期调用均异常,本次随机选取一个进行探测,以便尽快恢复正常调度。 |
相关文档
文档 | 说明 |
|---|---|
创建并配置第一个 AI 加速网关实例的完整流程,是本教程的前提。 | |
实例各配置项的完整说明,包括模型路由策略的参数详情。 | |
为实例或模型设置用量限额,超限后按路由策略切换模型。 |