火山方舟
火山方舟


资源

请输入


- 文档首页
 火山方舟平台功能开通管理
 复制全文
 下载 pdf
开通管理
 文档反馈
 问问助手
开通管理介绍
在 开通管理页,您可以清晰了解当前商品的开通状态、免费额度消耗情况、模型用量上限使用情况、推理输入/输出定价、LoRA精调定价、全量精调定价、模型级别限流。可以在当前页面配置开通/关闭服务、查看模型的接入文档。

开通模型服务
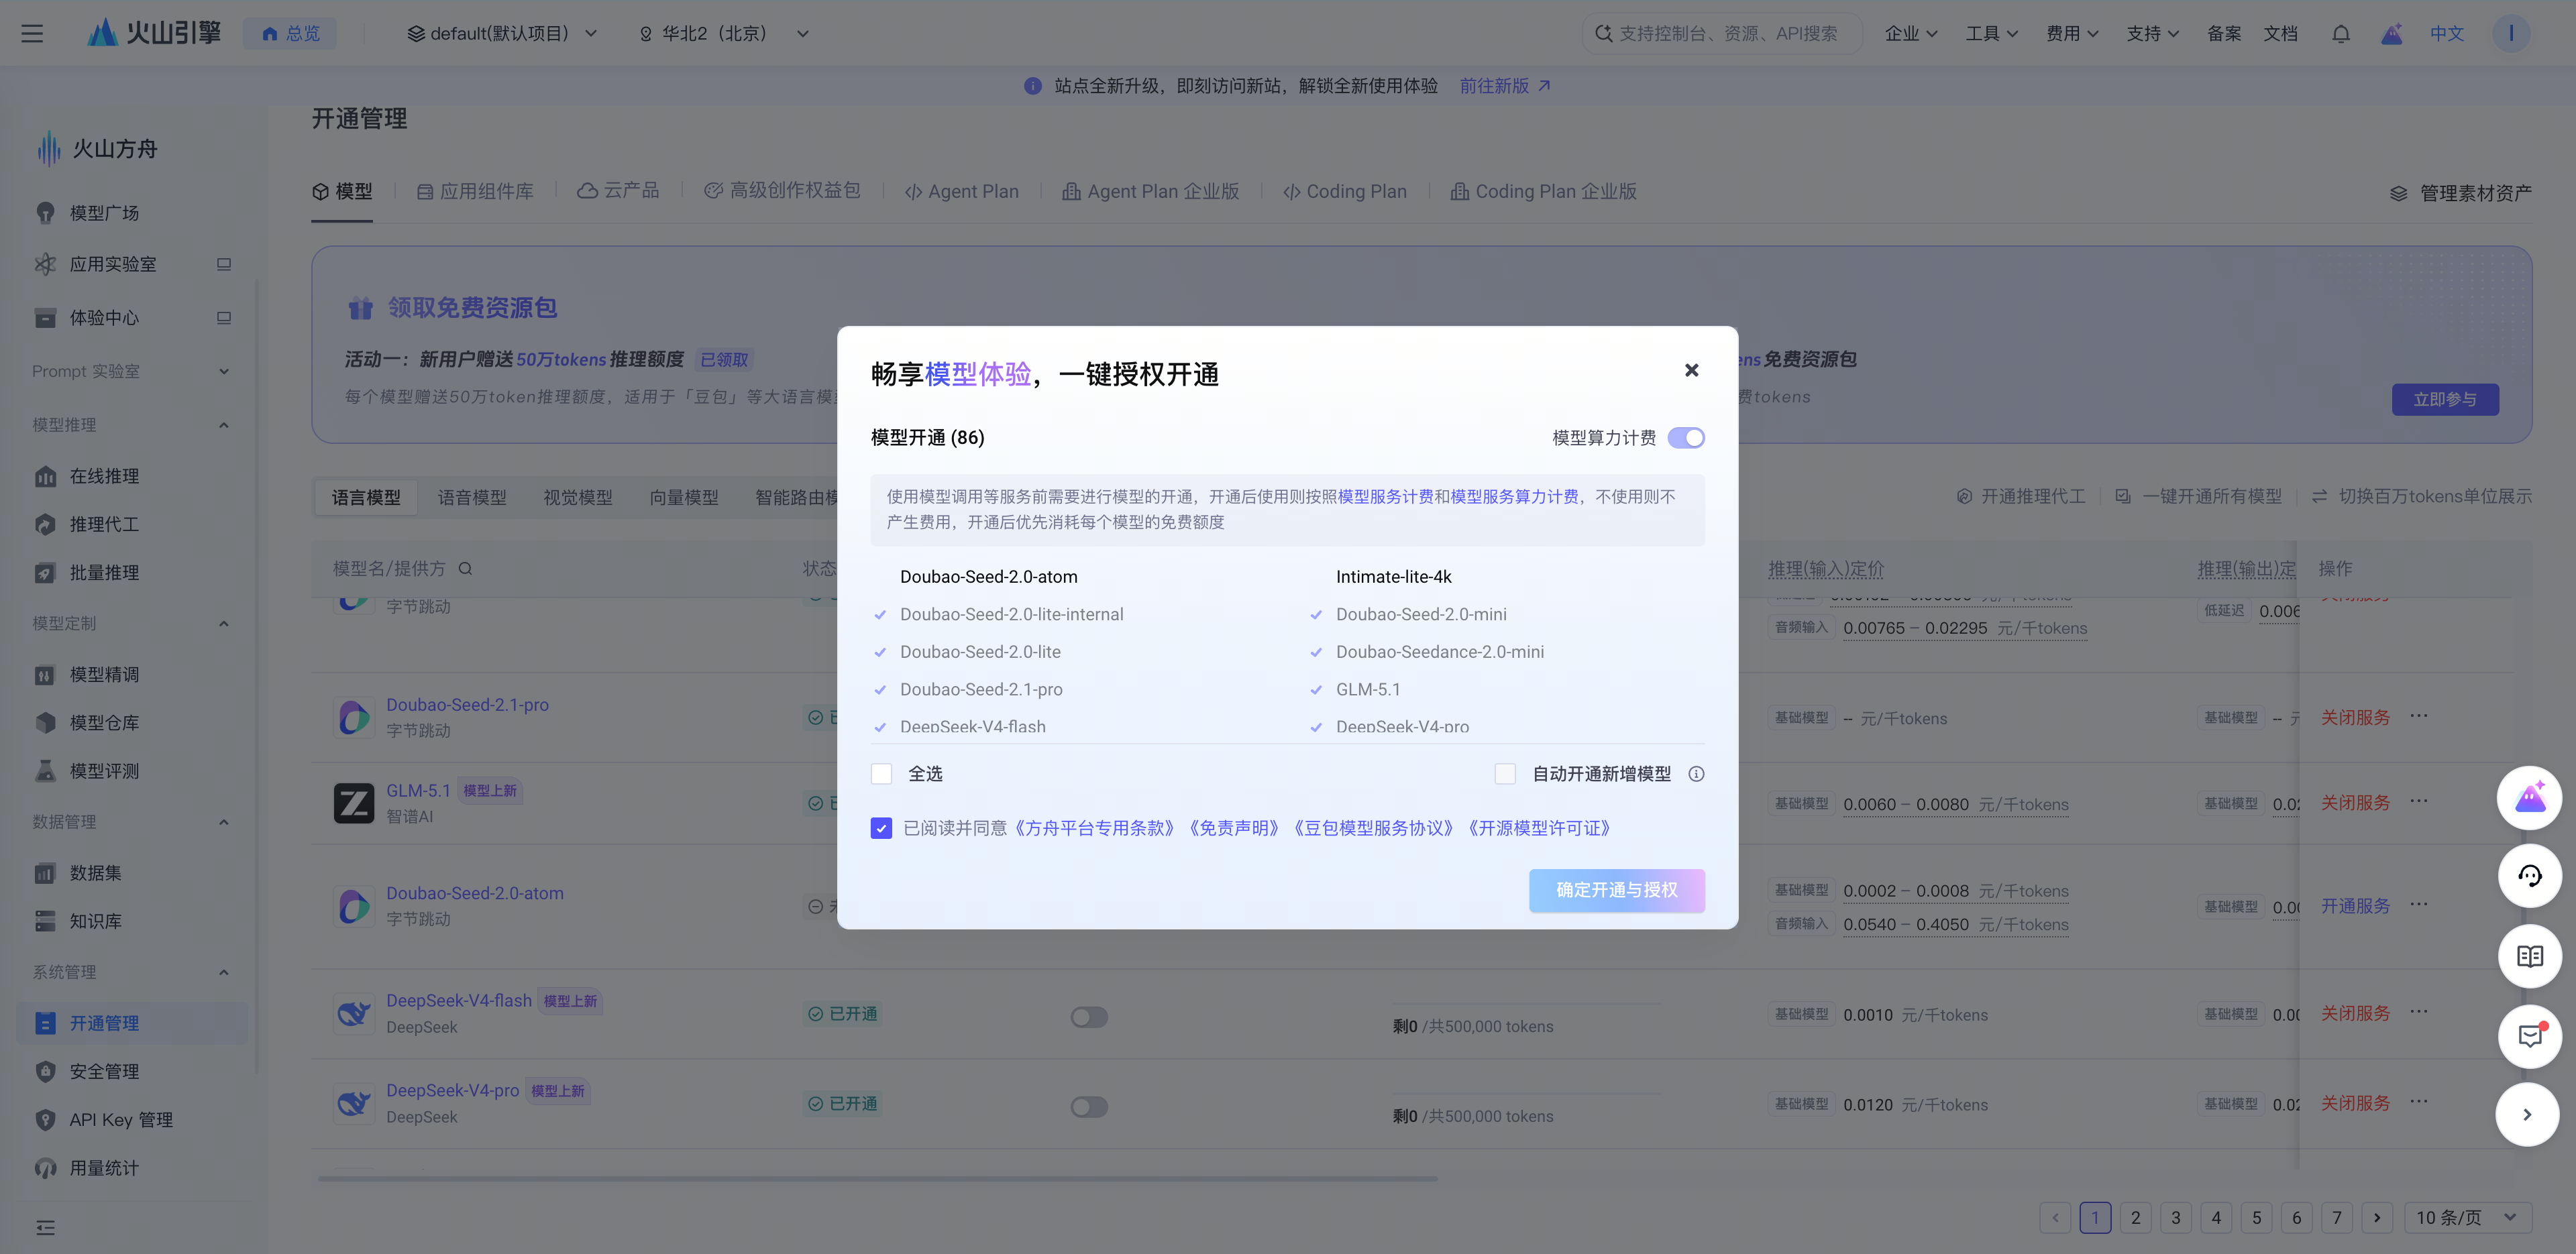
点击目标模型的开通服务按钮,在弹窗中勾选全选及自动开通新增模型。开启后,系统将自动为后续新增且支持自动开通的模型开通服务。
Doubao-Seed-Evolving 模型不在自动开通范围内,如需使用,请在开通管理页手动开通模型服务。
开通状态说明
免费额度说明
安心体验模式说明
安心体验模式是针对未开通过模型服务的新用户更方便体验免费额度设计的,可以保障您免费体验模型推理服务,又不产生费用。在安心体验模式下,您调用推理 API 时仅消耗平台赠送的 50w token 免费额度,接近免费额度后服务将暂停,避免产生额外费用。详情请参见 安心体验模式细则说明。
注意
免费额度仅适用于抵扣模型推理消耗的 token(50w 免费 token),不能抵扣使用各类插件、知识库等产生的费用。
用量上限设置
为控制模型调用量、减少超用扣费风险,火山方舟提供两级用量上限:
注意
为避免超用,当请求预估用量超过剩余可用额度时,将请求失败并触发用量上限错误,请注意确认剩余用量是否充足。
模型用量上限
说明
- 账号下同一模型的所有推理接入点共享该模型用量上限。
- 控制台显示的免费额度数据存在小时级延迟。如希望通过模型用量上限来控制仅使用免费额度,建议您设置的上限值尽量小于控制台显示的免费额度剩余值。
- 模型用量上限值仅可移除或者重新设置,账号下每个模型的模型用量上限设置需间隔至少 2 小时。
接入点用量上限
说明
- 账号下所有接入点仍共享该模型用量上限;多个接入点用量上限值之和可能超过模型总用量上限值。
- 即使本接入点未达到设置的接入点用量上限,也可能因其他接入点用量过高而触发模型维度的用量上限,建议根据业务优先级合理设置各接入点用量上限值。
- 接入点用量上限值创建后重新更改需至少间隔 2 小时,请根据业务需求合理设置。
功能限制
- 适用范围限制:模型用量上限、接入点用量上限均仅适用于在线推理场景,不支持批量推理。
- 兼容性限制:
- 前缀缓存功能与模型用量上限、接入点用量上限均不可同时启用。
- 接入点用量上限 与 低延迟(Fast)推理 互斥:开启其一后另一开关不可用。
- 模型类型限制:语音、多模态向量化模型暂不支持设置用量上限。
- 付费模式限制:
- 仅支持为已开通且按 token 后付费 / 按张数后付费的模型或接入点设置用量上限。
- 若模型的推理接入点已购买 TPM 保障包或模型单元,暂不支持设置用量上限。
模型级别限流说明
当前对每个账号下的每个基础模型设置了RPM(Requests Per Minute,每分钟请求数)及TPM(Tokens Per Minute,每分钟tokens数量)的调用限制。
说明
- 依赖同一个基础模型的所有模型推理接入点,共享同一个基础模型的模型级别限流。
- 模型调用限制仅包含按照Token后付费的模型调用,不包含购买的模型单元。
- 每一个模型推理接入点的限流可以在模型 推理接入点 的详情页进行自定义配置。
定价说明
最近更新时间:2026.09.30 16:22:03
这个页面对您有帮助吗?
有用
有用
无用
无用