火山方舟
火山方舟


资源

请输入


- 文档首页
 火山方舟实践教程强化学习最佳实践
 复制全文
 下载 pdf
强化学习最佳实践
 文档反馈
 问问助手
强化学习(Reinforcement Learning, RL)是一种机器学习范式,其核心在于通过模型或智能体在推理或与环境的动态交互中得到反馈并基于反馈实现策略优化。
具体而言,强化学习过程包括rollout、reward、组织样本、train。其中rollout是模型进行推理或智能体进行多轮推理并调用外部插件工具;reward是将推理的过程和结果送入奖励函数或模型进行评分;组织样本是根据样本信息和反馈选择合适的样本并将格式转换为训练所需要的格式;train是对模型基于样本中的prompt response和奖励分数进行训练。
方舟强化学习将以上环节进行了一定程度的封装,用户仅需选择合适的模型、数据和训练方法,无需关注训练环境、配置和训练过程。对于Model RL主要关注奖励函数的构建;对于Agent RL主要关注rollout中的agent逻辑、奖励函数的构建、训练样本的选择和格式转换。
强化学习的意义和时机
- 意义:
- 进一步加强和对齐期望偏好
- 通常意义上,我们对一个pretrain基座模型先做SFT任务,教会模型学会某种范式。但是真实环境里,产生大量带标注的语料是一件艰难且复杂的任务。因此,通过少量带标注的语料,对pretrain基座进行SFT任务后,通过RL过程对这个SFT基座进一步来对齐预期的奖励目标。
- 在RL阶段,我们需要准备一个Reward方法 和 一个Reference Model。通过Reward方法,能够进一步加强和对齐reference model采样结果达到所期望的偏好。
- 突破SFT任务的局限性
- 一般情况,SFT任务往往是希望模型能学会的范式,而不期望的方面,则需要通过RL来进行对齐。比如,我们可以在Reward方法里,通过对期望的采样结果给予正反馈分数,对不期望的采样结果给予负反馈分数打压。以此,来弥补SFT任务的一些局限性。
- 增强模型探索和泛化能力
- 对比SFT任务,RL能够允许模型自主采样,并通过返回的reward来更新调整。不同之处在于,RL没有限制模型一定要输出某个答案,而是通过reward方式来引导模型探索和学习范式,因此,能够保证模型有一点的泛化和探索能力。当然,在此过程中,我们也可以通过调整KL_Loss来调整探索程度。
- 时机:
- 接下来,我们讨论下什么时候开始去做强化学习。有以下几点建议:
- 如果你的任务是客观性任务,而且你有很准确的reward计算标准,建议尝试。
- 如果你希望抑制模型不输出某些方面内容,可以配合reward model,尝试RL任务。
- 如果你希望模型的输出具有较好的多样性,建议尝试。
以上建议,都建立在本身reference model在多次rollout能够采样出较大概率能得到reward的能力,再考虑RL,否则RL阶段的奖励会比较稀疏,效果不佳。具体建议这样做:
- 构建好评估集和评测指标
- 测试reference model在评估集上的指标表现,包括bo1和boN指标。观察模型boN指标是否显著高于bo1,且boN指标能接近预期。
选择训练方法
- DPO :Offline policy训练。当已经离线准备好偏好数据时,可选择DPO训练,详见直接偏好优化最佳实践。
- 优点:无需训练奖励模型,显存占用低,适合快速微调。
- 缺点:依赖高质量偏好数据,若数据不准确,可能导致模型学习偏差。
- PPO:Online policy训练。是一种经典的策略优化算法,通过限制策略更新的幅度来确保训练的稳定性,比如通过裁剪概率比或 KL 散度约束,防止策略偏离初始模型过远。目标函数包含策略梯度项、裁剪机制和 KL 惩罚项。在语言模型训练中,PPO 需要同时训练策略模型(Actor)和价值模型(Critic),价值模型用于估计状态价值以计算优势函数。
- 优点:稳定可控,适合复杂任务,是通用强化学习的基准算法。
- GRPO:Online policy训练。通过群体内的相对比较来优化策略,摒弃了传统 PPO 中的价值网络(Critic 模型),采用动态梯度正则化技术,引入梯度监测器和自适应正则控制器。
- 优点:解决了 PPO 的数值不稳定问题,训练崩溃率得到降低。在超大规模模型训练和多步推理任务中表现出色,训练效率高,适合资源受限场景。
- DAPO:Online policy训练。由清华大学联合字节提出,旨在解决大规模 LLM 强化学习中的问题。包含裁剪偏移、动态采样、Token - 级策略梯度损失和溢出奖励塑造等关键技术。通过动态采样技术,过滤掉零梯度数据,提高训练效率和稳定性;Token - 级策略梯度损失在长思维链强化学习场景中有助于增强训练稳定性;溢出奖励塑造可以减少奖励噪声并稳定训练。
- 优点:通过其关键技术,有效解决了长链思维场景下的 RL 训练难题,在 AIME 2024 数学推理任务上,使用 Qwen2.5 - 32B 模型达到了 50 分,超过了 DeepSeek - R1 的 47 分,且仅使用了 DeepSeek - R1 - Zero - Qwen - 32B 所需训练步骤的 50%,训练效率得到提升,收敛速度加快。
数据准备
数据格式
数据量级
不同任务所需数据量不同,一般越困难、判定规则越复杂,所需数据量越大。
可以先构建几百条数据进行尝试,根据效果指标判断是否要增加更多数据。
奖励规则配置
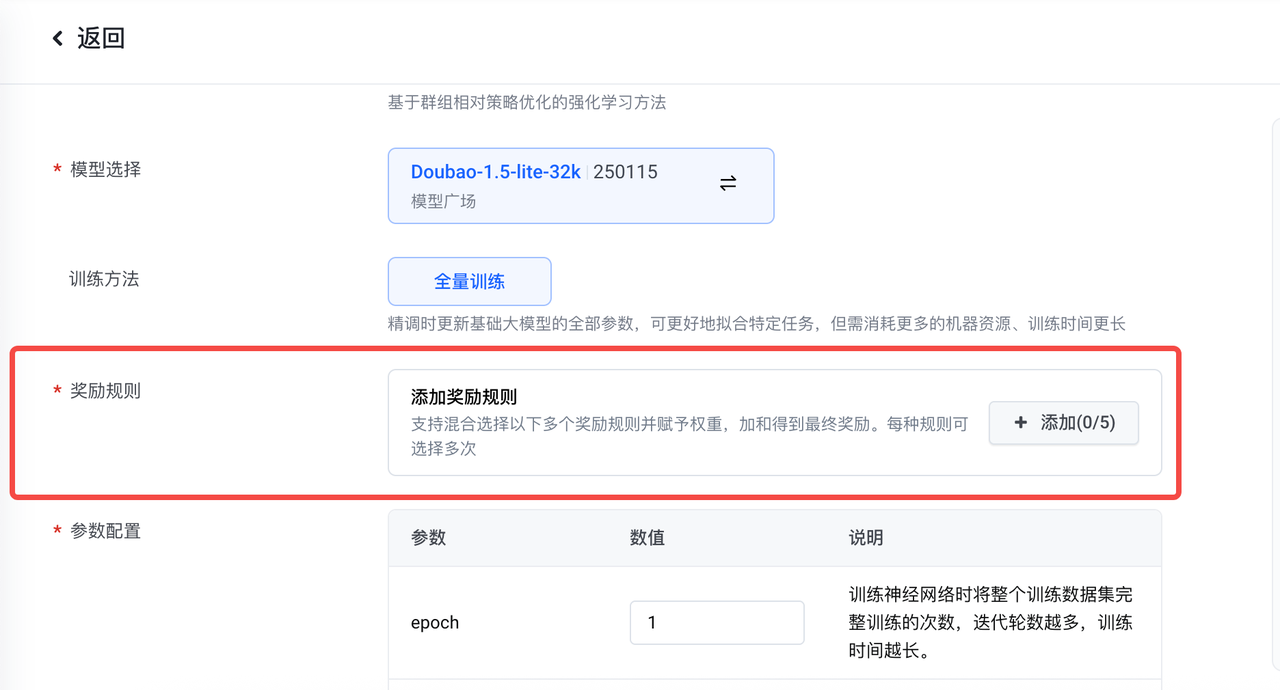
不同场景的选择
- 预置函数:
- 平台提供了常用的奖励函数供用户选择,以简化训练流程。当预置函数满足需求时,建议直接使用。
- 自定义函数:
- 当预置函数无法满足要求时,可以使用自定义函数定义reward规则。
- 奖励模型:
- 对于无明确判定规则的偏好类打分,需要使用Reward Model。可以通过自定义函数调用 方舟精调模型或基础模型+prompt 作为Reward Model,并在自定义函数中将模型输出结果解析成reward。
预置函数
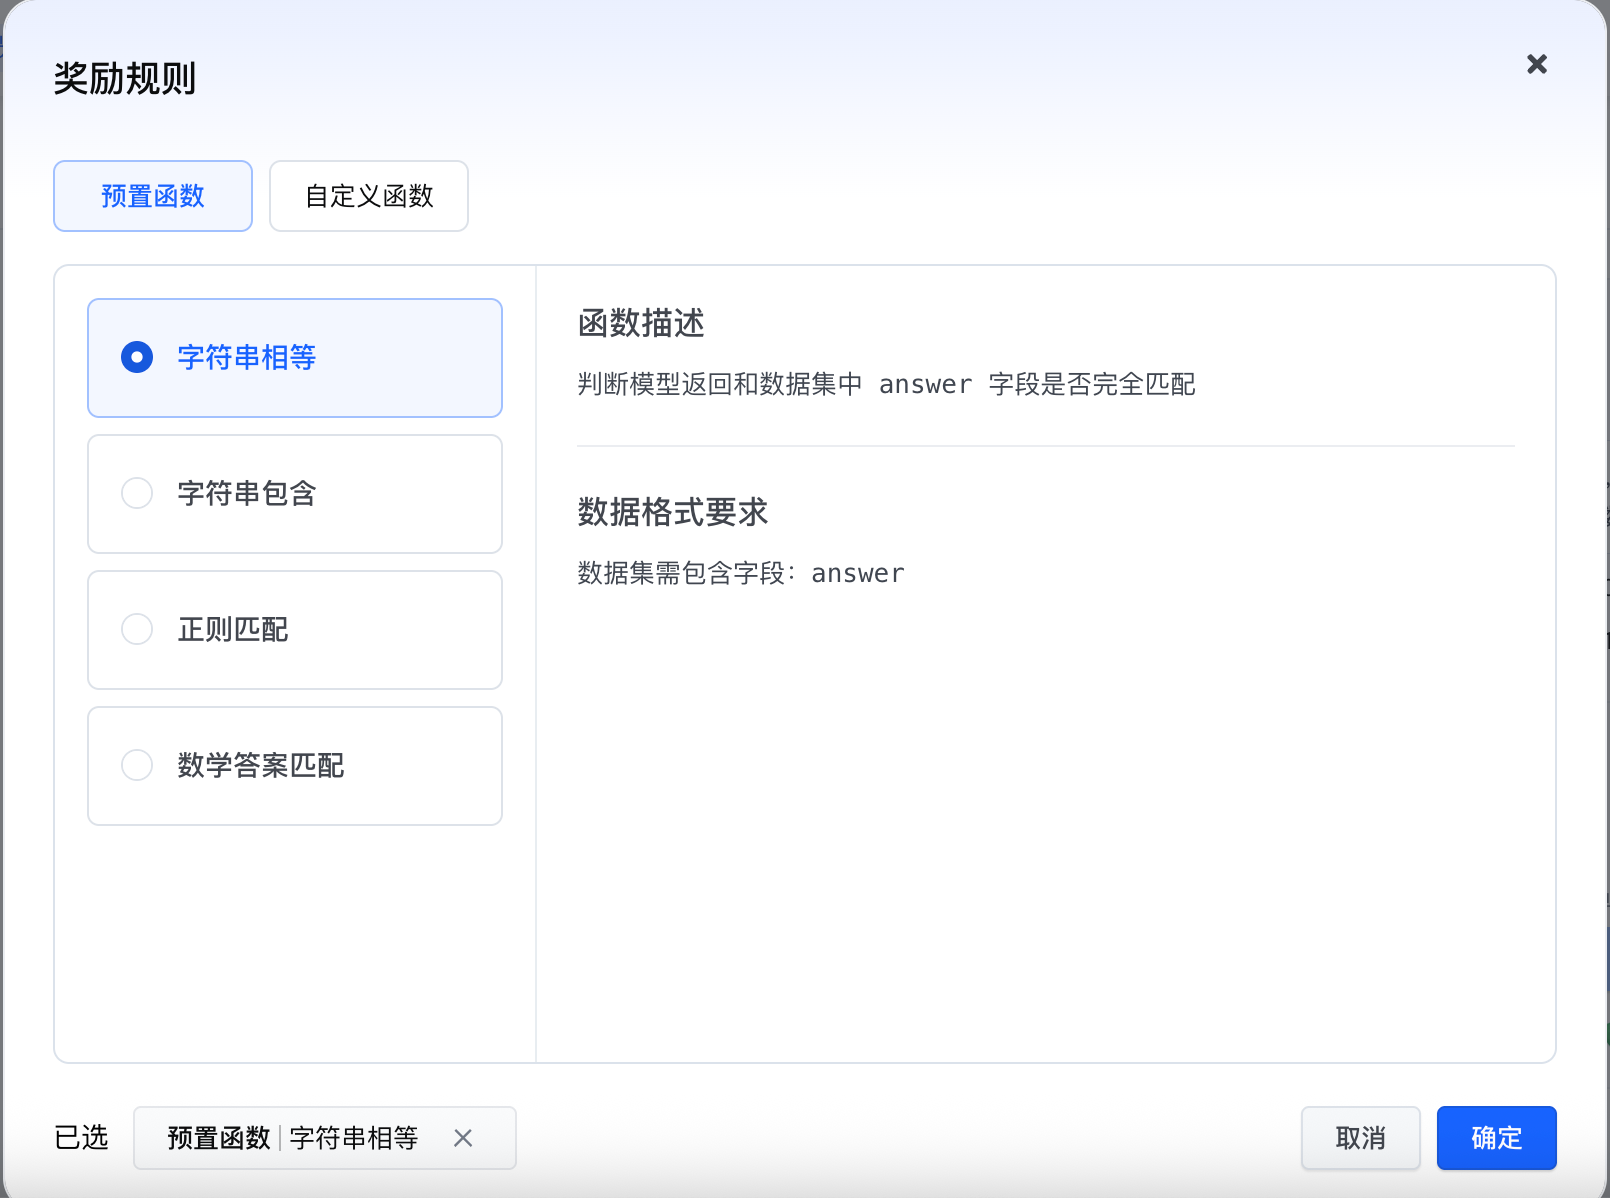
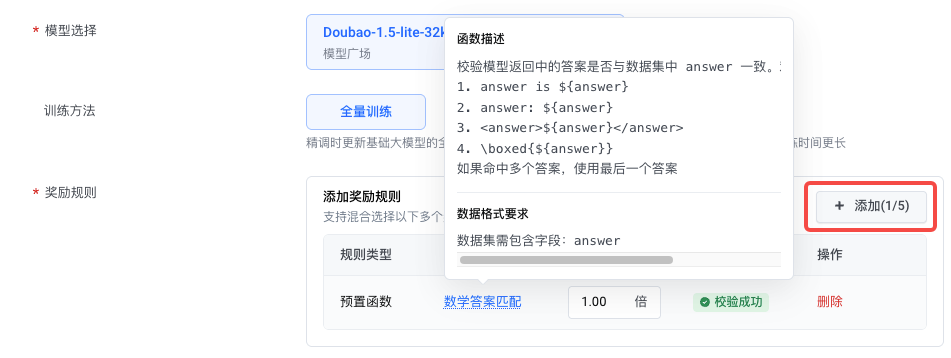
- 每种预置奖励规则可选择添加多次,具体介绍详见控制台。
- * 字符串全等:信息抽取或者文本分类等任务,可以通过答案是否完全匹配来定义reward。* 字符串包含:总结摘要类任务,可以通过和groundtruth比对关键信息是否包含来定义reward。* 正则匹配:参考问答类型任务,输出可能是按某种格式输出,可以通过提取模型采样结果中的关键信息和参考答案匹配来定义reward。* 长度惩罚:在某些任务中,我们可能不希望模型输出过于冗长的结果,那么我们可以用长度惩罚函数配合其他预置reward函数共同作用定义reward。
自定义函数
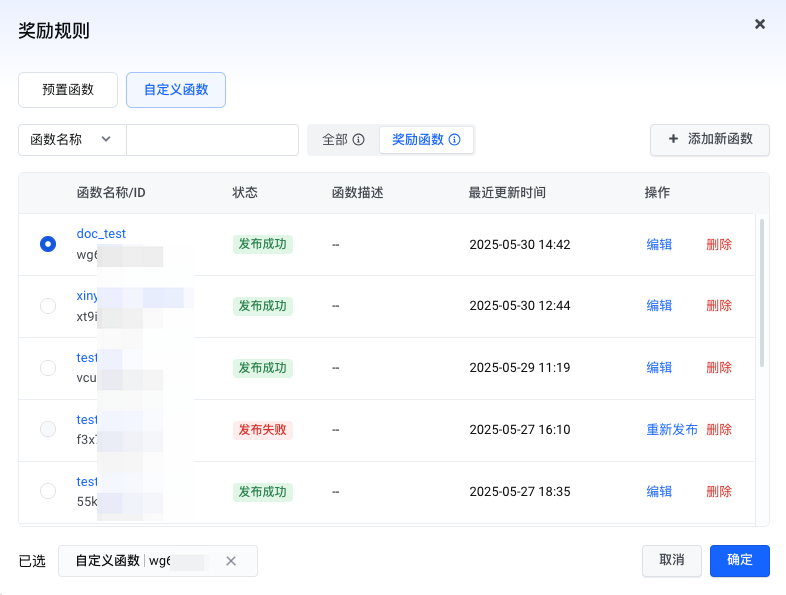
- 当预置函数无法满足要求时,可以选择自定义函数,通过Python代码的方式定义reward逻辑。比如,需要使用Reward Model时,可以通过请求推理方舟推理接入点作为Reward Model,得到输出结果解析成对应的reward。
函数签名
@dataclass
class RewardFunctionResult:
rewards: List[float]
metrics: Dict[str, float]
status: str # success/failure
error: str
def reward_fn(
context: Dict[str, Any],
sample: Dict[str, Any],
completions: list[Dict[str,Any]])-> RewardFunctionResult
入参
返回
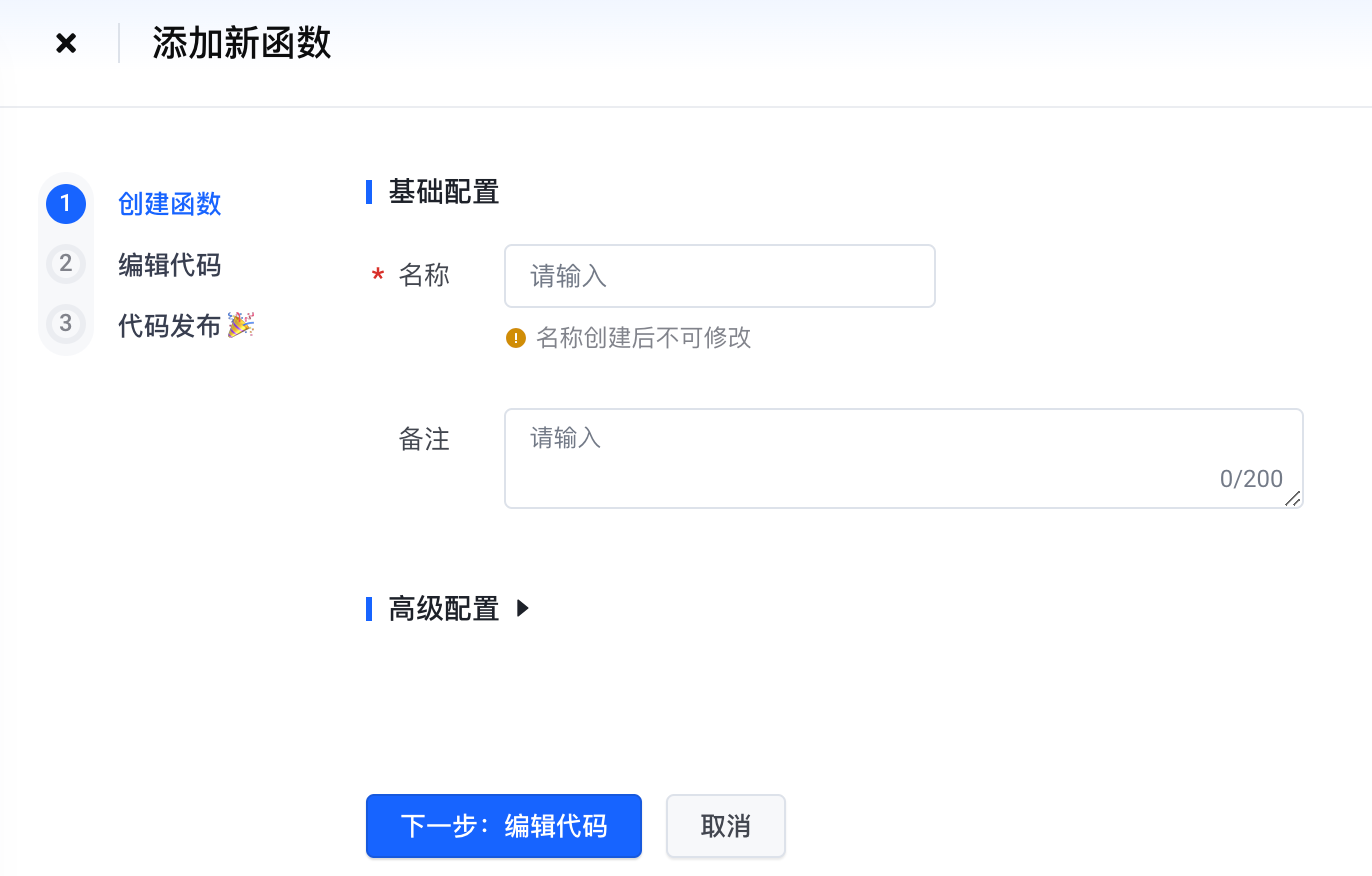
- 创建自定义函数
- 点击 添加新函数 ,输入函数名称。
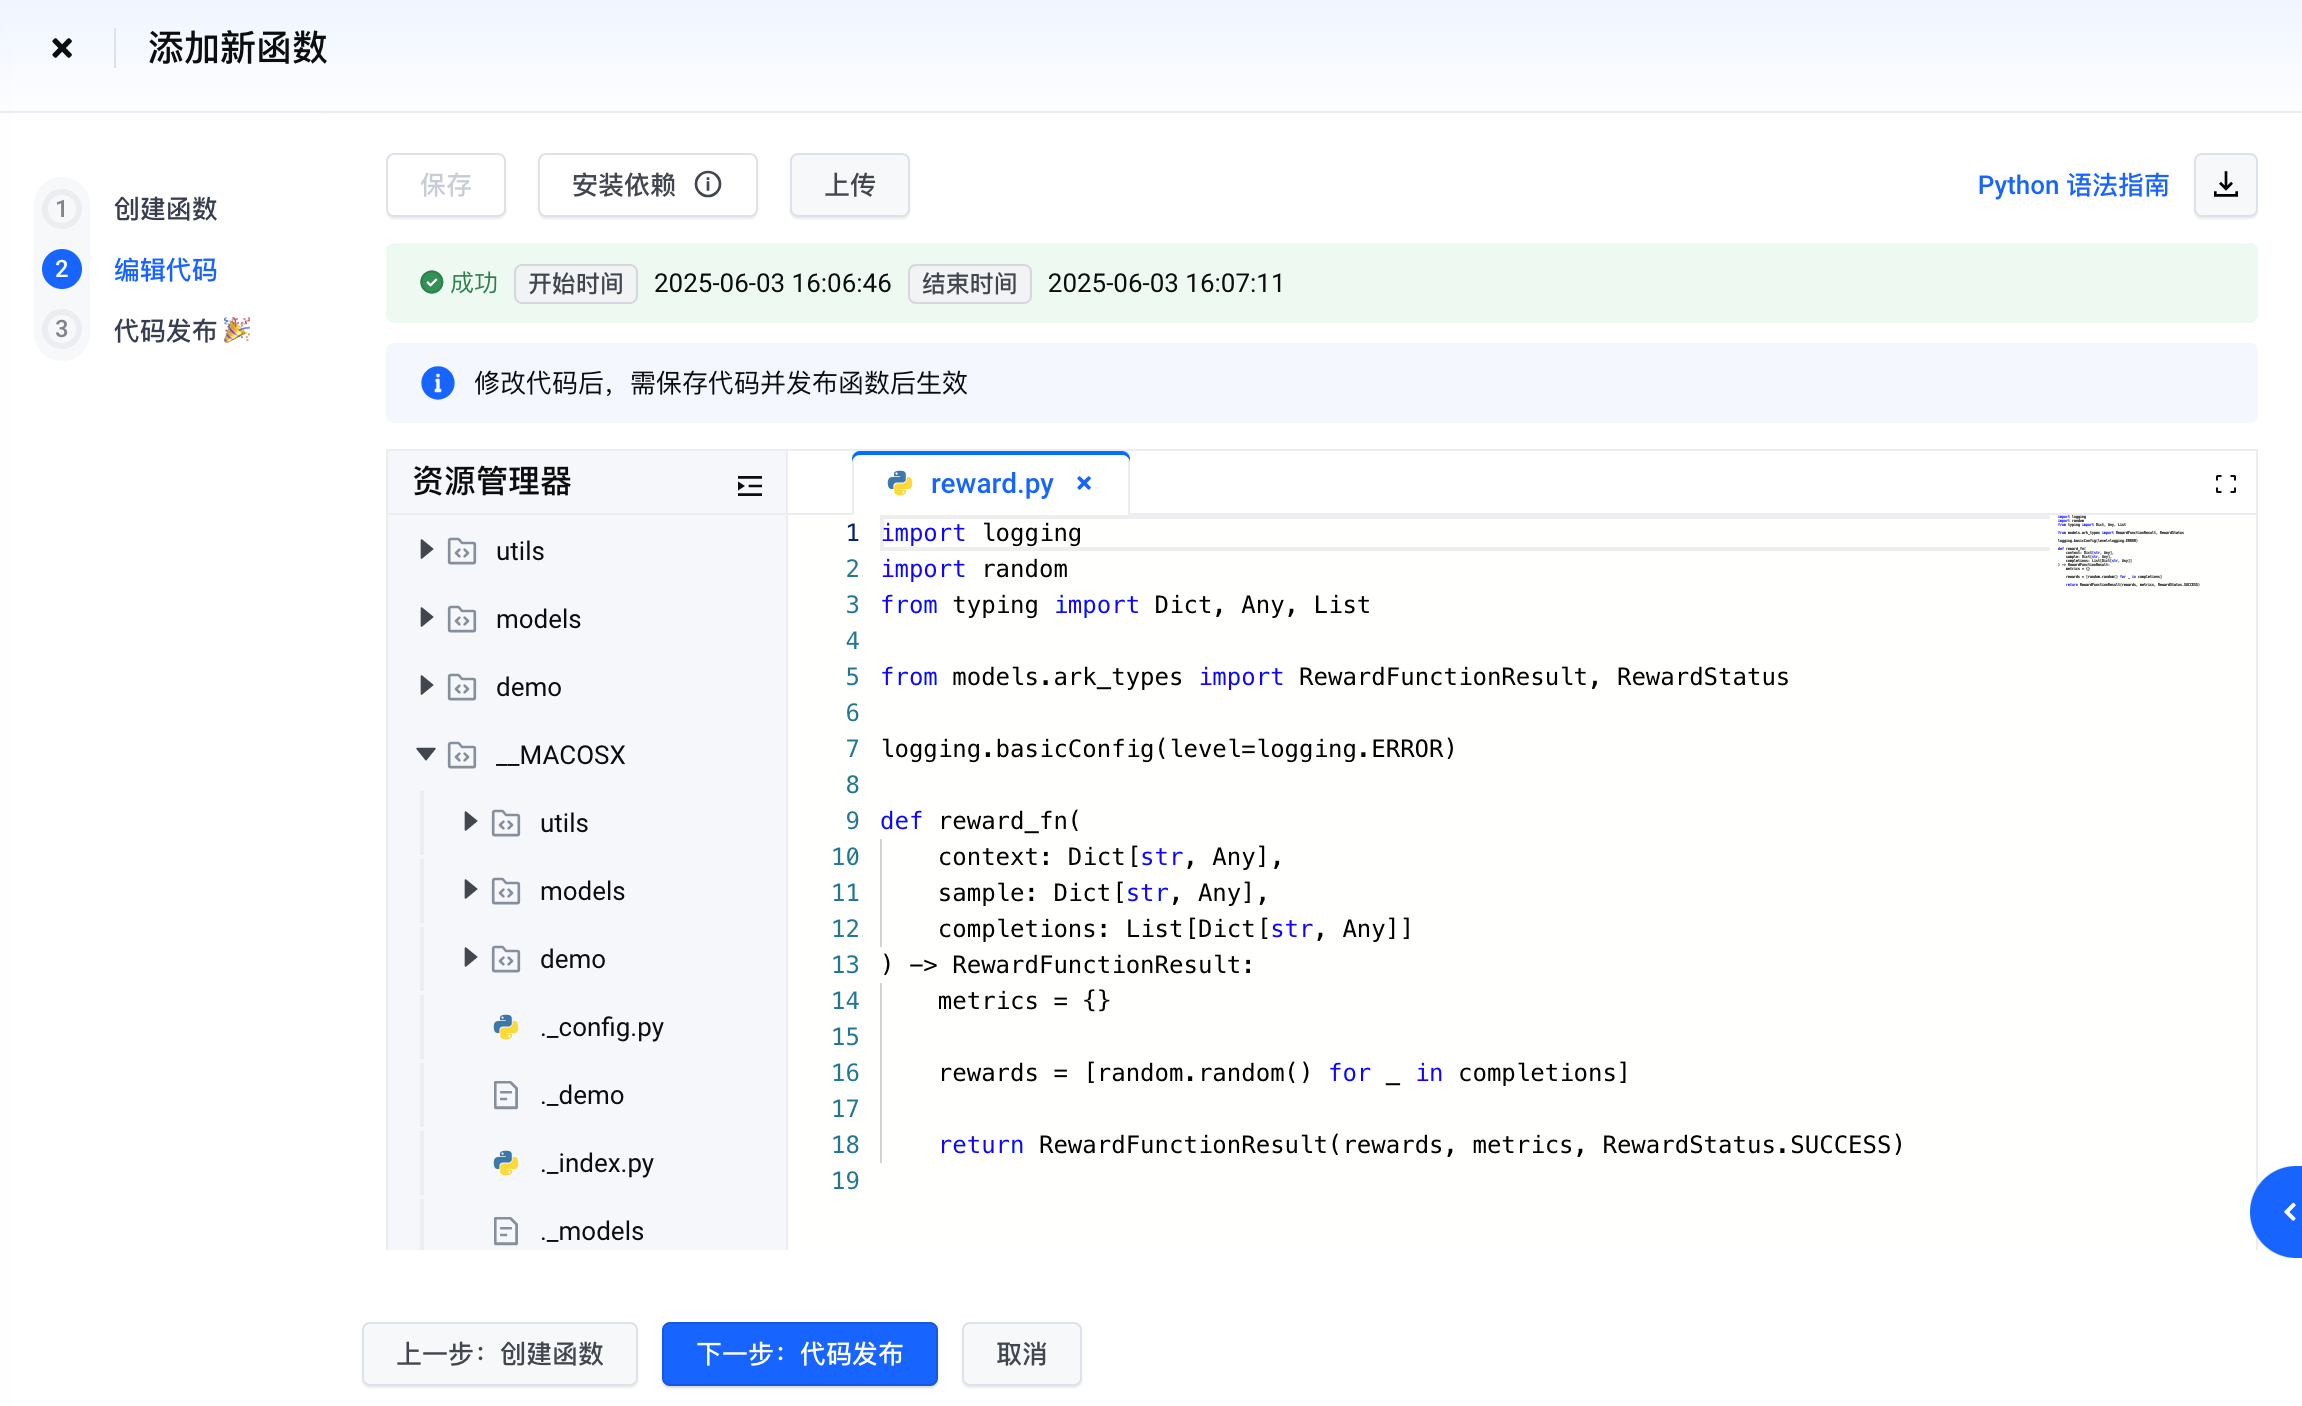
- 编辑函数
- 在reward.py中编辑自定义函数,完成后可以点击上方的 安装依赖 按钮准备好函数运行环境。
- 发布函数
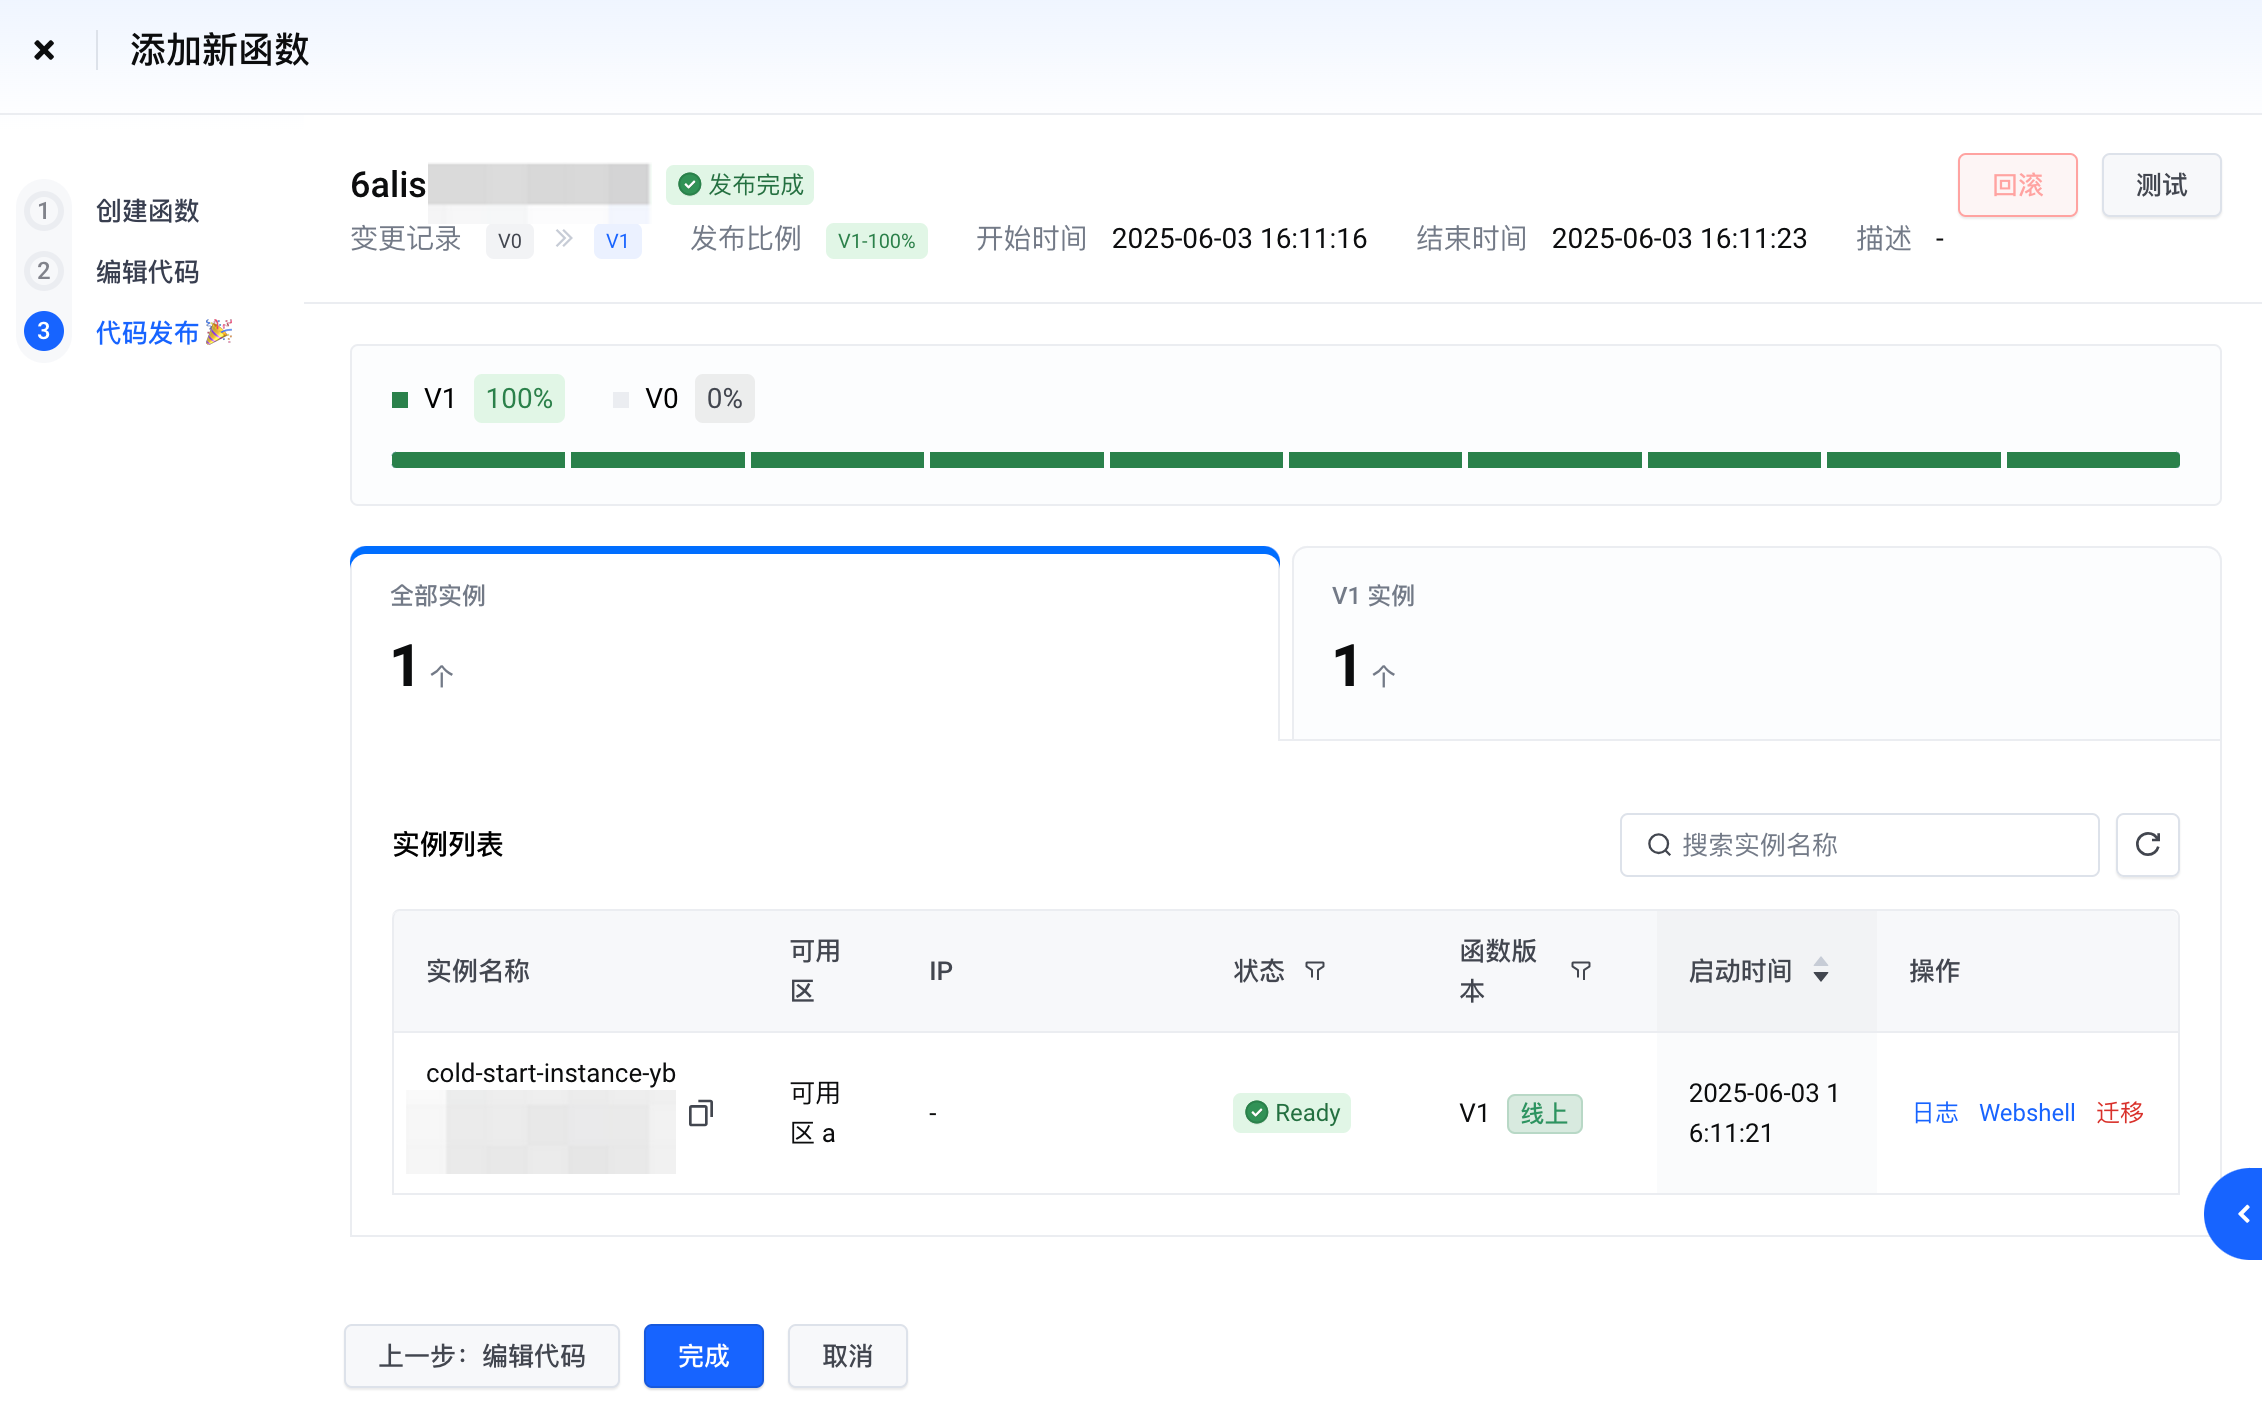
- 完成编辑后,点击 下一步:代码发布,进入代码发布页面。
- 发布完成后可以通过 测试 请求函数查看返回的奖励得分是否符合预期,如不符合预期返回上一步:编辑代码。此外还可以进行查看日志等操作。
- 如函数测试结果符合预期,点击完成结束函数创建。
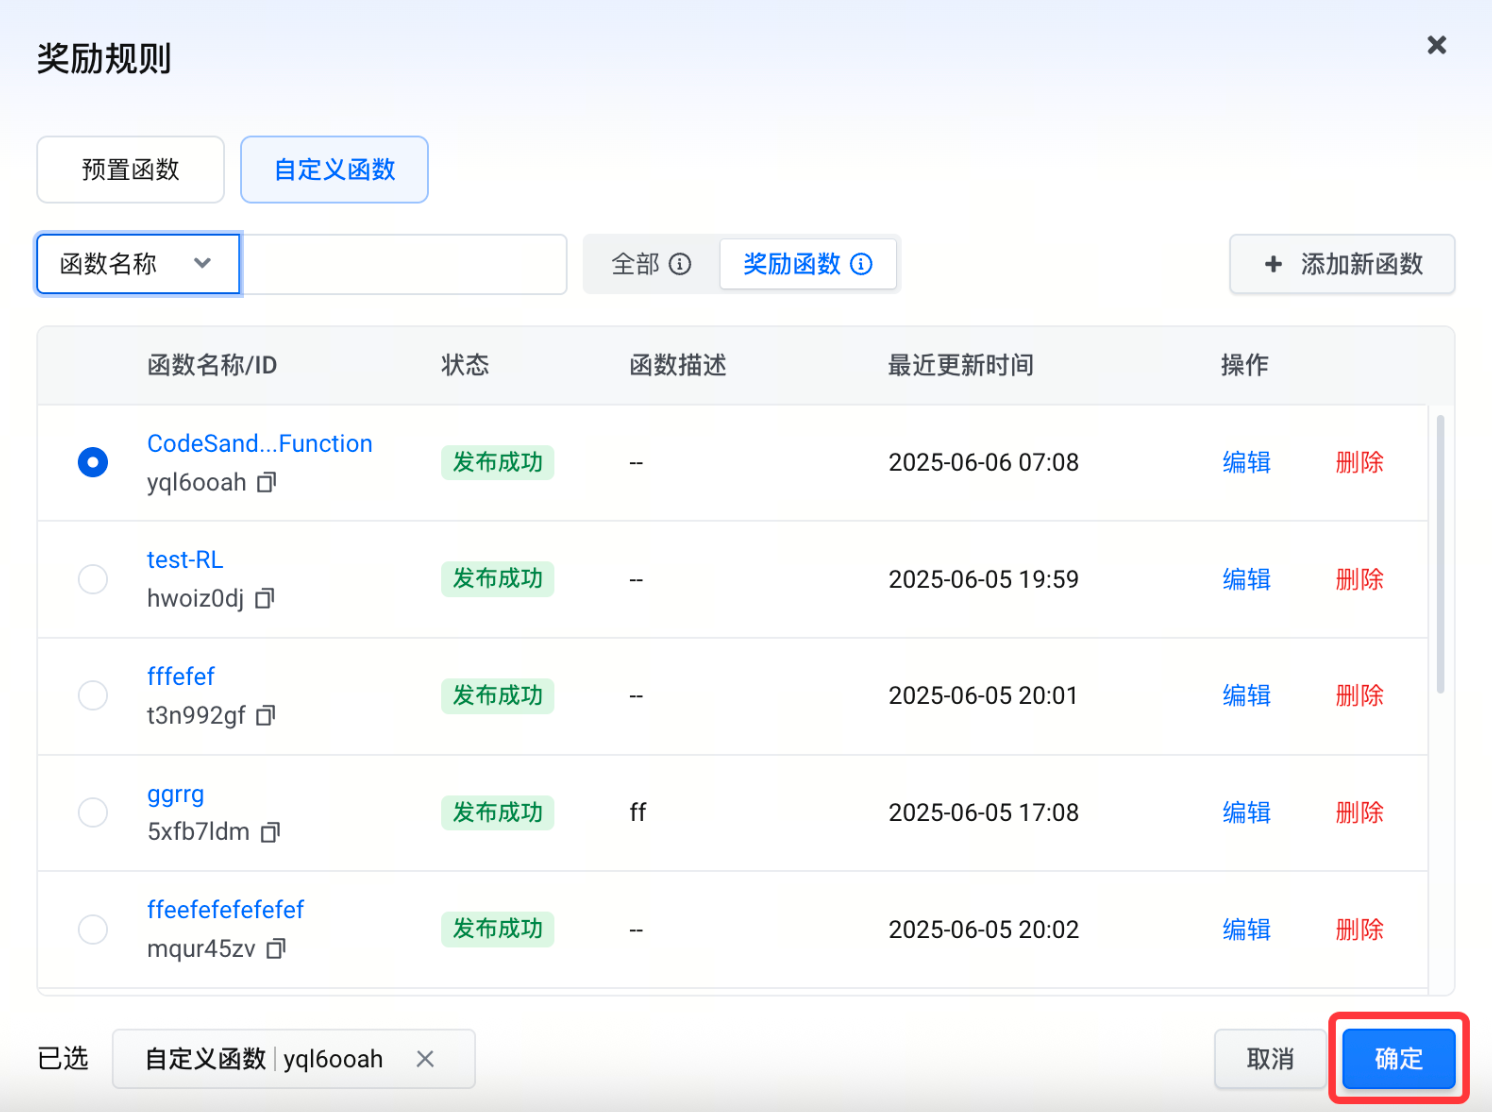
- 添加自定义函数为奖励规则
奖励混合
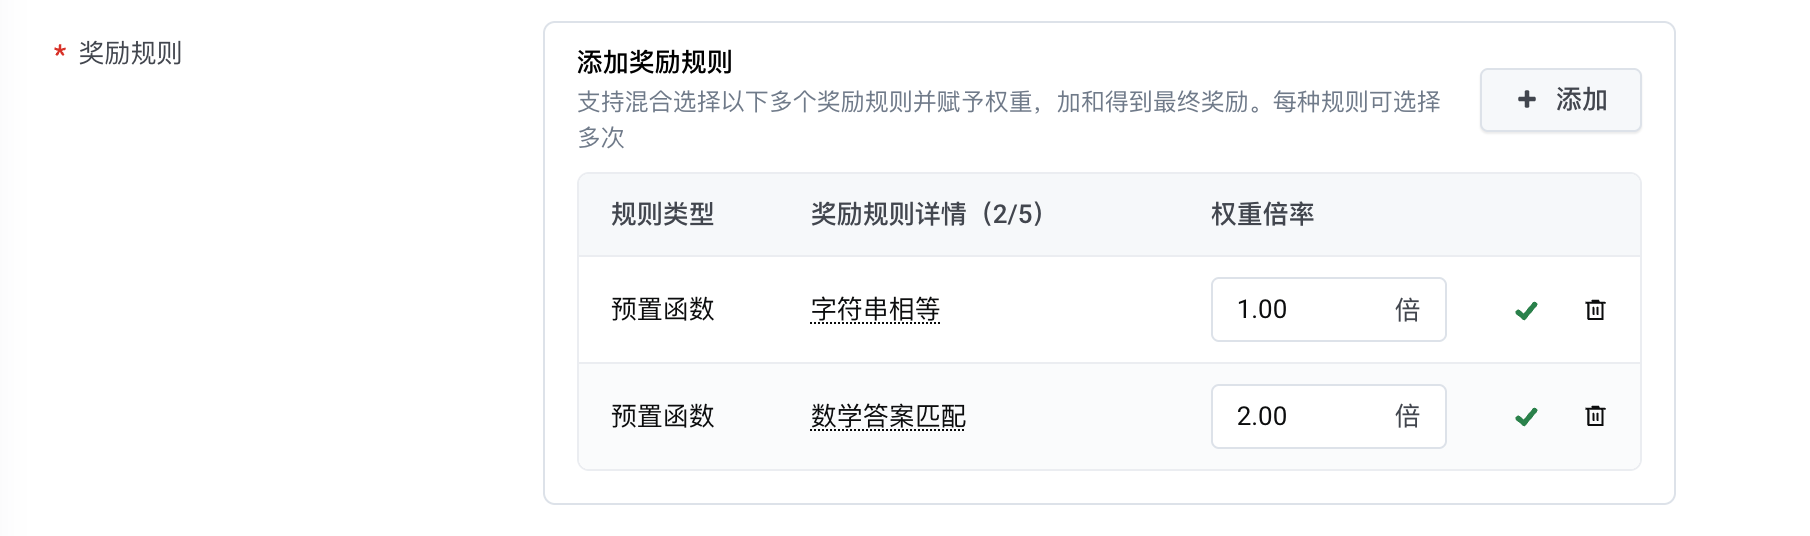
- 支持添加总共不超过5个奖励规则(包括预置函数和自定义函数),预置奖励函数可多次添加。
- 支持给每个预置函数或自定义函数设置权重倍率,最终奖励分数为各奖励规则分数加权求和
- reward = reward_1权重倍率_1 + reward_2权重倍率_2 ...
- 权重倍率 默认值1倍,最小值0.01倍,最大值1000倍,最小调整单位0.01倍
训练配置
参数配置
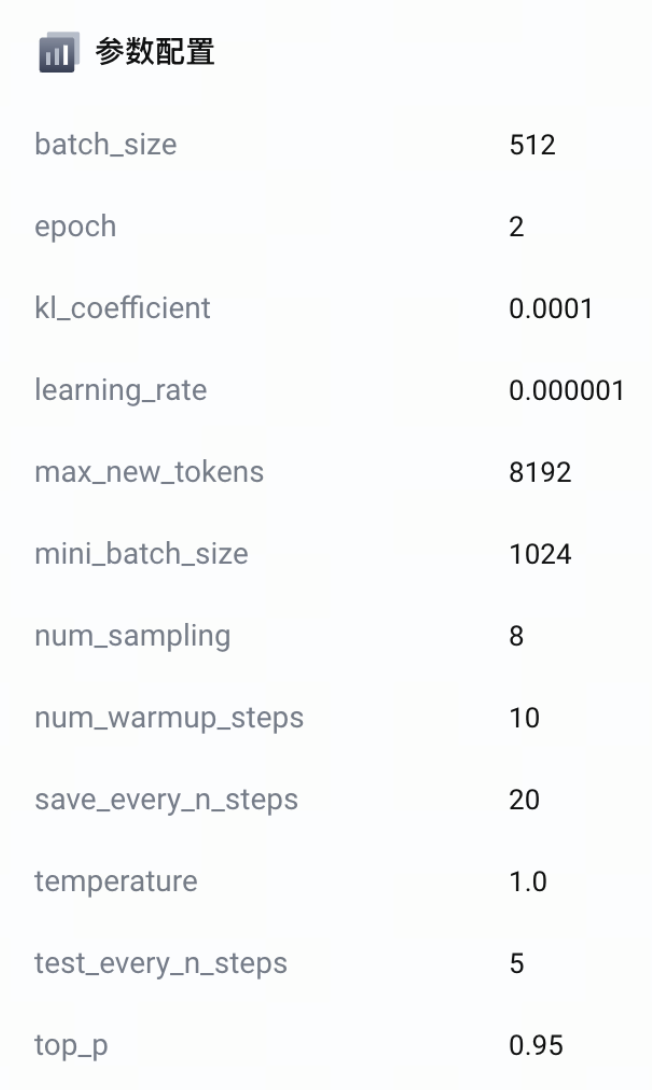
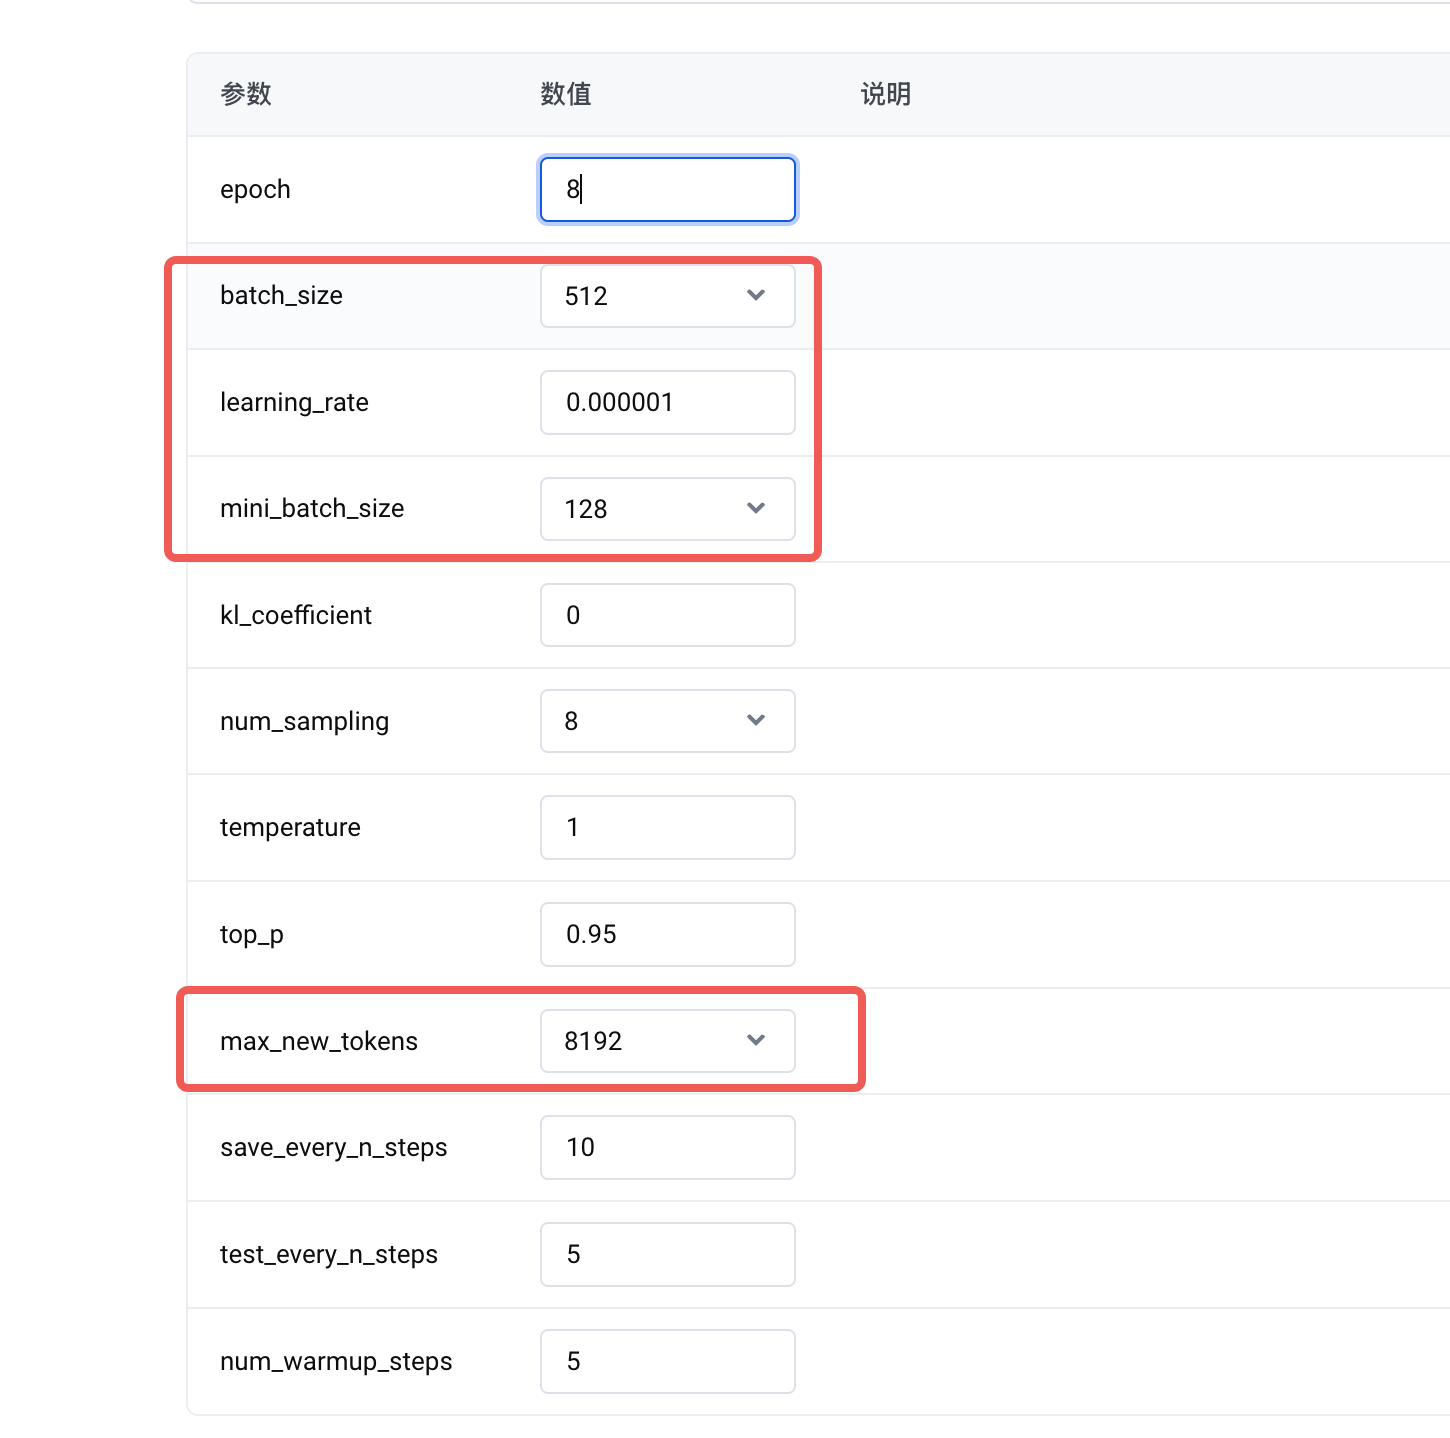
- kl_coeffient:客观性任务,kl_loss可以配置为0
- num_samples:根据数据量和训练效率综合考虑。
- max_new_tokens:根据效果指标里的rollout结果的截断比例判断调整最大输出token数量。
效果评估
查看基础效果指标
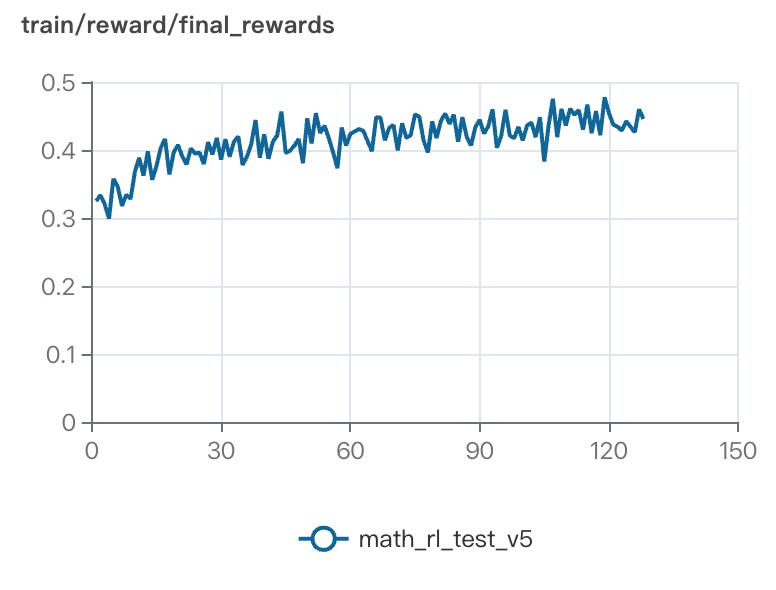
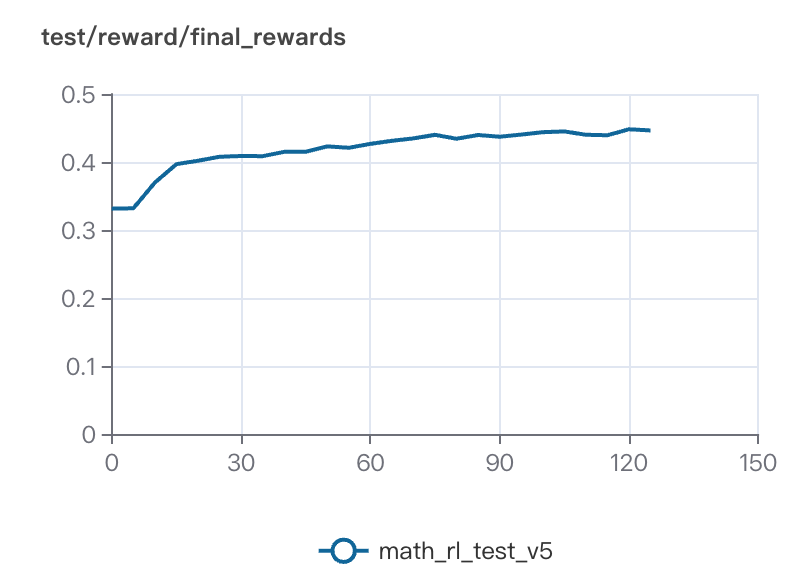
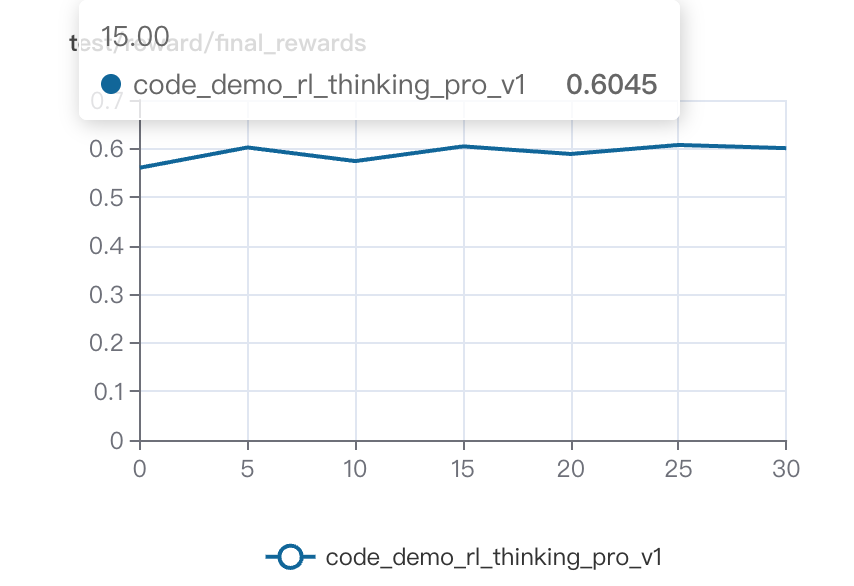
主要关注train/reward/final_rewards和test/reward/final_rewards,代表每个batch在训练集和测试集上的reward得分平均值,是多个奖励函数的加权和,代表效果得分变化。
同时可以参考generation相关指标,了解模型输出情况随训练的变化。
指标名 | 描述 |
train/batch_size | 批次大小,和启动参数一致 |
train/epoch | 第几轮训练,从0开始 |
train/global_step | 第几个step,train从1开始 |
train/num_sampling | 每个样本的采样数,和启动参数num_sampling一致 |
train/num_samples | 暂时没有作用 |
train/num_replicated_samples | 暂时没有作用 |
train/generation/prompt_length.mean | prompt的平均长度 |
train/generation/prompt_length.max | prompt的最大长度(截断后的最大长度,真实长度会更长) |
train/generation/prompt_length.clipfrac | prompt截断比例 |
train/generation/response_length.mean | response的平均长度 |
train/generation/response_length.max | response的最大长度 |
train/generation/response_length.clipfrac | response的截断比例 |
train/reward/final_rewards | batch的最后reward平均值,是多个奖励函数的加权和 |
train/reward/functions/{name}/rewards(mean) | 名为{name}的奖励函数的平均值 |
train/reward/functions/{name}/rewards(bon) | 名为{name}的奖励函数对每个样本采样n_sampling次的最大值,样本间再平均。可以表示模型最好的情况(best of) |
train/reward/functions/{name}/rewards(won) | 名为{name}的奖励函数对每个样本采样n_sampling次的最小值,样本间再平均。可以表示模型最差的情况(wost of) |
train/advantage/advantages | 奖励平均值 |
train/advantage/returns | 回报的平均值,仅在PPO训练中出现 |
train/actor/lr | policy的优化器lr |
train/actor/grad_norm | policy的梯度norm值。 |
train/actor/logprobs | 每个token输出概率的平均值。(暂未开放) |
train/actor/entropy | 每个token熵的平均值,用于衡量模型稳定性。(暂未开放) |
train/actor/loss | policy的最终loss,包含pg_loss和kl_loss等加权和 |
train/actor/pg_loss | Policy Gradient Loss,策略梯度损失 |
train/actor/kl_loss | kl损失,仅在ppo训练中 |
train/actor/pg_clipfrac | pg_loss的裁剪比例 |
train/actor/pg_clipfrac_high | pg_loss的上裁剪比例 |
train/actor/pg_clipfrac_low | pg_loss的下裁剪比例 |
train/actor/pg_clipfrac2 | 对于pg_loss过大的情况额外增加了一个裁剪方式,用于提高训练稳定性。这个指标一般在1e-4以下 |
train/critic/lr | critic的优化器lr |
train/critic/grad_norm | critic的梯度norm值 |
train/critic/vf_loss | Value Function Loss,价值函数损失 |
train/critic/vf_clipfrac | vf_loss的裁剪比例 |
train/actor/vf_clipfrac_high | vf_loss的上裁剪比例 |
train/actor/vf_clipfrac_low | vf_loss的下裁剪比例 |
test/xxxxxx | 基于测试集的指标信息,具体含义参考对应的train指标 |
自定义效果指标
训练框架将把每个 step 的指标按 key 聚合出最大值、最小值和平均值,并和其他效果指标一起展示。
案例分享
Demo1 - 使用预置奖励函数的Math任务
1.1 数据集准备
从开源openr1项目下载 https://huggingface.co/datasets/open-r1/OpenR1-Math-220k 数据集。将数据处理成方舟RL训练集格式,以下是一条示例:
{"messages":[{"role":"user","content":"5. Natural numbers are arranged in a table as shown.\n\n| 1 | | | | | | |\n| :--- | :--- | :--- | :--- | :--- | :--- | :--- |\n| 2 | 3 | | | | | |\n| 4 | 5 | 6 | | | | |\n| 7 | 8 | 9 | 10 | | | |\n| 11 | 12 | 13 | 14 | 15 | | |\n| 16 | 17 | 18 | 19 | 20 | 21 | |\n| 22 | 23 | 24 | 25 | 26 | 27 | 28 |\n\nThe table continues by writing natural numbers so that each subsequent row contains one more number than the previous row. Determine the sum of all numbers in the row $u$ where the number 1000 is located.\n\n## NATIONAL MATHEMATICS COMPETITION\n\nPoreč, 28. - 30. March 2019.\nPlease reason step by step, and put your final answer within \\boxed{}."}],"extra":{"answer":"45585"}}
1.2 创建精调任务
- 使用预置reward函数
- 配置训练参数,建议:
1.3 观察训练指标
训练集rewards指标上涨正常,测试集正确率提升10% 提升幅度30%
Demo2 - 使用自定义奖励函数+sandbox的Code任务
2.1 数据集准备
数据集:https://huggingface.co/datasets/ByteDance-Seed/Code-Contests-Plus
Test Cases:https://github.com/bytedance/SandboxFusion
2.2 Unit Test Cases上传对象存储
由于OJ代码类题目的test cases需要比较多的输入输出才能校验出给出的代码片段是否足够正确,往往有的test cases文件会达到MB级别,甚至GB级别。因此,这里通过将test cases保存在火山对象存储TOS进行存储,在真实需要计算reward时,通过sandbox拉取tos存储的test cases进行校验。TOS介绍文档
以下是一条保存的test cases示例:
[{"type": "StandardIO", "data": {"input": {"stdin": "5 5\n1 0 10\n1 0 10\n3 1 2\n1 0 6\n3 1 2\n"}, "output": {"stdout": "YES\nYES\n"}}}, {"type": "StandardIO", "data": {"input": {"stdin": "5 8\r\n1 -5 8\r\n1 -4 8\r\n1 -3 8\r\n1 2 7\r\n3 1 3\r\n2 2\r\n3 1 3\r\n3 3 4\r\n"}, "output": {"stdout": "NO\r\nYES\r\nYES\r\n"}}}]
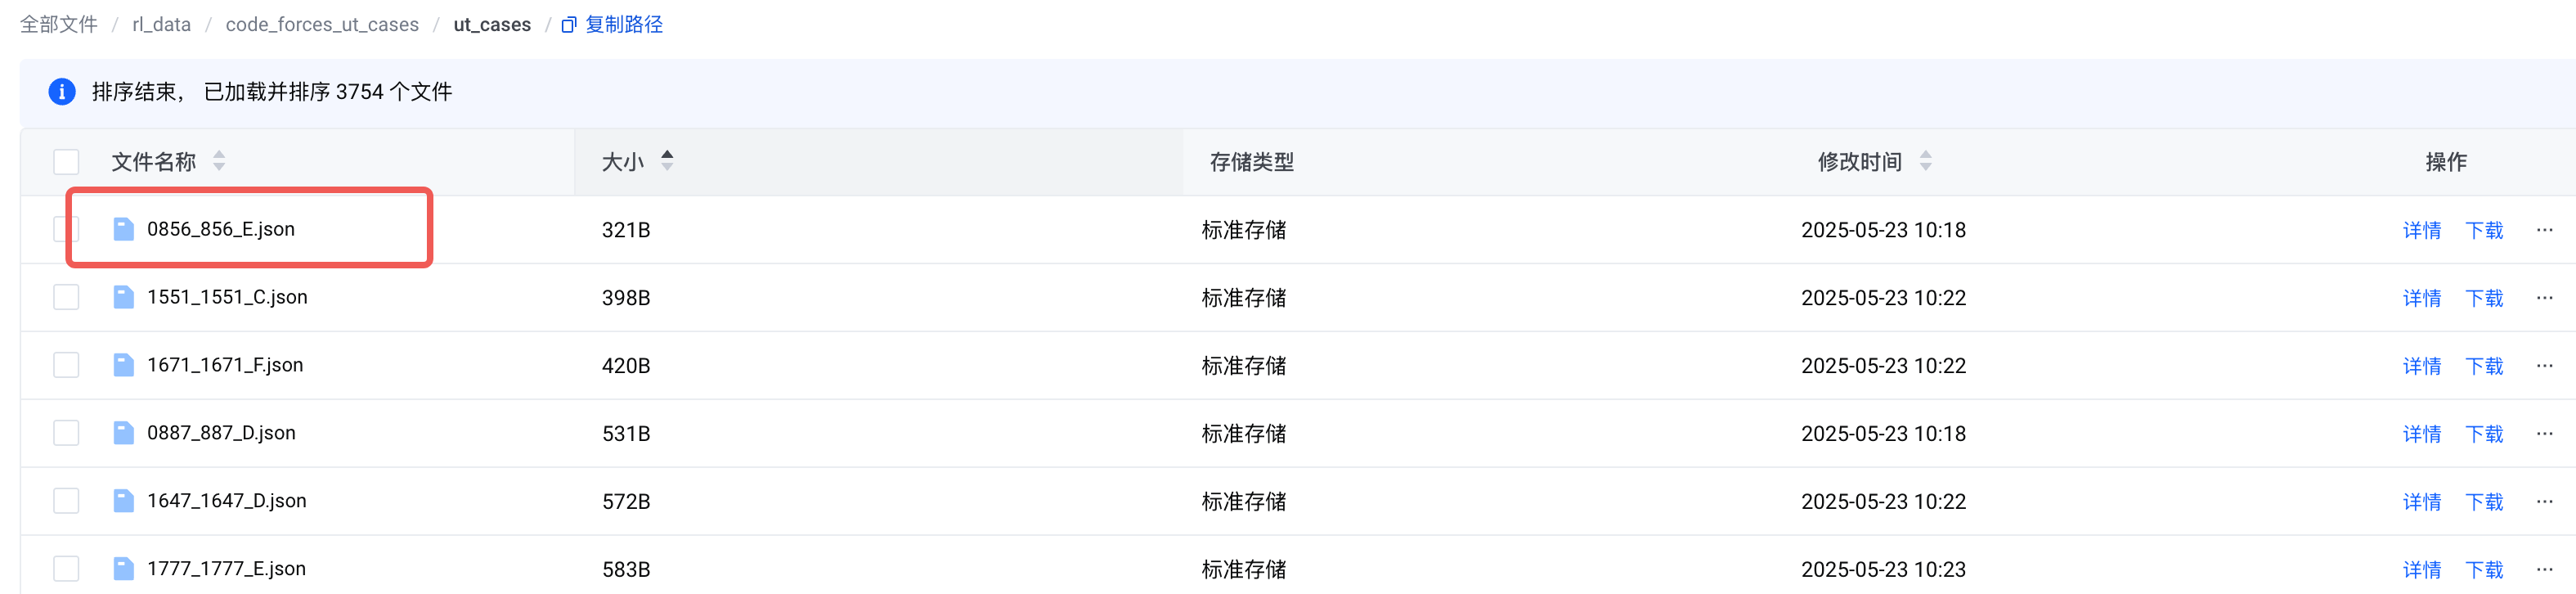
并且,在训练集的extra字段中使用内网链接。
公网链接示例:https://duncan.tos-cn-beijing.volces.com/XXX/XXXX.json
内网链接示例:https://duncan.tos-cn-beijing.ivolces.com/XXX/XXX.json
2.3 创建Code Sandbox 函数服务
- 参考 https://www.volcengine.com/docs/6662/1538139 创建代码沙箱
注意:请根据任务情况或日志服务中的报错信息,调整实例规格。当前任务测试用例较大,推荐 8核 32G。
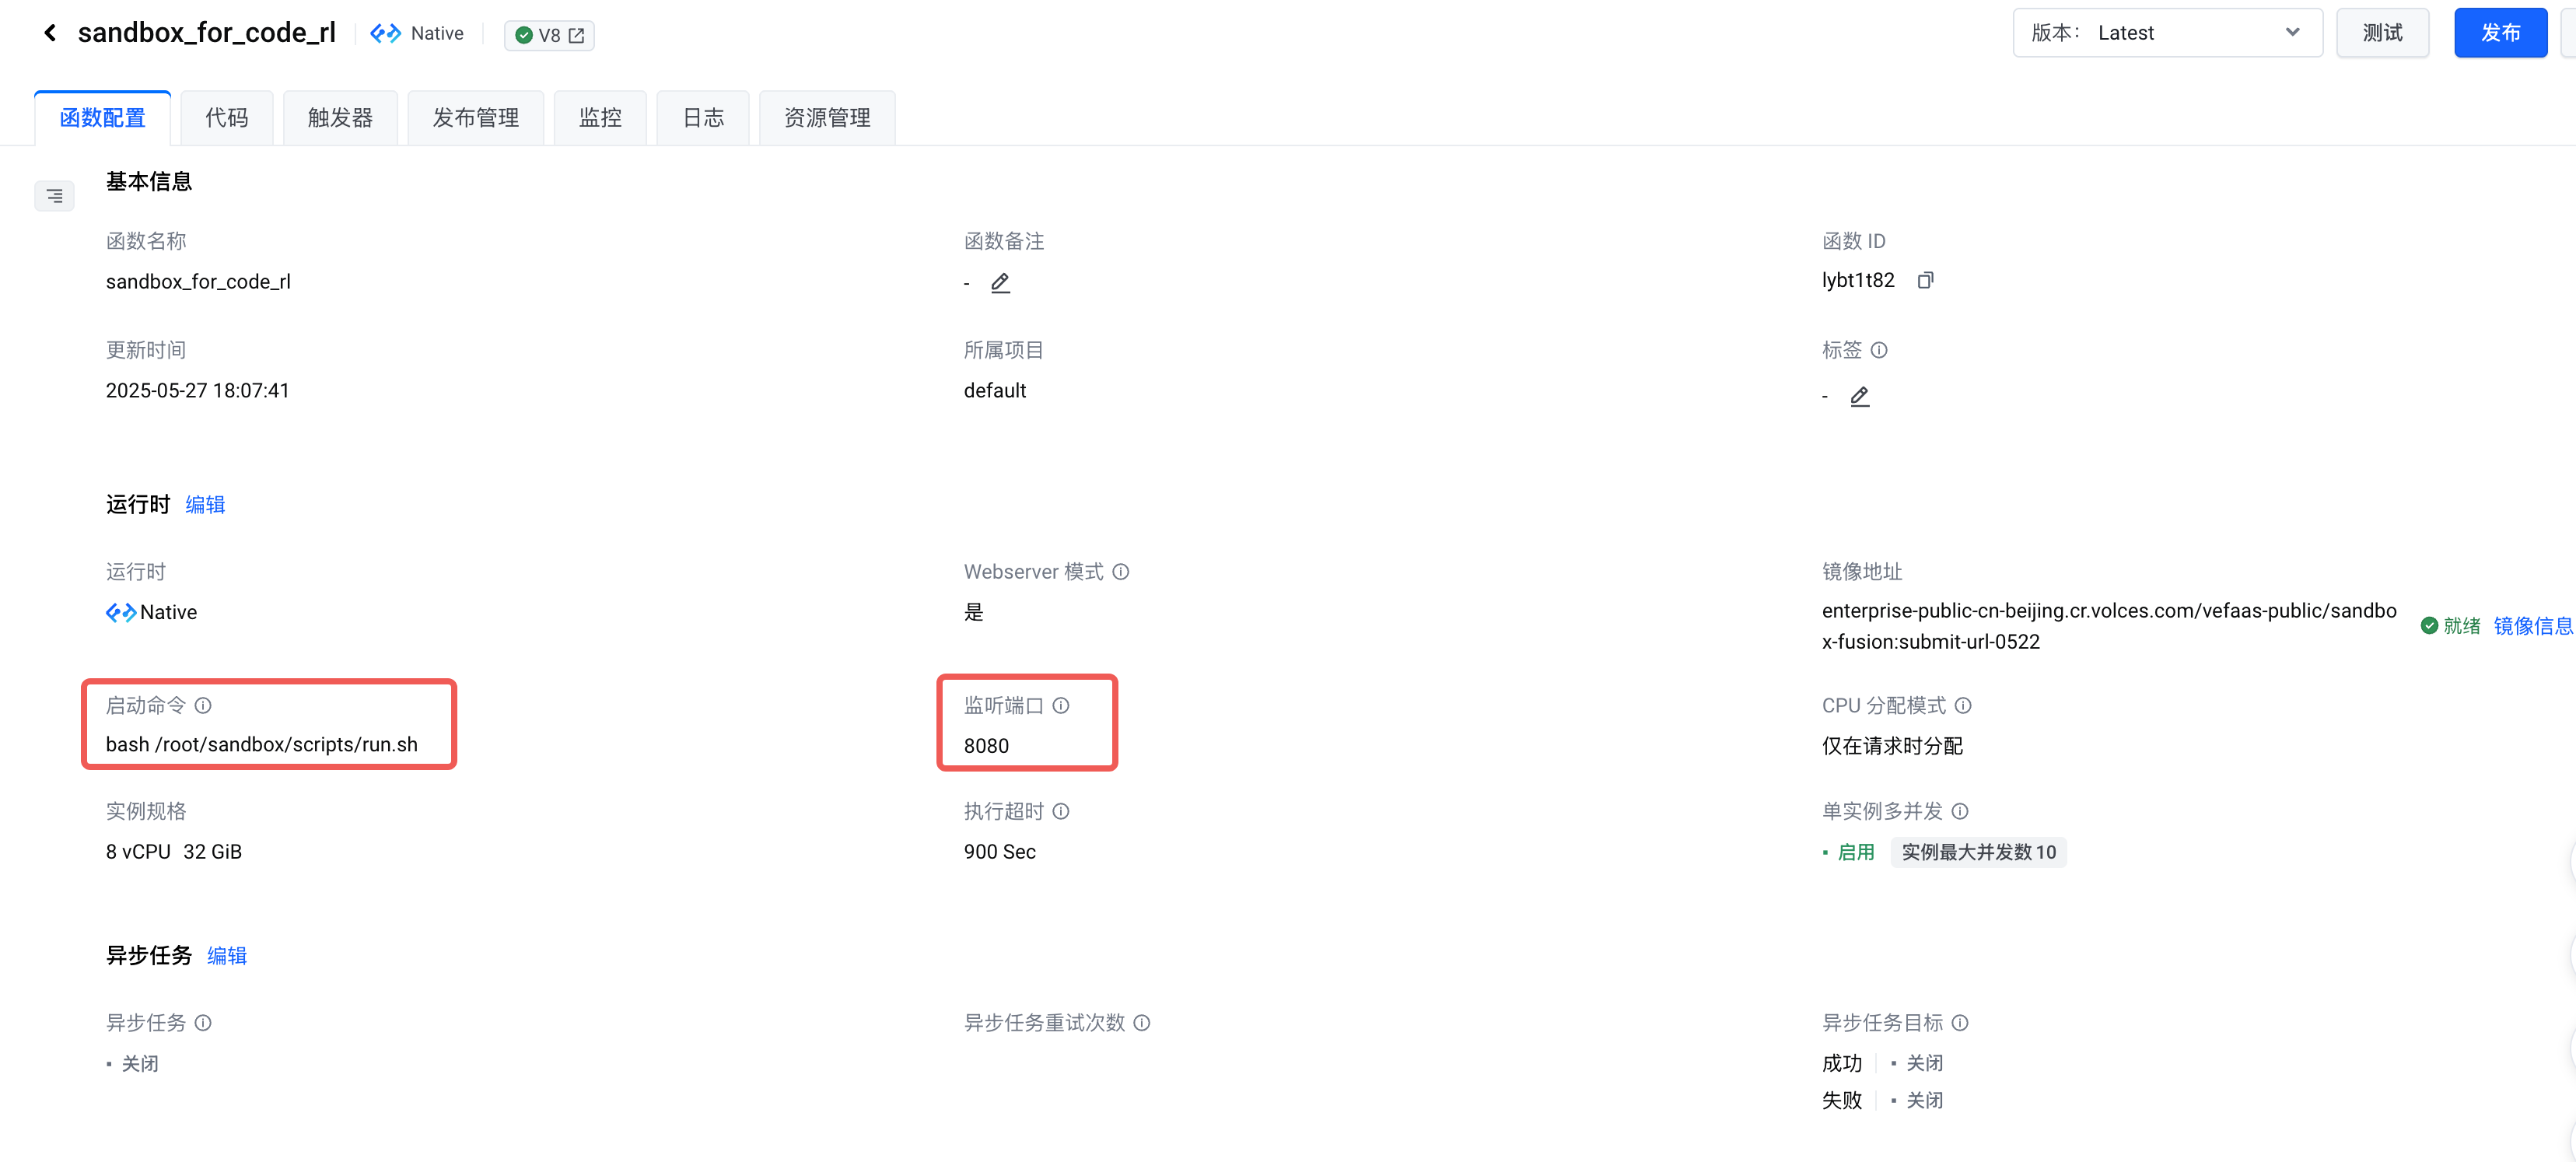
- 代码沙箱函数服务测试:
以下是一个测试示例:
{
"data": {
"dataset": "code_test",
"id": 1566,
"completion": "```cpp\n#include <iostream>\n#include <vector>\n#include <algorithm>\n\nusing namespace std;\n\nconst int maxn = 2e5 + 5;\nvector<int> g[maxn];\nint deg[maxn];\n\nbool isBud(int v) {\n if (v == 1) return false;\n if (deg[v] < 1) return false;\n for (int u : g[v]) {\n if (deg[u] != 1) return false;\n }\n return true;\n}\n\nvoid dfs(int v, int p) {\n for (int u : g[v]) {\n if (u == p) continue;\n dfs(u, v);\n }\n if (v != 1 && deg[v] == 1) {\n int cur = v;\n while (cur != 1 && deg[cur] == 1) cur = g[cur][0];\n if (cur == 1) {\n g[p].erase(find(g[p].begin(), g[p].end(), v));\n int newParent = v == g[v][0]? p : g[v][0];\n g[newParent].push_back(v);\n } else {\n g[g[cur][0]].erase(find(g[g[cur][0]].begin(), g[g[cur][0]].end(), cur));\n g[cur].erase(find(g[cur].begin(), g[cur].end(), v));\n int newParent = v == g[v][0]? cur : g[v][0];\n g[newParent].push_back(v);\n }\n deg[p]--;\n deg[v] = 0;\n for (int u : g[v]) {\n deg[u]--;\n }\n }\n}\n\nint main() {\n int t;\n cin >> t;\n while (t--) {\n int n;\n cin >> n;\n for (int i = 1; i <= n; ++i) {\n g[i].clear();\n deg[i] = 0;\n }\n for (int i = 0; i < n - 1; ++i) {\n int u, v;\n cin >> u >> v;\n g[u].push_back(v);\n g[v].push_back(u);\n deg[u]++;\n deg[v]++;\n }\n while (true) {\n bool foundBud = false;\n for (int v = 1; v <= n; ++v) {\n if (isBud(v)) {\n dfs(v, g[v][0]);\n foundBud = true;\n break;\n }\n }\n if (!foundBud) break;\n }\n int leaves = 0;\n for (int i = 1; i <= n; ++i) {\n if (deg[i] == 1) leaves++;\n }\n cout << leaves << endl;\n }\n return 0;\n}\n```",
"config": {
"dataset_type": "CommonOJDataset",
"language": "cpp",
"locale": "string",
"provided_data": {
"test": {
"location": "URL",
"url": "https://duncan.tos-cn-beijing.ivolces.com/rl_data/code_forces_ut_cases/ut_cases/1566_1566_E.json"
}
},
"run_timeout": 1,
"extra": {}
}
},
"method": "POST",
"path": "/submit",
"headers": {}
}
函数返回,检查返回体中的 accepted 字段是否正常。
{
"id": 1566,
"accepted": false,
"extracted_code": "#include <iostream>\n#include <vector>\n#include <algorithm>\n\nusing namespace std;\n\nconst int maxn = 2e5 + 5;\nvector<int> g[maxn];\nint deg[maxn];\n\nbool isBud(int v) {\n if (v == 1) return false;\n if (deg[v] < 1) return false;\n for (int u : g[v]) {\n if (deg[u] != 1) return false;\n }\n return true;\n}\n\nvoid dfs(int v, int p) {\n for (int u : g[v]) {\n if (u == p) continue;\n dfs(u, v);\n }\n if (v != 1 && deg[v] == 1) {\n int cur = v;\n while (cur != 1 && deg[cur] == 1) cur = g[cur][0];\n if (cur == 1) {\n g[p].erase(find(g[p].begin(), g[p].end(), v));\n int newParent = v == g[v][0]? p : g[v][0];\n g[newParent].push_back(v);\n } else {\n g[g[cur][0]].erase(find(g[g[cur][0]].begin(), g[g[cur][0]].end(), cur));\n g[cur].erase(find(g[cur].begin(), g[cur].end(), v));\n int newParent = v == g[v][0]? cur : g[v][0];\n g[newParent].push_back(v);\n }\n deg[p]--;\n deg[v] = 0;\n for (int u : g[v]) {\n deg[u]--;\n }\n }\n}\n\nint main() {\n int t;\n cin >> t;\n while (t--) {\n int n;\n cin >> n;\n for (int i = 1; i <= n; ++i) {\n g[i].clear();\n deg[i] = 0;\n }\n for (int i = 0; i < n - 1; ++i) {\n int u, v;\n cin >> u >> v;\n g[u].push_back(v);\n g[v].push_back(u);\n deg[u]++;\n deg[v]++;\n }\n while (true) {\n bool foundBud = false;\n for (int v = 1; v <= n; ++v) {\n if (isBud(v)) {\n dfs(v, g[v][0]);\n foundBud = true;\n break;\n }\n }\n if (!foundBud) break;\n }\n int leaves = 0;\n for (int i = 1; i <= n; ++i) {\n if (deg[i] == 1) leaves++;\n }\n cout << leaves << endl;\n }\n return 0;\n}",
"full_code": null,
"test_code": null,
"tests": [
{
"passed": false,
"exec_info": {
"status": "Success",
"message": "",
"compile_result": {
"status": "Finished",
"execution_time": 0.3585023880004883,
"return_code": 0,
"stdout": "",
"stderr": ""
},
"run_result": {
"status": "Finished",
"execution_time": 0.02179861068725586,
"return_code": 0,
"stdout": "4\n2\n111\n1\n4\n104\n95\n1\n2\n4\n",
"stderr": ""
},
"executor_pod_name": "lybt1t82-ck1hh536i1-reserved-7cfb6879d4-tcpfh",
"files": {}
},
"test_info": {
"input": {
"stdin": "10\n7\n1 2\n1 3\n1 4\n2 5\n2 6\n4 7\n49\n1 2\n2 3\n3 4\n4 5\n5 6\n6 7\n7 8\n8 9\n9 10\n10 11\n11 12\n12 13\n13 14\n14 15\n15 16\n16 17\n17 18\n18 19\n19 20\n20 21\n21 22\n22 23\n23 24\n24 25\n25 26\n26 27\n27 28\n28 29\n29 30\n30 31\n31 32\n32 33\n33 34\n34 35\n35 36\n36 37\n37 38\n38 39\n39 40\n40 41\n41 42\n42 43\n43 44\n44 45\n45 46\n46 47\n47 48\n48 49\n223\n1 2\n2 113\n1 3\n3 114\n1 4\n4 115\n1 5\n5 116\n1 6\n6 117\n1 7\n7 118\n1 8\n8 119\n1 9\n9 120\n1 10\n10 121\n1 11\n11 122\n1 12\n12 123\n1 13\n13 124\n1 14\n14 125\n1 15\n15 126\n1 16\n16 127\n1 17\n17 128\n1 18\n18 129\n1 19\n19 130\n1 20\n20 131\n1 21\n21 132\n1 22\n22 133\n1 23\n23 134\n1 24\n24 135\n1 25\n25 136\n1 26\n26 137\n1 27\n27 138\n1 28\n28 139\n1 29\n29 140\n1 30\n30 141\n1 31\n31 142\n1 32\n32 143\n1 33\n33 144\n1 34\n34 145\n1 35\n35 146\n1 36\n36 147\n1 37\n37 148\n1 38\n38 149\n1 39\n39 150\n1 40\n40 151\n1 41\n41 152\n1 42\n42 153\n1 43\n43 154\n1 44\n44 155\n1 45\n45 156\n1 46\n46 157\n1 47\n47 158\n1 48\n48 159\n1 49\n49 160\n1 50\n50 161\n1 51\n51 162\n1 52\n52 163\n1 53\n53 164\n1 54\n54 165\n1 55\n55 166\n1 56\n56 167\n1 57\n57 168\n1 58\n58 169\n1 59\n59 170\n1 60\n60 171\n1 61\n61 172\n1 62\n62 173\n1 63\n63 174\n1 64\n64 175\n1 65\n65 176\n1 66\n66 177\n1 67\n67 178\n1 68\n68 179\n1 69\n69 180\n1 70\n70 181\n1 71\n71 182\n1 72\n72 183\n1 73\n73 184\n1 74\n74 185\n1 75\n75 186\n1 76\n76 187\n1 77\n77 188\n1 78\n78 189\n1 79\n79 190\n1 80\n80 191\n1 81\n81 192\n1 82\n82 193\n1 83\n83 194\n1 84\n84 195\n1 85\n85 196\n1 86\n86 197\n1 87\n87 198\n1 88\n88 199\n1 89\n89 200\n1 90\n90 201\n1 91\n91 202\n1 92\n92 203\n1 93\n93 204\n1 94\n94 205\n1 95\n95 206\n1 96\n96 207\n1 97\n97 208\n1 98\n98 209\n1 99\n99 210\n1 100\n100 211\n1 101\n101 212\n1 102\n102 213\n1 103\n103 214\n1 104\n104 215\n1 105\n105 216\n1 106\n106 217\n1 107\n107 218\n1 108\n108 219\n1 109\n109 220\n1 110\n110 221\n1 111\n111 222\n1 112\n112 223\n3\n1 2\n2 3\n7\n1 2\n1 3\n1 4\n2 5\n2 6\n4 7\n209\n1 2\n2 106\n1 3\n3 107\n1 4\n4 108\n1 5\n5 109\n1 6\n6 110\n1 7\n7 111\n1 8\n8 112\n1 9\n9 113\n1 10\n10 114\n1 11\n11 115\n1 12\n12 116\n1 13\n13 117\n1 14\n14 118\n1 15\n15 119\n1 16\n16 120\n1 17\n17 121\n1 18\n18 122\n1 19\n19 123\n1 20\n20 124\n1 21\n21 125\n1 22\n22 126\n1 23\n23 127\n1 24\n24 128\n1 25\n25 129\n1 26\n26 130\n1 27\n27 131\n1 28\n28 132\n1 29\n29 133\n1 30\n30 134\n1 31\n31 135\n1 32\n32 136\n1 33\n33 137\n1 34\n34 138\n1 35\n35 139\n1 36\n36 140\n1 37\n37 141\n1 38\n38 142\n1 39\n39 143\n1 40\n40 144\n1 41\n41 145\n1 42\n42 146\n1 43\n43 147\n1 44\n44 148\n1 45\n45 149\n1 46\n46 150\n1 47\n47 151\n1 48\n48 152\n1 49\n49 153\n1 50\n50 154\n1 51\n51 155\n1 52\n52 156\n1 53\n53 157\n1 54\n54 158\n1 55\n55 159\n1 56\n56 160\n1 57\n57 161\n1 58\n58 162\n1 59\n59 163\n1 60\n60 164\n1 61\n61 165\n1 62\n62 166\n1 63\n63 167\n1 64\n64 168\n1 65\n65 169\n1 66\n66 170\n1 67\n67 171\n1 68\n68 172\n1 69\n69 173\n1 70\n70 174\n1 71\n71 175\n1 72\n72 176\n1 73\n73 177\n1 74\n74 178\n1 75\n75 179\n1 76\n76 180\n1 77\n77 181\n1 78\n78 182\n1 79\n79 183\n1 80\n80 184\n1 81\n81 185\n1 82\n82 186\n1 83\n83 187\n1 84\n84 188\n1 85\n85 189\n1 86\n86 190\n1 87\n87 191\n1 88\n88 192\n1 89\n89 193\n1 90\n90 194\n1 91\n91 195\n1 92\n92 196\n1 93\n93 197\n1 94\n94 198\n1 95\n95 199\n1 96\n96 200\n1 97\n97 201\n1 98\n98 202\n1 99\n99 203\n1 100\n100 204\n1 101\n101 205\n1 102\n102 206\n1 103\n103 207\n1 104\n104 208\n1 105\n105 209\n191\n1 2\n2 97\n1 3\n3 98\n1 4\n4 99\n1 5\n5 100\n1 6\n6 101\n1 7\n7 102\n1 8\n8 103\n1 9\n9 104\n1 10\n10 105\n1 11\n11 106\n1 12\n12 107\n1 13\n13 108\n1 14\n14 109\n1 15\n15 110\n1 16\n16 111\n1 17\n17 112\n1 18\n18 113\n1 19\n19 114\n1 20\n20 115\n1 21\n21 116\n1 22\n22 117\n1 23\n23 118\n1 24\n24 119\n1 25\n25 120\n1 26\n26 121\n1 27\n27 122\n1 28\n28 123\n1 29\n29 124\n1 30\n30 125\n1 31\n31 126\n1 32\n32 127\n1 33\n33 128\n1 34\n34 129\n1 35\n35 130\n1 36\n36 131\n1 37\n37 132\n1 38\n38 133\n1 39\n39 134\n1 40\n40 135\n1 41\n41 136\n1 42\n42 137\n1 43\n43 138\n1 44\n44 139\n1 45\n45 140\n1 46\n46 141\n1 47\n47 142\n1 48\n48 143\n1 49\n49 144\n1 50\n50 145\n1 51\n51 146\n1 52\n52 147\n1 53\n53 148\n1 54\n54 149\n1 55\n55 150\n1 56\n56 151\n1 57\n57 152\n1 58\n58 153\n1 59\n59 154\n1 60\n60 155\n1 61\n61 156\n1 62\n62 157\n1 63\n63 158\n1 64\n64 159\n1 65\n65 160\n1 66\n66 161\n1 67\n67 162\n1 68\n68 163\n1 69\n69 164\n1 70\n70 165\n1 71\n71 166\n1 72\n72 167\n1 73\n73 168\n1 74\n74 169\n1 75\n75 170\n1 76\n76 171\n1 77\n77 172\n1 78\n78 173\n1 79\n79 174\n1 80\n80 175\n1 81\n81 176\n1 82\n82 177\n1 83\n83 178\n1 84\n84 179\n1 85\n85 180\n1 86\n86 181\n1 87\n87 182\n1 88\n88 183\n1 89\n89 184\n1 90\n90 185\n1 91\n91 186\n1 92\n92 187\n1 93\n93 188\n1 94\n94 189\n1 95\n95 190\n1 96\n96 191\n3\n1 2\n2 3\n99\n1 2\n2 3\n3 4\n4 5\n5 6\n6 7\n7 8\n8 9\n9 10\n10 11\n11 12\n12 13\n13 14\n14 15\n15 16\n16 17\n17 18\n18 19\n19 20\n20 21\n21 22\n22 23\n23 24\n24 25\n25 26\n26 27\n27 28\n28 29\n29 30\n30 31\n31 32\n32 33\n33 34\n34 35\n35 36\n36 37\n37 38\n38 39\n39 40\n40 41\n41 42\n42 43\n43 44\n44 45\n45 46\n46 47\n47 48\n48 49\n49 50\n50 51\n51 52\n52 53\n53 54\n54 55\n55 56\n56 57\n57 58\n58 59\n59 60\n60 61\n61 62\n62 63\n63 64\n64 65\n65 66\n66 67\n67 68\n68 69\n69 70\n70 71\n71 72\n72 73\n73 74\n74 75\n75 76\n76 77\n77 78\n78 79\n79 80\n80 81\n81 82\n82 83\n83 84\n84 85\n85 86\n86 87\n87 88\n88 89\n89 90\n90 91\n91 92\n92 93\n93 94\n94 95\n95 96\n96 97\n97 98\n98 99\n7\n1 2\n1 3\n1 4\n2 5\n2 6\n4 7\n"
},
"output": {
"stdout": "2\n1\n1\n1\n2\n1\n1\n1\n1\n2\n"
}
}
}
],
"extracted_type": null,
"extra": null
}
2.4 Reward函数创建
在创建RL精调任务时,在 奖励规则部分添加 自定义奖励函数
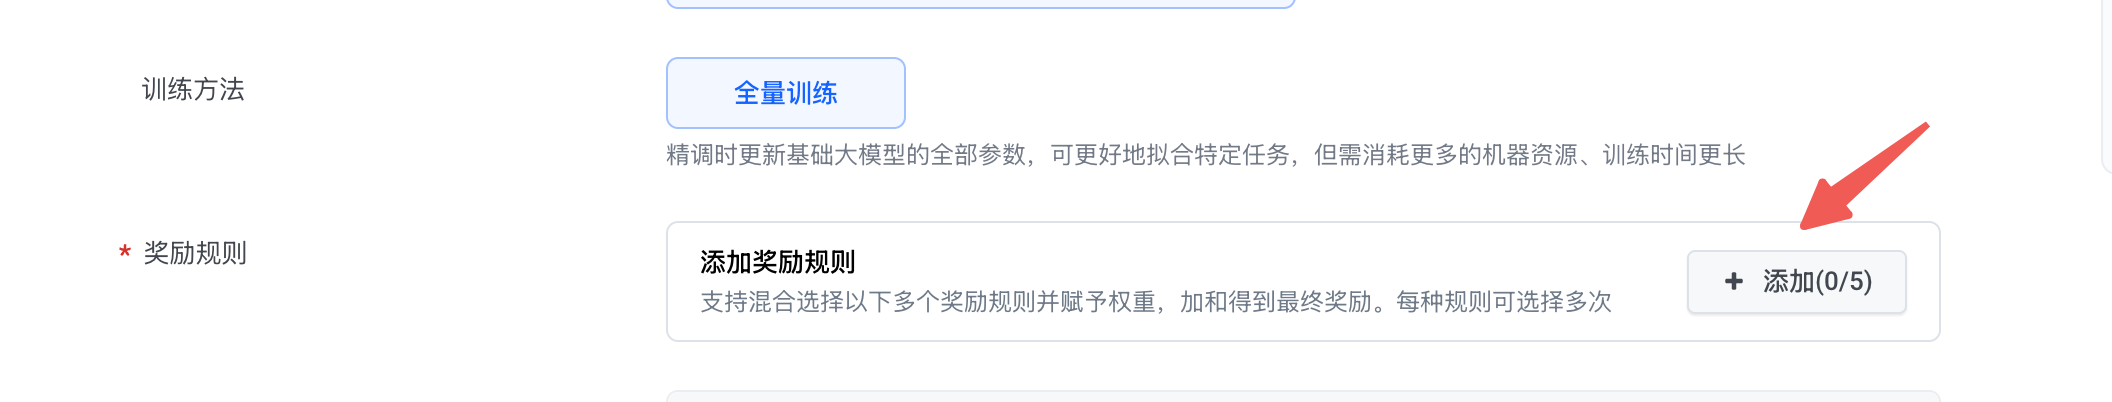
创建后,主要修改 rl_reward.py 部分的代码,并在 requirements.txt 中增加需要的依赖包。
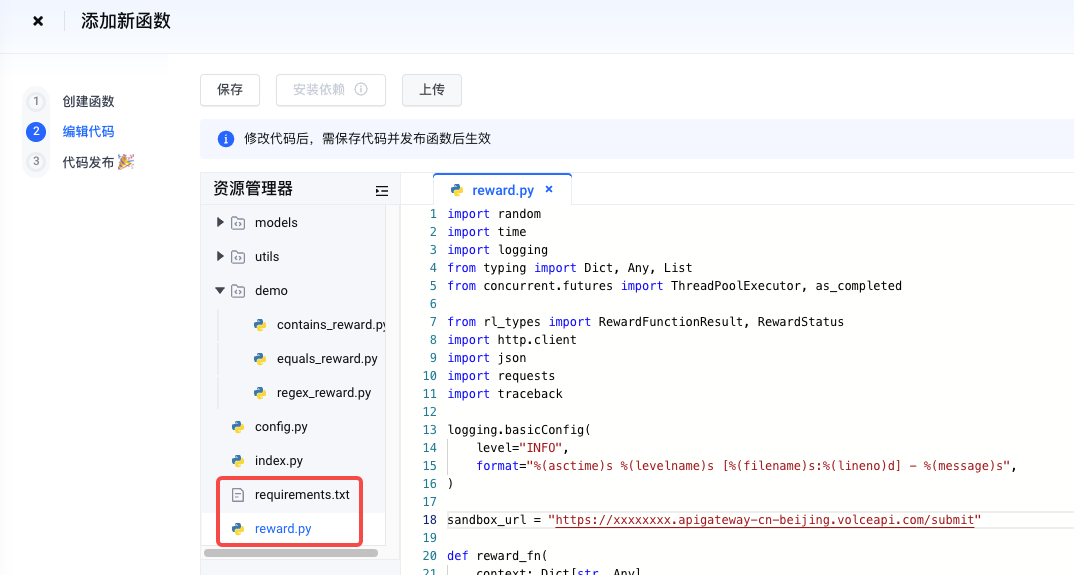
以下是requirements.txt的示例:
requests==2.32.3
以下是reward.py的示例:
sandbox_url 替换成 对应的 sandbox函数服务的地址。
import random
import time
import logging
from typing import Dict, Any, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from rl_types import RewardFunctionResult, RewardStatus
import http.client
import json
import requests
import traceback
logging.basicConfig(
level="INFO",
format="%(asctime)s %(levelname)s [%(filename)s:%(lineno)d] - %(message)s",
)
sandbox_url = "https://sd1048j77bam7gokaj98g.apigateway-cn-beijing.volceapi.com/submit"
def reward_fn(
context: Dict[str, Any],
sample: Dict[str, Any],
completions: List[Dict[str, Any]]) -> RewardFunctionResult:
metrics = {}
rewards = []
status = RewardStatus.SUCCESS
time_cost = []
# 提前提取公共参数(所有completion共享同一组extra参数)
try:
extra = sample['extra']
language = extra['language']
time_limit = float(extra['time_limit'])
contest_id = extra['contest_id']
url = extra['url']
except KeyError as e:
logging.error(f"Sample missing required extra field: {e}")
return RewardFunctionResult([0], {"error": 1.0}, RewardStatus.FAILURE)
# 定义线程任务函数(封装单个completion的处理逻辑)
def process_single_completion(completion: Dict[str, Any]) -> tuple:
"""
处理单个completion的沙箱请求,返回(奖励值,耗时,错误信息)
"""
start_time = time.time()
try:
# 提取模型输出内容
logging.info(f"completion: {completion}")
resp = completion['messages']['content']
# 调用沙箱接口
reward, payload = request_sandbox(resp, language, time_limit, contest_id, url)
# 计算奖励值(根据业务逻辑调整)
true_reward = 1.0 if reward else 0.0
elapsed = time.time() - start_time
return (true_reward, elapsed, None) # (奖励,耗时,无错误)
except Exception as e:
traceback.print_exc()
elapsed = time.time() - start_time
logging.error(f"Error processing completion: {str(e)}, 请求:{payload}")
return (0.0, elapsed, e) # (无奖励,耗时,错误信息)
# 使用线程池并发处理所有completions
with ThreadPoolExecutor(max_workers=30) as executor:
# 提交所有任务到线程池
results = executor.map(process_single_completion, completions)
# 等待所有任务完成并收集结果
for res in results:
true_reward, elapsed, error = res
# 记录耗时
time_cost.append(elapsed)
# 处理奖励值
if true_reward is not None:
rewards.append(true_reward)
# 处理错误状态(只要有一个失败则整体标记为失败)
if error is not None:
status = RewardStatus.FAILURE
# 计算指标
if time_cost:
metrics['sandbox_cost_max'] = max(time_cost)
metrics['sandbox_cost_avg'] = sum(time_cost) / len(time_cost)
else:
metrics['sandbox_cost_max'] = 0
metrics['sandbox_cost_avg'] = 0
return RewardFunctionResult(rewards, metrics, status)
def request_sandbox(completion: str, language: str, time_limit: float, contest_id: str, url: str) -> bool:
"""
调用沙箱接口(保持原逻辑,添加异常处理)
"""
try:
payload = json.dumps({
"dataset": "code_test",
"id": int(contest_id),
"completion": completion,
"config": {
"dataset_type": "CommonOJDataset",
"language": language,
"locale": "string",
"provided_data": {
"test": {
"location": "URL",
"url": url
}
},
"run_timeout": float(time_limit),
"extra": {}
}
})
headers = {
'Content-Type': 'application/json',
'Accept': 'application/json',
}
response = requests.request("POST", sandbox_url, headers=headers, data=payload)
response.raise_for_status() # 检查HTTP错误状态码
result = json.loads(response.text)
return result.get('accepted', False), payload # 确保有默认值
except requests.exceptions.RequestException as e:
logging.error(f"Sandbox request failed: {str(e)}, 请求:{payload}")
raise # 向上抛出异常以便上层处理
except json.JSONDecodeError:
logging.error("Invalid JSON response from sandbox")
raise
except KeyError:
logging.error("Missing 'accepted' field in sandbox response")
raise
- 函数测试
以下是一个测试示例:
{
"data": {
"context": {
"model_customization_job_id": "mcj_xxxxxx_xxx",
"foundation_model_name": "doubao-seed-2-0-mini",
"foundation_model_version": "260428",
"customization_type": "GRPO",
"is_mock": false
},
"sample":{
"messages": [
{
"role": "user",
"content": "You are an expert competitive programmer. You will be given a problem statement, test case constraints and example test inputs and outputs. Please reason step by step about the solution (that must respect memory and time limits), then provide a complete implementation in c++17.\n\nYour solution must read input from standard input (cin), write output to standard output (cout).\nDo not include any debug prints or additional output.\n\nPut your final solution within a single code block:\n```cpp\n<your code here>\n```\n\nExecution time limit: 2.0 seconds\nMemory limit: 256.0 MB\n\n# Problem\nDue to the recent popularity of the Deep learning new countries are starting to look like Neural Networks. That is, the countries are being built deep with many layers, each layer possibly having many cities. They also have one entry, and one exit point.\n\nThere are exactly L layers, each having N cities. Let us look at the two adjacent layers L1 and L2. Each city from the layer L1 is connected to each city from the layer L2 with the traveling cost cij for $$i,j\\in\\{1,2,\\ldots,N\\}$$, and each pair of adjacent layers has the same cost in between their cities as any other pair (they just stacked the same layers, as usual). Also, the traveling costs to each city from the layer L2 are same for all cities in the L1, that is cij is the same for $$i \\in \\{1, 2, \\ldots, N\\}$$, and fixed j.\n\nDoctor G. needs to speed up his computations for this country so he asks you to find the number of paths he can take from entry to exit point such that his traveling cost is divisible by given number M.\n\n## Input Format\nThe first line of input contains N (1 \u2264 N \u2264 106), L (2 \u2264 L \u2264 105) and M (2 \u2264 M \u2264 100), the number of cities in each layer, the number of layers and the number that travelling cost should be divisible by, respectively.\n\nSecond, third and fourth line contain N integers each denoting costs 0 \u2264 cost \u2264 M from entry point to the first layer, costs between adjacent layers as described above, and costs from the last layer to the exit point.\n\n## Output Format\nOutput a single integer, the number of paths Doctor G. can take which have total cost divisible by M, modulo 109 + 7.\n\n## Examples\n```input\n2 3 13\n4 6\n2 1\n3 4\n```\n```output\n2\n```\n\n## Note\nThis is a country with 3 layers, each layer having 2 cities. Paths $$6 \rightarrow 2 \rightarrow 2 \rightarrow 3$$, and $$6 \rightarrow 2 \rightarrow 1 \rightarrow 4$$ are the only paths having total cost divisible by 13. Notice that input edges for layer cities have the same cost, and that they are same for all layers.\n\nNow solve the problem and return the code."
}
],
"tools": [],
"extra": {
"contest_id": 852,
"language": "python",
"time_limit": "0.5",
"url":"https:\/\/duncan.tos-cn-beijing.volces.com\/rl_data\/code_forces_ut_cases\/ut_cases\/0852_852_B.json"
}
},
"completions": [
{
"messages": [{
"role": "assistant",
"content": "### Solution Code\n```cpp\n#include <iostream>\n#include <vector>\n#include <cstring>\nusing namespace std;\n\nconst int MOD = 1e9 + 7;\n\nvector<vector<int>> multiply(const vector<vector<int>> &a, const vector<vector<int>> &b, int m) {\n vector<vector<int>> res(m, vector<int>(m, 0));\n for (int i = 0; i < m; ++i) {\n for (int k = 0; k < m; ++k) {\n if (a[i][k] == 0) continue;\n for (int j = 0; j < m; ++j) {\n res[i][j] = (res[i][j] + (long long)a[i][k] * b[k][j]) % MOD;\n }\n }\n }\n return res;\n}\n\nvector<vector<int>> matrix_pow(vector<vector<int>> base, int power, int m) {\n vector<vector<int>> res(m, vector<int>(m, 0));\n for (int i = 0; i < m; ++i) {\n res[i][i] = 1;\n }\n while (power > 0) {\n if (power % 2 == 1) {\n res = multiply(res, base, m);\n }\n base = multiply(base, base, m);\n power /= 2;\n }\n return res;\n}\n\nint main() {\n ios_base::sync_with_stdio(false);\n cin.tie(nullptr);\n \n int N, L, M;\n cin >> N >> L >> M;\n \n vector<int> a(N), b(N), c(N);\n for (int i = 0; i < N; ++i) cin >> a[i];\n for (int i = 0; i < N; ++i) cin >> b[i];\n for (int i = 0; i < N; ++i) cin >> c[i];\n \n vector<int> cnt_first(M, 0), cnt_b(M, 0), cnt_d(M, 0);\n for (int x : a) cnt_first[x % M]++;\n for (int x : b) cnt_b[x % M]++;\n for (int i = 0; i < N; ++i) {\n int d = (b[i] + c[i]) % M;\n cnt_d[d]++;\n }\n \n if (L == 2) {\n int ans = 0;\n for (int r = 0; r < M; ++r) {\n int t = (M - r) % M;\n ans = (ans + (long long)cnt_first[r] * cnt_d[t]) % MOD;\n }\n cout << ans << endl;\n } else {\n int k = L - 2;\n vector<vector<int>> T(M, vector<int>(M, 0));\n for (int i = 0; i < M; ++i) {\n for (int j = 0; j < M; ++j) {\n int t = (j - i) % M;\n if (t < 0) t += M;\n T[i][j] = cnt_b[t];\n }\n }\n \n vector<vector<int>> T_pow = matrix_pow(T, k, M);\n \n vector<int> dp_mid(M, 0);\n for (int i = 0; i < M; ++i) {\n if (cnt_first[i] == 0) continue;\n for (int j = 0; j < M; ++j) {\n dp_mid[j] = (dp_mid[j] + (long long)cnt_first[i] * T_pow[i][j]) % MOD;\n }\n }\n \n int ans = 0;\n for (int j = 0; j < M; ++j) {\n int t = (M - j) % M;\n ans = (ans + (long long)dp_mid[j] * cnt_d[t]) % MOD;\n }\n cout << ans << endl;\n }\n \n return 0;\n}"
}]
}]
},
"method": "POST",
"path": "/",
"headers": {}
}
观察结果返回:
{
"rewards": [
0
],
"metrics": {
"sandbox_cost_max": 7.152166843414307,
"sandbox_cost_avg": 7.152166843414307
},
"status": "success"
}
2.5 创建精调任务
参数配置建议:
- kl_coefficient:客观性任务,kl_loss可以配置为0
- num_samples:根据数据量和训练效率综合考虑。
- max_new_tokens:根据效果指标里的rollout结果的截断比例判断调整最大输出token数量。
2.6 观察训练指标
测试集正确率提升4%
最近更新时间:2026.09.22 16:52:17
这个页面对您有帮助吗?
有用
有用
无用
无用