大数据研发治理套件
大数据研发治理套件


- 文档首页
 大数据研发治理套件用户指南数据集成数据源列表Oracle配置 Oracle 任务
 复制全文
 下载 pdf
 文档反馈
 问问助手
Oracle 数据源为您提供读取和写入 Oracle 的双向通道数据集成能力,实现不同数据源与 Oracle 之间的数据传输场景。本文为您介绍 DataSail 的 Oracle 数据同步的能力支持情况,包括离线批式同步和基于 LogMiner 的实时同步方案。
1 使用前提
已完成 Oracle 数据源配置操作,详见配置 Oracle 数据源。
2 实时同步方案(LogMiner CDC)
2.1 方案概述
DataSail 通过 Oracle 内置的 LogMiner 工具实现实时变更数据捕获(CDC)。LogMiner 通过解析 Oracle Redo Log 和 Archive Log 中的变更记录,将数据库的 INSERT、UPDATE、DELETE 操作实时同步到下游目标端。工作原理如下:
- DataSail 调用 Oracle LogMiner API 开始日志挖掘会话。
- 读取 Redo Log / Archive Log 中的变更记录。
- 解析变更记录为结构化的增量数据。
- 将增量数据写入下游目标(如 StarRocks、ByteHouse、Doris 等)。
2.2 前置要求
注意
使用 LogMiner 进行实时 CDC 采集前,请先了解以下使用限制:
- 当前方案适用于 Oracle 整库的数据变更量小于 10000 条/秒的场景。
- 仅支持主库读取,不支持从库。
- 默认仅支持 Oracle 非 CDB 模式以及非 RAC 模式。
- 不支持的数据类型:NCLOB、CLOB、BFILE、XMLTYPE、LONG、BINARY、VARBINARY、BLOB
使用 LogMiner CDC 前,请确保已完成以下配置(详细步骤请参见2.2.2 实时同步(LogMiner CDC)服务端配置):
配置项 | 要求 | 验证 SQL |
|---|---|---|
归档日志模式 | 必须为 ARCHIVELOG |
|
全列补充日志 | 必须已开启 |
|
LogMiner 权限 | 已授予 logminer_user | 请参见2.2.2 实时同步(LogMiner CDC)服务端配置的权限脚本 |
归档日志保留 | 建议不少于 24 小时 |
|
部署架构 | 非 CDB 模式、非 RAC 模式 |
|
2.3 使用实时整库同步
Oracle 实时同步主要通过 DataSail 的解决方案能力实现:
- 实时整库同步:将 Oracle 整库或选定表实时同步到目标端。详见实时整库同步(新版)。
- 实时分库分表:将 Oracle 多个分库分表合并同步到一张目标表。详见实时分库分表(新版)。
以实时整库同步为例,介绍配置方案的操作步骤:
- 进入 DataSail 控制台 > 全域集成 > 解决方案。
- 单击新建数据同步解决方案 > 实时整库同步按钮,进入新建实时整库同步方案页面。
- 数据来源选择 Oracle,选择已注册的 Oracle CDC 数据源。
- 选择需要同步的数据库和表。
- 配置目标端(如 StarRocks、ByteHouse 等)。
- 配置 DDL 策略和数据转换规则。
- 提交并启动解决方案。
2.4 LogMiner CDC 限制与注意事项
限制项 | 说明 |
|---|---|
数据变更量 | 适用于整库数据变更量小于 10000 条/秒的场景。 |
主从库 | 仅支持主库读取,不支持从库。 |
部署架构 | 默认仅支持非 CDB 模式以及非 RAC 模式。 |
不支持的数据类型 | NCLOB、CLOB、BFILE、XMLTYPE、LONG、BINARY、VARBINARY、BLOB 等二进制和超大类型。 |
无主键表 | 建议所有 CDC 表都有主键或唯一键,否则 UPDATE/DELETE 操作可能无法正确匹配行。 |
归档日志删除 | 归档日志被清理后,如果 DataSail 尚未读取,会导致数据丢失,需重新全量同步。 |
并发性 | LogMiner 会话会占用 Oracle 服务端资源,建议在非业务高峰时段首次启动。 |
DDL 支持 | 支持 ADD COLUMN、DROP COLUMN;不支持 RENAME TABLE、MODIFY COLUMN TYPE。 |
3 离线同步任务配置
3.1 新建任务
Oracle 数据源测试连通性成功后,进入到数据开发界面,开始新建 Oracle 相关通道任务。
新建任务方式详见离线数据同步、流式数据同步。
3.2 可视化配置说明
任务创建成功后,您可根据实际场景,配置Oracle 批式读、Oracle 批式写或 Oracle 流式写等通道任务。
3.2.1 Oracle 批式读
数据来源选择 Oracle,并完成以下相关参数配置。其中参数名称前带 * 的为必填参数,名称前未带 * 的为可选填参数。
参数 | 说明 |
|---|---|
*数据源类型 | 下拉选择 Oracle 数据源类型。 |
*数据源名称 | 已在数据源管理中注册成功的 Oracle 数据源,下拉可选。 |
*Schema 目录 | 数据库下已有的 Schema 目录信息,下拉可选。 |
*数据表 | 选择需要采集的数据表信息,您可同时选择多个 Schema 相同的表进行数据同步,支持区间表达式“table_[0-99]”和时间表达式“table_${date}”方式,来快速配置选择多个表。 |
分库分表 | Oracle 支持分库分表形式读取,单击添加分库分表按钮,进行分库分表添加,在下拉框中选择分库数据源与具体分表名称信息,支持添加多个分库分表。 说明 配置分库分表,需要所有表的 Schema 信息必须保持一致,否则任务会执行异常。 |
数据过滤 | 支持您将需要同步的数据进行筛选条件设置,只同步符合过滤条件的数据,可直接填写关键词 where 后的过滤 SQL 语句,例如:create_time > '${date}',表示只同步 create_time 大于等于 ${date} 的数据,不需要填写 where 关键字。 说明 该过滤语句通常用作增量同步,暂时不支持 limit 关键字过滤,其 SQL 语法需要和选择的数据源类型对应。 |
切分建 | 根据配置的字段进行数据分片,建议使用主键或有索引的列作为切分键,具体如下:
说明 目前仅支持类型为整型或字符串的字段作为切分建。 |
3.2.2 Oracle 批式写
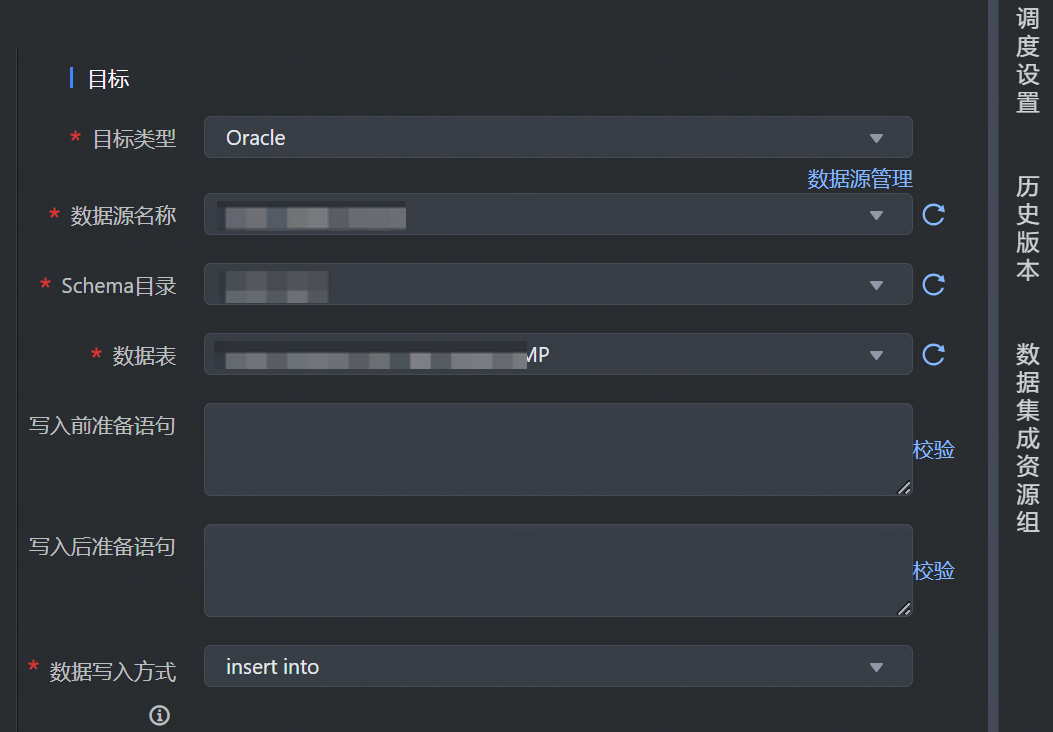
数据目标端选择 Oracle,并完成以下相关参数配置。
参数 | 说明 |
|---|---|
*目标类型 | 数据去向目标类型选择 Oracle。 |
*数据源名称 | 已在数据源管理界面注册的 Oracle 数据源,下拉可选。 |
*Schema 目录 | 数据库下已有的 Schema 目录信息,下拉可选。 |
*数据表 | 数据源下所属需数据写入的表名,下拉可选。 |
写入前准备语句 | 在执行该数据集成任务前,需要率先执行的 SQL 语句,通常是为了使任务重跑时支持幂等。 说明 可视化通道任务配置中只允许执行一条写入前准备语句。 |
写入后准备语句 | 执行数据同步任务之后执行的 SQL 语句。例如写入完成后插入某条特殊的数据,标志导入任务执行结束。 说明 可视化通道任务配置中只允许执行一条写入后准备语句。 |
*数据写入方式 | 下拉选择数据写入 Oracle 的方式:
说明 如果希望主键/唯一索引冲突时任务正常执行可以添加高级参数: |
3.2.3 Oracle 流式写
支持可视化方式配置流式写入 Oracle 单表。Oracle Writer 通过 JDBC 远程连接 Oracle 数据库,并执行相应的 SQL 语句将数据写入 Oracle。流式写入 Oracle 配置方式如下: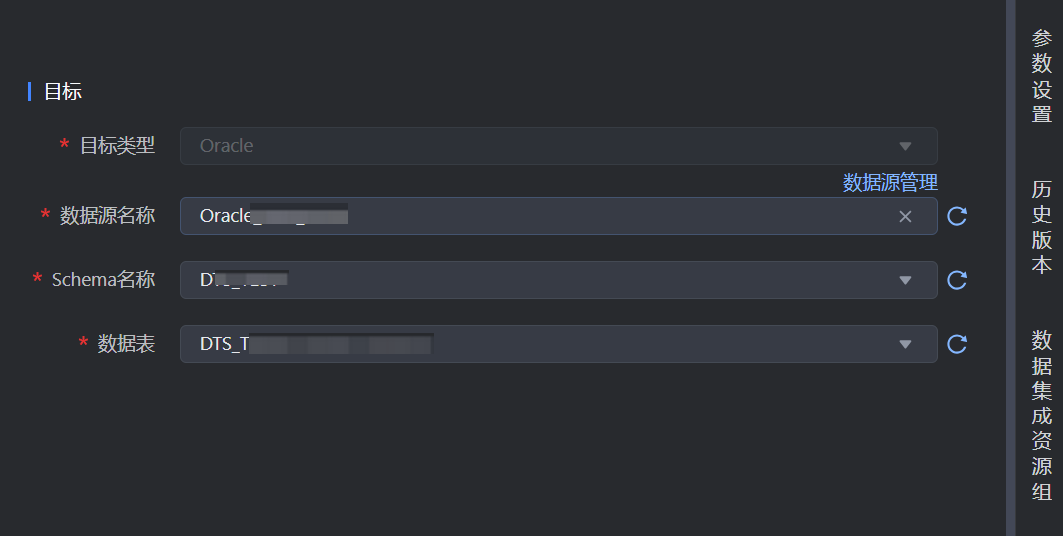
数据目标端选择 Oracle,并完成以下相关参数配置。其中参数名称前带 * 的为必填参数,名称前未带 * 的为可选填参数。
参数 | 说明 |
|---|---|
*目标类型 | 数据去向目标类型选择 Oracle。 |
*数据源名称 | 已在数据源管理界面注册的 Oracle 数据源,下拉可选。 |
*Schema 目录 | 数据库下已有的 Schema 目录信息,下拉可选。 |
*数据表 | 数据源下所属需数据写入的表名,下拉可选。 |
3.2.4 字段映射
数据来源和目标端配置完成后,需要指定来源和目标端的字段映射关系,根据字段映射关系,数据集成任务将源端字段中的数据,写入到目标端对应字段中。
您可通过以下三种方式操作字段映射关系:
- 自动添加:单击自动添加按钮,根据两端数据表信息,可以自动填充来源和目标的字段信息。
- 手动添加:单击手动添加按钮,可以手动编辑来源和目标的字段信息,可以逐个添加。
说明
来源端字段信息支持输入数据库函数和常量配置,单击手动添加按钮,在源表字段中输入需添加的值,并选择函数或常量类型,例如:
- 函数:支持输入
now()、current_timestamp()等 Oracle 数据库支持的函数。 - 常量:
- 支持自定义输入常量值,
'123'、'${DATE}'、'${hour}'等,输入值两侧需要加上英文单引号,支持结合时间参数与项目参数使用。 - 分库分表配置时,您也可手动添加
${database}_${table}或${database}.${table}形式的常量字段,将分库分表各自的来源库表信息,写入到目标表字段中。
- 支持自定义输入常量值,
- 函数:支持输入
- 移动\删除字段:您也可以根据需要移动字段映射顺序或删除字段。
3.3 DSL 配置说明
Oracle 数据源支持使用脚本模式(DSL)的方式进行配置。在某些复杂场景下,或当数据源类型暂不支持可视化配置时,您可通过任务脚本的方式,按照统一的 JSON 格式编写 Oracle Reader 和 Oracle Writer 参数脚本代码,来运行数据集成任务。
3.3.1 进入 DSL 模式
进入 DSL 模式操作流程,可详见配置 MySQL 任务的3.3.1 进入 DSL 模式。
3.3.2 Oracle 批式读(DSL)
进入 DSL 模式编辑界面后,您可根据实际情况替换相应参数,Oracle 批式读脚本示例如下:
{
  "version": "0.2",
  "type": "batch",
  "reader": {
    "type": "oracle",
    "datasource_id": 12345,
    "parameter": {
      "columns": [
        {"name": "id", "type": "NUMBER"},
        {"name": "name", "type": "VARCHAR2"},
        {"name": "create_time", "type": "TIMESTAMP"}
      ],
      "filter": "create_time > '${date}'",
      "split_pk": "id",
      "table_schema": "HR",
      "table_name": "EMPLOYEES"
    }
  },
  "writer": {},
  "common": {
    "parameter": {}
  }
}
Reader 参数说明如下表:
参数名 | 描述 | 默认值 |
|---|---|---|
*type | 数据源类型,对于 Oracle 类型,填写:oracle | 无 |
*datasource_id | 注册的 Oracle 数据源 ID。可以在项目控制台 > 数据源管理界面中查找。 | 无 |
*table_schema | 填写 Oracle 数据库中的 Schema 名称。 | 无 |
*table_name | 需要同步的数据表名称,目前单个任务只支持将单表的数据采集到一个目标表中。 | 无 |
filter | 同步数据的筛选条件,同步数据时只会同步符合过滤条件的数据,直接填写关键词 where 后的过滤 SQL 语句。
| 无 |
split_pk | 根据配置的字段进行数据分片,建议使用主键或有索引的列作为切分键,同步任务会启动并发任务进行数据同步,提高同步速率:
说明 目前仅支持类型为整型或字符串的字段作为切分建。 | 无 |
*columns | 所配置的表中,需要同步的列名集合,使用 JSON 的数组描述字段信息。
| 无 |
3.3.3 Oracle 批式写(DSL)
根据实际情况替换 Oracle 批式写相应参数,Oracle 批式写脚本示例如下:
{
  "version": "0.2",
  "type": "batch",
  "reader": {
    "type": "xx",
    "datasource_id": null,
    "parameter": {}
  },
  "writer": {
    "type": "oracle",
    "datasource_id": 12345,
    "parameter": {
      "table_schema": "HR",
      "table_name": "EMPLOYEES_TARGET",
      "pre_sql_list": ["delete from HR.EMPLOYEES_TARGET where dt='${date}'"],
      "post_sql_list": [],
      "write_mode": "directlyInsert",
      "columns": [
        {"name": "id", "type": "NUMBER"},
        {"name": "name", "type": "VARCHAR2"},
        {"name": "create_time", "type": "TIMESTAMP"}
      ]
    }
  },
  "common": {
    "parameter": {}
  }
}
Writer 参数说明如下表,其中参数名称前带 * 的为必填参数,名称前未带 * 的为可选填参数:
参数名 | 描述 | 默认值 |
|---|---|---|
*type | 数据源类型,对于 Oracle 类型,填写:oracle | 无 |
*datasource_id | 注册的 Oracle 数据源 ID。可以在项目控制台 > 数据源管理界面中查找。 | 无 |
*table_schema | 填写 Oracle 数据库中的 Schema 名称。 | |
*table_name | 填写需要同步的数据表名称,一个数据集成任务只能同步数据到一张目标表。 | 无 |
pre_sql_list | 写入前准备语句:在执行数据集成任务前,率先执行的 SQL 语句。此语句通常是为了使任务重跑时支持幂等。 说明 DSL 模式支持配置多条写入前准备语句,多条语句之间用英文逗号分隔。 | 无 |
post_sql_list | 写入后准备语句:执行数据同步任务后执行的 SQL 语句。例如数据写入完成后,插入某条特殊的数据,标志导入任务执行结束。 说明 DSL 模式支持配置多条写入后准备语句,多条语句之间用英文逗号分隔。 | 无 |
*write_mode | 数据导入模式,支持 insert into 模式:
| 无 |
*columns | 所配置的表中需要同步的列名集合,使用 JSON 的数组描述字段信息。
| 无 |
3.4 高级参数说明
- 对于可视化通道任务,读参数需要加上
job.reader.前缀,写参数需要加上job.writer.前缀,如下图所示: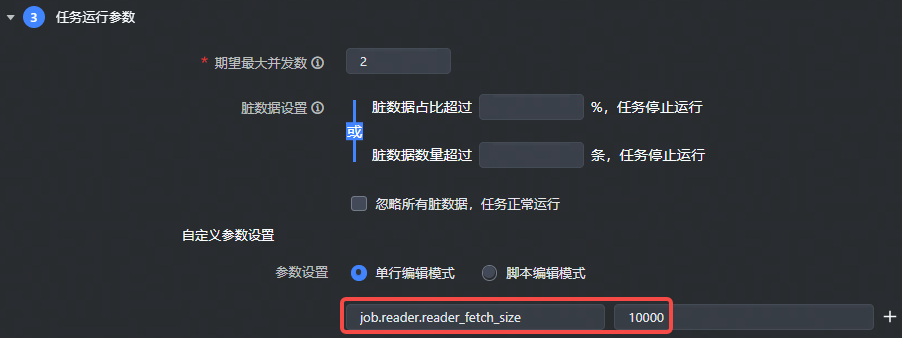
- 对于 DSL 任务,读参数请配置到
reader.parameter下,写参数请配置到writer.parameter下,直接输入参数名称和参数值。如下图所示: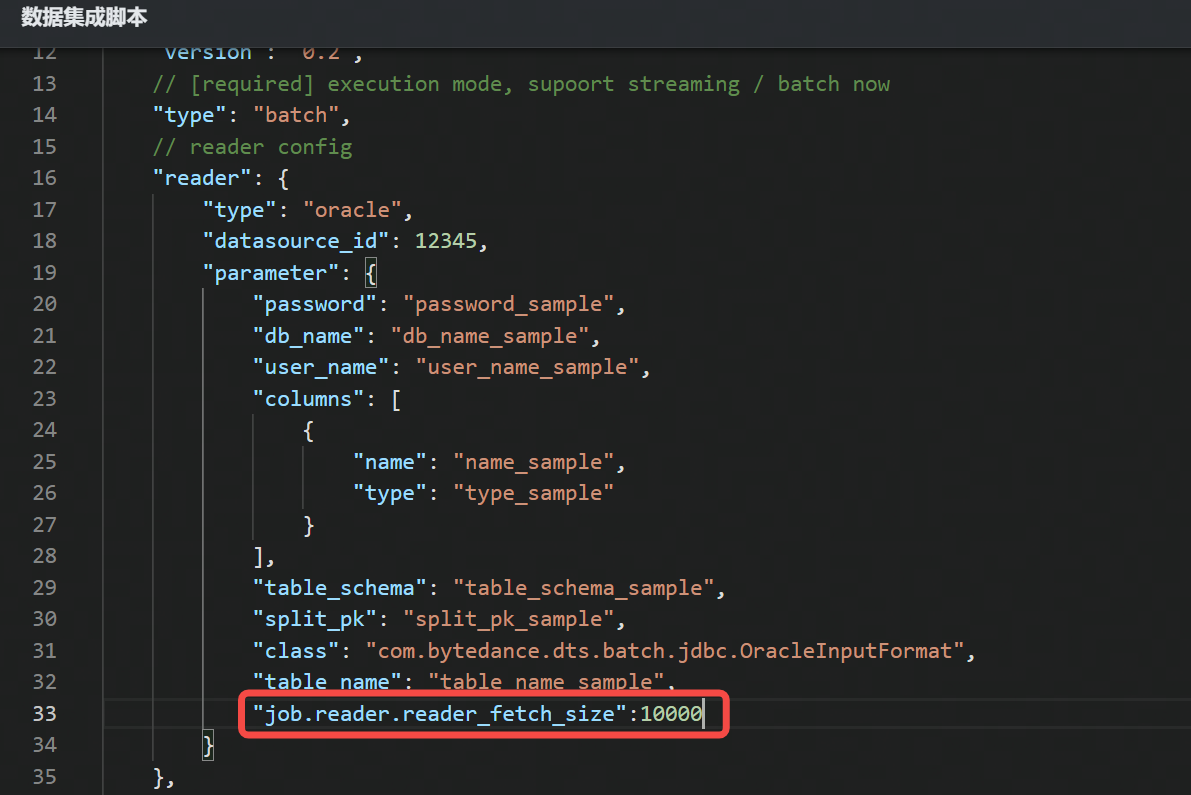
3.4.1 Oracle 批式读高级参数
批式读支持以下高级参数,您可根据实际情况进行配置:
参数名 | 描述 | 默认值 |
|---|---|---|
init_sql | 读取数据前执行的 SQL 语句。对于视图的查询可能需要使用 init SQL 语句初始化环境 | 无 |
reader_fetch_size | 每次拉取的数据条数,只在准确分片中有效。 | 10000 |
shard_split_mode | 分片模式,支持准确分片、并发分片、不分片三种模式:
| accurate |
customized_sql | 自定义查询读取 SQL 语句。filter 过滤配置项不足以描述所筛选的条件,可通过该配置项来自定义执行较复杂的查询 SQL。 说明 配置该高级参数项后,数据同步任务仍需配置 table_name、columns】、split_pk 、shard_split_mode 等必填配置项。然而,在执行同步时,系统将忽略这些配置项信息,直接使用该高级参数项中配置的内容进行数据查询和筛选。 | 无 |
3.4.2 Oracle 批式写高级参数
批式写支持以下高级参数,您可根据实际情况进行配置:
参数名 | 描述 | 默认值 |
|---|---|---|
is_insert_ignore | insert into 模式时,主键或唯一键冲突时任务失败还是忽略冲突(true = 忽略,false = 失败)。 | false |
write_batch_interval | 一次性批量提交的数据条数,该值可以减少与 Oracle 网络的交互次数并提升整体吞吐量。如果该值设置过大可能会导致数据同步进程 OOM。 | 100 |
write_retry_times | Oracle 写入失败时重试次数。 | 3 |
retry_interval_seconds | 写入失败后两次重试的时间间隔(单位:秒)。 | write_batch_interval / 10 |
4 最佳实践
4.1 离线同步性能优化
切分键选择策略如下表所示:
表特征 | 推荐切分键 | 预期效果 |
|---|---|---|
有自增主键(NUMBER 类型) | 主键列 | 最佳并发效果 |
有唯一索引(字符串类型) | 唯一索引列 | 较好并发效果 |
无主键无索引 | 不配置(nosplit 模式) | 单并发,速度较慢 |
分区表 | 分区键或主键 | 利用分区特性提升查询效率 |
说明
reader_fetch_size 的调优建议如下:
- 默认值 10000 适用于大多数场景。
- 如果表中包含 LOB 字段(CLOB/BLOB),建议降低至 1000 到 5000,避免内存占用过高。
- 如果表字段较少且每行数据量较小,可适当增大至 20000 到 50000,提升吞吐量。
4.2 写入幂等性设计
在数据集成任务中,写入幂等性是保证数据一致性的关键。建议采用以下策略:
-- 方案一:写入前清空目标分区数据(推荐)
-- pre_sql_list 配置:
-- ["delete from target_table where dt = '${date}'"]

-- 方案二:使用 is_insert_ignore 忽略主键冲突
-- 高级参数配置:
-- job.writer.is_insert_ignore = true
说明
方案一更加安全,能确保每次执行后目标表中的数据完全一致。方案二适用于追加写入场景,但可能导致旧数据无法被更新。
4.3 LogMiner CDC 运维建议
- 归档日志管理
- 建立定期巡检机制,确保归档日志空间充足(建议监控 V$RECOVERY_FILE_DEST 使用率)。
- 配置 RMAN 定期清理过期归档日志,但需确保清理策略与 DataSail 同步延迟相匹配。
- 建议归档日志保留时间不少于 24 小时,生产环境建议不少于 48 小时。
- 性能监控
- 关注 Oracle Alert Log 中是否有 LogMiner 相关的告警。
- 监控 V$LOGMNR_CONTENTS 的查询性能,高负载时可能需要调整 DataSail 端的采集并发。
- 全列补充日志会增加 Redo Log 生成量,建议在启用前评估存储影响。
- 故障恢复
- 如果 DataSail CDC 任务中断时间超过归档日志保留时间,需要重新执行全量同步。
- 建议为 Oracle CDC 任务配置实时任务监控及告警,及时发现同步异常。
4.4 安全最佳实践
安全措施 | 说明 |
|---|---|
最小权限原则 | 为 DataSail 用户仅授予必要的表和系统视图权限,避免使用数据库管理员(DBA)角色。 |
密码策略 | 使用强密码,定期轮换,避免在脚本中明文存储。 |
网络隔离 | 优先使用 VPC 私网连接,避免 Oracle 数据库暴露在公网。 |
审计日志 | 开启 Oracle 审计功能,记录 DataSail 用户的操作行为。 |
白名单配置 | 仅允许 DataSail 集成资源组的 IP 地址访问 Oracle 数据库。 |