缓存数据库 Redis 版
缓存数据库 Redis 版


文档指南

请输入


- 文档首页
 缓存数据库 Redis 版常见问题报错和异常为什么 Redis 平均 QPS 和资源利用率不高,仍会出现较高的延迟?
 复制全文
 下载 pdf
为什么 Redis 平均 QPS 和资源利用率不高,仍会出现较高的延迟?
 文档反馈
 问问助手
使用缓存数据库 Redis 版时,您可能遇到这样的情况:监控中的平均 QPS、CPU 利用率或网络带宽均不高,但应用偶尔出现较高的 P99 延迟,甚至请求超时。检查慢日志时,也可能没有发现对应的慢命令。
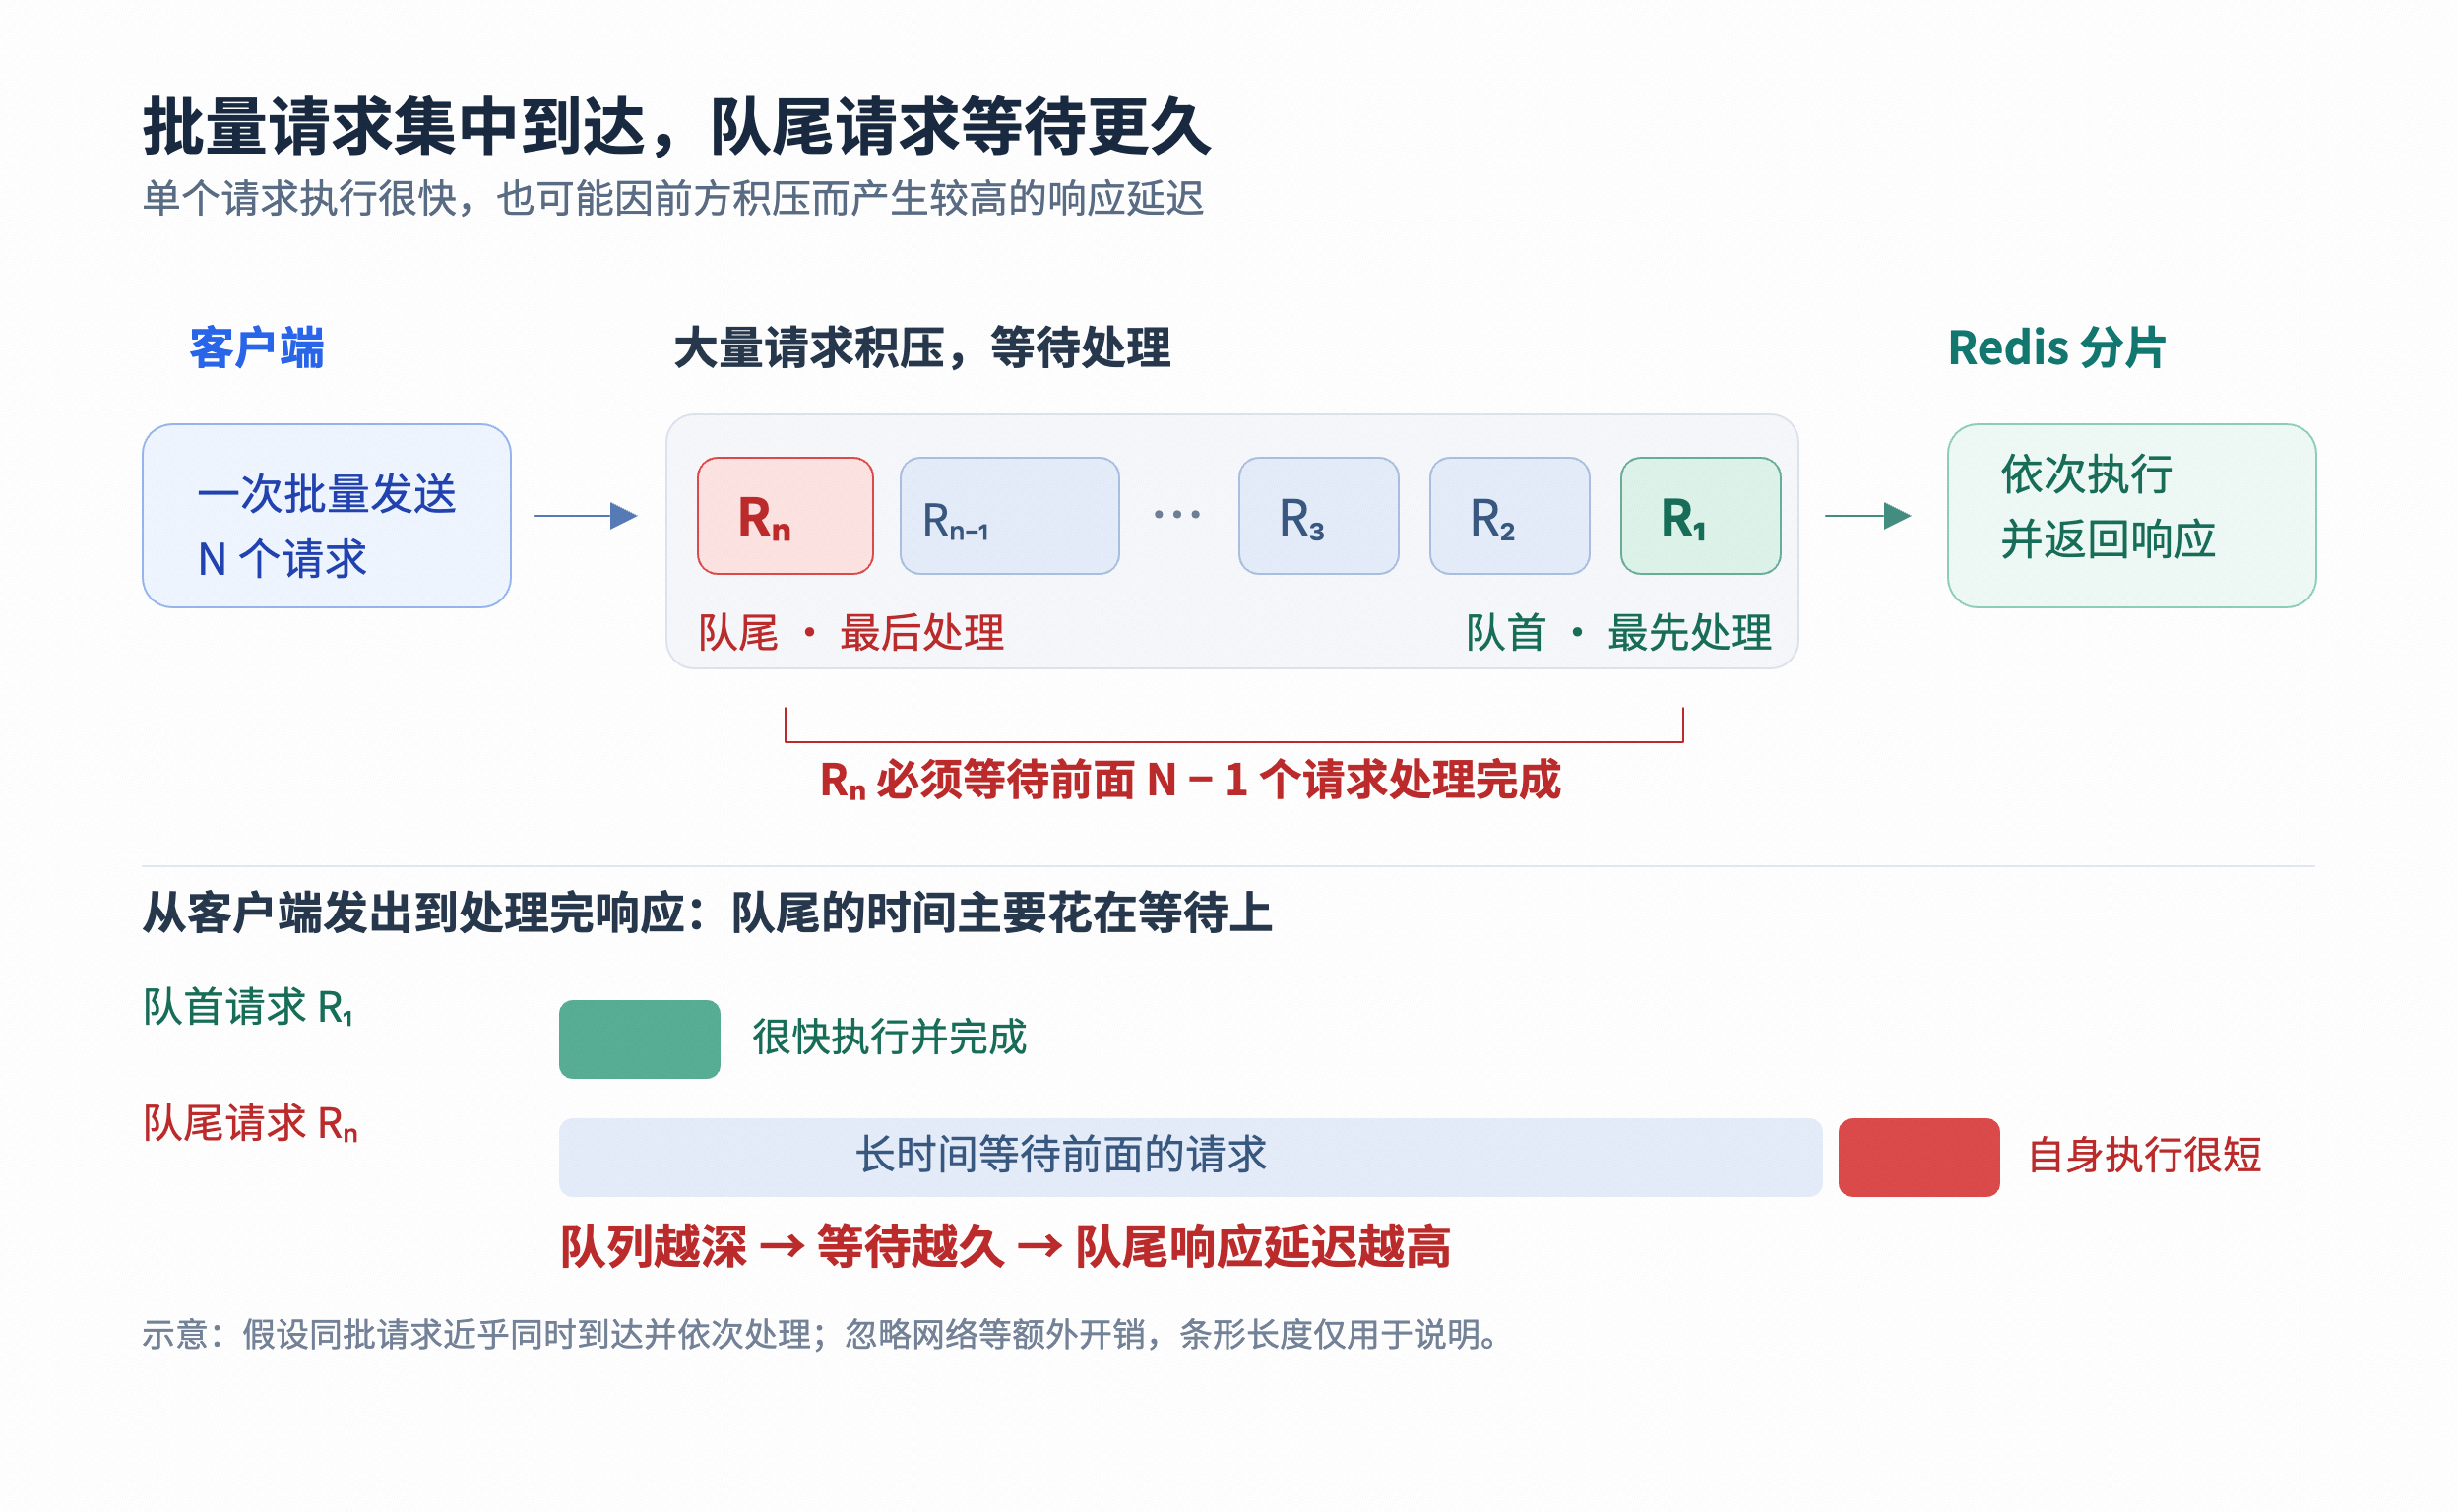
短时突发(Micro Burst)请求是造成这一现象的可能原因之一。当大量请求集中在极短时间内到达同一个处理节点或分片,超过该时间段内的处理能力时,部分请求需要排队等待。即使每条命令本身执行很快,排在后面的请求也可能因等待而产生较高延迟。较长统计周期内的平均值,无法完整反映这种短时拥塞。
本文解释这一机制,并介绍排查和缓解方法。文中数值均为原理演示,不代表任何实例规格的性能承诺。具体指标名称、采集周期及诊断功能,以所使用云产品的说明为准。
一、平均负载低,为什么仍然会发生拥塞?
1. 平均 QPS 无法反映请求是否集中到达
QPS 通常表示单位时间内的请求数量,通过采集周期内计数器差值计算除以周期时间来计算:
统计周期内的平均 QPS = 统计周期内的请求数 ÷ 统计周期时长(秒)
假设采集周期为一分钟,某一分钟内共有 6,000 个请求,那么平均 QPS 为 100。但这 6,000 个请求既可能均匀分布在一分钟内,也可能集中在几十毫秒内发出。两者的平均 QPS 相同,对系统瞬时处理能力的要求却相差很大。
除了 QPS 外,CPU 利用率和网络吞吐量等指标都可能受到时间聚合的影响:资源在短时间内繁忙,随后长时间空闲,最终展示出来的平均值仍然较低。
当客户端短时间内批量发送大量请求时,请求需要按顺序在Redis上排队处理。虽然单个请求耗时很短,但队列尾部的请求大部分时间消耗在了等待签名的请求处理上,如下图所示:
2. 计算示例:平均 QPS 约为 83,尾部延迟却接近 40 毫秒
假设单个 Redis 分片每秒可处理 100,000 个请求,平均每个请求耗时 10 微秒。从某个时间点开始,客户端在 10 毫秒内发出 5,000 个请求,这一分钟内没有其他后续的请求。为简化计算,暂不计网络传输、代理转发及客户端处理响应等额外耗时。
第 5,000 个请求约在第 10 毫秒发出,但需要等前面的请求处理完,约到第 50 毫秒才能完成。因此,在上述简化条件下,从客户端发出到客户端完整接收并处理响应的耗时约为:
最后一个请求的耗时 ≈ 5,000 × 10 微秒 − 10 毫秒
= 50 毫秒 − 10 毫秒
= 40 毫秒
虽然这条请求本身只需 10 微秒即可执行,但加上排队等待,客户端感知的耗时已达到约 40 毫秒。实际场景还需计入网络传输、代理转发和客户端处理响应等耗时。此时,如果观察QPS和延迟监控,可以看到:
观察指标 | 计算结果 |
QPS | 约 83.3 |
请求响应耗时 | 约 40 毫秒 |
同一批流量,既可以表现为“分钟平均 QPS 只有约 83”,也可以造成“队尾请求延迟约 40 毫秒”。这两个结果并不矛盾,分别描述了较长周期内的平均吞吐量和单个请求经历的等待。
二、哪些业务模式容易产生短时突发?
这些模式只是排查线索,是否产生拥塞取决于请求集中程度、命令开销和目标节点的实际处理能力。
三、如何缓解短时突发导致的高延迟?
1. 平滑请求发送速度
将集中任务拆成较小批次,错开定时任务执行时间,或给不同客户端的启动和重试时间加入随机抖动。需要限速时,应同时约束短时间内可释放的请求量,避免“每秒总量受控,但在一秒开始时全部放行”。
2. 为客户端使用合理的配置
根据业务并发量和延迟目标,合理设置客户端的连接复用方式、连接池大小及等待超时。对于 Spring Data Redis + Lettuce,如果确认共享连接存在竞争或响应积压,可评估使用底层连接池。
3. 为 Pipeline 选择合适批次
Pipeline 可以减少往返等待并提高吞吐,但批次过大或多个客户端同时提交批次,也可能使流量更集中。建议结合命令数量、请求与响应字节数、批次并发数及尾延迟目标确定批次大小,并通过真实业务负载验证。
- 在代理模式的缓存数据库 Redis 版实例中,代理节点到数据节点之间已采用 pipeline 收敛模式,建议在使用此类型实例时减少对 pipeline 的使用。
- Pipeline 一定程度上会降低缓存数据库的利用率:数据库系统在“削峰填谷“的连续访问下总吞吐在算术平均上会高于短时突发(Micro Burst)。详细建模过程请参考排队论。
注意
- 缓存数据库的 pipeline,如社区版Redis/Valkey 的pipeline的实现,过去/当前/未来都不保证原子性和事务性。请正确使用标准 Redis/Valkey MULTI/EXEC 来描述原子性和事务使用。
- 如果选择队列深度过深的 pipeline,建议业务选择和调高合适的 read timeout。由于受到请求在短时突发(Micro Burst)处理能力的可能排队,队尾的请求需要等待全部堆积完成后返回,在用户侧表现为业务侧 rt 升高。
4. 减少热点和单次请求开销
优化耗时命令、脚本及大范围数据读取,减少大响应。对于热点访问,在业务语义允许时使用本地缓存或数据拆分,降低同一分片上的集中负载。
5. 按实际瓶颈增加处理能力
若平滑流量后仍不能满足目标,应根据瓶颈选择能够提高单分片处理能力或网络能力的规格,或增加分片并改善数据分布。增加分片只有在流量能够分散时才会有效;同一个热点 Key 的请求通常不会因分片数量增加而自动均分。
容量评估应采用真实的命令组合、数据大小、并发度和突发模式,并同时验证 P99、超时率和积压恢复时间。只依据平均 QPS 或稳定流量下的最大吞吐量,可能低估对延迟敏感业务所需的余量。
6. 控制重试放大
对于可重试错误,设置有上限的重试次数、退避和随机抖动,并确认操作是否允许重复执行。客户端超时不代表服务端已经取消原请求,立即大量重试可能使积压进一步增加。
单纯调大超时时间不会提高处理能力,也不会消除排队。超时设置应与业务允许等待的时间、重试策略和整体调用期限共同设计。
最近更新时间:2026.10.10 17:11:02
这个页面对您有帮助吗?
有用
有用
无用
无用