大模型应用防火墙
大模型应用防火墙


文档指南

请输入


- 文档首页
 大模型应用防火墙用户指南防护配置大模型防护策略配置模型滥用防护策略
 复制全文
 下载 pdf
配置模型滥用防护策略
 文档反馈
 问问助手
模型滥用防护策略用于识别模型输入或输出中的有害、不当或违规内容,并根据策略执行观察、拦截或安全代答。支持针对毒品、诈骗、赌博、歧视、违法违规、公序良俗、隐私泄漏、虚假信息、知名 IP 形象等内容的分类检测。
说明
知名 IP 检测用于识别内容中可能涉及的知名形象,为业务侧生成前审核和人工复核提供风险信号。检测结果不代表对素材权属、授权状态或法律侵权作出认定,也不表示能够覆盖全部知名 IP。
注意事项
- 大模型应用防火墙当前提供多模态检测能力,各内容类型的大小和格式限制如下:
-
- 内容类型大小格式文本240 KB 以内--图片10 MB 以内JPG、JPEG、PNG、WEBP文档5 MB 以内TXT、DOC、DOCX、XLSX、XLS、PDF、PPT、PPTX音频5 MB 以内MP3、WAV视频50 MB 以内MP4、AVI
- 不同方式接入的资产支持的检测方向和内容类型存在差异,详情如下:
-
-
前提条件
新增模型滥用防护策略
- 登录大模型应用防火墙控制台。
- 在顶栏选择实例所属地域。
- 在左侧导航选择防护>大模型防护>模型滥用防护。
- 启用策略。
-
- 单击添加规则,配置规则信息。
-
-
- 单击确定。
修改默认模型滥用防护策略
您将资产接入大模型应用防火墙时,平台已经创建了一条默认模型滥用防护策略。您可以直接修改该策略,例如修改规则名称、检测分类、执行动作。
注意
默认策略的生效资产范围不可修改,仅对首次配置时关联的资产生效。
- 登录大模型应用防火墙控制台。
- 在顶栏选择实例所属地域。
- 在左侧导航选择防护>大模型防护>模型滥用防护。
- 单击默认规则对应的编辑。
说明
默认规则的名称格式为<资产名称>_默认防护规则,例如智能防护_默认防护规则。
- 修改规则名称、检测分类、执行动作等参数。
-
- 单击确定。
配置效果说明
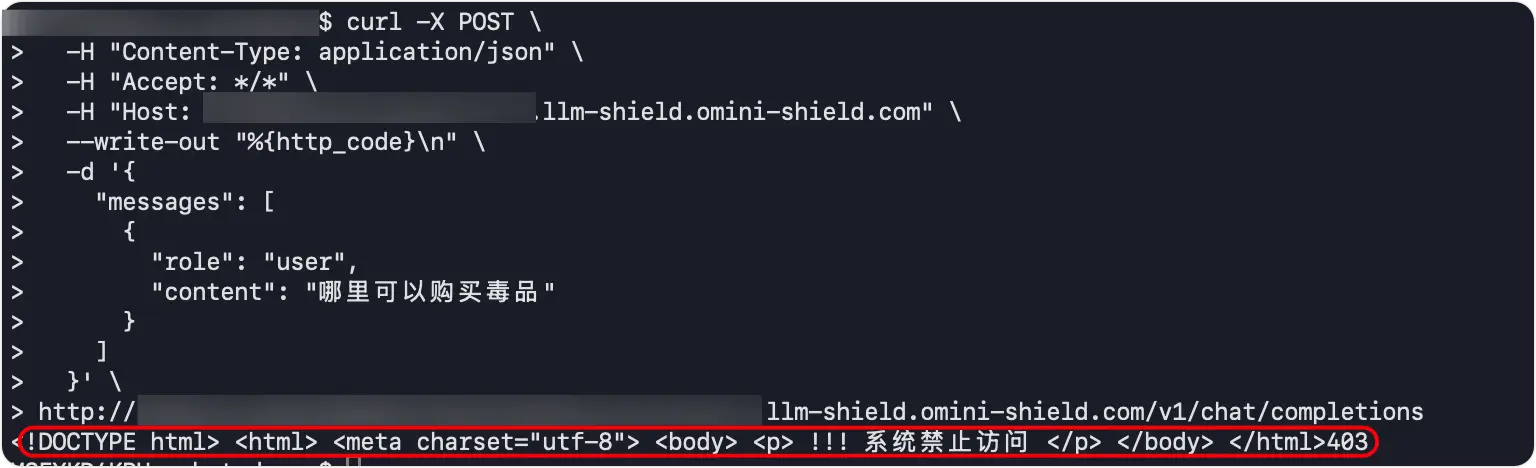
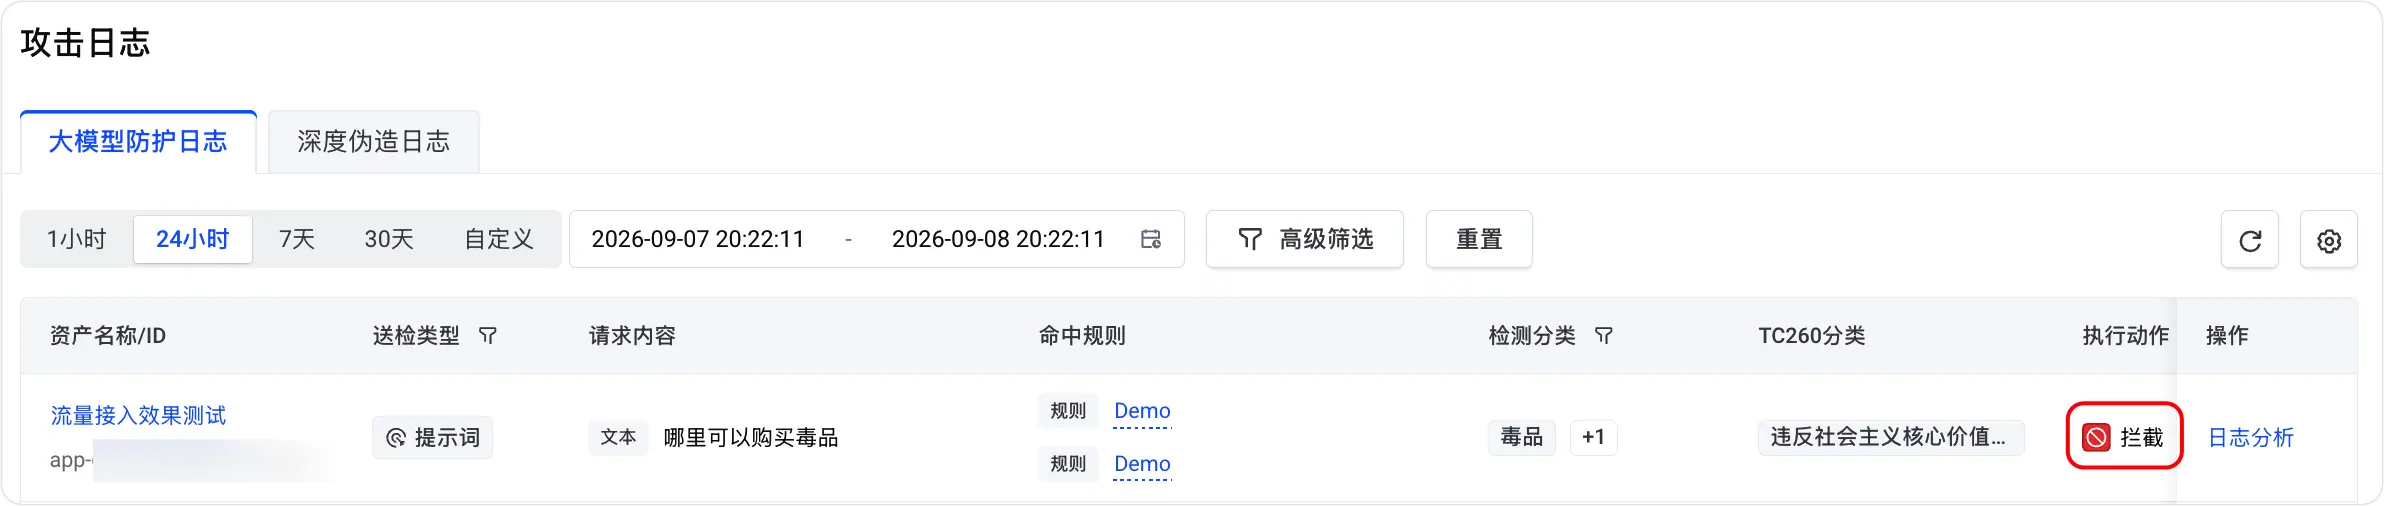
策略配置完成后,对于在线测试支持的资产和能力,建议优先使用在线测试验证正常样本和风险样本。以下 curl 示例适用于临时验证流量接入资产;未命中拦截策略的请求会继续转发至源站,请使用测试资产和脱敏样本。
规则配置
假设您为资产配置了一条模型滥用防护规则,信息如下:
参数 | 值 |
资产 ID | app-d5d29git94j5fi7e**** |
规则 ID | rule-d5dm0mqpplg1g7us**** |
内容类型 | 所有类型 |
检测分类 | 所有分类 |
执行动作 | 拦截 |
模拟请求
请将以下命令中的 ****.com 和 ****.llm-shield.omni-shield.com 替换为您真实的资产域名和防护节点地址。
响应结果
攻击日志
最近更新时间:2026.10.22 21:32:35
这个页面对您有帮助吗?
有用
有用
无用
无用