云数据库 PostgreSQL 版
云数据库 PostgreSQL 版


文档指南

请输入


- 文档首页
 云数据库 PostgreSQL 版用户指南插件高维向量相似度搜索(pg_vector)
 复制全文
 下载 pdf
高维向量相似度搜索(pg_vector)
 文档反馈
 问问助手
关于 pg_vector
pg_vector 是一款对高维度向量提供高效相似度搜索能力的插件,该插件具备以下功能:
- 支持向量数据类型,能够存储和查询向量数据。
- 支持精确和近似最近邻搜索(Approximate Nearest Neighbor,简称 ANN),支持的距离或相似度度量方法包括欧氏距离(L2 正则化欧氏距离,L2 norm Euclidean Distance)、曼哈顿距离(L1 Manhattan Distance)、余弦相似度(Cosine Similarity)以及内积运算(Inner Product)。
- 最大支持创建 16000 维度的向量,最大支持对 2000 维度的向量建立索引。
使用插件
创建插件
说明
需使用高权限账号创建插件。
查询插件版本
如您的实例版本为 PostgreSQL 11 且使用的插件版本低于 0.5.0,可通过以下命令升级插件版本到 0.5.0。
如您的实例版本为 PostgreSQL 12 或更高版本,可通过以下命令升级插件版本到 0.6.2。
如您的实例版本为 PostgreSQL 13 或更高版本,可通过以下命令升级插件版本到 0.8.2。
删除插件
数据类型
pg_vector 提供了 3 种向量数据类型(以下示例基于 vector 类型)。
insert&select
向量操作符
pg_vector 插件为向量类型实现了 14 种操作符。
注意
- 使用操作符计算的两个向量需要有相同的维度。
- 为方便使用,pg_vector 对欧氏距离运算、曼哈顿距离运算、余弦相似度运算、内积运算的结果进行了统一化处理:运算结果越小,表示参与运算的两个向量相似度越高。
索引
通常,单表中存储的向量条目(行数)会有上亿之多,为了加速 vector 类型数据的访问和相似度计算,pg_vector 提供了三种索引类型:btree 索引、ivfflat 索引和 hnsw 索引。
创建索引
- 创建 btree 索引
-
说明
- 创建 btree 索引时,要求向量维度小于等于 674 维。
- 实际使用中,建议将需要创建 btree 索引的向量维度控制在 500 或 500 以内,防止因为 toast 访问引起索引扫描效率下降等问题。
- 创建 ivfflat 索引
-
说明
- 创建 ivfflat 索引时如不指定 opclass ,默认使用 vector_l2_ops。
- ivfflat 索引要求被索引的 vector 列维度必须小于等于 2000。
- ivfflat 不支持多列索引。
- ivfflat 索引仅仅适用于 order by,不适用于 where 过滤。因为 where 条件只能用于 bool 类型或者 bool 表达式,而 ivfflat 的操作符 (<->、<=>、<#>)的返回值不是 bool 类型。
- 索引扫描时,召回率取决于 ivfflat.probes 和创建索引时指定的 lists 值。ivfflat.probes 值越高,召回率越高,索引扫描性能越低,ivfflat.probes 越低,召回率越低,索引扫描性能越高。召回率最高的是顺序扫描。
- 创建 hnsw 索引
-
说明
- hnsw 索引要求被索引的 vector 列维度必须小于等于 2000。
- hnsw 不支持多列索引。
- hnsw 索引仅适用于 order by,不适用于 where 过滤。因为 where 条件只能用于 bool 类型或者 bool 表达式,而 hnsw 的 操作符 (<->、<=>、<#>)返回值不是 bool 类型。
- 查询索引当前的构建进度
说明
该功能仅在 pg_vector 0.6.2 及更高版本实例中提供。
-
索引参数
- ivfflat 索引参数
- 以下两个参数,分别用于 ivfflat 索引创建和索引扫描:
- 参数何时使用含义lists创建索引时指定,insert 时使用。
- 最小值为 1,最大值 为 32768,默认值为 100,表示往索引中的数据集分成的列表数。该值越大,表示数据集被分割得越多,各个子集的大小就越小,查询效率就越快。
- lists 值不宜过大,建议设置在 2000 以内。否则创建索引时会占据较多内存,有可能引起内存不足,导致索引创建失败。
ivfflat.probes查询时指定,索引扫描时使用。最小值为 1,最大值为 32768,默认值为 1,在本次索引扫描过程中,搜索的列表数目。该值越大,搜索扫描搜索的列表数越多,召回率(recall)就会越高,但是索引扫描效率会有所降低;反之,该值越小,索引扫描搜索列表数越少,召回率就会较低,但是索引扫描的效率会有所提升。 如果该值大于创建索引时指定的 lists 值时,查询优化将会忽略索引,选择全表扫描。此时,可能会降低查询性能。ivfflat.iterative_scan查询时指定,索引扫描时使用。可选值为"off"或"relaxed_order"。若设置为"relaxed_order",在查询时,会扩大索引扫描的范围,获得更高的召回率,自然也会消耗更多的时间。ivfflat.max_probes查询时指定,索引扫描时使用。最小值为 1,最大值为 32768,默认值为 32768。ivfflat.iterative_scan 设置为"relaxed_order"时生效,在本次索引扫描过程中,搜索的最大列表数目为 max(ivfflat.probes, ivfflat.max_probes)。
- hnsw 索引参数
- 以下六个参数,分别用于 hnsw 索引的创建和扫描:
- 参数何时使用含义m创建索引时指定,insert 时使用。表示每个点需要与图中其他的点建立的连接数。m 的最小值为 2,最大值为 100,默认值为 16。通常 m 越大召回率越高,同时内存消耗越大;m 值越小,构建时间就越短。ef_construction创建索引时指定,insert 时使用。表示构建索引时动态候选集合的大小。ef_construction 的最小值为 4,最大值为 1000,默认值为 64。ef_construction 必须大于 m,通常设置为 m 值的 2 倍。对于聚集性数据而言,通常 ef_construction 取较大值时效果更佳。ef_construction 的值越大,索引构建速度越慢。hnsw.ef_search查询时指定,索引扫描时使用。该参数为查询时参数,用于限制返回的最大记录数和准确性。hnsw.ef_search 的最小值为 1,最大值为 1000,默认值为 40。例如,将 hnsw.ef_search 值设置为 40,则查询将只能返回 40 行,即使您尝试查询 100 个最近邻的记录。通常 hnsw.ef_search 越大搜索准确度越高,同时消耗的时间越长。hnsw.iterative_scan查询时指定,索引扫描时使用。可选值为"off"、"relaxed_order"或"strict_order"。若设置为"relaxed_order"或"strict_order",在查询时,会扩大索引扫描的范围,获得更高的召回率,自然也会消耗更多的时间。hnsw.max_scan_tuples查询时指定,索引扫描时使用。最小值为 1,默认值为 20000,限制扩大索引扫描时访问的最大 tuple 数量。hnsw.scan_mem_multiplier查询时指定,索引扫描时使用。最小值为 1,最大值为 1000,默认值为 1,设置扩大索引扫描时的使用的内存为 work_mem 的倍数。
- 以下三个参数,可以用于加快 hnsw 索引构建速度:
- 参数含义max_parallel_workers设置系统的最大并行进程数量,默认值为 8。max_parallel_maintenance_workers设置单一工具性命令(例如 CREATE INDEX)的最大并行进程数。maintenance_work_mem指定在维护性操作(例如 VACUUM、CREATE INDEX)中使用的最大的内存量。
使用示例
- 创建并使用 btree 索引。
-
- 创建 ivfflat 索引,并使用 vector_l2_ops,进行欧式距离相似性搜索。
-
- 创建 ivfflat 索引,并使用 vector_cosine_ops,进行余弦相似性搜索。
-
- 创建 ivfflat 索引,并使用 vector_ip_ops,进行内积相似性搜索。
-
- 并行创建 hnsw 索引,并使用 max_parallel_workers、max_parallel_maintenance_workers 和 maintenance_work_mem 参数。
-
- 创建 hnsw 索引,并使用 vector_l2_ops,进行欧式距离相似性搜索。
-
- 创建 hnsw 索引,并使用 vector_cosine_ops,进行余弦相似性搜索。
-
- 创建 hnsw 索引,并使用vector_ip_ops,进行内积相似性搜索。
-
说明
以上示例代码中的高召回率和低召回率仅代表设定场景下的结果,实际情况下需要根据业务模型进行调整。
聚合函数
pg_vector 插件为向量类型提供了两个聚合函数 avg() 和 sum()。
- avg() 函数用于计算向量每一维度的平均值,使用方法如下示例所示:
-
- sum() 函数用于对 vector 的每一维度进行求和,使用方法如下示例所示:
-
类型转换
pg_vector 插件提供了向量类型和几种数组类型的转换。
转换类型 | 使用示例 |
将 vector 转换为 vector | |
将 vector 转换为 real[ ] | |
将 real[ ] 转换为 vector | |
将 int4[ ] 转换为 vector | |
将 double precision[ ] 转换为 vector | |
将 numeric[ ] 转换为 vector | |
pg_vector 向量运算性能介绍
云数据库 PostgreSQL 版的向量化场景中,典型场景是存储经过大语言模型(Large Language Model,简称 LLM)(比如:text-embedding-ada-002)处理过后的 embeddings 向量(维度固定为 1536 维),并计算他们的相似度。本文以此场景为参考,验证不同数据量、不同线程数、不同并发数、不同索引和不同参数取值,对数据库 TPS 和时延的影响。
测试参数
测试参数 | |
测试并发数 | 6/16 |
测试线程数 | 1/4 |
测试时间 | 60s |
PostgreSQL实例规格 | 单 AZ 一主一备 32C64G |
客户端规格 | 32vCPU128GiB 极速型 SSD PL0 40 GiB |
测试流程
测试步骤 | 语句 |
创建插件 | |
创建表和索引 | |
创建函数,生成指定维度的 embedding 数据 | |
导入 10 万条数据 | |
pg_bench 压测 sql 语句:vtest.sql | |
pgbench 执行 | |
导入 20 万条数据 | |
导入 40 万条数据 | |
导入 60 万条数据 | |
导入 80 万条数据 | |
导入 100 万条数据 | |
测试结果
pgbench 性能
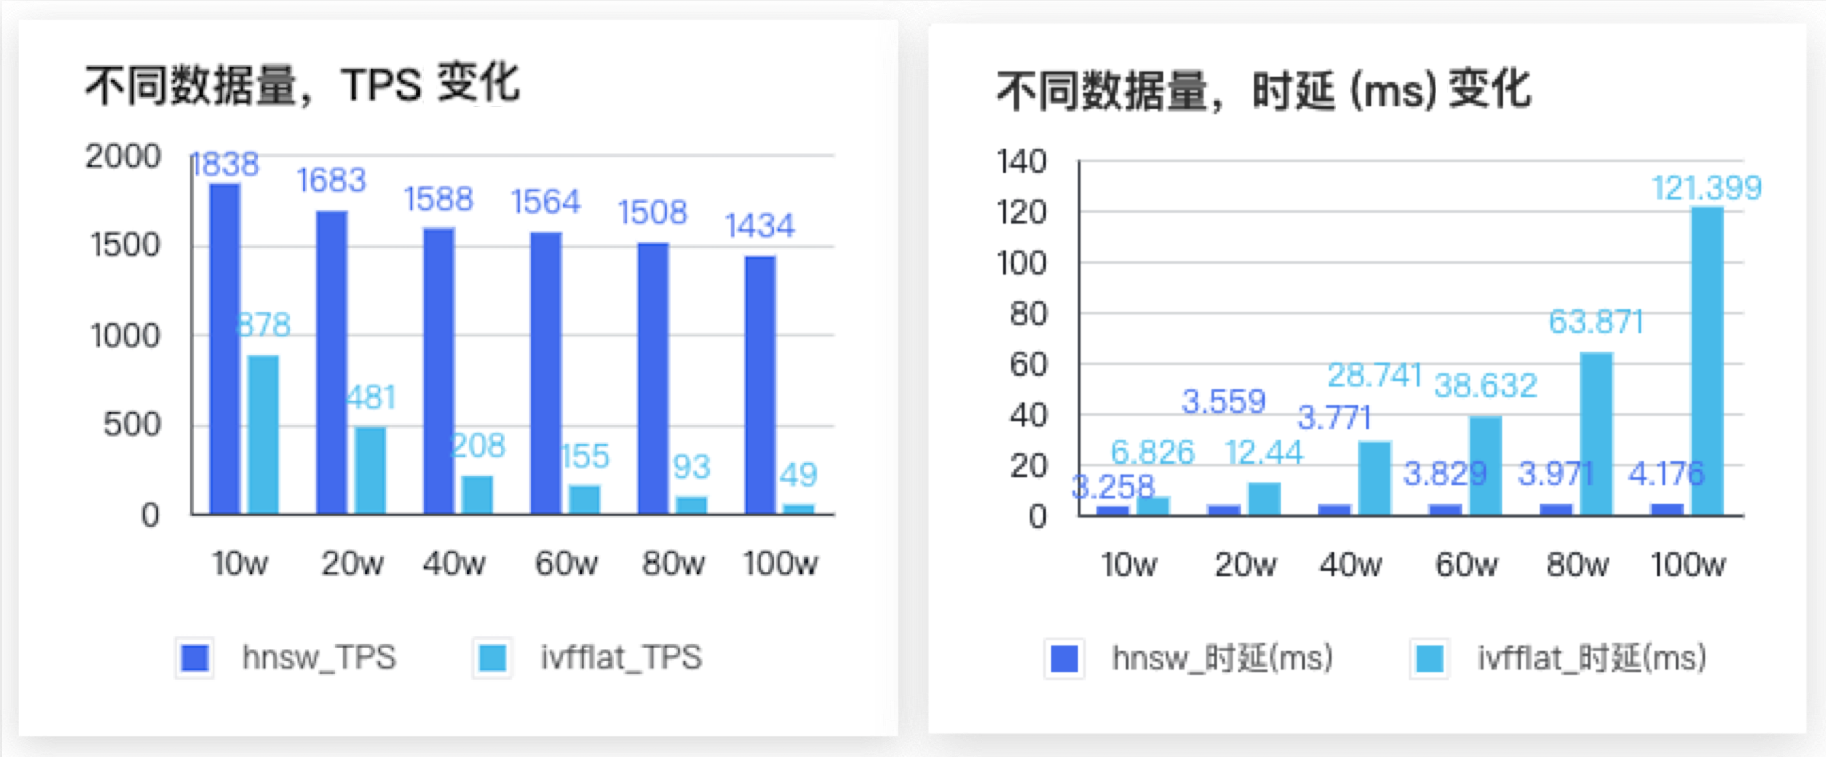
hnsw 索引与 ivfflat 索引对 TPS 和时延的影响
在单 AZ 一主一备 32C64G 实例、 6 并发 1 线程、不同数据量场景下,使用 hnsw 索引与 ivfflat 索引时对 TPS 和时延的影响。
超参数对于 TPS 和时延的影响
在单 AZ 一主一备 32C64G 实例、 60 万数据量、 16 并发 4 线程场景下,固定 m 和 ef_construction 的值,设定不同的 hnsw.ef_search 值对于 TPS 和时延的影响。

最佳实践
最近更新时间:2026.10.16 14:17:39
这个页面对您有帮助吗?
有用
有用
无用
无用