API 网关
API 网关


文档指南

请输入


- 文档首页
 API 网关用户指南插件中心流量管控LLM 负载感知路由
 复制全文
 下载 pdf
LLM 负载感知路由
 文档反馈
 问问助手
LLM 负载感知路由适用于大语言模型推理服务的流量调度场景。当后端部署了多个推理实例(如多台 GPU 服务器),且希望根据后端 GPU 的真实负载状态(例如:排队请求数、KV-Cache 使用率等)智能分配推理请求时,可通过配置 LLM 负载感知路由插件实现动态调度。
背景信息
什么是 LLM 负载感知
LLM 负载感知是指网关主动采集并利用后端推理实例的实时运行指标,将这些指标作为流量调度的核心决策依据。与传统负载均衡通过连接数或请求数来间接估算负载不同,负载感知能够直接反映 GPU 的真实负载程度。LLM 负载感知核心能力如下。
- 资源感知的请求调度:能够识别每个请求的实际资源开销差异,在 LLM 推理中,不同 Prompt 的 Token 长度差异显著,单个请求占用的 GPU 显存和计算时间高度不一致。负载感知路由基于后端实例的真实资源消耗状态进行调度,而非简单均分请求。
- 真实负载度量:以 GPU 实际负载而非连接数作为调度依据。一个长输出的推理请求虽然只占一个连接,但可能持续占用大量 GPU 资源数十秒,负载感知路由能够穿透连接层看到实例的真实压力。
- 实时后端状态感知:主动拉取后端推理实例的 GPU 利用率和推理队列深度,当某个实例已经出现排队溢出时,自动将新请求调度到空闲实例,避免继续向已过载的实例分配流量。
使用场景
- 多实例推理集群:多台 GPU 服务器部署同一模型,通过负载感知路由避免个别实例过载导致推理延迟上升。
- 混合模型部署:不同规格的 GPU 实例混合部署同一模型,资源消耗差异明显,利用负载感知实现基于实际 GPU 负载进行智能调度。
- 高并发推理服务:对于在线推理服务,请求量波动大,需要通过负载感知避免单实例排队过长导致超时。
前提条件
- 已创建网关实例,详情请参见 创建实例。
- 已将网关实例升级至 3.3.0 及以上版本,详情请参见 版本管理。
- 已创建服务,详情请参见 创建服务。
- 已创建路由,详情请参见 创建路由。
使用限制
- 同一插件在同一资源上只能绑定一次。
- 在同一路由中,LLM 负载感知路由插件、LLM Session 亲和路由插件 和 MCP 会话保持插件 互斥,不能同时开启。
操作步骤
- 登录 API 网关控制台。
- 在顶部导航栏,选择目标地域。
- 在左侧导航栏 实例管理 下拉框中选择目标实例后,单击 插件中心 > 流量管控 > LLM 负载感知路由插件。
- 单击 创建插件,配置插件参数。
-
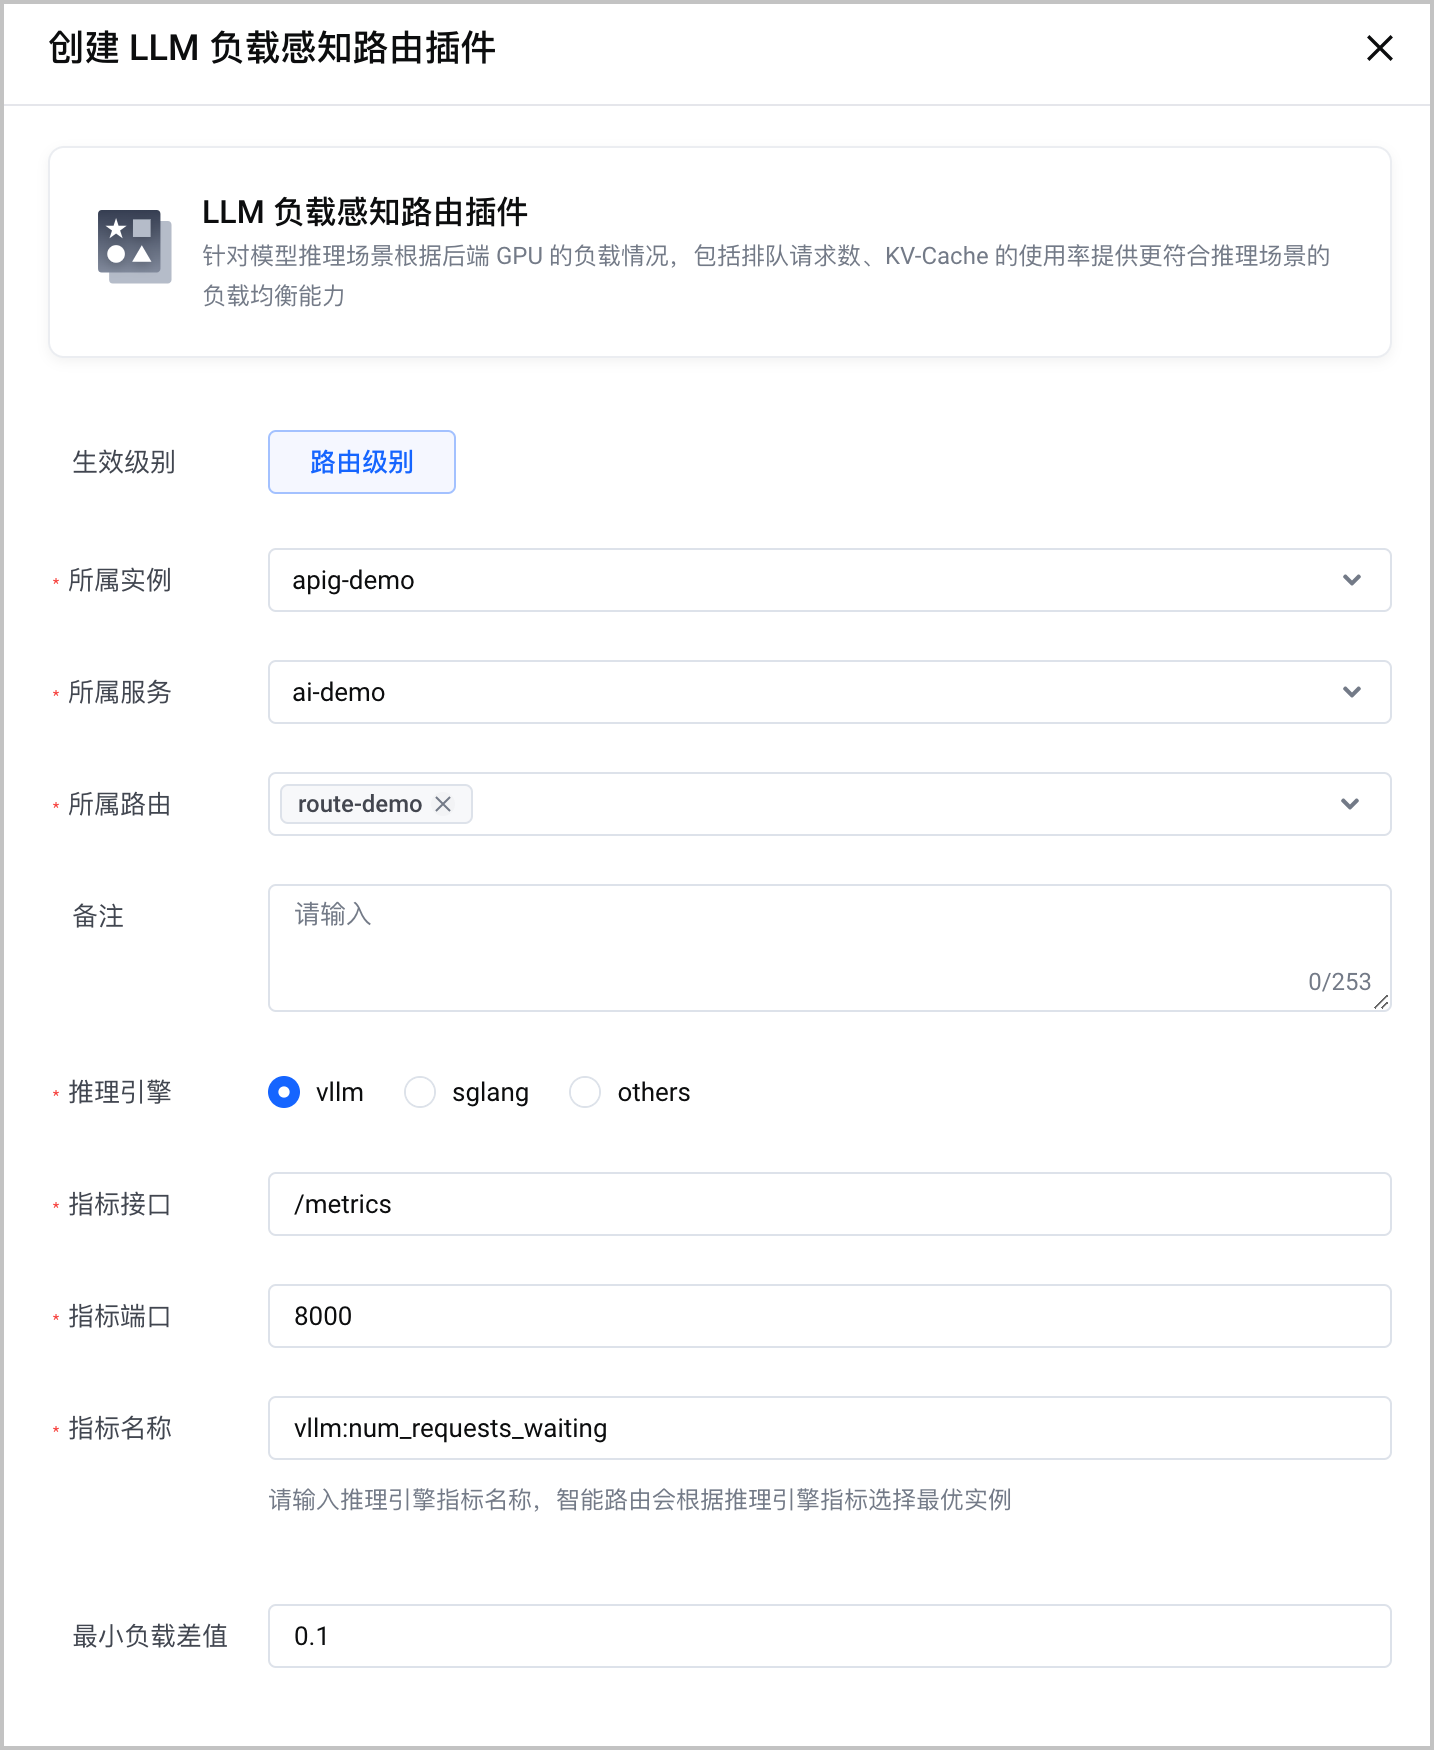
- 配置项说明生效级别选择 LLM 负载感知路由插件的生效级别,当前仅支持 路由级别。所属实例在下拉菜单中选择插件所属 APIG 网关实例。所属服务在下拉菜单中选择插件所属服务。所属路由在下拉菜单中选择插件所属路由。备注您可以根据业务需要选择是否编辑备注内容,例如插件用途等,便于后期识别。推理引擎选择 LLM 使用的推理引擎,包括 vllm、sglang 和 others。
- 指标接口:配置推理引擎指标暴露的 URI 路径,例如/metrics。
- 指标端口:配置推理引擎指标暴露的端口号,例如8000。
- 指标名称:配置进行负载感知的指标,API 网关会基于该指标选择最优的后端实例。例如vllm:num_requests_waiting。
最小负载差值设置触发负载优先调度的最小阈值,即负载最低的后端节点与其他节点的负载指标差值。取值范围:≥ 0。- 差值 ≥ 阈值:请求将优先路由至负载最低的节点。
- 差值 < 阈值:按轮询策略分配,避免因负载波动导致频繁切换。
- 单击 确定,完成配置。
查看配置
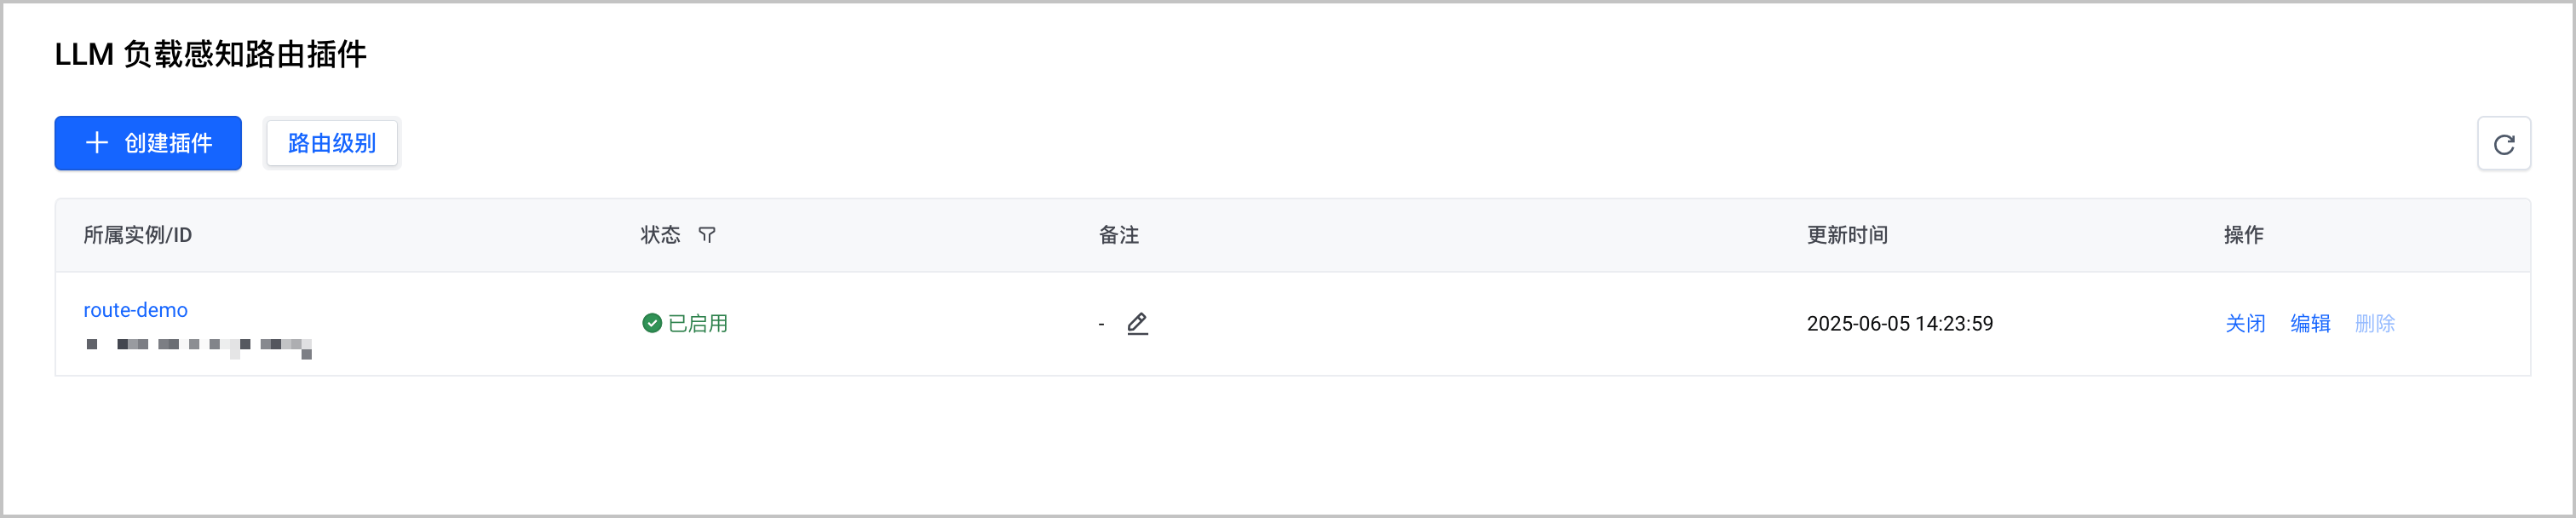
配置完成后,在插件列表中,查看已配置的插件,若插件状态为 已启用,表示插件已生效。
最近更新时间:2026.08.10 17:59:43
这个页面对您有帮助吗?
有用
有用
无用
无用