图像生成大模型
图像生成大模型


文档指南

请输入


- 文档首页
 图像生成大模型图像生成大模型实时互动数字人大模型实时互动数字人SDK实时互动数字人SDK-产品介绍
 复制全文
 下载 pdf
实时互动数字人SDK-产品介绍
 文档反馈
 问问助手
1. 产品介绍
1.1 产品名称
实时互动数字人 SDK
1.2 产品介绍
实时互动数字人 SDK 基于 Flowact-R1 模型、豆包端到端实时语音大模型,面向陪聊、客服、教学等实时互动场景设计。产品可与用户自然互动,输出响应式实时视频流,实现低延迟、高灵活性的数字人对话。
与 OmniHuman1.5 等 "图 + 音频→离线视频" 的生成式数字人不同,实时互动数字人采用 流式生成范式:客户端通过 WebSocket / RTC 持续推送音频,服务端返回声画同步的视频帧,支持 480P@25fps 实时输出。结合端到端实时语音能力,实现了 "看得见、听得懂、能对话" 的数字人 Agent,广泛应用于陪伴聊天、在线客服、教学互动、企业培训等场景。
1.3 产品优势
- 流式低延迟生成:基于流式视频生成架构,端到端首帧响应约2秒左右(不含语音对话模块),声画毫秒级同步。
- 极低形象创建成本:仅需一张人物图即可生成对应的数字人形象,无需录制真人视频,无需形象训练。
- 动作可控:可根据用户对话,实时自动生成符合对话场景的数字人动作,无需额外输入动作指令。
- 可快速集成:SDK集成了 Flowact-R1 模型、豆包端到端实时语音大模型、RTC等技术,也快速集成至业务APP中。
注意:模型生成具有一定随机性,部分动作可能无法响应;视频时长过长后存在一定概率画面崩坏,建议结合业务场景设置会话长度策略。
1.5 使用建议
- 数字人形象图:建议使用清晰、正面的半身高质量真人图片,避免极端角度或人脸占比过小。
- 对话音频:支持用户使用中英文与数字人SDK自然对话,暂不支持其他语种。
- 动作提示:使用简单清晰的动作要求,对话过程中遵循 "清晰、不矛盾、少否定" 原则。
- 会话时长:单次连续会话建议结合业务设置心跳与最大时长,长时间会话建议分段或在场景空闲处重连。
2. 入参与出参说明
3. 服务开通与计费规则
3.1 服务开通
- 您需要使用火山账号登录控制台,在数字人页面 开通「实时互动数字人SDK」能力;
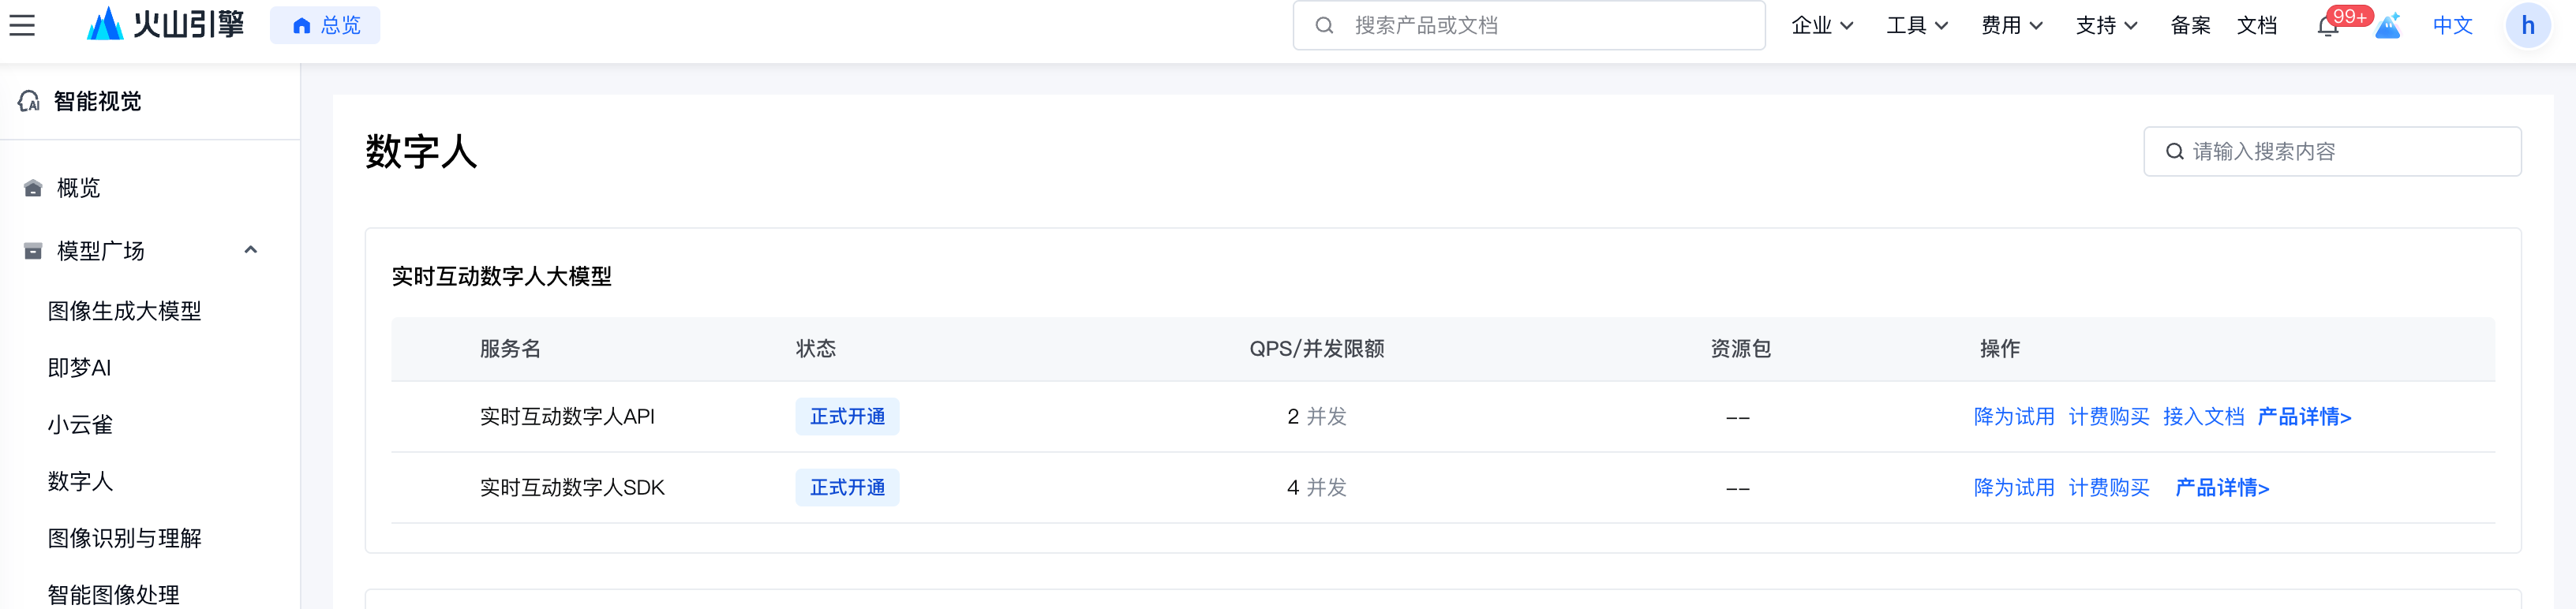
- 服务开通后,您可以选择参考对应的SDK接口文档进行接入。
平台/语言 | 接入文档 |
Web | |
iOS | |
Android |
3.2 计费规则
使用服务前需先购买并发,费用如下,服务高峰期可能会遇到排队
步骤 | 单价 | 备注 |
1并发包月 | 42000元 | 购买前请联系商务确认资源 |
1并发包年 | 420000元 | 购买前请联系商务确认资源 |
3.3 欠费关停策略
- 账户可用余额不足或账户可用余额小于0被扣为负值,即为欠费。
- 账户欠费起2个小时内可正常使用服务。
- 自账户欠费起24个小时仍未能补缴所有欠费账单,视为主动放弃服务,资源将被释放且无法恢复。
最近更新时间:2026.07.31 14:24:13
这个页面对您有帮助吗?
有用
有用
无用
无用