全站加速
全站加速


- 文档首页
 全站加速AI 加速网关控制台操作指南 创建 AI 加速网关实例
 复制全文
 下载 pdf
 文档反馈
 问问助手
AI 加速网关实例是统一管理和加速大模型 API 调用的入口。本文介绍如何在全站加速(DCDN)控制台创建 AI 加速网关实例。
背景信息
创建 AI 加速网关实例时需要配置您的后端模型。实例创建成功后,您可以通过 OpenAI 兼容协议 或 协议透传 两种方式调用后端模型,二者在协议转换与支持的网关能力上存在差异。详情请参见调用方式说明。
一个加速网关实例(对应一个 BaseUrl —— 含加速域名)可同时关联多种调用类型 / 用途(如文本生成、图像生成、语音合成等)的模型,网关会根据请求路径自动路由到对应类型的模型,无需为不同模型类型创建多个实例。
使用限制
- 网关实例支持关联的模型包括火山方舟模型、第三方模型服务商模型(国内、海外)、自部署模型。具体模型来源请参见 功能特性。
说明
- 火山方舟模型、第三方模型服务商模型支持以 OpenAI 兼容协议和协议透传方式调用。
- 自部署模型仅支持以 OpenAI 兼容协议方式调用。
- 每个实例最多允许关联 50 个模型。
前提条件
创建实例前,请确保:
- 已开通全站加速服务。
- 已准备好要接入的模型。
准备模型配置所需信息:- 火山方舟模型:在 火山方舟控制台 创建 API Key,并获取模型的推理接入点(Endpoint)。
- 第三方模型服务商模型(国内、海外):获取对应平台的 API Key。详情请参见从模型提供商平台获取模型调用密钥。
- 自部署模型:准备服务的 API Key 和地址(BaseUrl)。
注意
自部署文本生成模型必须兼容 OpenAI Chat Completions API 格式;自部署语音识别和语音合成模型必须满足 AI 加速网关的协议规范。更多信息,请参见自部署模型接入 AI 加速网关接口协议规范。
操作步骤
登录 全站加速控制台。
在左侧导航栏,选择 AI 加速网关 > 实例管理。
单击 新增实例。
在 创建实例 页面完成以下配置。参数详情请参见 配置说明。
- 基本信息:填写实例名称并选择类型。
- 模型配置:选择路由策略,添加并配置至少一个模型。
- 高级配置:设置加速区域、缓存、限流、预算管理和工具精选策略。
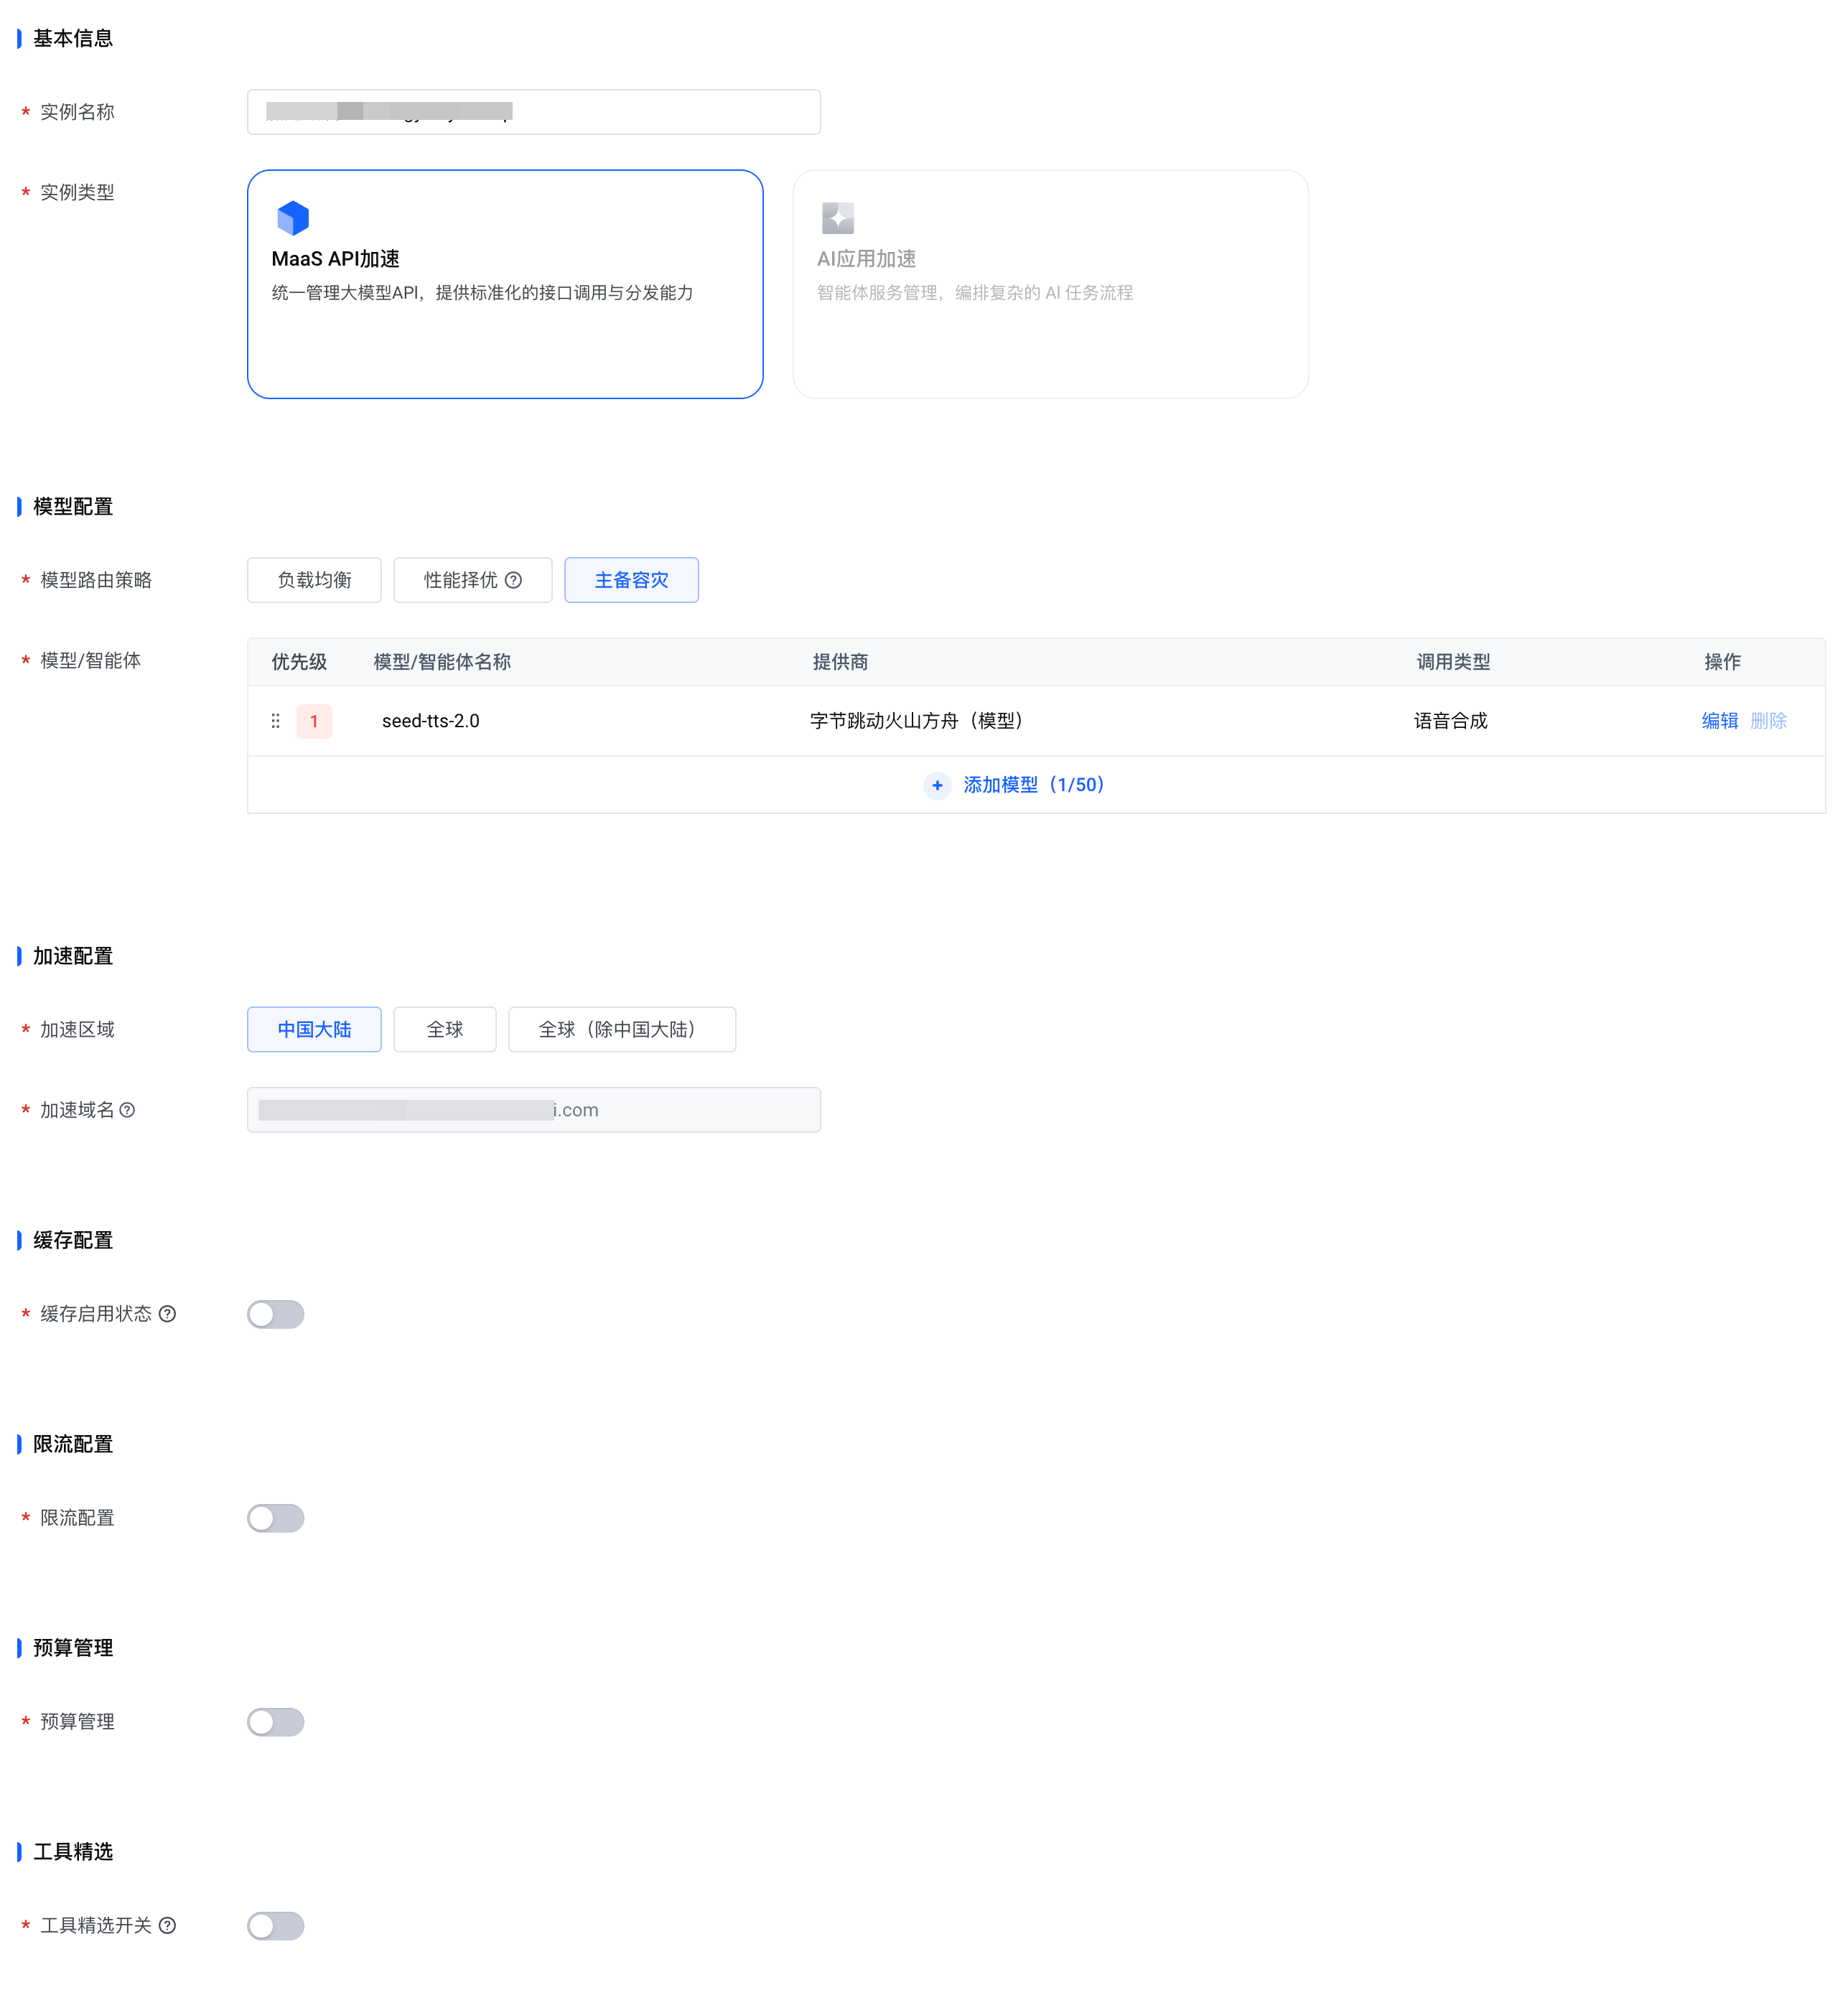
单击 确认。
创建成功后,页面自动返回 实例管理 列表。
下一步:实例创建后,您即可通过网关访问密钥调用已接入的后端模型。获取网关访问密钥并发起模型调用,请参见通过 AI 加速网关调用大模型;查看、编辑和删除已创建的实例,请参见查看和管理实例。
您还可以进一步为实例配置以下高级能力:
- 配置多模型路由:通过负载均衡、主备容灾或性能择优策略在多个模型间分发请求。
- 配置预算管理控制调用成本:为实例或模型设置用量限额,超限后按路由策略切换模型。
- 配置缓存与限流:开启语义缓存降低重复调用成本,设置限流保护后端服务。
- 使用工具精选提升 Function Calling 效率:在请求转发前智能筛选工具,提升响应速度并降低 Token 开销。
配置说明
实例创建页面的配置项说明如下。
配置分组 | 配置项 | 说明 |
|---|---|---|
基本信息 | 实例名称 | 实例的标识名称。 |
实例类型 | 指定实例用途。目前仅支持 MaaS API 加速,用于统一管理和加速大模型 API 调用。 | |
模型配置 | 模型路由策略 | 请求分发规则。可选项:
说明
|
模型/智能体 | 单击 添加模型 接入后端模型。具体配置项因模型类型而异,请参见下方各模型类型的配置说明。最多支持添加 50 个。 | |
加速配置 | 加速区域 | 选择您的用户主要所在的地理区域,以便网关能够就近接入,优化网络延迟。可选项:中国大陆、全球、全球(除中国大陆)。 |
精品公网 | (仅当加速区域为中国大陆且实例配置了第三方模型服务商(海外)模型时出现)开启后,将通过精品公网通道加速第三方模型服务商(海外)模型(Anthropic、OpenAI、Google)的访问,降低跨境网络延迟,提升访问稳定性。精品公网将产生额外费用,详情请参见 AI 加速网关计费说明。 | |
加速域名 | 设置实例的公开访问地址。加速域名是客户端调用的
| |
HTTPS 配置 | (仅自定义加速域名时可见)开启后,网关使用 HTTPS 提供安全的加速服务。开启 HTTPS 时需选择证书。 | |
证书来源 | (仅开启 HTTPS 时)证书的来源方式。可选项: | |
服务授权 | (仅开启 HTTPS 时)AI 加速网关需要通过跨服务访问授权获取读写火山引擎证书中心的权限,以管理用于 HTTPS 的证书。授权状态显示为 已授权 表示授权已完成。如未授权,请按页面提示完成授权。 | |
证书名称(新上传证书) | (仅证书来源为新上传证书时)新上传证书的自定义名称,用于在证书中心中标识该证书。 | |
证书内容(新上传证书) | (仅证书来源为新上传证书时)PEM 格式的证书内容,需以 | |
私钥内容(新上传证书) | (仅证书来源为新上传证书时)PEM 格式的私钥内容。支持 RSA 和 ECC 等密钥算法:
请确保上传的私钥与证书匹配。 | |
选择证书(已有托管证书) | (仅证书来源为已有托管证书时)从下拉列表中选择已托管在火山引擎证书中心的证书。 | |
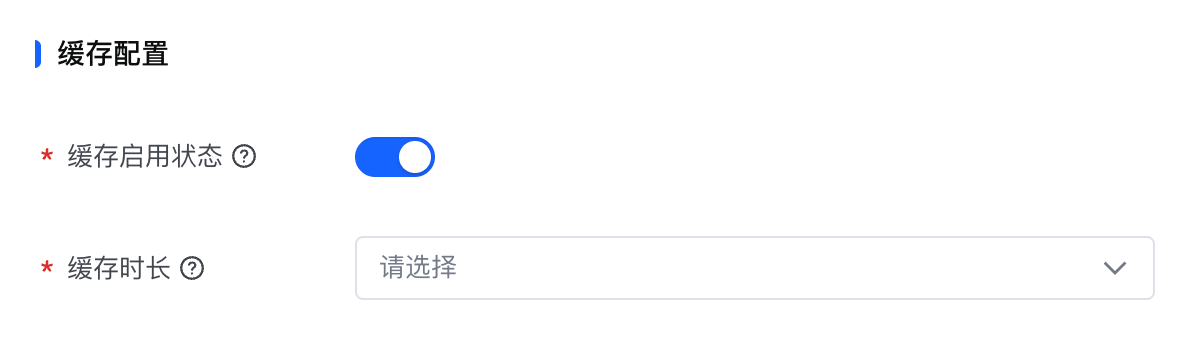
缓存配置 | 缓存启用状态 | 开启后,网关会缓存模型的成功响应。当后续收到相似的请求时,将直接从缓存中返回结果,提升性能并降低成本。 |
缓存时长 | (仅开启缓存时)缓存的有效时间。超过此时长,缓存将被视为过期并自动清除。可选项:1 分钟、5 分钟、30 分钟、1 小时、1 天、1 周。 | |
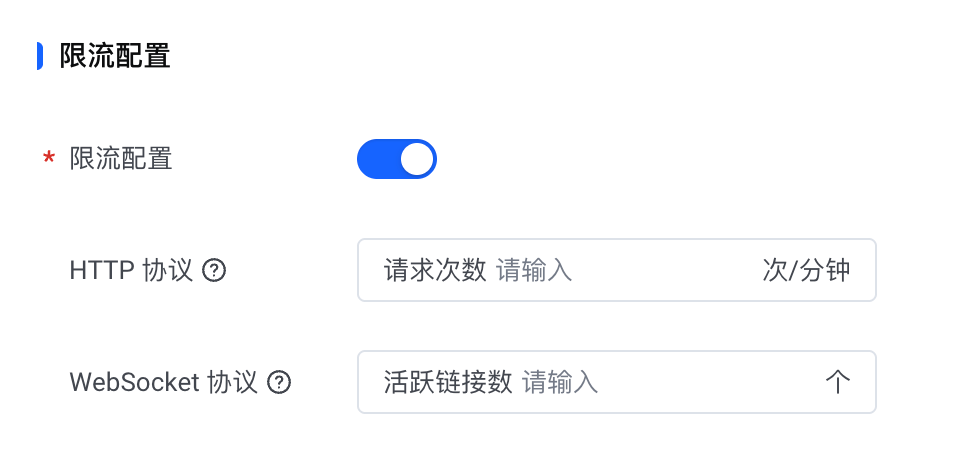
限流配置 | 限流配置 | 开启后,可设置请求速率限制,保护后端服务免受流量冲击。 |
HTTP 协议 | (仅开启限流时)限制每分钟的请求数(RPM)。 | |
WebSocket 协议 | (仅开启限流时)限制并发连接数。 | |
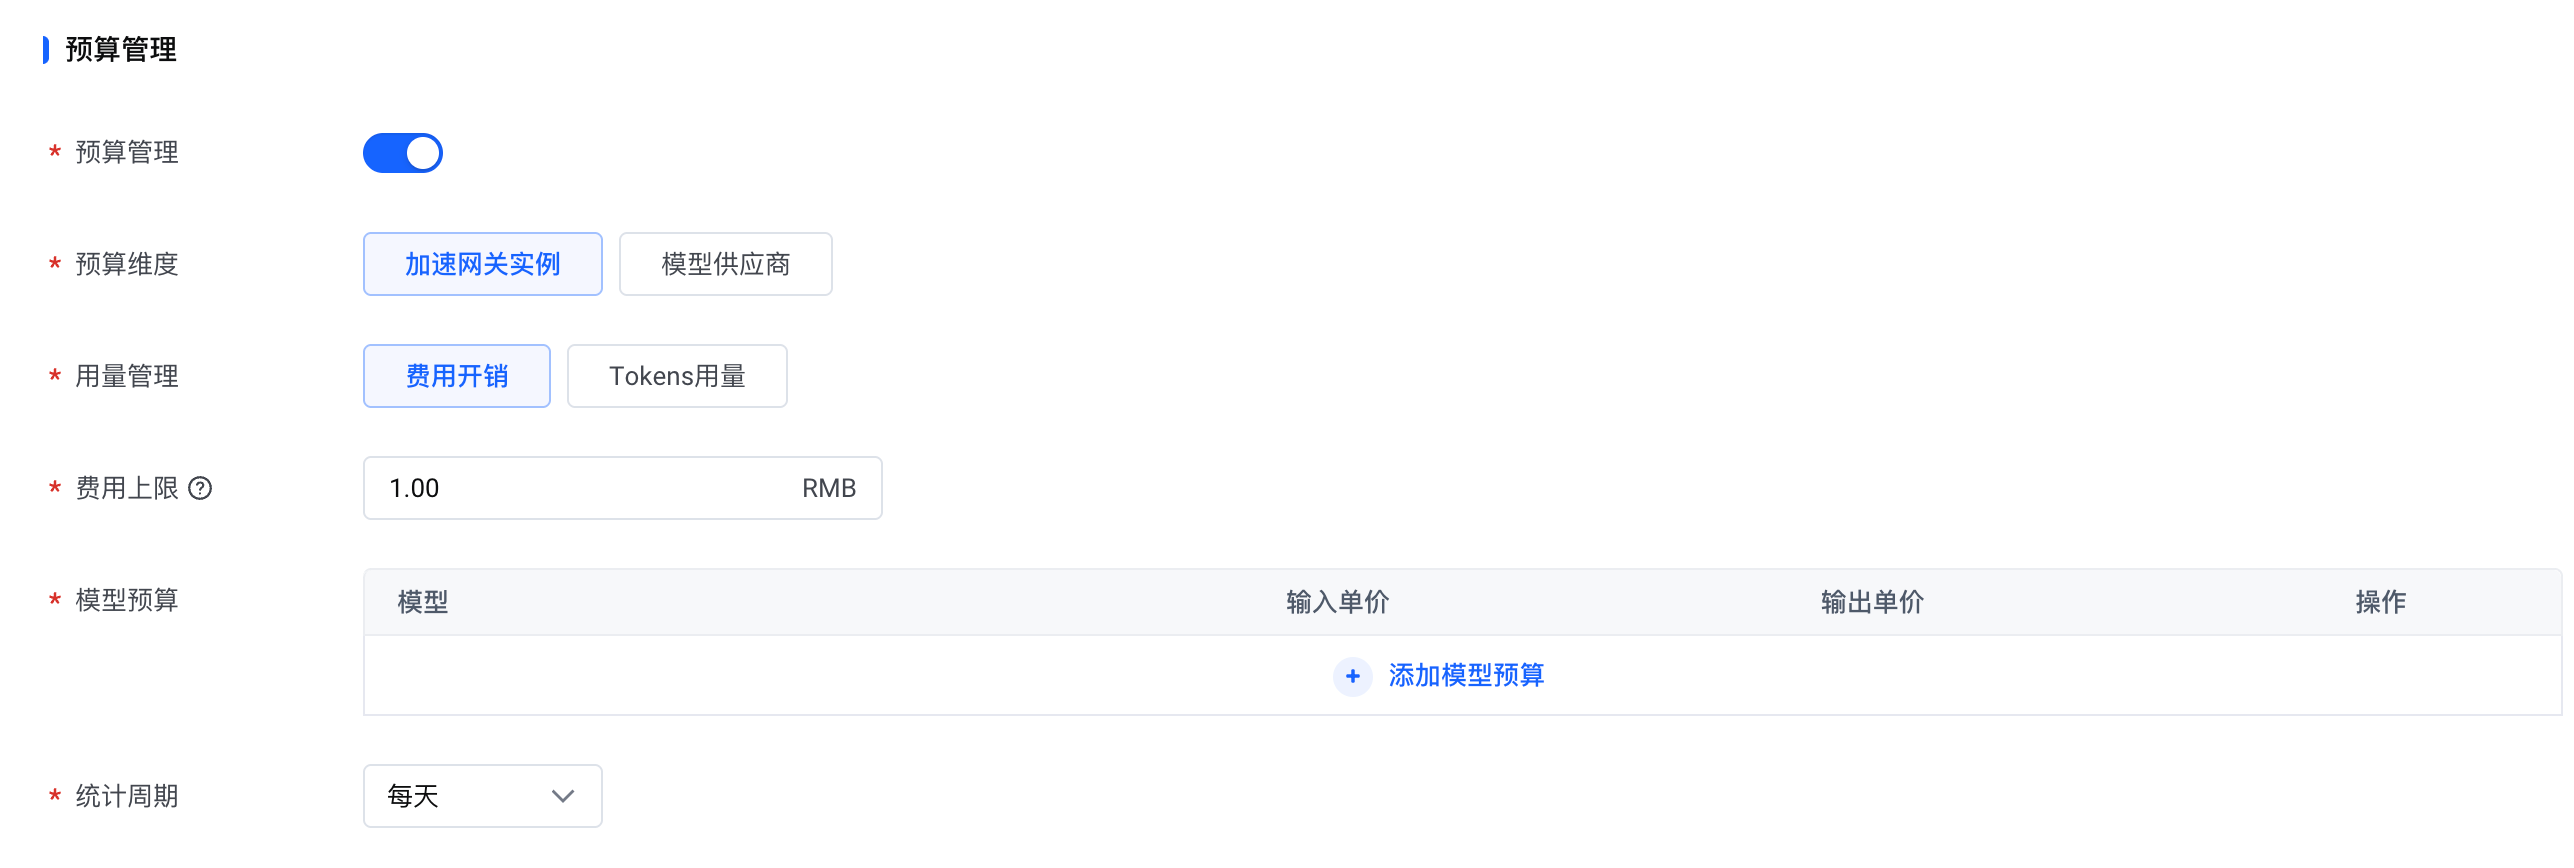
预算管理配置 | 预算管理 | 开启后,可为网关实例或模型供应商设置用量限额。当用量达到限额后,网关将按 模型路由策略 把请求重新分发到同一调用类型的其他模型,从而控制成本。 |
预算维度 | 限额的统计口径。可选项:
| |
用量管理 | 限额的计量方式。可选项:
| |
费用上限 | (仅 预算维度 为 加速网关实例 且 用量管理 为 费用开销 时)实例的费用总上限,单位为 RMB,最小值为 1。 | |
Tokens 用量上限 | (仅 预算维度 为 加速网关实例 且 用量管理 为 Tokens 用量 时)实例的 Tokens 用量总上限,单位为 Tokens,最小值为 100。 | |
模型预算 | 为单个模型设置预算。模型下拉项与实例已配置的模型联动,支持 添加模型预算 和 删除。表格列因 预算维度 和 用量管理 的组合而异:
说明 输入单价、输出单价为您填写的协商价或估算价,仅用于预算费用的测算口径,与 AI 加速网关的实际计费无关。 | |
统计周期 | 预算用量的统计与重置周期。可选项:每小时、每天、每周、每月。 | |
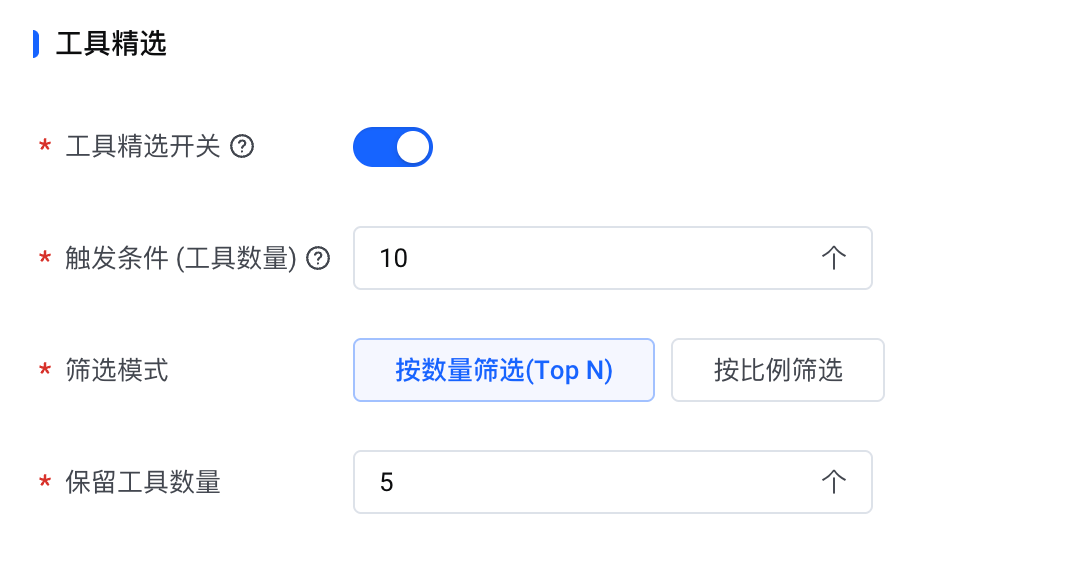
工具精选配置 | 工具精选开关 | 开启后,网关在请求 LLM 前会先对请求携带的工具(tools)列表做智能筛选,仅将与当前任务最相关的工具透传给模型,从而提升模型响应速度与准确率,并降低 Token 调用成本。默认关闭。 |
触发条件(工具数量) | (仅开启工具精选时)触发精选的工具数量下限。当单次请求携带的工具数达到该阈值时才执行精选,避免对小工具集做不必要的处理。默认值为 10 个。 | |
筛选模式 | (仅开启工具精选时)保留工具的计算方式。可选项:
| |
保留工具数量 | (仅 筛选模式 为 按数量筛选(Top N) 时)保留的工具个数,默认值为 5 个。该值不能超过 触发条件 中设置的工具数量。 | |
保留工具比例 | (仅 筛选模式 为 按比例筛选 时)保留工具占请求携带工具总数的百分比,默认值为 10%。 |
火山方舟模型配置项
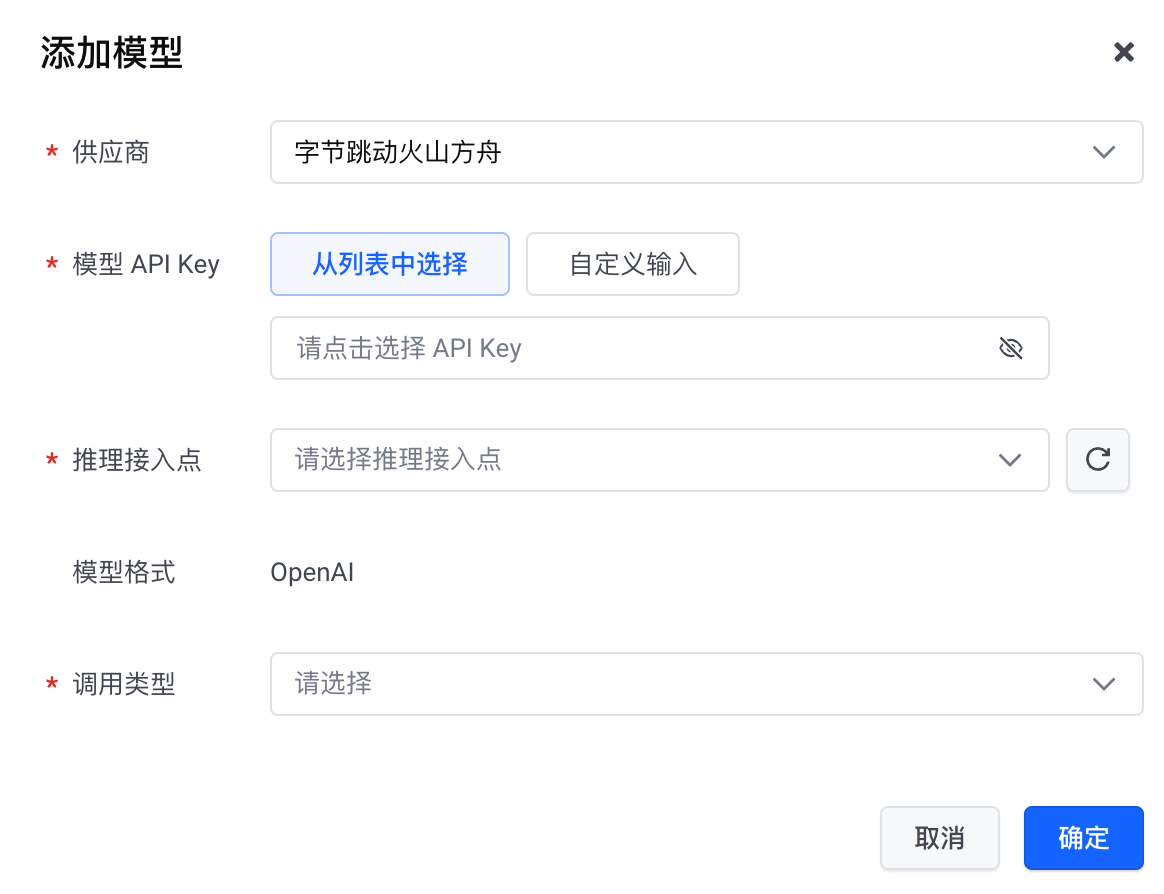
配置项 | 说明 |
|---|---|
供应商 | 选择 字节跳动火山方舟。 |
配置类型 | 火山方舟的接入配置类型。可选项:
|
模型 API Key | 火山方舟模型的访问凭证,必填。推荐选择 从列表中选择,自动加载已创建的 API Key;也支持 自定义输入。 |
推理接入点 | (仅配置类型为 模型 时)模型在火山方舟的推理端点地址。支持 预置推理接入点(可搜索模型名称)和 自定义推理接入点 两类来源,可在下拉菜单中切换选择。 |
模型格式 | (仅配置类型为 模型 时)模型通信协议,取值固定为 OpenAI,为系统只读展示项。 说明 此为 OpenAI 兼容协议模式下的通信协议限制。使用协议透传时,网关原样转发厂商协议。 |
调用类型 | (仅配置类型为 模型 时)模型服务场景。可选项:文本生成、图像生成、语音识别、向量模型、语音合成、视频生成。 |
第三方模型服务商配置项
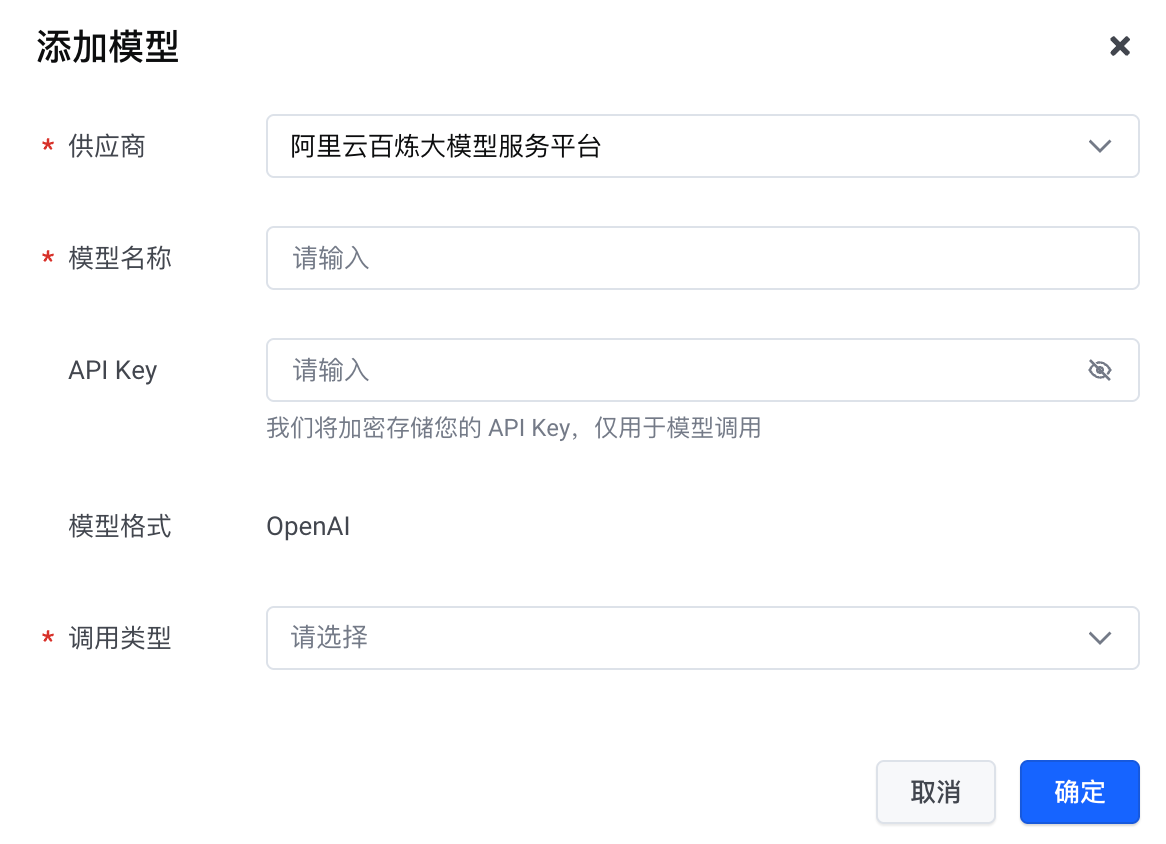
配置项 | 说明 |
|---|---|
供应商 | 选择您的模型服务提供商。支持的第三方模型服务商包括:
|
| 模型名称 | 在网关中显示的自定义名称。 |
API Key | 模型服务商平台提供的 API Key。 说明 如果不传入,该模型仅支持通过协议透传方式调用(协议透传方式仅支持请求加速能力,不支持其他能力)。 |
模型格式 | 模型通信协议,目前仅支持 OpenAI。 说明 此为 OpenAI 兼容协议模式下的通信协议限制。使用协议透传时,网关原样转发厂商协议。 |
调用类型 | 模型服务场景,目前仅支持 文本生成。 |
自部署模型配置项
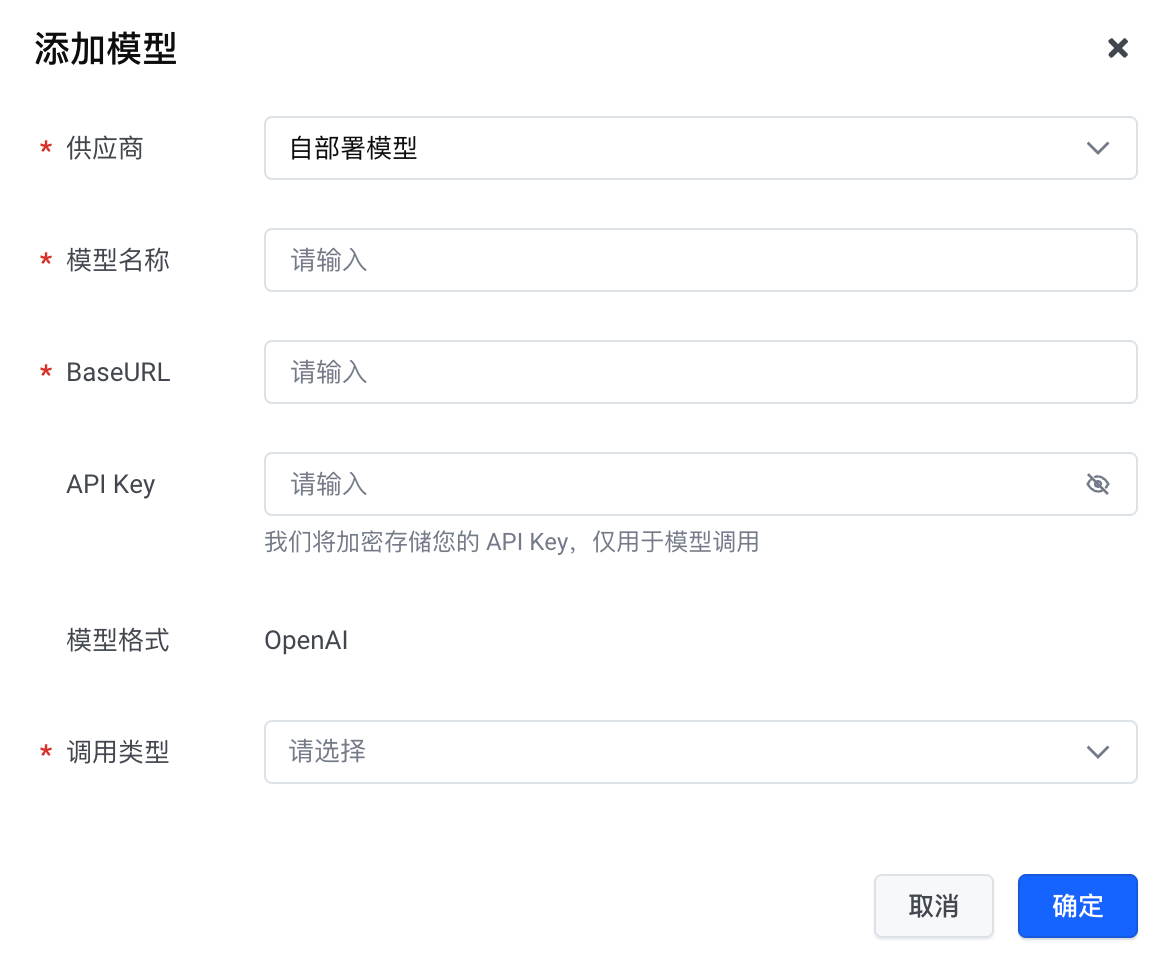
配置项 | 说明 |
|---|---|
供应商 | 选择 自部署模型。 |
| 模型名称 | 在网关中显示的自定义名称。 |
BaseURL | 自部署模型的服务地址。 |
API Key | 自部署模型的 API Key。 注意 自部署模型仅支持通过 OpenAI 兼容协议方式调用。您必须提供 API Key,否则无法调用。 |
模型格式 | 模型通信协议,目前仅支持 OpenAI。 |
调用类型 | 模型服务场景。可选项:文本生成、语音合成、语音识别。对于语音合成和语音识别模型,网关支持透传以下额外配置。 |
协议类型 | (仅语音合成)模型通信协议。可选项:HTTP、WebSocket。 |
采样率 | (仅语音合成)音频采样率(Hz),需输入正整数,支持添加多个值,最多 10 个。 |
位深 | (仅语音合成)音频位深度,支持多选,目前仅支持 16bit。 |
通道数 | (仅语音合成)音频通道数,支持多选。可选项:1(单声道)、2(立体声)。 |
集成方式 | (仅 HTTP 语音合成)网关处理用户请求的方式:
|
结果输出方式 | (仅语音识别)识别结果返回方式:
|
是否支持 VAD | (仅语音识别)模型是否支持语音活动检测(Voice Activity Detection)。开启后需配置以下参数。 |
默认前缀时长 | (仅开启 VAD 时)语音起始前保留的音频时长,单位为毫秒(ms),需输入不小于 1 的整数。 |
默认静音时长 | (仅开启 VAD 时)判定语音结束所需的静音时长,单位为毫秒(ms),需输入不小于 1 的整数。 |
默认激活阈值 | (仅开启 VAD 时)语音活动检测的激活灵敏度阈值,取值范围为 0 到 1。 |