You need to enable JavaScript to run this app.
文档中心
托管 Prometheus

托管 Prometheus

复制全文
下载 pdf
常见问题
无法正确查看到预期的指标?
复制全文
下载 pdf
无法正确查看到预期的指标?
托管 Prometheus 支持监控容器服务等云服务,也支持通过 ServiceMonitor、PodMonitor、Service/Pod annotation 进行服务发现。但是,有时候当您完成配置后,却无法正确检索到预期指标。本文为您介绍如何进行此类故障的排除。​
故障现象​
使用托管 Prometheus 进行容器服务集群监控时,开启资源监控或配置 ServiceMonitor 或 PodMonitor 后,并未采集到期望的指标数据。​
原因分析​
造成您无法查看到期望指标的可能原因有:​
  1. 查询语句错误,导致无法查询出正确的结果。​
  1. 确认 Target 被发现且正常采集。​
  • 服务发现配置错误,导致 Target 未被正确发现。​
  • 业务 Pod 自身和采集端点异常。​
  1. 查询的指标有误。​
整体排障流程如下图所示。其中,Target、Exporter 端口均为示例。​
​Image​​
排障步骤​
步骤一:确认指标查询和写入​
确认指标是否存在​
  1. 登录 VMP 服务控制台。​
  1. 在顶部导航栏,选择目标地域。​
  1. 单击左侧导航栏的 Explore,进入 Explore 页面。​
  1. 在右上角的配置项中,配置需要查询指标的 工作区,并在 指标检索 文本框内,输入对应的指标名称,确认指标是否已经被采集和存储。​
  • ​Image​​
确认指标查询语句​
查询指标时,请首先确认您使用的查询语句正确。错误的查询语句会导致查询出的指标错误,或者干脆查询不出任何结果。​
如果查询语句有问题,请及时修改。查询语句的使用方法,请参见 PromQL 基本用法。​
检查写入指标​
  1. 登录 VMP 服务控制台。​
  1. 单击左侧导航栏的 工作区,在工作区列表中选择需要查看监控数据的 的工作区,单击 工作区名称,进入工作区配置界面。​
  1. 在左侧导航栏中单击 监控。​
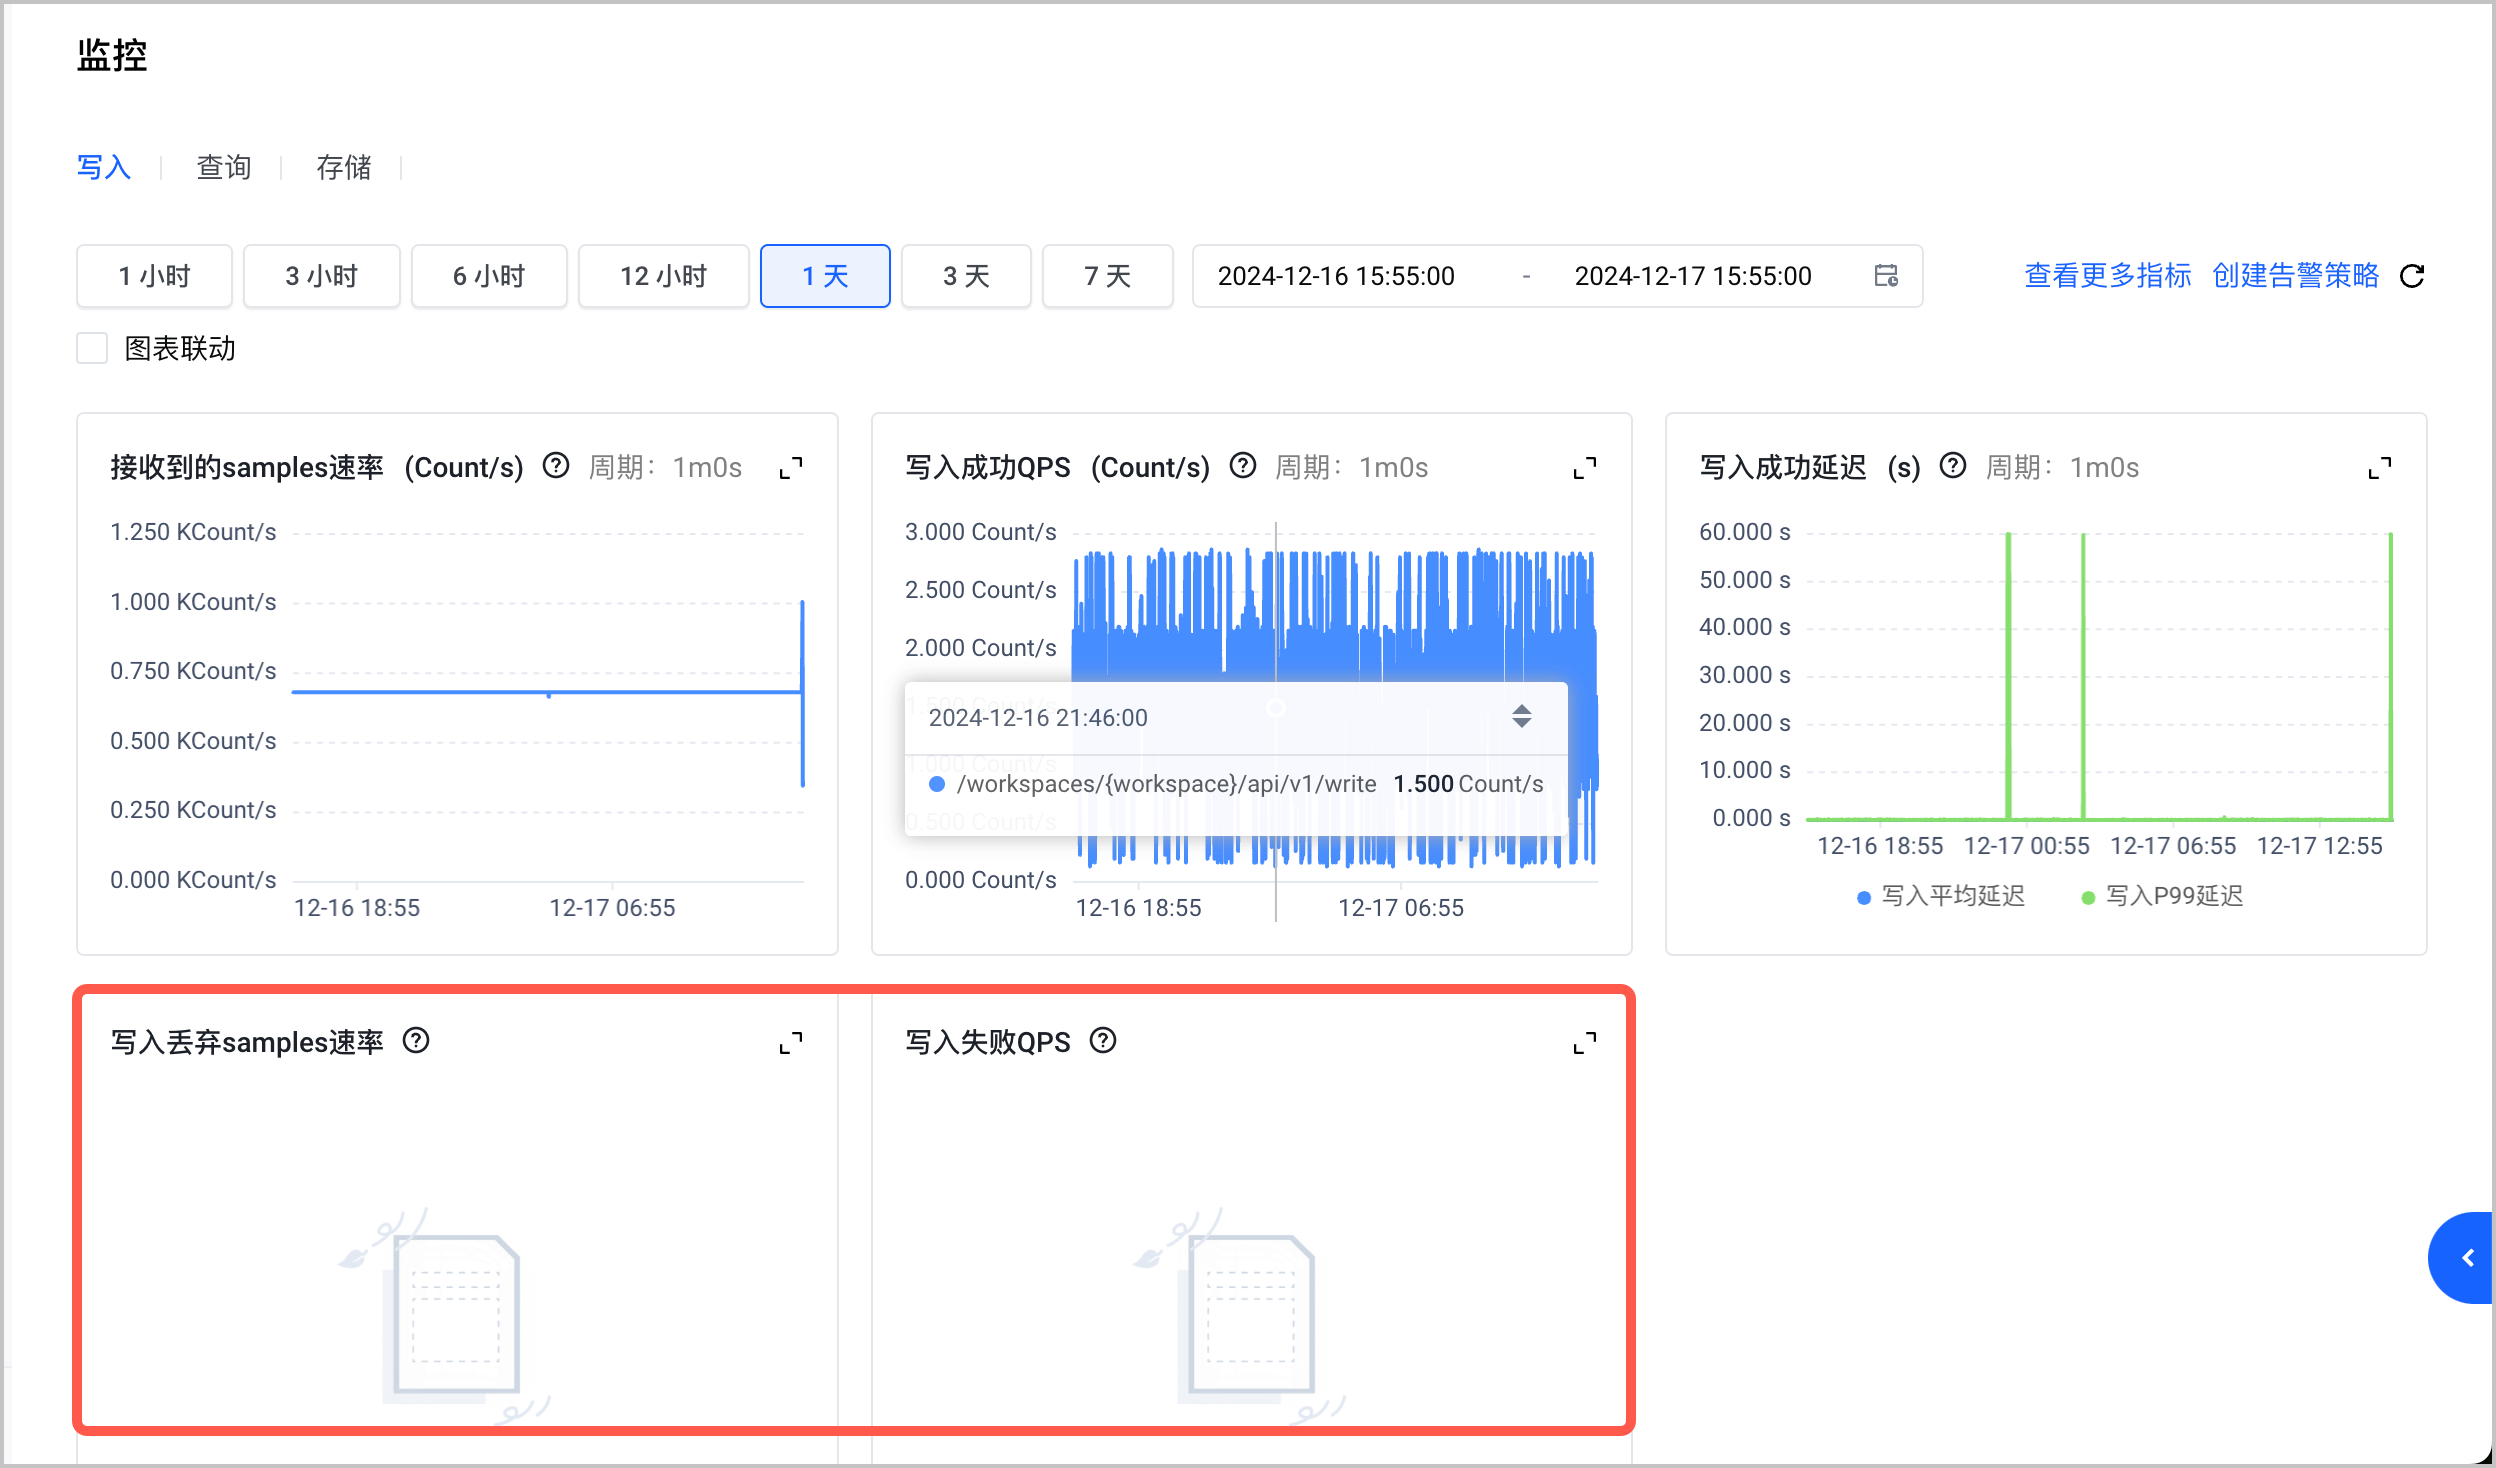
  1. 在监控页面,检查工作区的自监控,查看是否有被限流或者丢点的流量。​
​Image​​
步骤二:确认 Target 被发现且正常采集​
您可以采用如下步骤,确定采集器是否正确发现 Target 且正常采集:​
(推荐)方式一:通过 prometheus-agent dashboard 确认 Target 状态​
prometheus-agent 提供了一个使用便捷的排障页面,大部分场景下都可以依赖该页面排查出问题。​
  1. 访问 prometheus-agent dashboard。​
  • 通过本地浏览器访问​
  1. 通过 port-forward 方式本地访问 prometheus-agent 的端口。​
  • ​
    # 本地执行​
    kubectl -nkube-system port-forward svc/vmagent-prometheus-agent 8429:8429​
    ​
说明​
  • 需要确保本地可以通过 kubeconfig 公网访问。如果有其他类似隧道的方式,也可以打通本地到 K8s prometheus-agent 网络。​
  • 默认监听本地 localhost 端口,如果需要全网卡,请在命令行中添加 --address 0.0.0.0。​
  • kubectl -nkube-system port-forward svc/vmagent-prometheus-agent 8429:8429 --address 0.0.0.0​
  1. 本地访问 localhost:8429。​
  • 您需要关注 targets 和 service-discovery 这两个模块。首页如下所示。​
  • ​Image​​
  • 无法本地访问的替代方式​
  • 某些场景下无法本地访问 dashboard,比如临时排查问题申请了线上用户的 kubectl 读权限后,虽然可以执行 kubectl port-forward,但是无法通过本地浏览器访问 dashboard,只能通过手动 curl prometheus-agent API 查看返回的 JSON 内容。​
  • ​
    curl 命令​
    说明​
    curl localhost:8429/targets​
    查询 target 抓取状态,会返回类似如下的打印信息。您可以通过 grep 的方式过滤具体的 job。对应 dashboard 的 target 列表。​
    ​
    job=nodeScrape/kube-system/kubelet-cadvisor/1 (3/3 up)​
    state=up, endpoint=https://192.168.XX.XX:10250/metrics/cadvisor, labels={ecs="i-ydh********9xk",instance="192.168.XX.XX",job="kubelet-cadvisor",machine="ncsd********ibkg",machinepool="pcsd********if30",node="192.168.XX.XX"}, scrapes_total=85661, scrapes_failed=5, last_scrape=6229ms ago, scrape_duration=41ms, samples_scraped=1603, error=​
    state=up, endpoint=https://192.168.XX.XX:10250/metrics/cadvisor, labels={ecs="i-ydh********rfb",instance="192.168.XX.XX",job="kubelet-cadvisor",machine="ncsc********h3j0",machinepool="pcsc********h3ig",node="192.168.XX.XX"}, scrapes_total=85661, scrapes_failed=1, last_scrape=3407ms ago, scrape_duration=47ms, samples_scraped=1483, error=​
    state=up, endpoint=https://192.168.XX.XX:10250/metrics/cadvisor, labels={ecs="i-ydg********0p6",instance="192.168.XX.XX",job="kubelet-cadvisor",machine="ncs3********islg",machinepool="pcs3********ssv0",node="192.168.XX.XX"}, scrapes_total=85660, scrapes_failed=3, last_scrape=14092ms ago, scrape_duration=92ms, samples_scraped=4593, error=​
    ​
    在命令 curl -H 'accept:text/html' 'http://localhost:8429/targets' 中加上 accept header,可以返回 html 的格式。​
    curl localhost:8429/api/v1/targets​
    查询较为详细的 JSON 形式的 target 信息,分为 activeTargets 和 droppedTargets,每个 targets 里包括 meta labels。​
    ​
    {​
    "status": "success",​
    "data": {​
    "activeTargets": [​
    ​
    ],​
    "droppedTargets": [​
    ​
    ]​
    }​
    }​
    ​
    具体返回示例如下:​
    ​
    "activeTargets": [​
    {​
    "discoveredLabels": {​
    "__address__": "192.168.XX.XX:10250",​
    "__meta_kubernetes_node_address_Hostname": "192.168.XX.XX",​
    "__meta_kubernetes_node_address_InternalIP": "192.168.XX.XX",​
    ...​
    "__metrics_path__": "/metrics/cadvisor",​
    "__scheme__": "https",​
    "__scrape_interval__": "15s",​
    "__scrape_timeout__": "10s",​
    "instance": "192.168.XX.XX",​
    "job": "nodeScrape/kube-system/kubelet-cadvisor/1"​
    },​
    "labels": {​
    "ecs": "i-ydh9hrtxxcr9cxx9j9xk",​
    "instance": "192.168.XX.XX",​
    "job": "kubelet-cadvisor",​
    "machine": "ncsd********ibkg",​
    "machinepool": "pcsd********if30",​
    "node": "192.168.XX.XX"​
    },​
    "scrapePool": "kubelet-cadvisor",​
    "scrapeUrl": "https://192.168.XX.XX:10250/metrics/cadvisor",​
    "lastError": "",​
    "lastScrape": "2024-12-06T14:20:02.71+08:00",​
    "lastScrapeDuration": 0.054,​
    "lastSamplesScraped": 1603,​
    "health": "up"​
    }​
    ...​
    ]​
    ​
    curl localhost:8429/config​
    查看 prometheus-agent 读取到的原始配置。一般用 servicemonitor 等 CR 配置采集,operator 会自动加上一些 relabel,可以通过这个命令查看到实际被 prometheus-agent 读取到的完整的 scrape 采集配置。​
    ​
  1. 单击 prometheus-agent dashboard 的 targets,检查采集 Target 是否正常。​
  • ​Image​​
  • Taget 的名称来自配置的 job name,但是如果用 CR 的方式来配置,job 的命名格式为:​
  • ​
    采集方式​
    对应格式​
    servicemonitor 采集​
    serviceScrape/<namespace>/<servicemonitor-name>/n​
    podmonitor 采集​
    podScrape/<namespace>/<servicemonitor-name>/n​
    vmnodescrape 采集​
    nodeScrape/<namespace>/<servicemonitor-name>/n​
    通过 pod 的 annotation 采集​
    pod​
    ​
方式二:通过控制台确认 Target 状态​
注意​
通过 prometheus-agent dashboard 可以查看对应的服务是否被正确发现,控制台无法查看。​
  1. 登录 VMP 服务控制台。​
  1. 在顶部导航栏,选择目标地域。​
  1. 单击左侧导航栏的 Explore,进入 Explore 页面。​
  1. 在右上角的配置项中,配置需要查询指标的 工作区,并在 指标检索 文本框内,输入up{job="xxxx"},查看对应的服务是否被正确发现。​
  • ​Image​​
验证结果和解决方案​
​
验证结果​
解决方案​
Target 未被识别​
如果在 dashboard 上未找到对应的 Target 配置,通常是因为自定义的配置里有问题。​
  • 使用 CR 采集​
  • 请检查 ServiceMonitor 或者 PodMonitor 配置是否正确。具体请参见 服务发现。​
  • 注意事项:​
  • ServiceMonitor 或者 PodMonitor 带有火山标识的 label volcengine.vmp: "true",才会被 Prometheus-agent 发现。​
  • ​
    kind: ServiceMonitor​
    metadata:​
    labels:​
    volcengine.vmp: "true"​
    ...​
    ​
  • ServiceMonitor 或者 PodMonitor 默认采集当前 namespace下的 pod。您可以加一个 namespaceSelector 指定 namespace 或者如下述运行采集所有的 namespace。​
  • ​
    namespaceSelector:​
    any: true​
    ​
  • ServiceMonitor 里的 selector 匹配的是 service 本身的 label,与 service spec 里的 selector 无关。​
  • 使用 Pod Annotation 采集​
  • 添加 Pod annotation 的格式参考如下:​
  • ​
    prometheus.io/path: /metrics​
    prometheus.io/port: "8888"​
    prometheus.io/scrape: "true"​
    ​
注意​
  • kube-system 命名空间下的 Pod 默认不会被采集。​
  • 如果 Pod Yaml 里没有定义和 prometheus.io/port 定义一致的 port,则不会被采集。​
  • ​
    ports:​
    - containerPort: 8888​
    name: metrics​
    ​
Target DROPPED​
在 prometheus-agent dashboard 的 discovered targets 里,如果检查到有 Target 被 DROPPED,通常是因为错误使用 relabel 配置导致过滤了该指标。​
​Image​​
  1. 单击右边的 debug 链接进行排查。​
  1. 查看带有原始 meta label 的 original labels 指标。​
  • ​Image​​
  1. 查看每一个 relabel 的 step 前后的结果。​
  • ​Image​​
  • 如果是红色,表示 drop 掉的 label。​
  • 如果是蓝色,表示 add 上的 label。​
  1. 找到非预期的 step,和自定义的 relabel 配置进行对比,检查是否有问题。​
Target UP​
如果 Target 状态是 UP,通常是其他原因导致的。通过以下步骤排障。​
  • 检查 prometheus-agent 日志​
  • 部分指标未暴露​
  • 检查基础指标​
  • 大部分的常见指标,可以在 VKE 控制台 观测配置 查看,是否开启组件将指标 drop。​
  • ​Image​​
​
  • 自定义指标​
  • 检查自定义 serviceMonitor/podMonitor 里的 relabel 配置,是否过滤了该指标。​
Target DOWN​
如果 Target DOWN,请查看 last error 字段,通常可能原因为:​
  • 网络问题:prometheus-agent 到 exporter 端口网络不通导致 connection refused。​
  • 请检查网络问题,可能为安全组配置错误等。​
  • 配置问题:比如 http 写成 https 等,导致请求直接返回 EOF 等。​
  • ​Image​​
​
步骤三:检查采集器状态​
方式一:使用 kubectl 检查采样器状态​
​
# 查看pod是否存在​
kubectl -nkube-system get po |grep vmagent​
# 查看pod事件​
kubectl -nkube-system describe po vmagent-prometheus-agent-0​
# 查看pod日志​
kubectl -nkube-system logs vmagent-prometheus-agent-0 -cvmagent --tail=100​
​
方式二:使用控制台检查采样器状态​
  1. 在左侧菜单栏中选择 集群,并在右侧集群列表中选择采集器所在集群。​
  1. 单击集群名称,进入集群配置页面。​
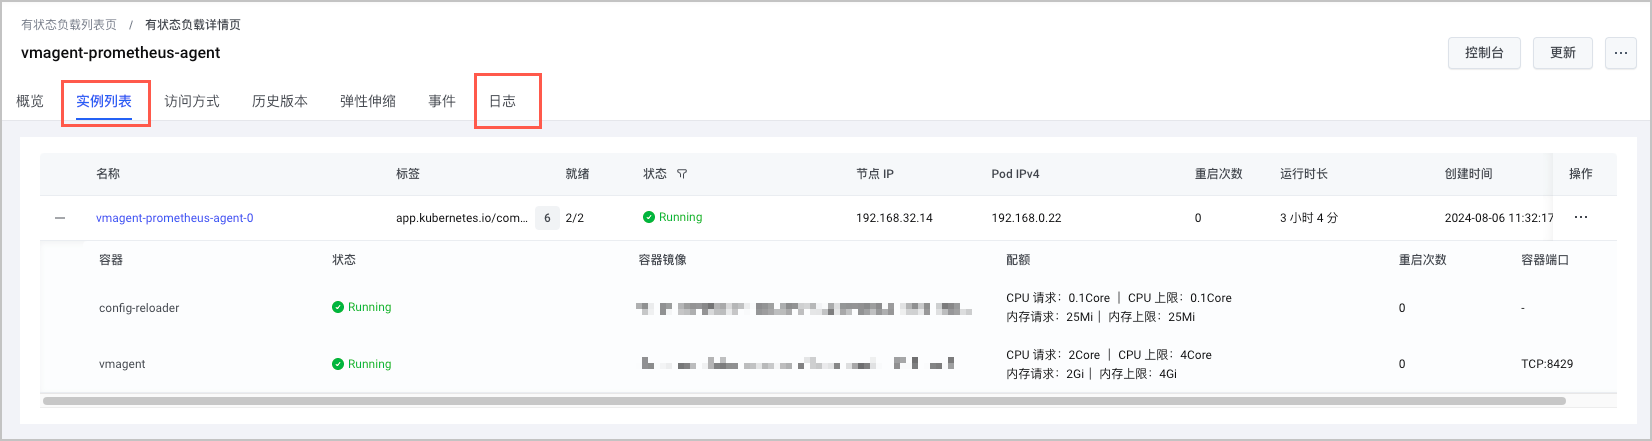
  1. 在左导航栏中选择 工作负载 > 有状态负载,在 kube-system 命名空间下,查看采集器 vmagent-prometheus-agent 的 Pod 状态和日志。​
  • ​Image​​
验证结果和解决方案​
检查 prometheus-agent 状态​
​
可能原因​
解决方案​
状态异常只有初始化 Job​
如果 prometheus-agent 状态异常,仅有一个 pre-install Job。​
可能有 pre-delete Job,因为 vke addon 检测部署超时后会自动卸载。​
请查看 Job 对应 pod 的日志,查看 pod 的状态和事件等。​
  • 部署 VKE 集群时,如果勾选了部署 prometheus-agent,但是部署的时间很长,可能是待部署 agent 的资源没运行,导致 prometheus-agent 组件部署超时(无法调度等),展示状态为异常。​
  • pre-install Job 会调用 VKE 的 OpenAPI 接口获取默认指标列表,请检查 VKE pod 子网的安全组规则。​
没有 prometheus-agent​
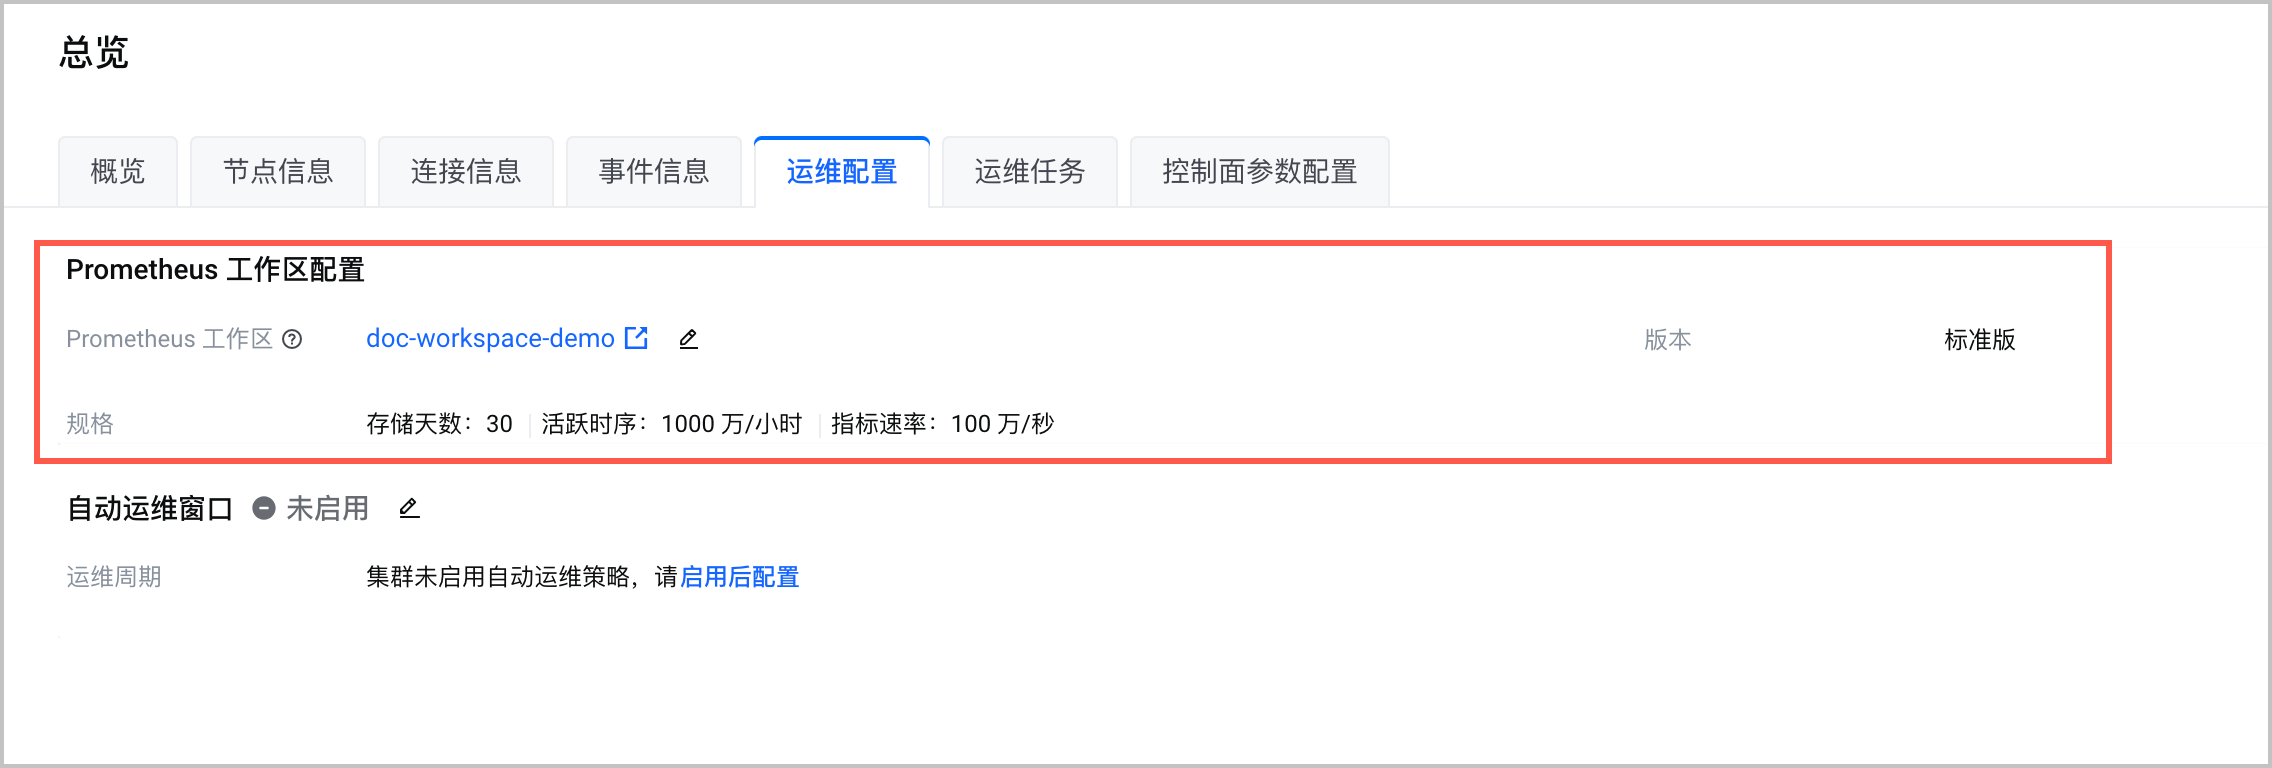
  1. 检查 VKE 总览 里的 运维配置,确认已经开启 Prometheus 工作区。​
  • ​​​
  1. 请检查集群里有 monitoring-config configMap。​
  • 只有集群里有该 configMap,才会创建出 prometheus-agent。如果不存在,请单击 此处 提交工单。​
  • ​
    # 检查是否有该configMap​
    kubectl -nkube-system get cm monitoring-config​
    ​
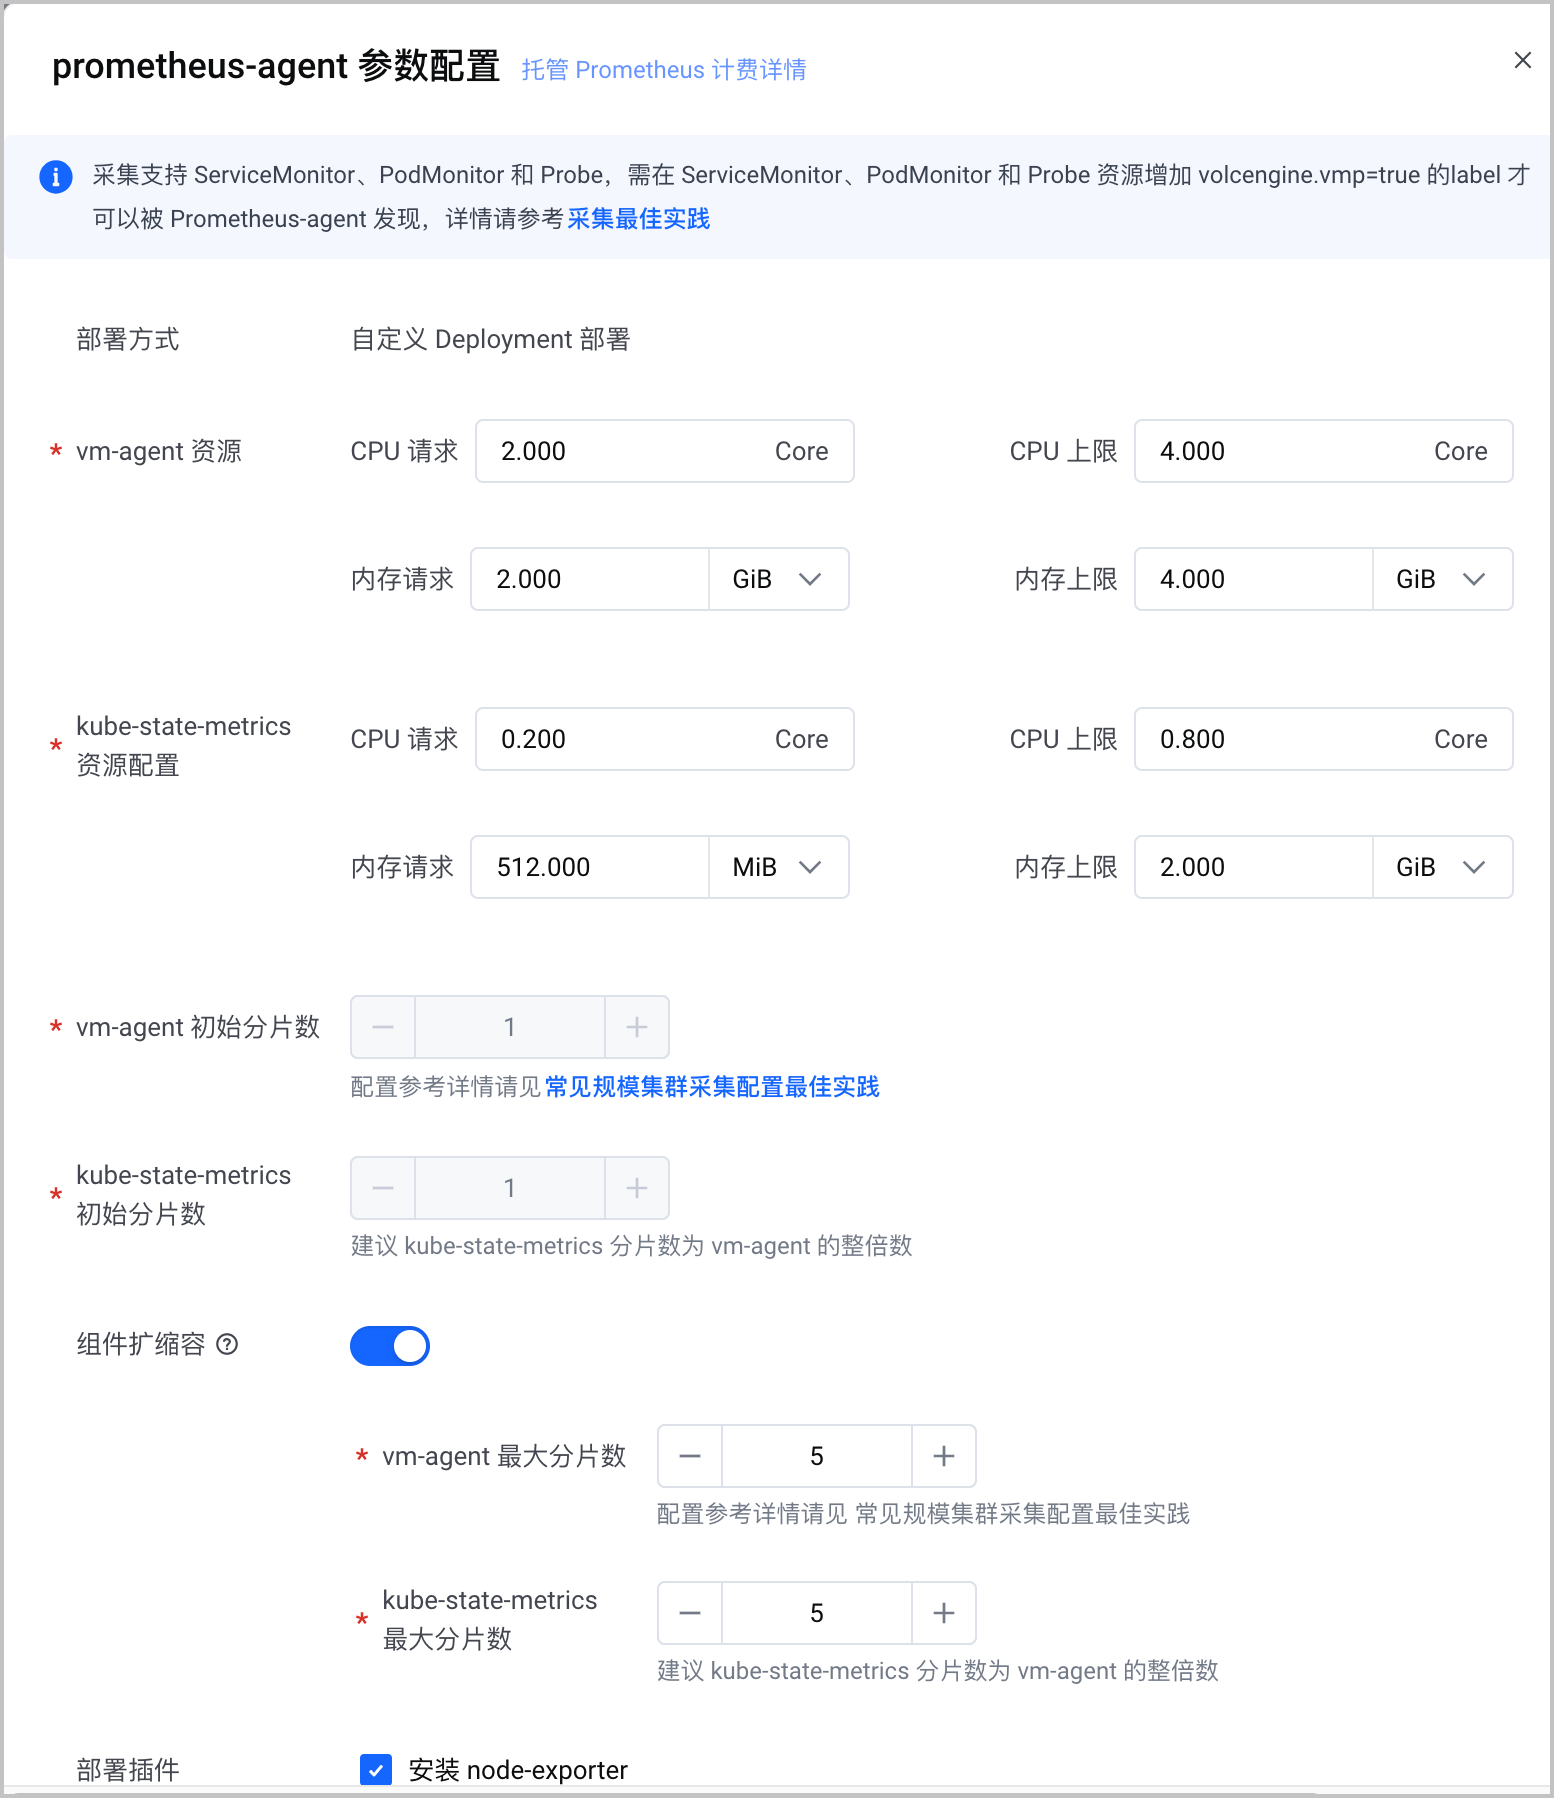
prometheus-agent OOM​
建议在 prometheus-agent 的参数配置里完成以下操作:​
  • 增大资源内存上限​
  • 开启 组件扩缩容​
​​​
​
采集发送链路异常​
可能的原因有:​
  • exporter 和 prometheus-agent 的网络问题​
说明​
请先确保 exporter 状态正常和安全组配置正确。​
  • prometheus-agent 本身有问题​
  • prometheus-agent 到 vmp workspace 的问题​
请结合 检查 prometheus-agent 日志 和 prometheus-agent 基础指标 监控面板进行排查,具体操作步骤请参见 检查 prometheus-agent 状态。​
步骤四:检查采集对象中的指标​
您可以采用如下步骤,确认 Target 中确实存在您需要的指标:​
  1. 在本地环境中,使用 kubectl 连接采集器所在集群,检查 Exporter 状态异常。​
  1. 确认是否 Metrics 接口异常或者指标未暴露。​
  • 在 prometheus-agent dashboard 上,单击 Active targets 页签,查看对应的 target response。​
  • ​Image​​
  • 如果端口不通,不会为 UP 状态,请查看对应展示的 Error 状态。​
  • 如果要确认是否个别指标没有获取到,请在返回的指标页面里,直接搜索对应指标 metric 名。​
  • 通过 curl 手动检查​
  1. 执行以下命令,将采集对象(例如 Exporter)的端口映射到本地。​
  • ​
    kubectl port-forward pod/rabbitmq-exporter-5fxxxx 9419:9419 -n volcano-metrics​
    ​
说明​
  • 采集对象可能部署在集群中,也可能部署在集群外部(例如部署在 ECS 主机上),本例以采集对象部署在集群中举例。如果采集对象部署在集群外部,您可以直接使用 curl http://target-ip:port/metrics 的方式访问到采集对象。​
  • rabbitmq-exporter-5fxxxx 为采集对象的实例名称,本例中以 RabbitMQ-Exporter 为例,您需要在实际操作中替换成您的采集对象的实例名称。​
  • 9419 为该采集对象暴露指标的端口号。不同采集对象的端口号不同,您需要在实际操作中替换成正确的端口号。​
  • -n volcano-metrics 为采集对象所在的命名空间,您需要在实际操作中替换成采集对象所在的命名空间。​
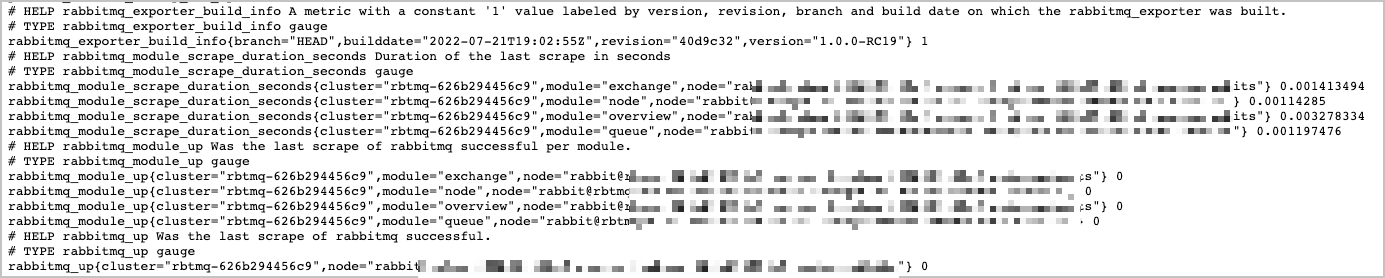
  1. 在本地环境(Linux/Mac)中打开浏览器,在地址栏中输入 localhost:9419,进入采集对象页面,查看您查询的指标是否被正常采集到。​
  • ​Image​​
  1. 如果您的查询指标依然没有被正确采集到,有如下几种可能:​
  • 您所查询的指标已被废弃,请查看该采集对象的官方文档,进行确认。​
  • 您还没有完成指标对应的配置。例如:在 Kafka 中,如果您没有配置 Topic,则无法查询 kafka_topic_partitions 等关于 Topic 的指标项。​
相关文档​
​
最近更新时间:2025.07.01 14:36:48
这个页面对您有帮助吗?
有用
有用
无用
无用