持续交付
持续交付


文档指南

请输入


- 文档首页
 持续交付用户指南AI 应用DeepSeek快速部署 DeepSeek-R1-0528 推理服务
 复制全文
 下载 pdf
快速部署 DeepSeek-R1-0528 推理服务
 文档反馈
 问问助手
本文介绍如何在火山引擎容器服务集群中,快速部署 DeepSeek-R1-0528 模型推理服务,满足您的业务需求。
背景信息
DeepSeek-R1-0528 是深度求索于 2025 年 5 月 28 日推出的推理模型升级版。它以 DeepSeek V3 Base 为基础,参数量达 685B 。通过强化推理链等优化,其推理、编程能力显著提升,在 AIME 2025 数学测试中,准确率从 70% 跃升至 87.5% 。该模型还支持 JSON 输出,幻觉率降低约 50%。并且,它完全开源,性能可与顶尖模型媲美,实用性强 。
使用说明
前提条件
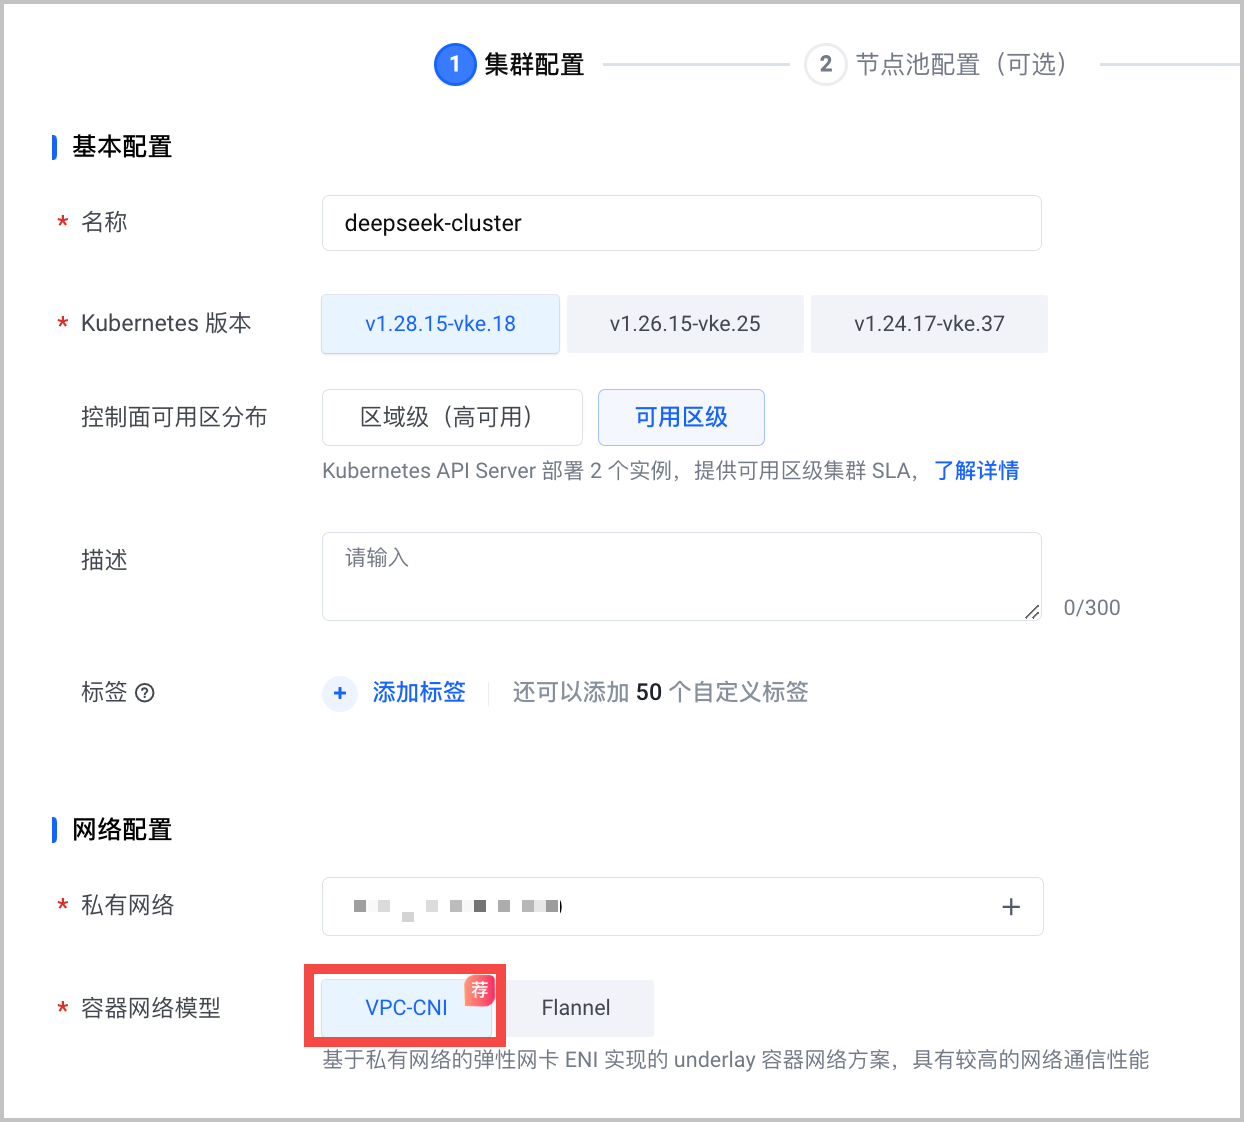
- 容器网络模型:选择 VPC-CNI。
-
- 计算规格:推荐使用不同的机型部署不同的模型,以发挥最大性价比。DeepSeek-R1-0528 的参数量达到了 685B,以下是推荐的机型以及对应的机器数量。
-
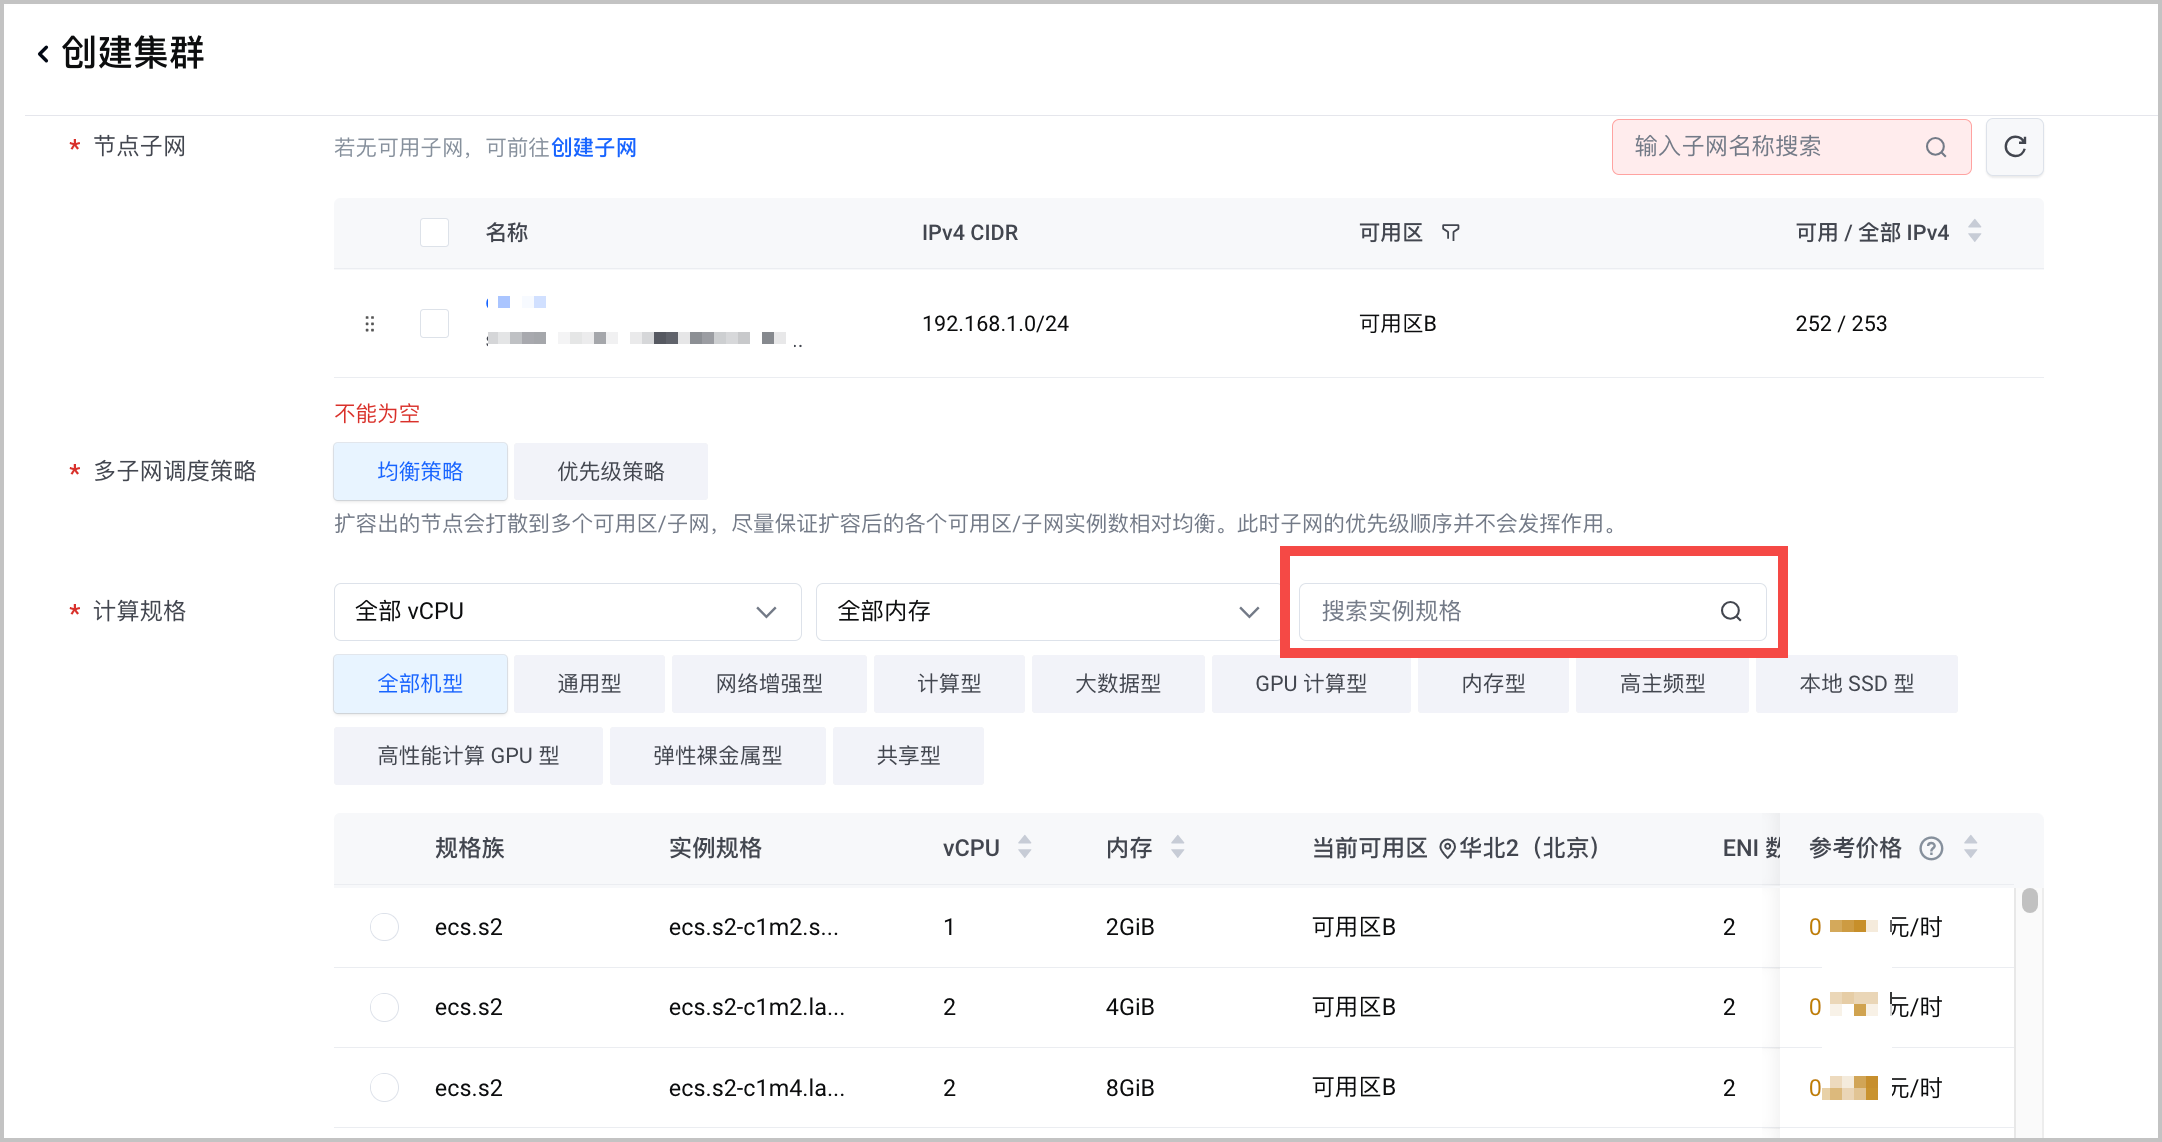
- 模型名称推荐GPU 数量机器数量DeepSeek-R1-0528ecs.hpcpni3ln.45xlarge82ecs.ebmhpcpni2l.32xlarge82
- 组件配置:安装 csi-tos 和 nvidia-device-plugin 两个组件。
API 网关
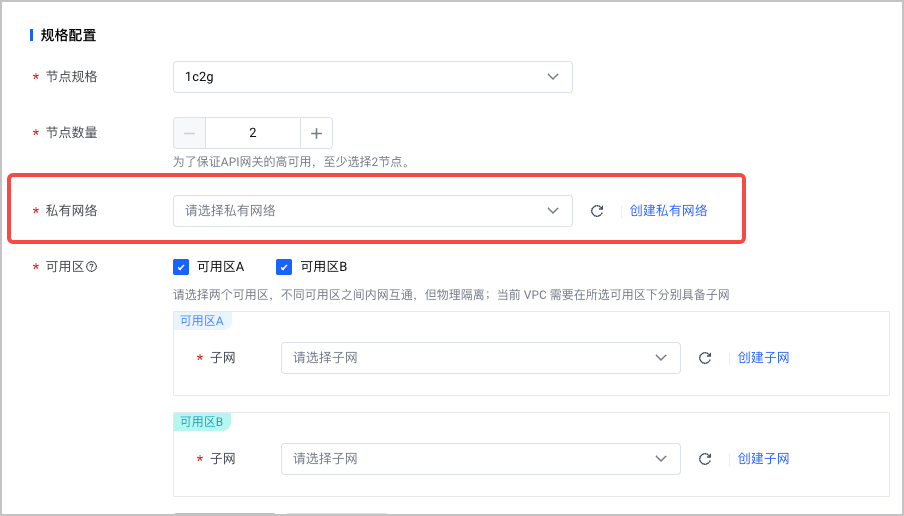
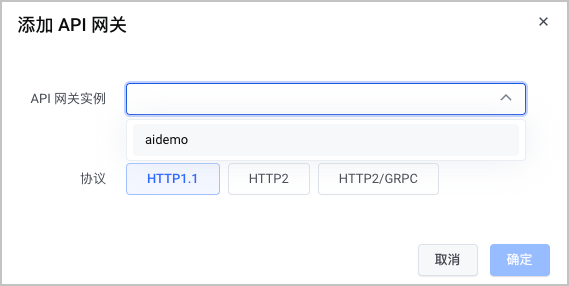
- 已创建 API 网关。 私有网络置必须和所创建 VKE 集群相同。网关节点的规格选择 1c2g 2。协议 为 HTTP1.1。创建 API 网关实例的详细说明参见 创建实例。
-
操作步骤
第一步:开启 RDMA 资源配置
采用分布式推理的方式部署 DeepSeek-R1-0528。分布式部署需要 RDMA 网卡实现多节点之间的数据通信。在已创建的 VKE 集群中,来开启 RDMA 资源配置。
- 更新节点池配置。
- 登录已创建的容器服务集群,在左侧菜单栏中 节点管理 > 节点池,单击目标节点的 编辑,进入节点池编辑页面。
-

- 在 更多配置 > 节点标签 区域,新增标签 vke.node.rdma.mode: exclusive。
-

- 在 高级配置 > Kubelet 自定义参数 区域,添加参数 topology-manager-policy: best-effort。
-

- 安装 RDMA 组件。
- 登录目标 VKE 集群,在 组件管理 > 网络 安装 rdma-device-plugin组件。
-

第二步:创建部署集群
将已创建的 VKE 集群接入持续交付平台。
- 登录 持续交付控制台。
- 在左侧导航栏选择 资源管理。
- 在资源管理页面,切换至 部署资源 页签。
- 在 部署资源 页签,单击 创建部署资源 。
- 在 创建部署资源 对话框,按要求配置部署资源信息。重点注意以下参数配置,其他参数说明参见 接入 VKE 集群。
-
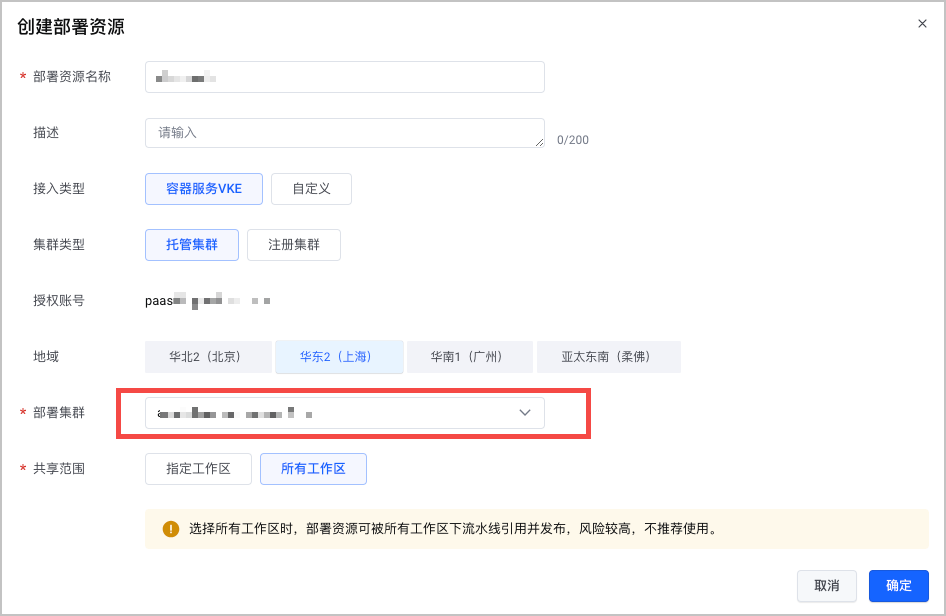
- 配置项说明接入类型选择 容器服务 VKE。地域选择已创建容器服务集群所在的地域。共享范围选择 所有工作区。
第三步:创建 AI 应用
在持续交付的 AI 应用 模块,部署大模型应用。
- 登录 持续交付控制台。
- 在左侧导航栏选择 AI 应用。
- 在 AI 应用页面,单击 创建应用。
- 选择 基于 AI 模型创建 > DeepSeek-R1-0528,单击 部署。
- 按要求填写应用的相关配置信息。配置完成后单击 创建,应用将开始创建并部署。重点注意以下参数配置,其他参数说明参见 创建和部署 AI 应用(自定义创建)。
- 模型配置
-

-
- 部署集群
- 配置项说明部署资源选择已创建的容器服务集群。
- 推理服务规格
-

-
- 单击 创建,启动模型创建。
第三步:创建 API 网关访问推理服务
火山引擎 API 网关 APIG 是基于云原生的、高扩展、高可用的云上网关托管服务。在传统流量网关的基础上,集成丰富的服务发现和服务治理能力,打通微服务架构的内外部网络,实现安全通信。
- 登录当前应用。
- 登录 持续交付控制台。
- 在左侧导航栏选择 AI 应用。
- 在 AI 应用页面,选择目标 AI 应用,单击应用卡片,进入当前应用的基本信息页签。
- 在 基本信息 > 访问设置 页签,选择 API 网关。
-
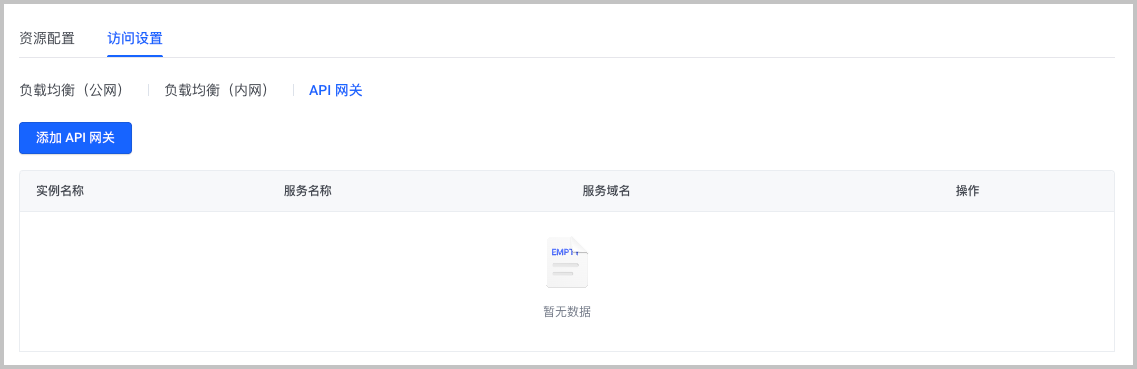
- 单击 添加 API 网关 ,添加符合 前提条件 要求的 API 网关。
-
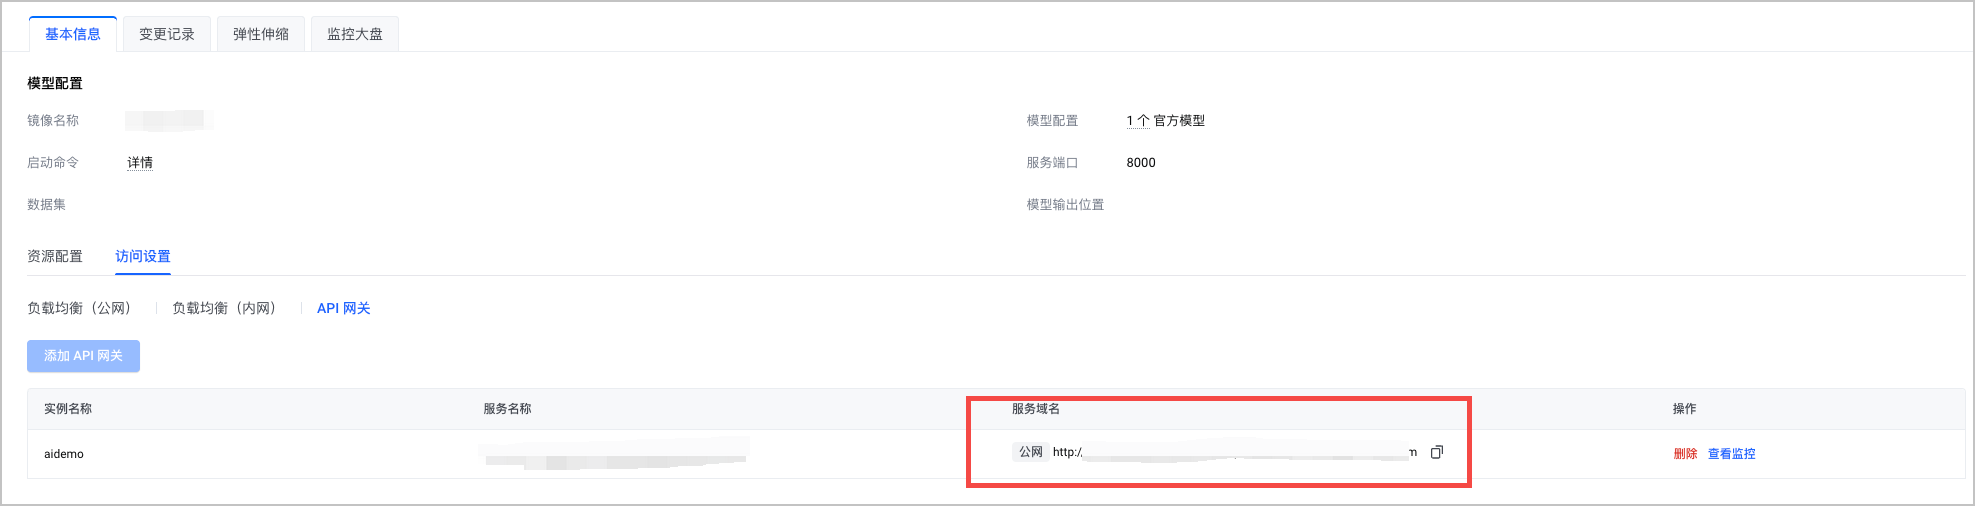
- 完成上述操作后,即可在 访问设置 页面查看模型的公网域名。
-
操作结果
通过本地 curl 命令调用大模型 API,即可以成功和大模型对话。
curl -X POST http://example.com/v1/chat/completions -H "Content-Type: application/json" -d '{
"model": "/model",
"messages": [
{
"role": "user",
"content": "Your question to DeepSeek"
}
],
"temperature": 0.7
}'
最近更新时间:2025.09.04 19:20:17
这个页面对您有帮助吗?
有用
有用
无用
无用