向量数据库 Milvus 版
向量数据库 Milvus 版
向量数据库 Milvus 版


文档指南
请输入


产品动态
用户指南
实例管理
库表管理
任务中心
集成中心
最佳实践
API 参考
实例管理
工作流管理
- 文档首页
 向量数据库 Milvus 版最佳实践向量数据库 Milvus 版和 DeepSeek-V3.1多模态打标实践
 复制全文
 下载 pdf
向量数据库 Milvus 版和 DeepSeek-V3.1多模态打标实践
 文档反馈
 问问助手
在推荐系统中,特征提取和标签标注都是推荐系统中的核心链路,决定了推荐精度与推荐效率。本文主要讲述如何使用向量数据库 Milvus 版与大模型结合实现一个多模态特征提取和打标系统,利用向量数据库 Milvus 版对高维数据高效存储与相似性检索,结合 Doubao 对于图像、DeepSeek V3.1 对于语义的精准理解,实现自动化打标和特征提取。
整体架构
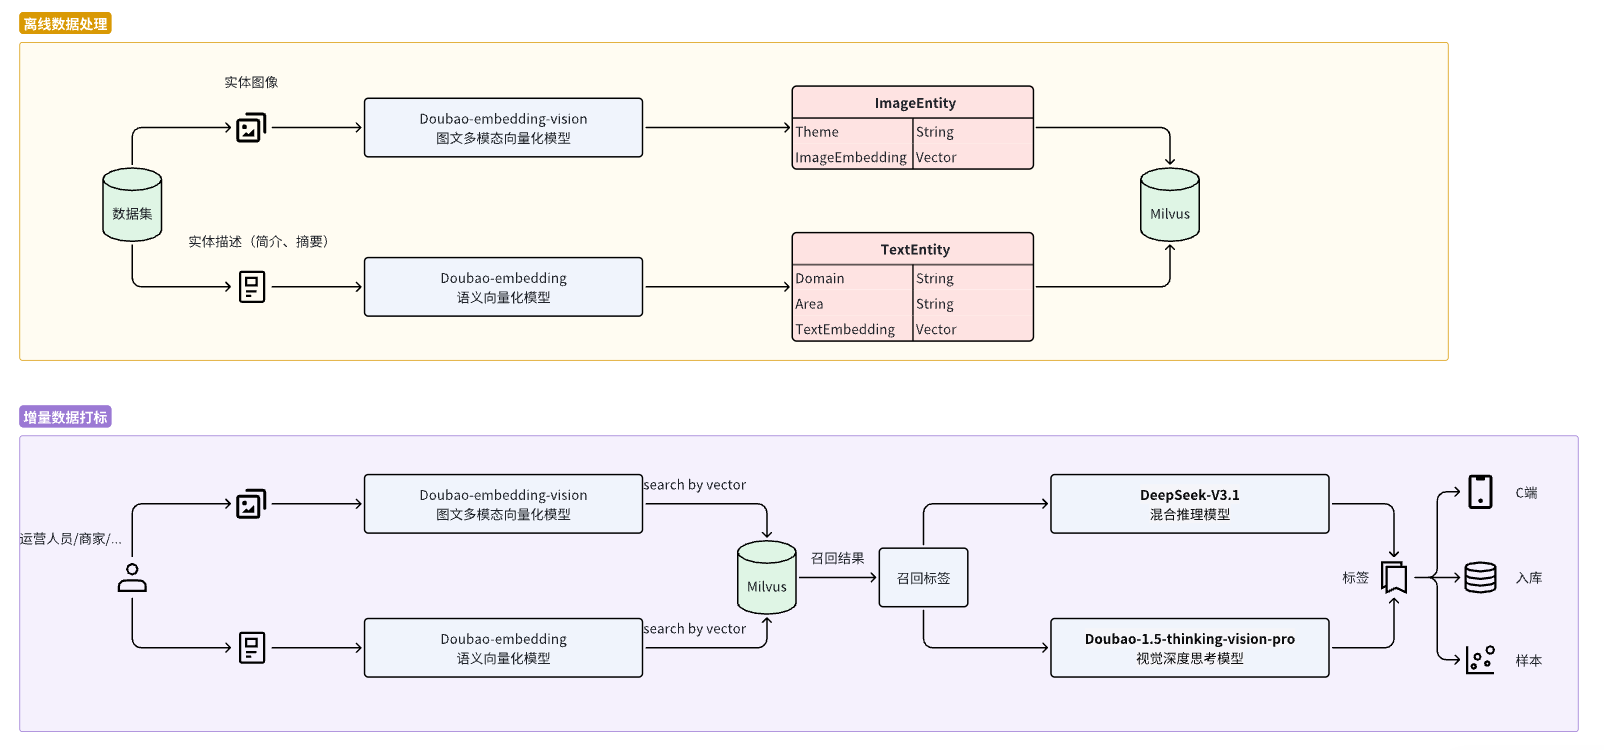
架构组成
- 离线数据处理:已经打标的数据 > 大模型向量化 > 写入向量数据库 Milvus 版。
- 增量数据打标:用户输入图像或文本 > 大模型向量化 > 向量数据库 Milvus 版召回结果提取标签 > DeepSeek V3.1 或 Doubao 打标 > 用户端、数据库、数据样本等。
前提条件
- 已创建实例且实例处于运行中状态。具体操作,请参见创建实例。
- 已获取实例的访问地址。具体操作,请参见连接实例。
- 已在火山方舟控制台创建用于所需模型的在线推理接入点。具体操作,请参见获取 Endpoint ID(创建自定义推理接入点)。
说明
本实践中使用多模态理解模型(Doubao-1.5-thinking-vision-pro)、多模态向量化模型(Doubao-embedding-vision 和 Doubao-embedding)、推理模型(DeepSeek-V3.1)。您可根据需要选择其他模型。关于各模型的介绍,请参见模型列表。
- 已安装 pymilvus。安装命令如下。
- # Install specific PyMilvus versionpip install pymilvus==2.5.8# Update PyMilvus to the newest versionpip install --upgrade pymilvus# Verify installation successpython -m pip list | grep pymilvus
- 已安装火山方舟 SDK。具体操作,请参见安装与初始化。
- 已下载文本素材数据。
- 已下载图片素材并解压。代码如下。
- wget https://github.com/milvus-io/pymilvus-assets/releases/download/imagedata/reverse_image_search.zipunzip -q -o reverse_image_search.zip
离线数据处理
核心代码逻辑
- 读取已经打标的数据集,调用模型接入点将对应图片或文本转换为向量。
- 将向量数据、标签批量写入向量数据库 Milvus 版。
图片数据处理
- 创建 Collection。
- 在已创建的向量数据库 Milvus 版实例中创建 Collection,完整代码如下。具体操作,请参见创建 Collection。
- 字段名称数据类型索引类型说明度量类型字段名称数据类型索引类型说明度量类型idint64auto_index自动 ID。-image_pathvarchar(512)auto_index图片地址。-image_embeddingfloat_vector(2048)auto_index图片向量。L2themevarchar(128)auto_index图片主题标签。-
- from pymilvus import MilvusClientfrom pymilvus import DataTypemilvus_client = MilvusClient(uri="http://milvus-xxx.milvus.ivolces.com:19530", # Milvus 实例的访问地址token="<user>:<password>", # Milvus 实例的用户名和密码,替换为创建实例的用户名密码)def create_collection_if_not_exists(collection_name):if collection_name in milvus_client.list_collections():print(f"Collection {collection_name} already exists.")returnschema = MilvusClient.create_schema(auto_id=False,enable_dynamic_field=True,)schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)schema.add_field(field_name="image_path", datatype=DataType.VARCHAR, max_length=512)schema.add_field(field_name="image_embedding", datatype=DataType.FLOAT_VECTOR, dim=2048)schema.add_field(field_name="theme", datatype=DataType.VARCHAR, max_length=128)index_params = milvus_client.prepare_index_params()index_params.add_index(field_name="id",index_type="AUTOINDEX")index_params.add_index(field_name="image_embedding",index_type="AUTOINDEX",metric_type="L2")index_params.add_index(field_name="theme",index_type="AUTOINDEX")milvus_client.create_collection(collection_name=collection_name,schema=schema,index_params=index_params,consistency_level="Bounded",num_shards=1)print(f"Created collection {collection_name}")
- 图像向量化。
- 调用 Doubao-embedding-vision 模型接入点,将图片向量化。代码如下。
- import base64from volcenginesdkarkruntime import Arkimport numpy as npark_client = Ark(api_key="<your_api_key>",base_url="https://ark-cn-beijing.bytedance.net/api/v3",timeout=120,max_retries=2,)def encode_image(image_path):with open(image_path, "rb") as image_file:return base64.b64encode(image_file.read()).decode('utf-8')def image_embedding(image_path):image_base64 = encode_image(image_path)resp = ark_client.multimodal_embeddings.create(model="<your_model_id>",input=[{"type": "image_url","image_url": {"url": f"data:image/jpeg;base64,{image_base64}"}}])embedding = resp.data.embedding# 确保向量是numpy数组并展平为一维embedding = np.array(embedding).flatten()print(f"向量维度:{embedding.shape}")return embedding
- 写入向量和标签
- 将向量化数据和打标的标签写入向量数据库 Milvus 版。
- def insert_single_data(path, theme):image_vector = image_embedding(image_path)insert_data([{"image_path": image_path, "image_embedding": image_vector, "theme": theme}], "tag_model_demo")def insert_data(data, collection_name):milvus_client.insert(collection_name=collection_name,data=data)def batch_insert():df = pd.read_csv("reverse_image_search.csv")success_count = 0failure_count = 0for index, row in tqdm(df.iterrows(), total=len(df), desc="生成图像embedding"):image_path = row["path"]theme = row["label"] # 读取 label 字段print(f"开始处理{image_path},标签: {theme}")try:image_vector = image_embedding(image_path)insert_data([{"image_path": image_path, "image_embedding": image_vector, "theme": theme}], "tag_model_demo")print(f"成功插入{image_path}")success_count += 1time.sleep(1) # 控制 API 调用频率except Exception as e:print(f"处理{image_path}失败,已跳过: {str(e)}")failure_count += 1print(f"成功插入{success_count}张图片,失败{failure_count}张图片")
文本数据处理
- 创建 Collection。
- 在已创建的向量数据库 Milvus 版实例中创建 Collection,完整代码如下。具体操作,请参见创建 Collection。
-
- 字段名称数据类型索引类型说明度量类型字段名称数据类型索引类型说明度量类型idint64auto_index自动 ID。-abstractvarchar(65535)auto_index文章摘要。-text_embeddingfloat_vector(2560)auto_index文本向量。L2domainvarchar(128)auto_indexdomain标签。-areavarchar(128)auto_indexarea标签。-
- from pymilvus import MilvusClientfrom pymilvus import DataTypemilvus_client = MilvusClient(uri="http://milvus-xxx.milvus.ivolces.com:19530", # Milvus 实例的访问地址token="<user>:<password>", # Milvus 实例的用户名和密码,替换为创建实例的用户名密码)def create_collection_if_not_exists_text(collection_name):if collection_name in milvus_client.list_collections():print(f"Collection {collection_name} already exists.")returnschema = MilvusClient.create_schema(auto_id=False,enable_dynamic_field=True,)schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)schema.add_field(field_name="abstract", datatype=DataType.VARCHAR, max_length=65535)schema.add_field(field_name="text_embedding", datatype=DataType.FLOAT_VECTOR, dim=2560)schema.add_field(field_name="domain", datatype=DataType.VARCHAR, max_length=128)schema.add_field(field_name="area", datatype=DataType.VARCHAR, max_length=128)index_params = milvus_client.prepare_index_params()index_params.add_index(field_name="id",index_type="AUTOINDEX")index_params.add_index(field_name="abstract",index_type="AUTOINDEX")index_params.add_index(field_name="text_embedding",index_type="AUTOINDEX",metric_type="L2")index_params.add_index(field_name="domain",index_type="AUTOINDEX")index_params.add_index(field_name="area",index_type="AUTOINDEX")milvus_client.create_collection(collection_name=collection_name,schema=schema,index_params=index_params,consistency_level="Bounded",num_shards=1)print(f"Created collection {collection_name}")
- 文本向量化。
- 调用 Doubao-embedding 模型接入点进行文本向量化,代码如下。
- import base64from volcenginesdkarkruntime import Arkimport numpy as npark_client = Ark(api_key="<your_api_key>",base_url="https://ark-cn-beijing.bytedance.net/api/v3",timeout=120,max_retries=2,)def text_embedding(text):resp = ark_client.embeddings.create(model="<your_model_id>",input=text)embedding = resp.data[0].embedding# 确保向量是 numpy 数组并展平为一维embedding = np.array(embedding).flatten()print(f"向量维度:{embedding.shape}")return embedding
- 写入向量和标签。
- 将向量化数据和打标的标签写入向量数据库 Milvus 版。
- def insert_data(data, collection_name):milvus_client.insert(collection_name=collection_name,data=data)def write_single_data(text, domain, area):text_vector = text_embedding(text)insert_data([{"abstract": text, "text_embedding":text_vector, "domain": domain, "area": area}], "tag_model_text_demo")def batch_insert_text():create_collection_if_not_exists_text("tag_model_text_demo")df = pd.read_excel("text_demo_1000.xlsx", usecols=["domain", "area", "abstract"])success_count = 0failure_count = 0for index, row in tqdm(df.iterrows(), total=len(df), desc="生成文本embedding"):abstract = row.abstractdomain = row.domainarea = row.areatry:text_vector = text_embedding(abstract)insert_data([{"abstract": abstract, "text_embedding":text_vector, "domain": domain, "area": area}], "tag_model_text_demo")success_count += 1time.sleep(1) # 控制 API 调用频率except Exception as e:print(f"处理失败,已跳过: {str(e)}")failure_count += 1print(f"成功插入{success_count}条文本,失败{failure_count}条文本")
打标处理
核心代码逻辑
- 通过大模型将物料的图片和文本生成向量。
- 使用向量在向量数据库 Milvus 版中进行向量搜索。
- 将召回结果中的标签和物料本身传递至大模型生成打标结果。
图片打标
- 图片搜索。
- 将用户上传的图片转换成向量,在向量数据库 Milvus 版中进行向量搜索,提取搜索结果的标签。代码如下。
- def search_by_image(collection_name, image_embedding, limit):res = milvus_client.search(collection_name=collection_name,anns_field="image_embedding",data=[image_embedding],limit=limit,output_fields=["id", "image_path", "theme"],)print(res)return resdef query_by_image(image_path):query_image_embedding = image_embedding(image_path)res = search_by_image("tag_model_demo", query_image_embedding, 10)return [hit.entity["theme"] for hit in res[0]]
- ['goldfish', 'goldfish', 'goldfish', 'goldfish', 'goldfish', 'goldfish', 'goldfish', 'goldfish', 'brain_coral', 'brain_coral']
- 图片打标。
- 将图片和标签召回结果传给图像大模型进行打标,在提示词中提示模型尽量使用召回结果中的标签进行打标,如果没有合适的召回结果也可让大模型抽象出新的标签。
- def auto_tag_image(image_path, unique_themes):image_base64 = encode_image(image_path)recommond_tags_system_prompt = f"""## 角色- 你是一个图片分类器,你能够很好的分析用户传入的图片,然后给图片分类打标签;## 任务- 基于用户传入的图片,分析图片内容,对图片打标签分类,输出theme标签;## 推荐使用的标签- 推荐的theme标签:{unique_themes};## 要求- 先分析用户上传的图片内容是什么,这个内容最可能是什么主题的,一步一步慢慢分析;- 对于一个图片,只能打唯一一个theme标签;- 优先从上面给的"推荐使用的标签"里面选取标签,打给用户上传的图片;- 经过分析后,若"推荐使用的标签"里面没有合适的标签,则抽象出一个简短的词语作为新的标签;- 严格按照下面的json格式输出;## 输出格式参考{{"analysis": "这里是你对图片内容,以及应该怎么打标签的分析", "theme": "theme标签"}}"""response = ark_client.chat.completions.create(# 替换为您的推理接入点 IDmodel="<your_model_id>",messages=[{"role": "user","content": [{"type": "image_url","image_url": {"url": f"data:image/jpeg;base64,{image_base64}"},},{"type": "text","text": recommond_tags_system_prompt,},],}],)return response.choices[0].message.content
- 查看打标结果。
- {"analysis": "图片中展示的是金鱼,在推荐使用的标签中存在'goldfish'这一标签,该标签与图片内容主题匹配,因此选择该标签。", "theme": "goldfish"}
文本打标
- 文本搜索
- 将用户输入的文本转成向量,在向量数据库 Milvus 版中进行向量搜索,提取出召回结果的标签信息。代码和输出如下。
- def search_by_text(collection_name, text_embedding, limit):res = milvus_client.search(collection_name=collection_name,anns_field="text_embedding",data=[text_embedding],limit=limit,output_fields=["id", "abstract", "domain", "area"],)return resdef query_by_text(text):query_text_embedding = text_embedding(text)tags = search_by_text("tag_model_text_demo", query_text_embedding, 10)domains = [hit.entity["domain"] for hit in tags[0]]areas = [hit.entity["area"] for hit in tags[0]]return domains, areas
- 输出如下。
- ['ECE', 'ECE', 'ECE', 'ECE', 'ECE', 'ECE', 'ECE', 'ECE', 'Civil', 'ECE']['Satellite radio', 'Analog signal processing', 'Operational amplifier', 'Satellite radio', 'Satellite radio', 'Analog signal processing', 'Satellite radio', 'Satellite radio', 'Green Building', 'Digital control']
- 文本打标。
- 将文本和向量数据库 Milvus 版中召回的标签传给 DeepSeek-V3.1 模型进行打标,同样在提示词中提示模型尽量使用召回结果中的标签进行打标,如果没有合适的召回结果也可让 DeepSeek 抽象出新的标签。代码如下。
- def auto_tag_text(text, unique_domains, unique_areas):recommond_tags_system_prompt = f"""## 角色- 你是一个文本摘要分类器,你能够很好的分析用户输入的文章摘要,然后给文章摘要分类打标签;## 任务- 基于用户输入的文章摘要,分析文章摘要,对文章摘要打标签分类,输出domain标签和area标签;## 推荐使用的标签- 推荐的domain标签:{unique_domains};- 推荐的area标签:{unique_areas};## 要求- 先分析用户输入的文章摘要内容是什么,这个内容最可能是什么主题的,一步一步慢慢分析;- 对于一个文章摘要,只能打唯一一个domain标签和唯一一个area标签;- 优先从上面给的"推荐使用的标签"里面选取标签,打给用户输入的文章摘要;- 经过分析后,若"推荐使用的标签"里面没有合适的标签,则抽象出两个简短的词语分别作为新的domain标签和area标签;- 严格按照下面的json格式输出;## 输出格式参考{{"analysis": "这里是你对文章摘要内容,以及应该怎么打标签的分析", "domain": "domain标签", "area": "area标签"}}"""response = ark_client.chat.completions.create(# 替换为您的推理接入点 IDmodel="<your_model_id>",messages=[{"role": "system", "content": recommond_tags_system_prompt},{"role": "user", "content": text},],)return response.choices[0].message.content
- 查看打标结果。
- {"analysis": "The article discusses a software-defined radio (SDR) with a flexible RF front end, focusing on its application in maritime frequency bands, specifically for systems like the Automatic Identification System (AIS) and the upcoming VHF Data Exchange Service (VDES). This involves radio communication, signal processing, and satellite links, falling under the domain of electrical and computer engineering (ECE). The area is closely related to satellite radio and data exchange services in maritime contexts, making 'Satellite radio' a fitting area tag from the recommended list.","domain": "ECE", "area": "Satellite radio"}
最近更新时间:2025.12.12 18:56:30
这个页面对您有帮助吗?
有用
有用
无用
无用