文档数据库 MongoDB 版
文档数据库 MongoDB 版


文档指南

请输入


- 文档首页
 文档数据库 MongoDB 版最佳实践oplog 相关参数设置指南
 复制全文
 下载 pdf
oplog 相关参数设置指南
 文档反馈
 问问助手
文档数据库 MongoDB 版提供了 oplog 大小和 oplog 保留时间相关参数,oplog 相关参数设置不合理,可能会导致 oplog 被覆盖,从而影响 MongoDB 的主从复制和按时间点恢复数据等功能。本文介绍如何配置合理的 oplog 相关参数供您参考。
功能介绍
oplog(Operation log)是 MongoDB 中一个特殊的有界集合(capped collection),是 MongoDB 中实现复制功能的基本机制,会将数据库上已执行所有写操作(如插入、更新、删除等)按时间顺序记录在 local.oplog.rs 集合中。更多关于 oplog 的详情,请参见 Replica-set-oplog。
oplog 大小
文档数据库 MongoDB 版提供了 replication.oplogSizeMB 参数来指定 oplog 的大小。该参数支持动态和静态两种取值方式,其中:
- 动态取值:即 Default,系统会将实例 10% 的最大可用存储空间用于记录 oplog。
说明
- 例如,实例的最大可用存储空间为 20 GiB,且 replication.oplogSizeMB 设置为 Default,那么当前实例中可用于记录 oplog 的空间为 2 GiB。更多关于该参数的详情,请参见 replication.oplogSizeMB。
- 如果您变更了实例配置导致实例最大可用存储空间改变,那么 replication.oplogSizeMB 的实际取值也会改变。关于实例最大可用存储空间的更多详情,请参见查看实例信息。
- 为保证实例性能,建议 oplog 大小不要超过实例最大可用存储空间的 30%,若需要的 oplog 大小超过该值,建议扩容实例存储空间。实例变配的具体操作步骤,请参见副本集实例变配和变更分片集群实例配置。
- 静态取值:2048~实例最大可用存储空间的 90%。单位:MiB。
说明
- 实例或节点规格不同,该参数的静态取值范围也会不同,具体数值以控制台为准。例如,实例的最大可用存储空间为 60 GiB,那么控制台上的静态取值范围为 2048~55296。
- 您可以通过配置 replication.oplogSizeMB 参数来调整 oplog 大小,该参数调整后无需重启实例即可生效。参数修改方法,请参见修改实例参数。
您可以通过 mongo shell 或 mongosh 等客户端工具连接 MongoDB 实例后,执行以下命令来查看 oplog 大小以及 oplog 窗口期。
说明
- 通过 mongo shell 或 mongosh 工具连接实例的具体方法,请参见通过 mongo shell 工具连接实例。
- 如需查看分片集群的 oplog 大小,请使用分片集群中的 Shard 连接地址进行查看。关于连接地址的更多详情,请参见查看连接地址。
示例结果如下。
在上述示例中,oplog 大小为 2048MB,oplog 窗口期约为 3615 小时。
oplog 最短保留期
文档数据库 MongoDB 版提供了 oplog 最短保留期参数 oplogMinRetentionHours,设置该参数后可以确保 MongoDB 实例的 oplog 保留窗最小值也不会少于该参数值。
说明
- 仅 MongoDB 4.4 及之后的版本支持该参数,关于该参数的更多详情,请参见 oplogMinRetentionHours。
- 如需调整 oplog 最短保留期,您可以在 MongoDB 控制台上修改 oplogMinRetentionHours 参数。该参数调整后无需重启实例即可生效。参数修改方法,请参见修改实例参数。
- 文档数据库 MongoDB 支持对 oplog 保留窗设置事件告警规则,如果 oplog 可用时间过短,那么能保留的 oplog 记录有限,在主从复制时延增大、从库重建等场景下,因缺失所需 oplog 导致主从复制失败的风险会增加,进而影响实例可用性和数据可靠性。更多详情,请参见事件监控。
文档数据库 MongoDB 版实例的 oplog 清理规则会受到 oplog 大小和最短保留期的控制,具体清理规则请参见下表。
参数设置场景 | oplog 清理规则 | oplog 清理示例 |
未设置 oplogMinRetentionHours 参数 | oplogMinRetentionHours 参数的默认值为 0,表示不设置 oplog 最短保留期,此时 oplog 的清理规则由 oplog 大小 replication.oplogSizeMB 参数单独控制。 | 例如,MongoDB 实例创建成功后,均未手动修改 oplogMinRetentionHours 和 replication.oplogSizeMB 的默认值,即不设置 oplog 最短保留期,且 oplog size 的存储空间为实例 10% 的最大可用存储空间。那么系统将在 oplog size 超出实例 10% 的最大可用存储空间后被自动清理。 |
已设置 oplogMinRetentionHours 参数 | 此时 oplog 清理规则会同时受到 oplog 大小和最短保留期参数的控制。当同时满足如下条件时,MongoDB 会开始清理 oplog:
| 例如,MongoDB 实例创建成功后,已根据业务需要设置了 oplog 最短保留期为 40 小时,oplog size 仍采用默认动态取值(即实例 10% 的最大可用存储空间)。 在实例初始化还未写入过多数据时,oplog 集合的实际大小还未达到 replication.oplogSizeMB 参数所配置的上限,而 oplogMinRetentionHours 参数配置的 oplog 窗口期通常会比实际所需要的 oplog 窗口期大很多,因此 oplog 集合大小仅由 replication.oplogSizeMB 参数单独控制。 随着业务发展,当 oplog 集合的实际大小已超出 replication.oplogSizeMB 参数值后,oplog 大小将受到 oplog 最短保留期的限制,若 oplog 生成速度较快,oplog 集合的实际大小可能会远远超过 replication.oplogSizeMB 所配置的参数值。 |
设置指南
通用场景设置指南
您可以参照下表根据自身业务特征适当增加或减少 oplog size。
说明
- 通常情况下,建议只通过修改 replication.oplogSizeMB 参数来确保有足够的 oplog 窗口。
- 文档数据库 MongoDB 版中 replication.oplogSizeMB 参数默认采用动态取值方式,即系统会将实例 10% 的最大可用存储空间用于记录 oplog。通常情况下,您仅需要保持默认值即可,如果您变更了实例配置导致实例最大可用存储空间改变,那么 replication.oplogSizeMB 的实际取值也会自动改变。
- 无论是设置 MongoDB 实例的 oplog 大小或是 oplog 最短保留期参数,最好确保 oplog 的窗口期在 24 小时以上。
oplog size 调整建议 | 适用的业务特征 |
适当增加 oplog size | 业务存在较多的增删改操作,例如批量更新、频繁插入删除、或原地大量更新操作。 |
酌情减少 oplog size | 业务中增删改操作较少,主要将 MongoDB 数据库用于存储冷数据。 |
特殊场景设置指南
变配重启等场景需关注的相关配置
新增或重启从节点后,需要依赖 oplog 中的记录来确定这些节点能否成为副本集中正常工作的节点。这些节点可能会在某些情况下(例如网络延迟、丢包、中断,从节点磁盘吞吐达到瓶颈,writeConcern 使用了 {w:1} 且写入负载较大)出现延迟,无法从同步源中找到所期望的 oplog 记录,此时就会出现 too stale to catch up 报错,且节点状态也会变为 RECOVERING 异常状态,最终导致主从节点复制失败。
注意
在执行变配或重启等操作前,强烈建议重点关注 MongoDB 实例中从节点延迟的情况,以及实例的 oplog 窗口期是否能够满足要求,避免因从节点延迟过大导致节点进入异常状态无法恢复。当从节点的延迟不断增加时,请及时提交工单联系技术支持协助解决。
您可以通过如下任意一种方式查看从节点延迟情况。
查看方式 | 操作步骤 | 结果示例 |
方式一:通过 MongoDB 控制台查看 | 您可以参考下图中的主从延时字段来查看节点的延迟情况。 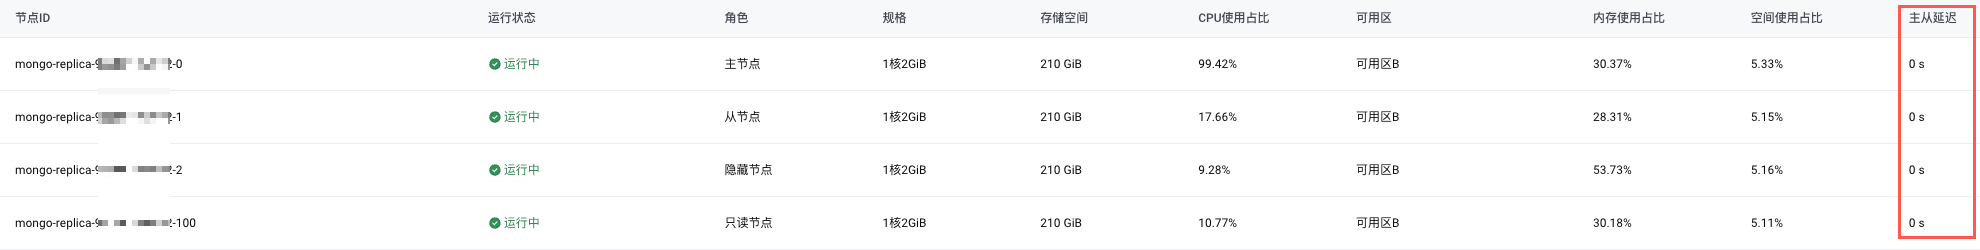 从上述截图中可以看到,实例中的其他节点与主节点均没有延迟。 | |
| 您可以参考下图中的主备延时指标来查看节点的延迟情况。 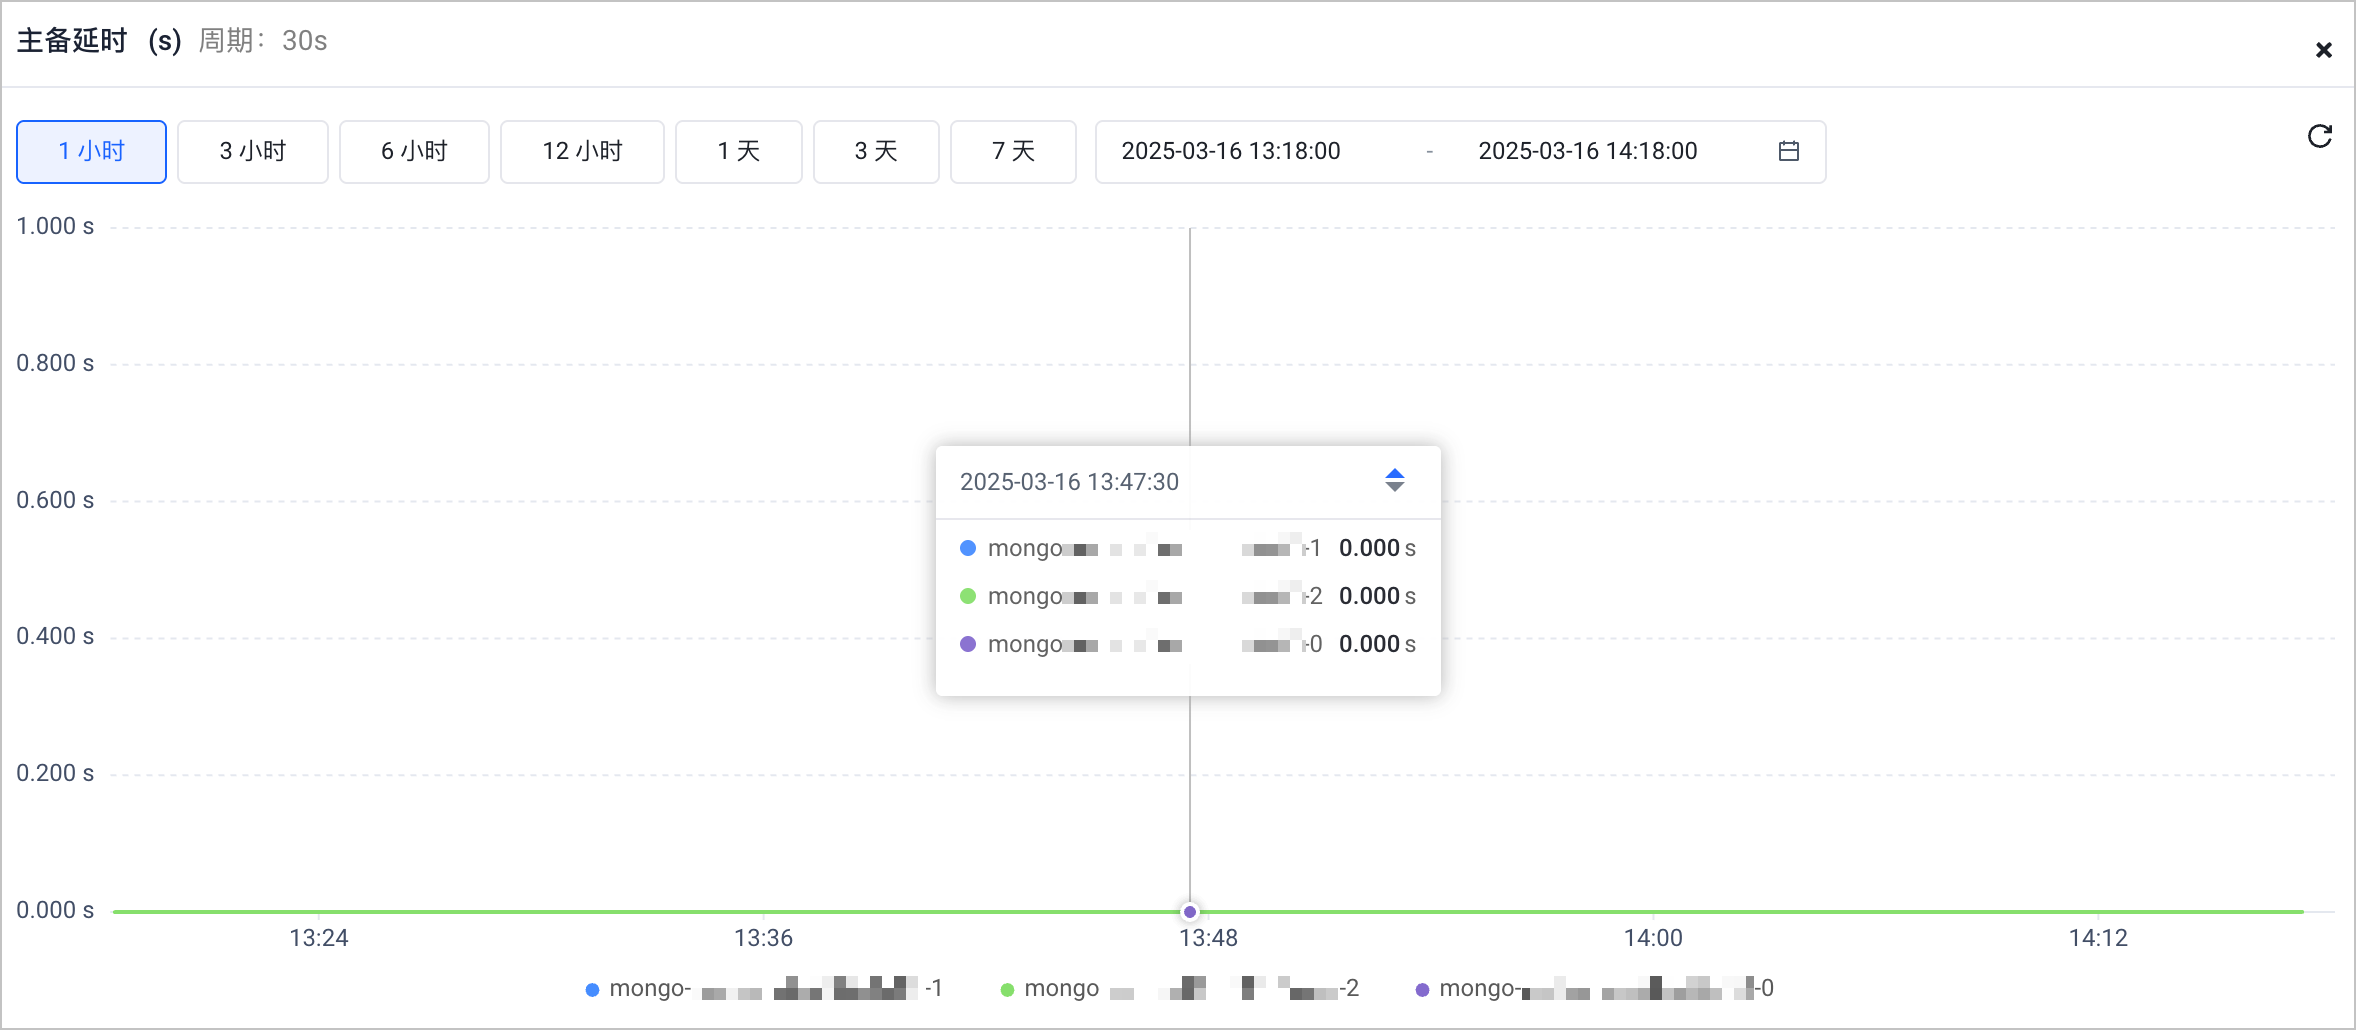 从上述截图中可以看到,实例中的其他节点与主节点均没有延迟。 | |
方式二:通过客户端工具查看 | 您可以通过 mongo shell 或 mongosh 等客户端工具连接 MongoDB 实例后,执行以下命令来查看从节点延迟情况。 说明
| 您可以根据命令返回结果中的 behind the primary 信息查看从节点的延迟情况。示例结果如下。 在上述示例中,第一个从节点存在 5 秒延迟(5 secs (0 hrs) behind the primary),另外两个从节点不存在延迟(0 secs (0 hrs) behind the primary)。 |
避免日志备份空洞的相关配置建议
文档数据库 MongoDB 版默认开启自动备份功能,备份对象包括数据库数据和 oplog 日志。针对日志备份,系统会以每分钟 1 次的频率,自动进行 oplog 日志的流式备份,无需配置。更多详情,请参见备份恢复。
MongoDB 支持通过回放日志备份文件中的 oplog 来按时间点恢复实例数据。但在某些数据同步、导入或测试场景(例如,使用 DTS、mongoShake 或其他工具同步/导入大量数据,短期内批量插入或更新大量数据,对数据进行压力测试)下,实例的写入速度会很快,若此时设置的 oplog size 较小或 oplog 最短保留期太短时,可能会出现 oplog 覆盖旧操作记录的速度过快,日志备份无法跟上 oplog 覆盖速度而导致日志备份空洞的情况。
您可以通过 oplog 大小以及 oplog 窗口来估算 oplog 生成速度。例如某 MongoDB 实例的 oplog 大小为 1800 GiB,oplog 窗口为 25h(即 1500min),那么 oplog 生成速度大约为 1.2 GiB/min。根据文档数据库 MongoDB 版实例过往使用经验,当 oplog 生成速度超过 10 GiB/min 后,出现日志备份空洞的概率会大大增加。
为避免或减少日志备份空洞的产生,你可以参考如下建议对数据库进行优化:
- 适当限制同步或导入工具的写入并发度、批次大小等。
- 将 writeConcern 设置为 {w:"majority"},而不是 {w:1}。
- 使用分片集群实例或者增加分片数,通过将数据分散到多个分片来降低单个分片上的 oplog 生成速度。
- 根据业务特点和需要适当调大 oplog 大小或者 oplog 最短保留期,为日志备份提供更多的缓冲时间,以便日志备份在业务低峰期有足够的时间去追赶之前落后的 oplog 记录。
相关监控告警配置
在根据上述设置指南对 oplog 相关参数进行了合理配置后,强烈建议您同时根据业务需求为 MongoDB 设置如下相关监控告警配置。
说明
- 关于 MongoDB 支持的监控指标详情,请参见监控指标说明。
- 查看 MongoDB 实例的监控数据的具体操作步骤,请参见查看监控数据。
- 为 MongoDB 实例创建告警策略的具体操作步骤,请参见设置告警。
- 关于 MongoDB 支持的事件监控详情,请参见事件监控。
最近更新时间:2026.02.13 14:08:24
这个页面对您有帮助吗?
有用
有用
无用
无用