文档数据库 MongoDB 版
文档数据库 MongoDB 版


文档指南

请输入


- 文档首页
 文档数据库 MongoDB 版快速入门检索功能
 复制全文
 下载 pdf
检索功能
 文档反馈
 问问助手
本文介绍文档数据库 MongoDB 版的检索功能。
功能介绍
在应用程序中构建检索能力时,传统方案通常需要引入 Elasticsearch 等独立搜索引擎,这会带来架构复杂化、数据同步链路脆弱和运维成本增高等问题。文档数据库 MongoDB 版检索功能通过在数据库实例内部署专用的搜索节点(mongot),实现检索能力与数据库的原生集成。您可以直接使用 MongoDB 标准聚合查询语法完成检索任务,无需维护外部搜索系统。
检索功能提供以下两种检索方式。
系统架构与工作原理
无论使用哪种检索类型,其底层均由统一的检索架构支撑。文档数据库 MongoDB 版支持副本集和分片集群两种架构,检索功能在此架构基础上通过增加独立的 mongot 节点实现搜索能力的扩展。mongot 是基于 Apache Lucene 构建的索引与查询执行引擎,专门用于支持 MongoDB Search 和 Vector Search。
- 架构示意图
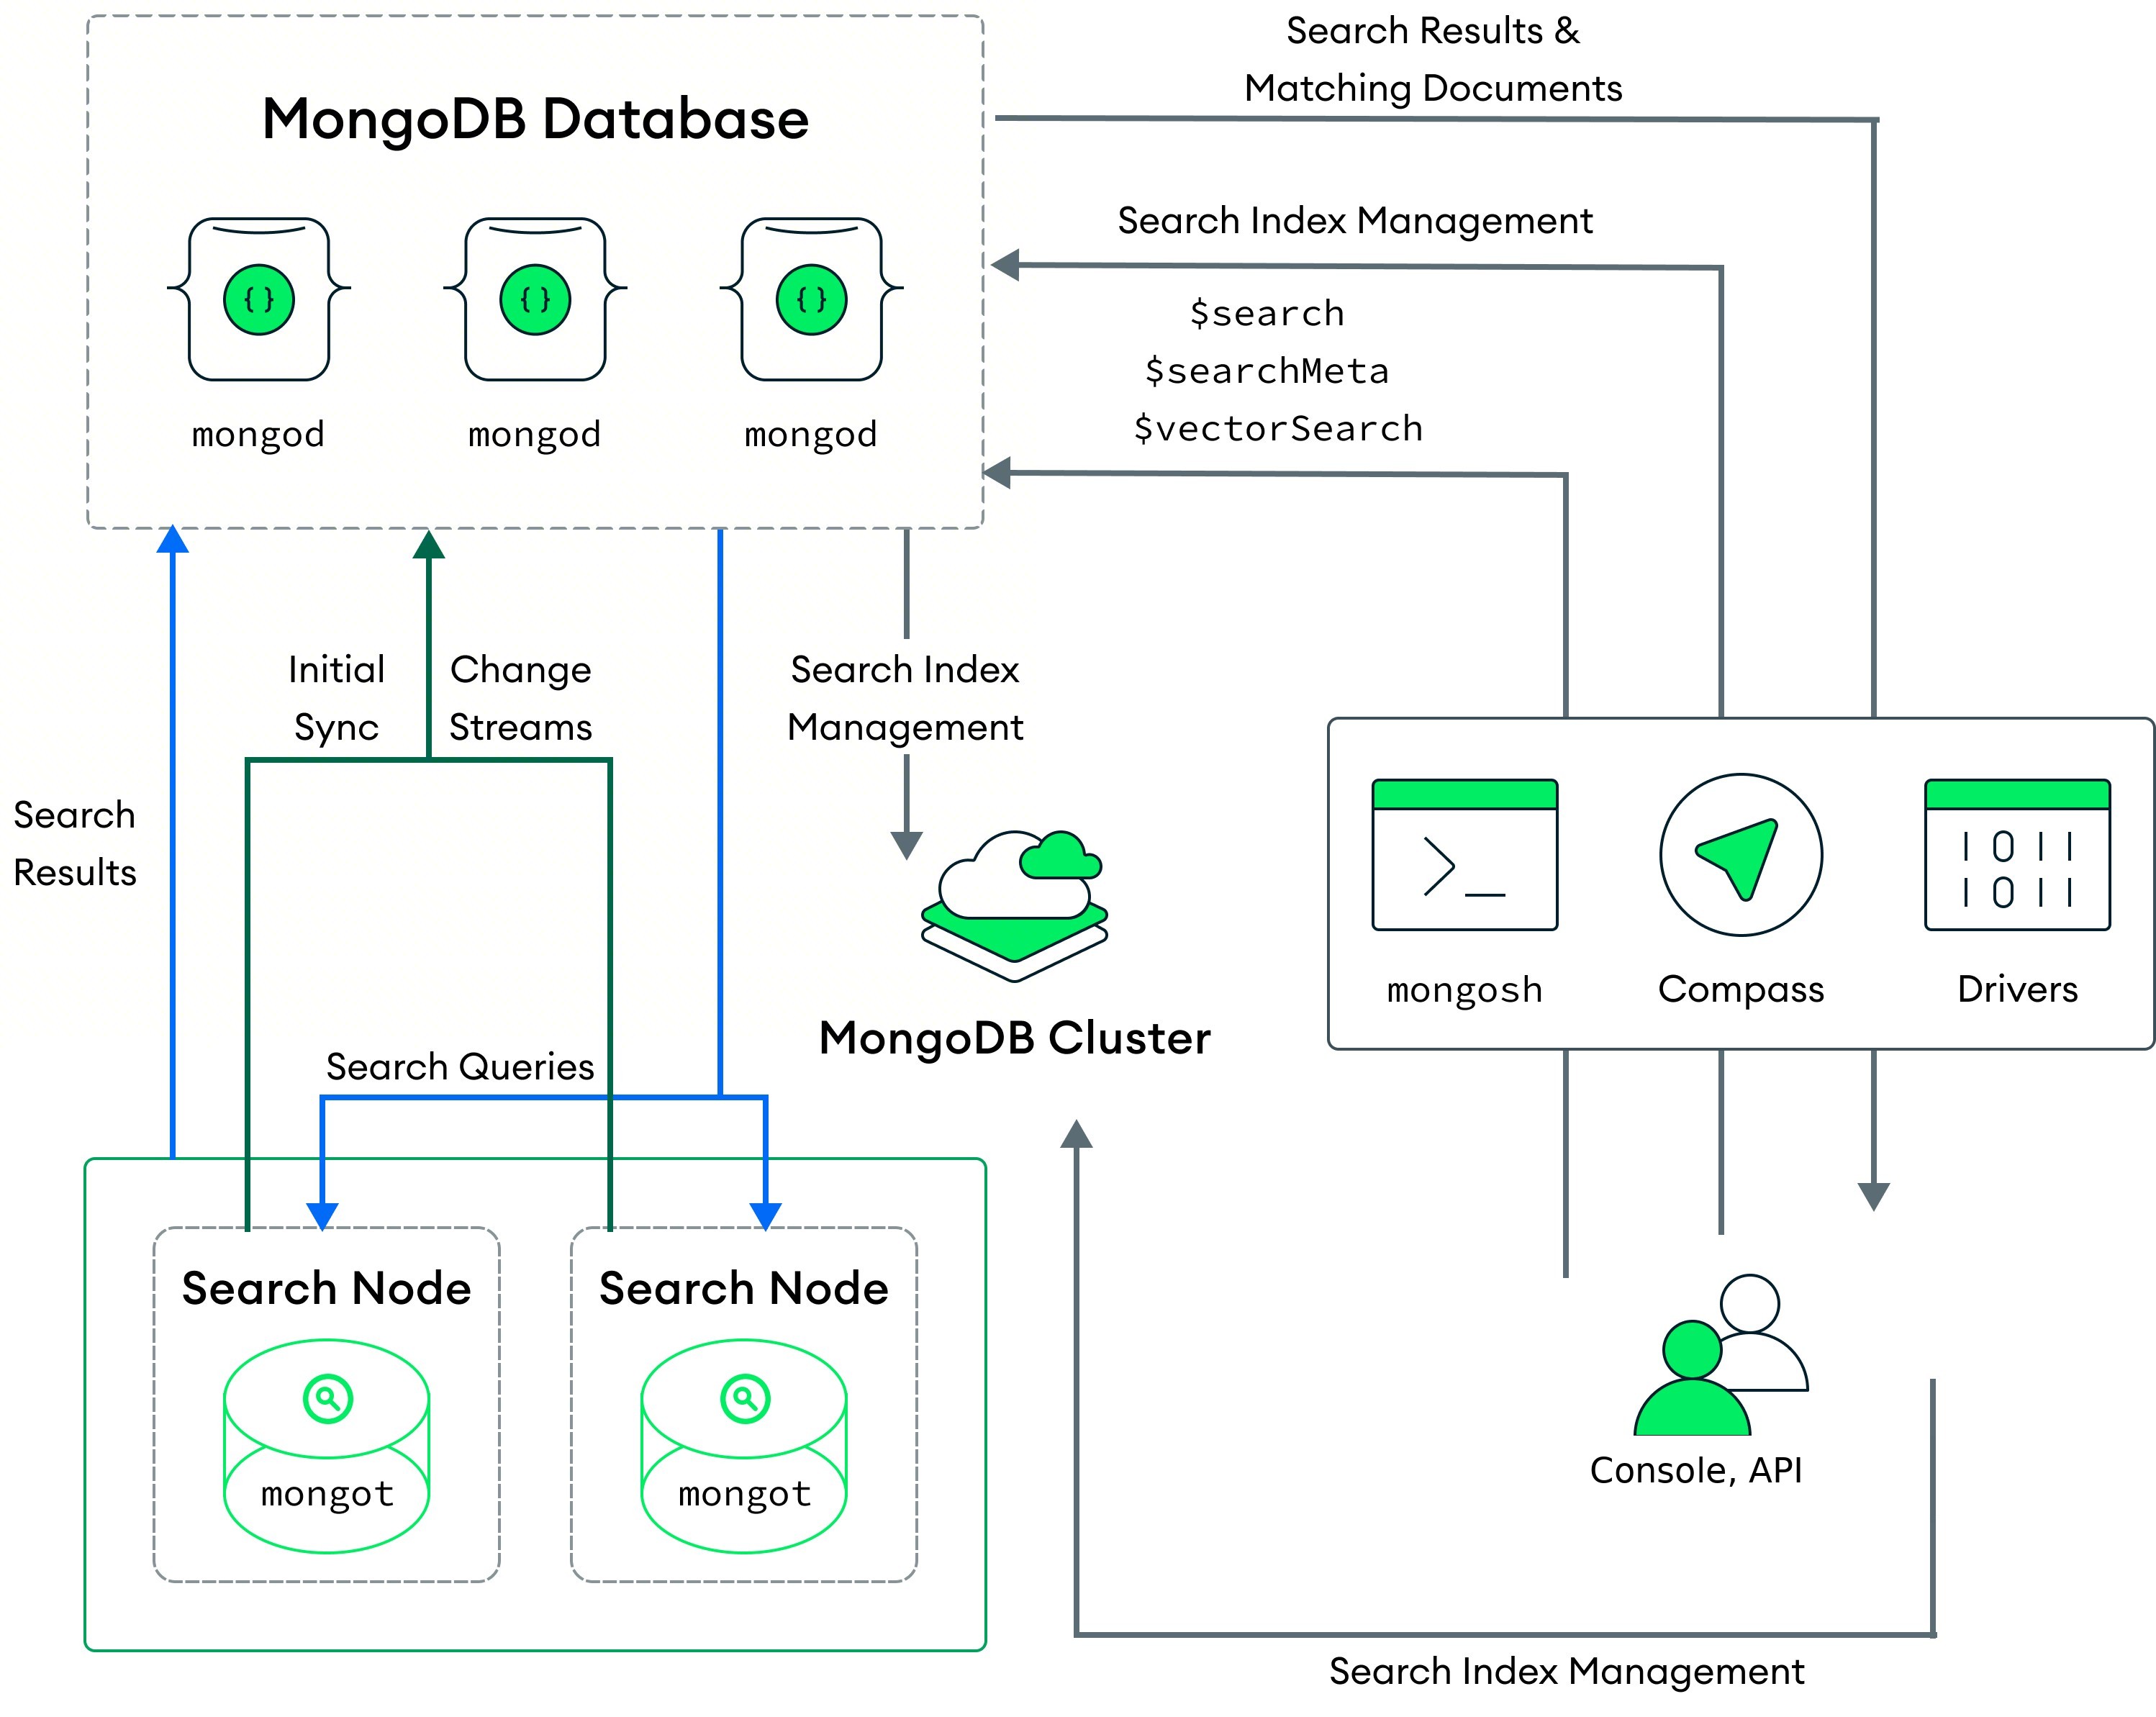 核心组件与职责
-
- 数据同步机制
- mongot 通过 Change Stream(MongoDB 的变更流机制)异步订阅 mongod 的数据变更,实时更新索引,确保最终一致性。检索负载运行于独立的 mongot 节点上,不会对核心数据库的事务处理性能产生影响。
- 请求处理路径
- 您通过 mongosh 或其他 MongoDB 官方驱动发起检索聚合查询。mongos(分片集群)或 mongod(副本集)接收该查询后,将搜索阶段转发至 mongot 节点执行。mongot 完成搜索后,将匹配文档的标识与相关性评分返回给接收请求的代理节点,由该节点完成完整文档的读取、与普通查询结果的合并,最终将统一的结果集返回给您。整个路由和执行过程对应用完全透明。您只需通过标准的聚合语法编写检索语句,无需关心请求如何分发、数据如何合并等内部细节,也无需为检索功能维护额外的连接或 API。
使用限制
使用检索功能前,请注意以下约束条件。
注意
针对分片集群实例,如果对已有 Search 索引的集合进行分片,分片索引构建期间可能遇到短暂的不完整搜索结果。为已有 Search 索引的分片集合添加新分片时,搜索查询可能返回不完整结果,直至新分片完成初始同步。
使用流程
检索功能依靠 Search 索引实现,因此您需要在执行检索前预先创建好索引。以下按任务类型分别介绍索引创建与检索执行的完整步骤。
创建向量索引
向量索引用于支持语义相似性搜索。建议在确认索引状态变为 READY 后再执行搜索。
使用向量搜索功能前,您需要先确定向量的生成方式:
- 自动:在创建索引时指定要向量化的文本字段和模型,MongoDB 自动完成向量的生成、存储与更新,查询时自动为查询文本生成向量。您无需编写向量生成代码,也无需维护向量与源数据的同步。具体操作步骤,请参见创建 Auto Embedding 向量索引。
- 手动:自行调用嵌入模型生成向量,与原始数据一同写入,查询时自行生成查询向量。
下文以手动方式为例,介绍从向量准备到搜索的完整操作流程。
- 准备向量数据
- 业务代码中需引入 LLM Embedding 模型,将待检索的数据转换为向量数组后存储。向量维度不得超过 8192,且必须与后续索引定义中的 numDimensions 一致。
- 创建索引
- 使用 createSearchIndexes() 方法创建向量索引,核心定义结构如下。
-
- 参数说明
-
- 执行搜索
- 在聚合管道中使用 $vectorSearch 阶段。
说明
向量搜索支持近似最近邻(ANN,Approximate Nearest Neighbor)和精确最近邻(ENN,Exact Nearest Neighbor)两种搜索模式。ANN 搜索速度快,适用于大数据集;ENN 搜索精度高,但计算开销大。您可以通过 exact 参数控制搜索模式。
-
- 参数说明
-
- 您也可以通过 $search 阶段的 vectorSearch 操作符实现。
创建全文索引
全文索引用于对集合中已存储的文本字段内容进行关键词检索。
- 创建索引
- 使用 createSearchIndexes() 方法创建 Search 索引。以下示例创建了一个名为 full_text_index 的索引,并通过 mappings.dynamic: true 让 MongoDB 自动为集合中的所有字段建立索引。
-
- 参数说明
-
- 执行搜索
- 在聚合管道中使用 $search 阶段的 text 操作符。
注意
$search 阶段必须是其所在聚合管道中的第一个阶段。
-
- 参数说明
-
完整示例
以下 JSON 代码段展示了从连接数据库、创建向量索引到执行向量搜索的完整流程(以 Node.js 驱动为例)。您可以将示例中的占位符(如 <连接字符串>)替换为实际值。
注意
索引创建是一个异步操作,需要一定时间完成,建议在确认索引状态变为运行中后再执行搜索。
相关 API
最近更新时间:2026.10.13 19:43:53
这个页面对您有帮助吗?
有用
有用
无用
无用