云搜索服务
云搜索服务
云搜索服务


文档指南
请输入


用户指南
实例管理
可视化配置
插件管理
搜索管理
可观测
Cerebro 管理
任务中心
Logstash 用户指南
最佳实践
连接实例
数据集成
应用构建
API 参考
实例查询
实例管理
- 文档首页
 云搜索服务最佳实践应用构建基于云搜索服务和 Doubao-embedding-vision 模型构建图文检索应用
 复制全文
 下载 pdf
基于云搜索服务和 Doubao-embedding-vision 模型构建图文检索应用
 文档反馈
 问问助手
Doubao-embedding-vision 模型能够将图片和文本映射到统一的向量空间,实现跨模态语义理解。本文介绍如何使用云搜索服务和 Doubao-embedding-vision 模型完成图片向量化、数据索引和图文检索,快速构建支持图片搜图片、文本搜图片等能力的图文检索应用。
背景信息
图文检索在电商、广告、设计、搜索引擎等热门领域被广泛应用。常见的图文检索包括以图搜图和以文搜图,用户通过输入文字描述或上传图片就可以在海量的图片库中快速找到同款或者相似图片。
输入的文本描述和图片作为检索对象,分别对 image 和 text 进行特征提取,并在模型中对文本和图片建立相关联系,然后在海量图片数据库进行特征向量检索,返回与检索对象最相关的记录集合。其中特征提取部分采用 CLIP 模型,向量检索采用火山引擎云搜索服务在海量图片特征中进行快速搜索。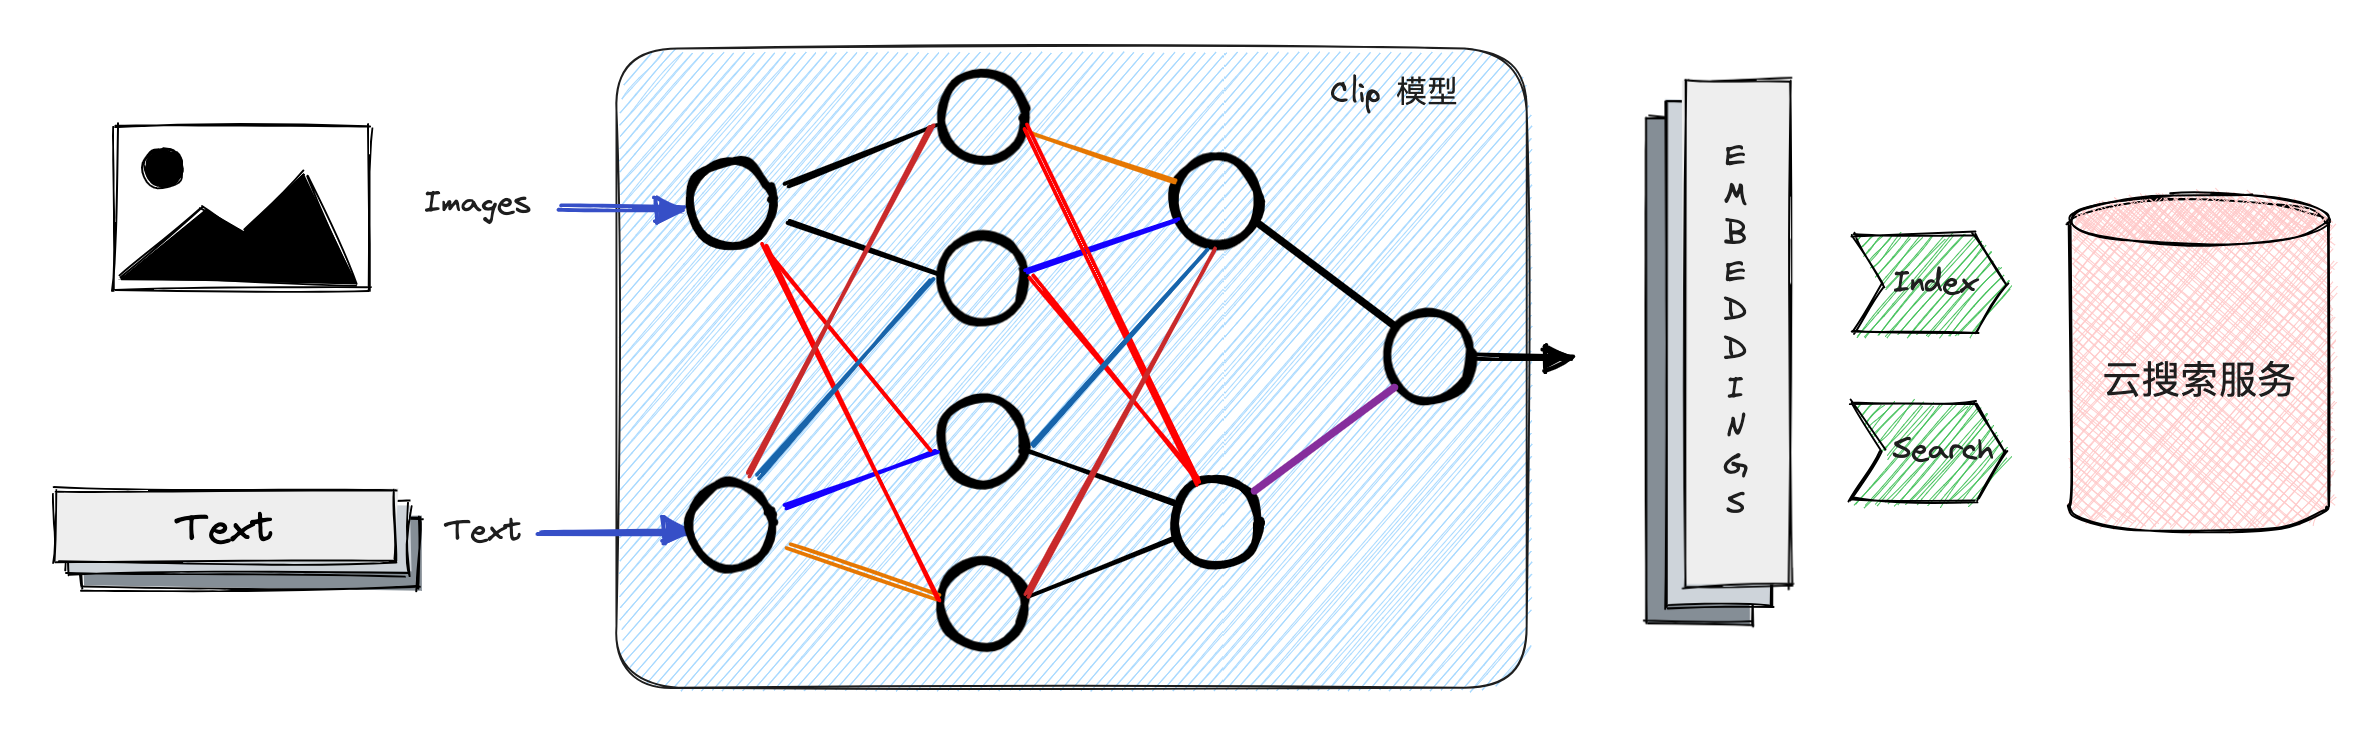
前提条件
已创建用于存储图片的 TOS 存储桶和文件夹,本文示例中使用的存储桶名称为 doc-test,Endpoint 域名节点为 tos-cn-beijing.ivolces.com,图片存放路径为 picture/image_temp。具体操作,请参见创建存储桶和创建文件夹。图片访问权限需要指定为公共读或者是携带签名的链接。
创建资源
创建 OpenSearch 实例
本文以 1000 万张图片 为例,采用 DiskANN + RaBitQ 索引方案,推荐使用以下实例规格。
测试场景 | 产品 | 配置项 | 推荐规格 |
测试场景 | 产品 | 配置项 | 推荐规格 |
图片规模:1000 万张。 Embedding 模型:Doubao-vision-embedding, 2048 维。 | 云搜索服务 | 专有主节点 | 3 * ex.x2.large (4c8g20G PL0) |
| | 数据节点 | 3 * es.x8.xlarge (8c64g + 800G FlexPL) |
| | Dashboard | 1 * kibana.x2.medium (2c4g) |
在 ContextSearch 中使用 Doubao-embedding-vision 模型
- 在 ContextSearch 服务中查看 Doubao-embedding-vision 模型的调用示例,并获取 model 字段的值。具体操作,请参见查看推理服务。
- 此外,您还可以在推理服务的监控页签查看单次请求 token 输入数量。
- 创建并查看用于调用模型的 API Key。具体操作,请参见创建 API Key。
部署图文检索应用
创建 OpenSearch 索引
- 登录实例可视化工具 Dashboards。具体操作,请参见登录 Kibana/Dashboards。
- 在左侧导航栏选择 Management > Dev Tools。
- 在 Dev Tools 中,创建 OpenSearch 索引,代码如下。
- PUT imagesearch{"settings": {"index": {"default_pipeline": "multimodal_remote_embedding","refresh_interval": "60s","knn": "true"},"knn.algo_param.diskann.store_strategy": "MEMORY","knn.algo_param.diskann.distance_strategy": "MULTI_BITS","knn.algo_param.diskann.sl": 200,"number_of_replicas": 0,"number_of_shards": "3"},"mappings": {"properties": {"id": {"type": "keyword"},"vector_source_image": {"type": "keyword"},"description": {"type": "text"},"vector": {"type": "knn_vector","dimension": 2048,"method": {"name": "diskann","space_type": "cosinesimil","engine": "diskann","parameters": {"R": 64,"L": 32,"quant_type": "rabitq","rabitq_centers": 64}}}}}}
- 配置 DiskANN + RaBitQ 向量引擎集群,代码如下。
- PUT _cluster/settings{"persistent": {"index.knn.algo_param.diskann.store_strategy": "MEMORY","index.knn.algo_param.diskann.distance_strategy": "MULTI_BITS","index.knn.algo_param.diskann.sl": 200}}
- 详细信息,请参见使用 DiskANN 向量引擎。
创建 ingest pipeline
创建 ingest pipeline,需要指定使用的 Image Embedding 模型,可以将指定字段(图片信息)转换为向量后嵌入回去。
执行以下命令,创建 ID 为 image_remote_embedding 的 ingest pipeline。
说明
创建 ingest pipeline 时,请注意填写以下信息:
- Authorization:设置为您创建的用于调用模型的 API Key。
- model:设置从 Doubao-embedding-vision 模型服务的调用信息中获取的 model 字段的值。
- field_map 中的定义表示 description 字段,vector_source_image 图片内容将会被向量化后存储到 vector 字段中。
PUT _ingest/pipeline/multimodal_remote_embedding
{
"description": "image/text embedding pipeline for remote inference",
"processors": [
{
"remote_multimodal_embedding": {
"remote_config": {
"method": "POST",
"url": "https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal",
"params": {
},
"headers": {
"Content-Type": "application/json",
"Authorization": "Bearer API KEY"
},
"advance_request_body": {
"model": "ep-xxx-xxx"
}
},
"field_map": {
"text": "description",
"image": "vector_source_image",
"embedding": "vector"
}
}
}
]
}
如涉及多个向量化字段,参考以下代码。
PUT _ingest/pipeline/multimodal_remote_embedding
{
"description": "image/text embedding pipeline for remote inference",
"processors": [
{
"remote_multimodal_embedding": {
"remote_config": {
"method": "POST",
"url": "https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal",
"params": {
},
"headers": {
"Content-Type": "application/json",
"Authorization": "Bearer API KEY"
},
"advance_request_body": {
"model": "ep-xxx-xxx"
}
},
"field_map": {
"text": "description",
"image": "vector_source_image",
"embedding": "vector"
}
}
},
{
"remote_multimodal_embedding": {
"remote_config": {
"method": "POST",
"url": "https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal",
"params": {
},
"headers": {
"Content-Type": "application/json",
"Authorization": "Bearer API KEY"
},
"advance_request_body": {
"model": "ep-xxx-xxx"
}
},
"field_map": {
"text": "description_2",
"image": "vector_source_image_2",
"embedding": "vector_2"
}
}
}
]
}
创建 search pipeline
执行以下命令,创建 search pipeline。
PUT _search/pipeline/multimodal_embedding_search_pipeline
{
"description": "image/text embedding pipeline for remote inference",
"request_processors": [
{
"remote_multimodal_embedding": {
"remote_config":
{
"method": "POST",
"url": "https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal",
"params": {},
"headers":
{
"Content-Type": "application/json",
"Authorization": "Bearer API KEY"
},
"advance_request_body":
{
"model": "ep-xxx-xxx"
}
}
}
}
]
}
结果验证
写入数据
执行以下命令,将 TOS Bucket 中的图片写入到 imagesearch 索引中。
POST _bulk
{ "index" : { "_index" : "imagesearch" } }
{ "id": "0a655b1f2c18632a534796bbf46a4ff7", "vector_source_image" : "https://doc-test.tos-cn-beijing.volces.com/picture/image_temp/0a655b1f2c18632a534796bbf46a4ff7.jpg","description":"图片中商品描述" }
{ "index" : { "_index" : "imagesearch" } }
{ "id": "0a6854edd10ed7bf0aea33f49f6bf340", "vector_source_image" : "https://doc-test.tos-cn-beijing.volces.com/picture/image_temp/0a6854edd10ed7bf0aea33f49f6bf340.jpg", "description":"图片中商品描述" }
执行以下命令,检查写入的数据。
GET imagesearch/_search
{
"query": {
"match_all": {}
}
}
搜索数据
支持通过 search pipeline、kNN 或 Java client 查询。
通过 search pipeline 查询
通过 kNN 查询
通过 Java client 查询
查询时支持传入文本或图片作为检索条件:
- query_text:文本查询内容。
- query_image:图片查询内容,支持以下两种格式:
- 可公开访问的图片 URL。
- Base64 编码的图片,格式为 data:image/{图片格式};base64,{图片 Base64 编码}。
query_text 和 query_image 可单独使用,也可同时传入。
GET imagesearch/_search?search_pipeline=multimodal_embedding_search_pipeline
{
"size": 20,
"_source": {
"includes": ["id", "description", "vector_source_image"]
},
"query": {
"remote_multimodal_neural": {
"vector": {
"query_text": "文字检索内容",
"query_image": "https://doc-test-1.tos-cn-beijing.volces.com/images/000000039769.jpg",
"k": 20
}
}
}
}
GET imagesearch/_search
{
"size": 20,
"_source": {
"includes": ["id", "description", "vector_source_image"]
},
"query": {
"knn": {
"vector": {
"vector": [1.0,2.0,3.0,...,8.0],
"k": 20
}
}
}
}
为索引设置默认的 search pipeline。
PUT /imagesearch/_settings
{
"settings": {
"search.default_pipeline": "multimodal_embedding_search_pipeline"
}
}
创建 search_template。
PUT _scripts/multimodal_search_template
{
"script": {
"lang": "mustache",
"source": {
"_source": {
"includes": [
"id",
"description",
"item_info"
]
},
"size": "{{size}}",
"from": "{{from}}",
"query": {
"remote_multimodal_neural": {
"vector": {
"query_text": "{{keyword}}",
"query_image": "{{image}}",
"k": "{{k}}"
}
}
}
}
}
}
添加 maven 依赖。
<dependency>
<groupId>org.opensearch.client</groupId>
<artifactId>opensearch-rest-high-level-client</artifactId>
<version>2.9.0</version>
</dependency>
<dependency>
<groupId>com.fasterxml.jackson.core</groupId>
<artifactId>jackson-core</artifactId>
<version>2.15.2</version>
</dependency>
<dependency>
<groupId>com.fasterxml.jackson.core</groupId>
<artifactId>jackson-databind</artifactId>
<version>2.12.7.2</version>
</dependency>
示例代码如下。
通过 search pipeline 查询
通过 kNN 查询
import org.apache.http.HttpHost;
import org.apache.http.auth.AuthScope;
import org.apache.http.auth.UsernamePasswordCredentials;
import org.apache.http.client.CredentialsProvider;
import org.apache.http.conn.ssl.NoopHostnameVerifier;
import org.apache.http.impl.client.BasicCredentialsProvider;
import org.apache.http.nio.conn.ssl.SSLIOSessionStrategy;
import org.apache.http.ssl.SSLContextBuilder;
import org.opensearch.action.search.SearchRequest;
import org.opensearch.action.search.SearchResponse;
import org.opensearch.client.*;
import org.opensearch.script.ScriptType;
import org.opensearch.script.mustache.SearchTemplateRequest;
import org.opensearch.script.mustache.SearchTemplateResponse;
import javax.net.ssl.SSLContext;
import java.util.Arrays;
import java.util.HashMap;
import java.util.List;
import java.util.Map;
public class Main {
RestHighLevelClient initRestHighLevelClientWithCA(List<HttpHost> hosts, String user, String password) throws Exception {
if (hosts == null || hosts.isEmpty()) {
throw new IllegalArgumentException("invalid empty hosts");
}
// add more parameters check here
// 身份信息相关
final CredentialsProvider provider = new BasicCredentialsProvider();
provider.setCredentials(AuthScope.ANY, new UsernamePasswordCredentials(user, password));
SSLContext sslContext = new SSLContextBuilder().loadTrustMaterial(null, (x509Certificates, s) -> true).build(); // 跳过 SSL 证书校验
RestClientBuilder builder = RestClient.builder(hosts.toArray(new HttpHost[0]))
.setHttpClientConfigCallback(httpClientBuilder -> httpClientBuilder
.setDefaultCredentialsProvider(provider) // 设置鉴权凭证
.setSSLStrategy(new SSLIOSessionStrategy(sslContext, NoopHostnameVerifier.INSTANCE))
) // 跳过 HostName 校验
.setRequestConfigCallback(requestBuilder -> requestBuilder
.setConnectionRequestTimeout(5000) // 从 connect 池中获取 connect 最大等待时间,根据实际情况调整
.setSocketTimeout(60000) // 请求超时时间,根据实际情况调整
.setConnectTimeout(5000)); // 建连超时时间,根据实际情况调整
return new RestHighLevelClient(builder);
}
public static void main(String[] args) throws Exception {
RestHighLevelClient client = new Main().initRestHighLevelClientWithCA(Arrays.asList(new HttpHost("{host}", 9200, "https")), "{username}", "{password}");
SearchTemplateRequest searchTemplateRequest = new SearchTemplateRequest();
searchTemplateRequest.setRequest(new SearchRequest().indices("imagesearch"));
searchTemplateRequest.setScriptType(ScriptType.STORED);
searchTemplateRequest.setScript("multimodal_search_template");
Map<String, Object> paramMap = new HashMap<String, Object>() {{
put("from", 0);
put("size", 20);
put("keyword", "猫"); // 不参与搜索的字段设置为空即可,eg: ""
put("image", "https://doc-test-1.tos-cn-beijing.volces.com/images/000000039769.jpg");
put("k", 20);
}};
searchTemplateRequest.setScriptParams(paramMap);
SearchTemplateResponse searchTemplateResponse = client.searchTemplate(searchTemplateRequest, RequestOptions.DEFAULT);
client.close();
SearchResponse response = searchTemplateResponse.getResponse();
Arrays.stream(response.getHits().getHits()).forEach(item -> {
System.out.println(item);
});
}
}
import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import org.apache.http.HttpHost;
import org.apache.http.auth.AuthScope;
import org.apache.http.auth.UsernamePasswordCredentials;
import org.apache.http.client.CredentialsProvider;
import org.apache.http.conn.ssl.NoopHostnameVerifier;
import org.apache.http.impl.client.BasicCredentialsProvider;
import org.apache.http.nio.conn.ssl.SSLIOSessionStrategy;
import org.apache.http.ssl.SSLContextBuilder;
import org.opensearch.action.search.SearchRequest;
import org.opensearch.action.search.SearchResponse;
import org.opensearch.client.*;
import org.opensearch.index.query.WrapperQueryBuilder;
import org.opensearch.script.ScriptType;
import org.opensearch.script.mustache.SearchTemplateRequest;
import org.opensearch.script.mustache.SearchTemplateResponse;
import org.opensearch.search.builder.SearchSourceBuilder;
import javax.net.ssl.SSLContext;
import java.util.*;
public class Main {
private static final ObjectMapper objectMapper = new ObjectMapper();
RestHighLevelClient initRestHighLevelClientWithCA(List<HttpHost> hosts, String user, String password) throws Exception {
if (hosts == null || hosts.isEmpty()) {
throw new IllegalArgumentException("invalid empty hosts");
}
// add more parameters check here
// 身份信息相关
final CredentialsProvider provider = new BasicCredentialsProvider();
provider.setCredentials(AuthScope.ANY, new UsernamePasswordCredentials(user, password));
SSLContext sslContext = new SSLContextBuilder().loadTrustMaterial(null, (x509Certificates, s) -> true).build(); // 跳过 SSL 证书校验
RestClientBuilder builder = RestClient.builder(hosts.toArray(new HttpHost[0]))
.setHttpClientConfigCallback(httpClientBuilder -> httpClientBuilder
.setDefaultCredentialsProvider(provider) // 设置鉴权凭证
.setSSLStrategy(new SSLIOSessionStrategy(sslContext, NoopHostnameVerifier.INSTANCE))
) // 跳过 HostName 校验
.setRequestConfigCallback(requestBuilder -> requestBuilder
.setConnectionRequestTimeout(5000) // 从 connect 池中获取 connect 最大等待时间,根据实际情况调整
.setSocketTimeout(60000) // 请求超时时间,根据实际情况调整
.setConnectTimeout(5000)); // 建连超时时间,根据实际情况调整
return new RestHighLevelClient(builder);
}
public static void main(String[] args) throws Exception {
System.out.println("Hello world!");
RestHighLevelClient client = new Main().initRestHighLevelClientWithCA(Arrays.asList(new HttpHost("xxx", 9200, "https")), "xxx", "xxx");
// 根据doc id 字段查询原始向量
SearchRequest searchRequest1 = new SearchRequest();
SearchSourceBuilder searchSourceBuilder1 = new SearchSourceBuilder();
searchSourceBuilder1.query(new WrapperQueryBuilder(
"{\n" +
" \"term\": {\n" +
" \"id\": \"0a655b1f2c18632a534796bbf46a4ff7\"\n" +
" }\n" +
" }"
));
searchRequest1.indices("imagesearch").source(searchSourceBuilder1);
SearchResponse docRes = client.search(searchRequest1, RequestOptions.DEFAULT);
String docJson = Arrays.stream(docRes.getHits().getHits()).findFirst().get().getSourceAsString();
JsonNode docJsonRoot = objectMapper.readTree(docJson);
// 查询向量
List<Double> vecList = new ArrayList<>();
for (JsonNode vecNode : docJsonRoot.get("vector")) {
vecList.add(vecNode.asDouble());
}
// 直接用 knn 查询
SearchRequest searchRequest = new SearchRequest();
SearchSourceBuilder searchSourceBuilder = new SearchSourceBuilder();
searchSourceBuilder.query(new WrapperQueryBuilder(String.format("{\n" +
" \"knn\": {\n" +
" \"vector\": {\n" +
" \"vector\": " + objectMapper.writeValueAsString(vecList) + ",\n" +
" \"k\": 20\n" +
" }\n" +
" }\n" +
"}")
));
searchRequest.indices("imagesearch").source(searchSourceBuilder);
SearchResponse responseKnn = client.search(searchRequest, RequestOptions.DEFAULT);
System.out.println(responseKnn);
}
}
数据量增加时调整分片数
当索引中的数据量持续增长,需要增加分片数时,可通过 _reindex API 将数据迁移到新的索引,并为新索引配置更多分片。
- 获取原索引 settings 和 mappings。
- GET /{原索引名称}/_settings?prettyGET /{原索引名称}/_mapping?pretty
- 根据获取到的 settings 和 mappings 创建新索引。创建时,仅保留必要的配置项,无需复制系统自动生成的配置(例如 creation_date、uuid、version 等),并根据业务需要修改 number_of_shards。
- PUT /新索引名称{"settings": {"index": {"number_of_shards": 60,...}...},"mappings": { ... } # 复制原索引的 mapping}
- 使用 _reindex API 将原索引中的数据迁移至新索引。
- POST /_reindex?wait_for_completion=false{"source": {"index": "{原索引名称}"},"dest": {"index": "{新索引名称}"}}
- 迁移完成后,分别统计原索引和新索引的文档数量。
- GET /{原索引名称}/_count{"query": {"match_all": {}}}GET /{新索引名称}/_count{"query": {"match_all": {}}}
- 如果两个索引的文档数量一致,则说明数据已迁移完成。
- 确认业务已完成切换且数据验证无误后,删除原索引。
- DELETE /{原索引名称}
- 为新索引添加与原索引相同的别名,使应用程序无需修改索引名称即可继续访问数据。
- POST /_aliases{"actions": [{ "add": { "alias": "{原索引名称}", "index": "{新索引名称}" } }]}
最近更新时间:2026.07.28 16:11:23
这个页面对您有帮助吗?
有用
有用
无用
无用