You need to enable JavaScript to run this app.
文档中心
云搜索服务

云搜索服务

复制全文
下载 pdf
数据迁移
使用 Logstash 跨集群迁移数据
复制全文
下载 pdf
使用 Logstash 跨集群迁移数据
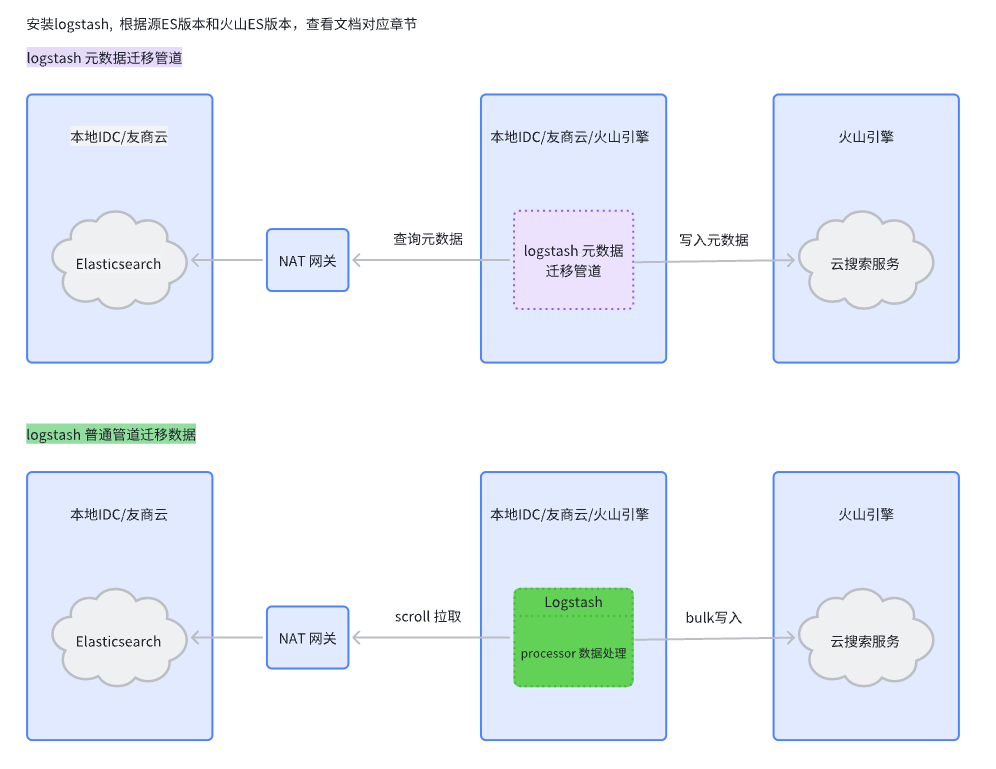
Logstash 是一款开源的数据收集引擎,具备实时管道处理能力,能够同时从多个来源采集数据、转换数据,然后将数据发送到 Elasticsearch 中。本文介绍如何通过 Logstash 进行跨集群的数据迁移。​
前提条件​
已创建 Logstash 实例且 Logstash 实例处于运行中状态。具体操作,请参见创建 Logstash 实例。​
数据迁移流程图​
​​​
注意事项​
在数据迁移之前,请确保源集群、Logstash 服务、目的集群的网络互通。具体操作,请参见使用 SNAT 配置公网访问。​
操作步骤​
  1. 创建并部署元数据迁移管道。具体操作和参数配置,请参见和元数据迁移管道。​
  1. 创建并部署普通管道。具体操作,请参见创建管道。管道配置示例如下。​
  • ​
    input {​
    opensearch {​
    # 源集群 endpoint,不需要加 http 或 https​
    hosts => "源集群链接"​
    # 源集群 basicAuth 鉴权信息(如果存在)​
    user => "源集群用户名"​
    password => "源集群密码"​
    # 支持通配符,"*" 表示所有索引,如果索引多数据量大可以分开配置​
    # "*,-.*" 表示非 "." 开头的所有索引,"." 开头索引通常是系统索引,无需同步​
    index => "源索引名"​
    query => '{ "sort": [ "_doc" ] }'​
    size => 1000​
    # scroll session 保持时间​
    scroll => "5m"​
    docinfo => true​
    # 指定 docinfo 到 @metadata​
    docinfo_target => "@metadata"​
    # HTTP 协议 ssl=>false​
    # HTTPS 协议 ssl=>true 默认跳过证书校验​
    ssl => false​
    # Elasticsearch 6 及以后支持版本配置,不超过源索引分片数,加速 scroll​
    slices => 1​
    }​
    }​
    ​
    # 删除 Logstash 自动添加的字段,可选​
    #filter {​
    # mutate {​
    # remove_field => ["@version", "@timestamp"]​
    # }​
    #}​
    ​
    output {​
    opensearch {​
    # 源实例 endpoint,不需要加 http 或 https​
    hosts => "目标集群链接"​
    # 目标实例 basicAuth 鉴权信息(如果存在)​
    user => "目标集群用户名"​
    password => "目标集群密码"​
    # 与源索引名保持一致​
    index => "%{[@metadata][_index]}"​
    document_id => "%{[@metadata][_id]}"​
    # HTTP 协议 ssl=>false,HTTPS 协议 ssl=>true​
    ssl => false​
    # 当使用 HTTPS 链接时,是否验证 Elasticsearch 服务端证书​
    ssl_certificate_verification => false​
    # ssl_certificate_verification 为 true 时,验证服务端 CA 证书路径,.cer 或 .pem 格式​
    # cacert => "CA 证书路径"​
    }​
    }​
    ​
说明​
  • 若源集群中的数据存在 routing 参数,output 插件中也需配置 routing 字段。​
  1. 查看管道运行状况。具体操作,请参见查询日志和使用调试功能。​
  1. 查看迁移进度。​
  • 执行以下命令,查询集群中全部索引的信息,包括索引的健康情况、状态、名称、UUID、分片数、副本数、文档数量等信息。​
  • ​
    GET /_cat/indices?v​
    ​
  • 您可以通过对比源集群和目标集群的索引和文档数,来判断迁移进度。当索引数相同、文档数趋近相同时,可视为数据迁移完成。​
说明​
  • 迁移任务不会迁移后续增量数据,存量索引文档数趋近相同。​
  • 由于 Elasticsearch 2、Elasticsearch 5 中单个索引支持多个 _type,如果迁移时源索引指定了 _type 或者将不同 _type 拆分到了不同的目标索引,则需分 _type 查看索引迁移进度。您可以在源集群通过 /{索引名}/{_type}/_count 查看指定索引指定 _type 的文档数。​
  1. (可选)迁移增量数据。​
说明​
如果源索引需要增量更新,需注意以下事项:​
  • 文档包含时间字段,标记文档的最后更新时间。​
  • 迁移前记录迁移开始时间,后续用作增量迁移起始时间。​
  • 增量数据的迁移,需在存量迁移完成后开始。​
  • 创建并部署普通管道。具体操作,请参见创建管道。管道 input 插件配置示例如下。​
  • ​
    input {​
    elasticsearch {​
    # 源集群 endpoint,不需要加 http 或 https​
    hosts => "源集群链接"​
    # 源集群 basicAuth 鉴权信息(如果存在)。​
    user => "源集群用户名"​
    password => "源集群密码"​
    # 支持通配符,* 表示所有索引,如果索引多数据量大可以分开配置。​
    # *,-.* 表示非 . 开头的所有索引,. 开头索引通常为系统索引,无需同步。​
    index => "源索引名"​
    # 增量迁移,待迁移索引的 mappings,需有字段区分可以新老数据,最常见的字段是时间字段。​
    # 本示例查询迁移最近 10 分钟的数据。实际迁移时,字段、查询语句需根据业务场景调整。​
    query => '{"query":{"range":{"<my_timestamp_field>":{"gte":"now-10m","lte":"now/m"}}}}'​
    size => 1000​
    # 每 5 分钟执行一次。具体设置参考下述说明。​
    schedule => "*/5 * * * *"​
    # 是否使用 slice scroll 加速迁移,值不超过单索引分片数,Elasticsearch 6 及以后版本才支持配置。​
    # slices => 4​
    # scroll session 保持时间。​
    scroll => "5m"​
    docinfo => true​
    # HTTP 协议 ssl=>false,HTTPS 协议 ssl=>true​
    ssl => false​
    }​
    }​
    ​
说明​
schedule 字段配置:假设单次增量迁移耗时 y 分钟且波动不大,则可以配置查询时间范围为 [当前时间 - (y + 2) 分钟, 当前时间],持续增量迁移时,连续两次任务启动时间差 z 满足 y + 2 > z > y,则连续的 2 次增量迁移数据有重叠,可以保证增量数据不丢失。如果不需要多次执行,删除 schedule 字段即可。​
更多操作​
如需丢弃消息,可参考如下配置。​
​
ruby {​
init => "​
require 'time'​
"​
code => "​
ts = event.get('@timestamp')​
if ts​
# 当前 UTC 日期 00:00:00​
today = Time.now.utc.to_date​
cutoff_date = today - 7​
# 事件日期​
event_date = ts.time.utc.to_date​
if event_date < cutoff_date​
logger.warn('Dropping expired event by date',​
:event_date => ts.to_s,​
:cutoff_date => cutoff_date.to_s​
)​
event.cancel​
end​
end​
"​
}​
​
说明​
  • 以上配置丢弃当前日期前 7 天的数据,满足丢弃条件会输出一条日志。​
  • 写入 Elasticsearch 或 OpenSearch 实例的数据中,需要包含 @timestamp 字段。​
​
​
最近更新时间:2026.04.23 15:38:36
这个页面对您有帮助吗?
有用
有用
无用
无用