全栈可观测平台
全栈可观测平台


文档指南

请输入


- 文档首页
 全栈可观测平台自定义看板数据转换
 复制全文
 下载 pdf
数据转换
 文档反馈
 问问助手
自定义看板提供数据转换能力,支持对数据源查询结果进行排序、合并、重组等处理,使其适合作为图表展示的数据,本文为您介绍如何进行数据转换。
说明
允许配置多条转换规则,但前一次转换的结果将作为后一次转换的输入。
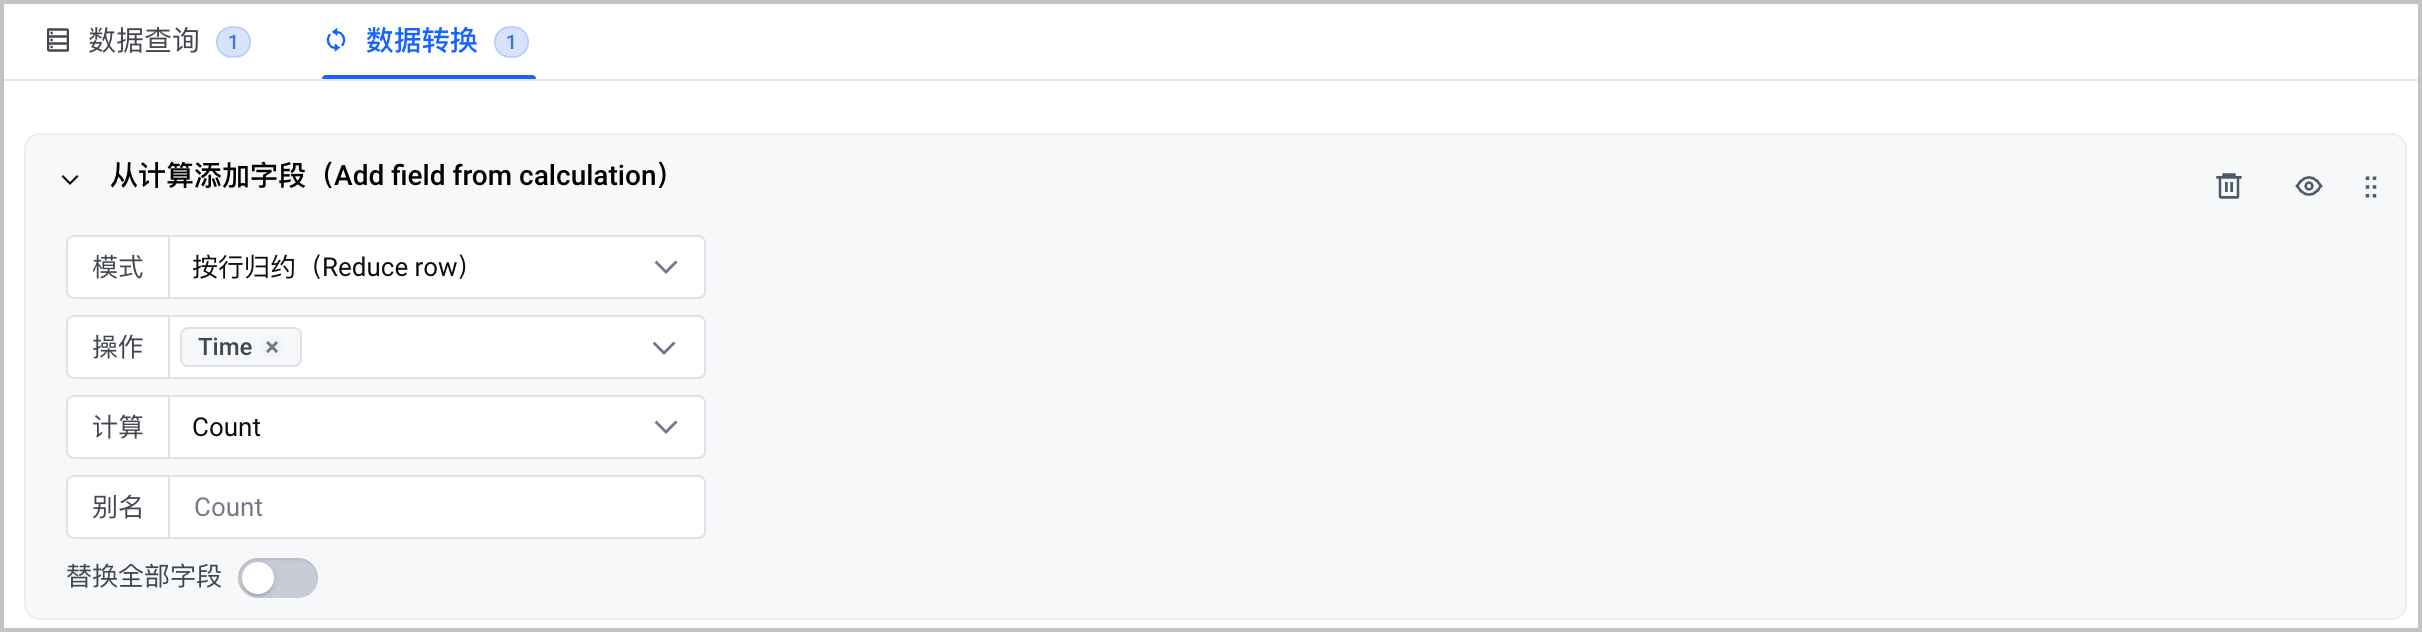
从计算添加字段(Add field from calculation)
基于当前单行已经存在的字段值,通过计算生成全新字段,常用于指标衍生计算、数据单位转换、数据归一化等场景。
该数据转换方式提供二元运算(Binary operation)、一元运算(Unary operation)、按行归约(Reduce row)、行索引(Row index)、累计函数(Cumulative functions)、窗口函数(Window functions)等多种模式,可根据实际场景选择合适的模式。
说明
替换全部字段开关默认关闭,可根据实际需求开启。
- 关闭:完整保留原始数据的所有字段,仅在数据末尾追加新生成的计算字段。适用于需要同时保留原始指标与衍生指标,方便对照溯源的场景。
- 开启:移除所有原始业务字段,仅保留时间、主键等必要索引字段和新生成的计算字段,原始数值或维度字段不再出现在结果中。适用于只关注最终计算结果,需要精简数据源,避免冗余字段干扰图表渲染或表格展示的场景。
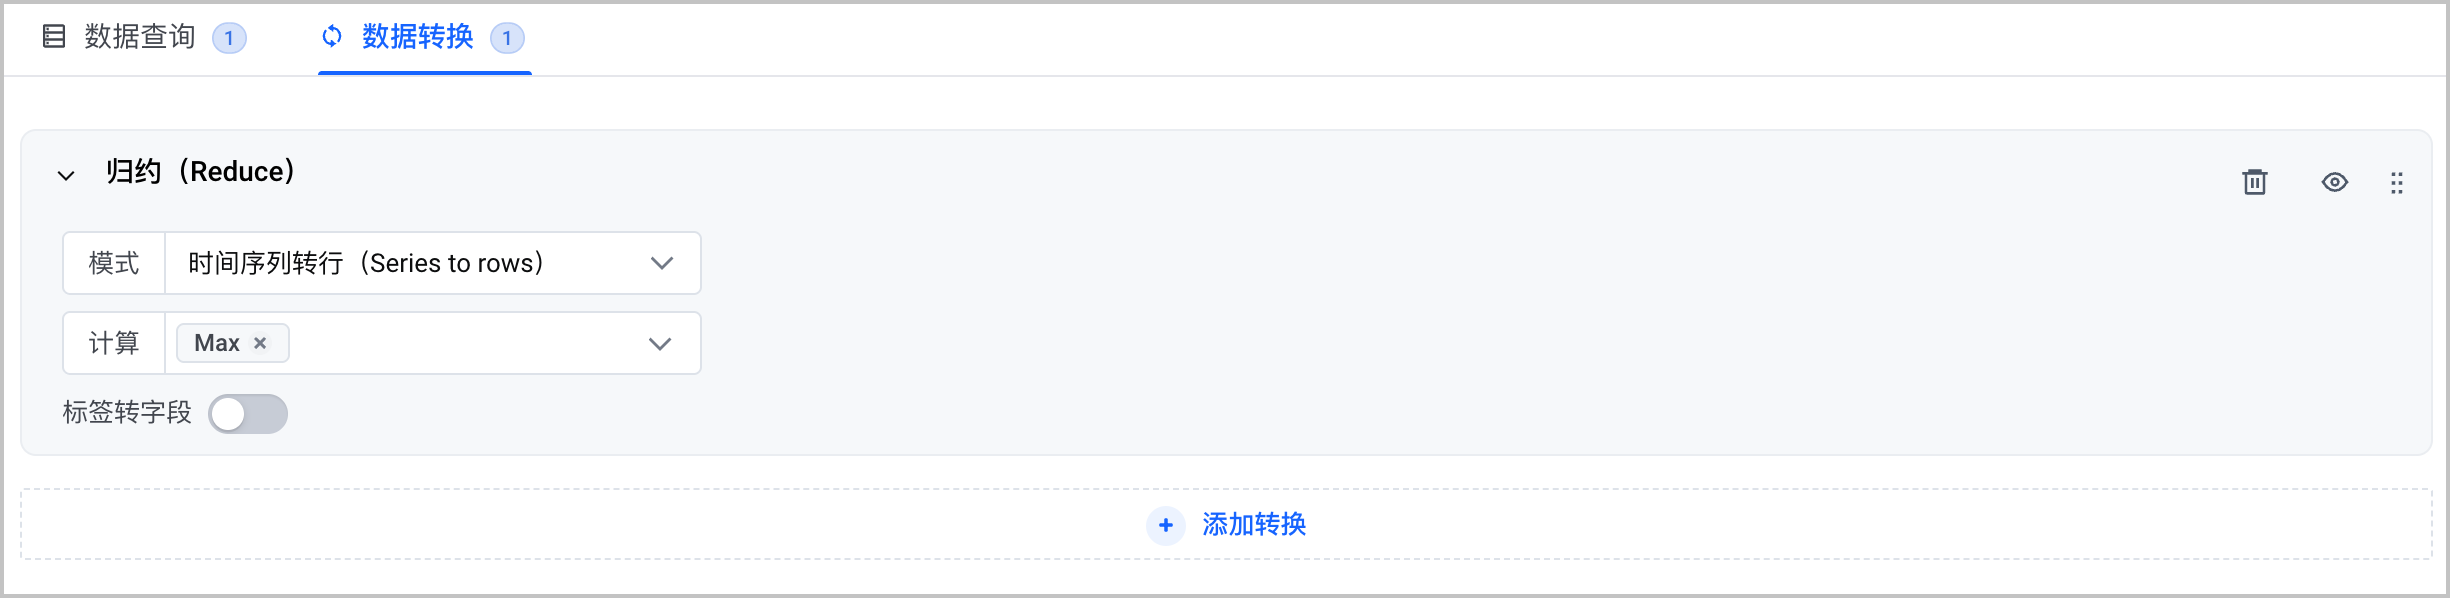
归约(Reduce)
使用最大值、最小值、平均值或最后值等函数,将所有行或数据点归约为单个值。常用于全局总量统计、全局极值提取、单指标汇总等场景。该数据转换方式支持时间序列转行(Series to rows)、归约字段(Reduce fields)两种模式,可根据实际场景选择合适的模式。
说明
标签转字段开关默认关闭,可根据实际需求开启。
- 关闭:归约后仅输出序列标识与聚合计算后的数值结果;原始时序的维度标签(例如:agent_id、instance、tool_name 等)不会拆分为独立列,仅以拼接字符串的形式隐含在序列名称中。适用于仅需简单聚合结果展示,不需要对维度做二次筛选、排序或关联操作的场景。
- 开启:归约后,将原始时序的每一个维度标签都拆分为独立的列字段,同时保留聚合数值列,标签从序列元数据变为结构化的表格字段。适用于需要基于维度做后续数据处理,或表格需要明确展示独立维度列的场景。
数据合并(Merge)
当配置了多条查询语句时,表格 Panel 的默认行为会将不同的查询语句渲染为独立的表格,通过 Panel 底部的下拉选择器进行表格切换。通过配置数据合并可将多条查询结果进行合并。
说明
该配置点击添加即可,无子配置项。当仅配置单条查询语句时,数据合并默认不生效。
数据合并的合并规则为:若两行数据共同的字段相等,则合并成一行,否则分行展示,并将各自不存在的字段置空。示例如下:
- Query A
- Query B
- 合并结果
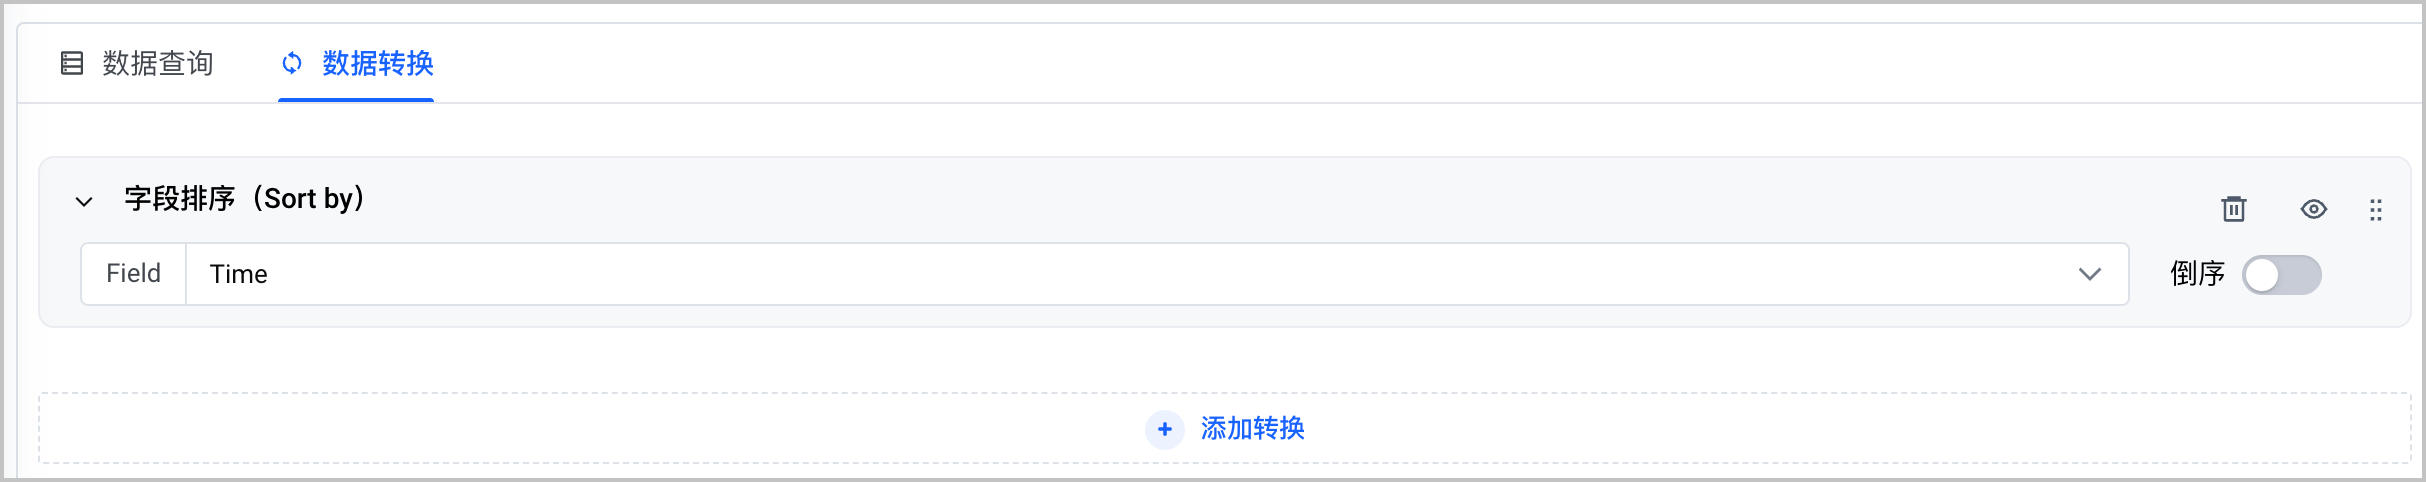
字段排序(Sort by)
字段排序能够定义表格的行排序,可以选择以哪一列的数据为基准排序,支持开启倒序。
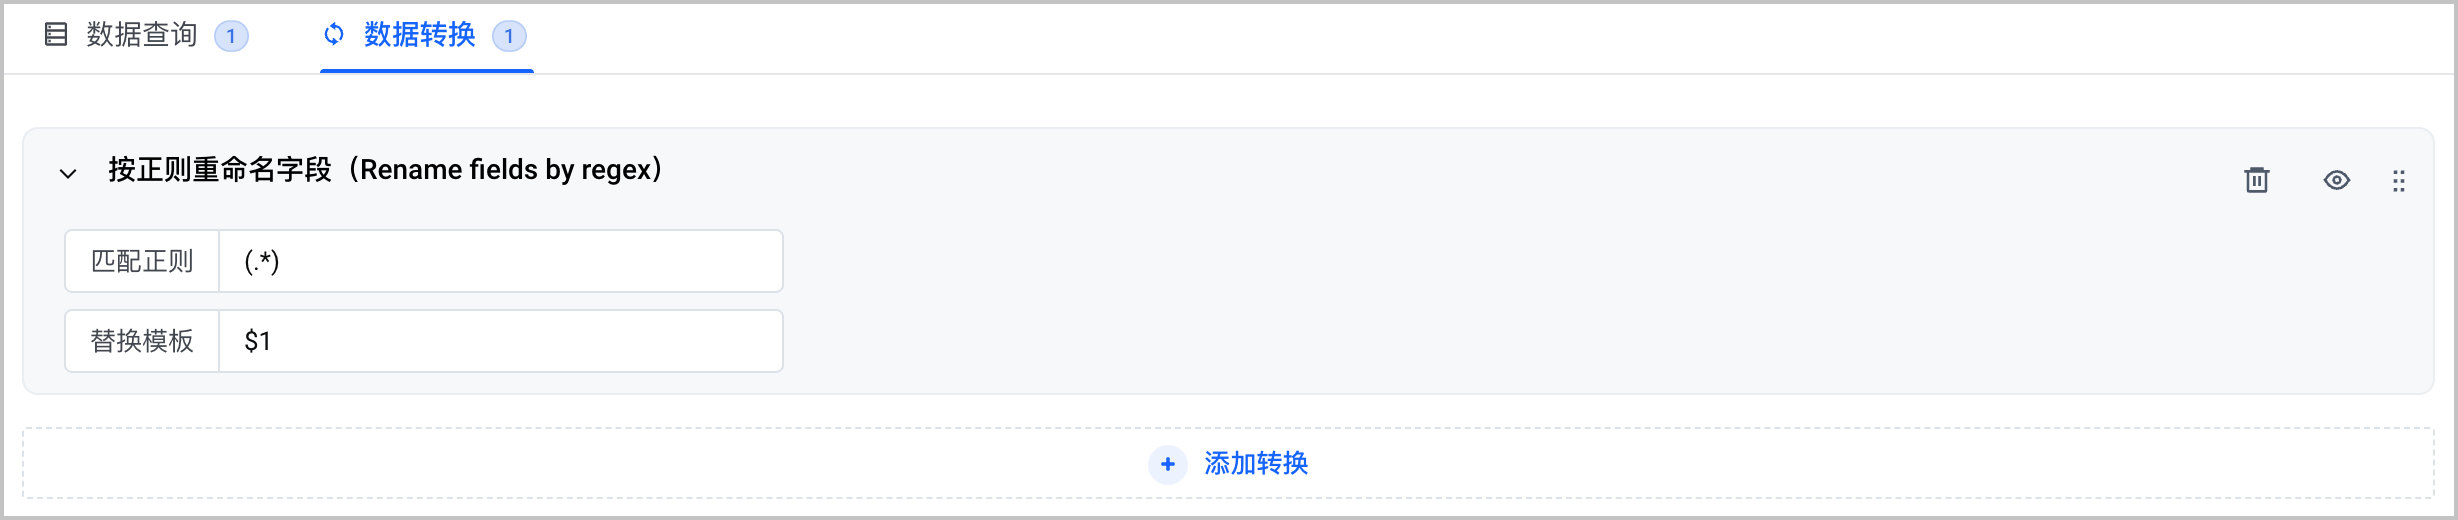
按正则重命名字段(Rename fields by regex)
例如:匹配规则配置为 ^metrics_(.+),替换模板配置为 $1 ,表示删除字段名前缀 metrics_。假设原字段名为 metrics_cpu_usage,使用此规则替换后的字段名为 cpu_usage。
按查询筛选数据(Filter data by query)
通过选择查询条件筛选数据,仅展示符合条件的结果。适用于快速定位目标数据、缩小结果范围等场景。未选择查询条件时,默认展示全部数据。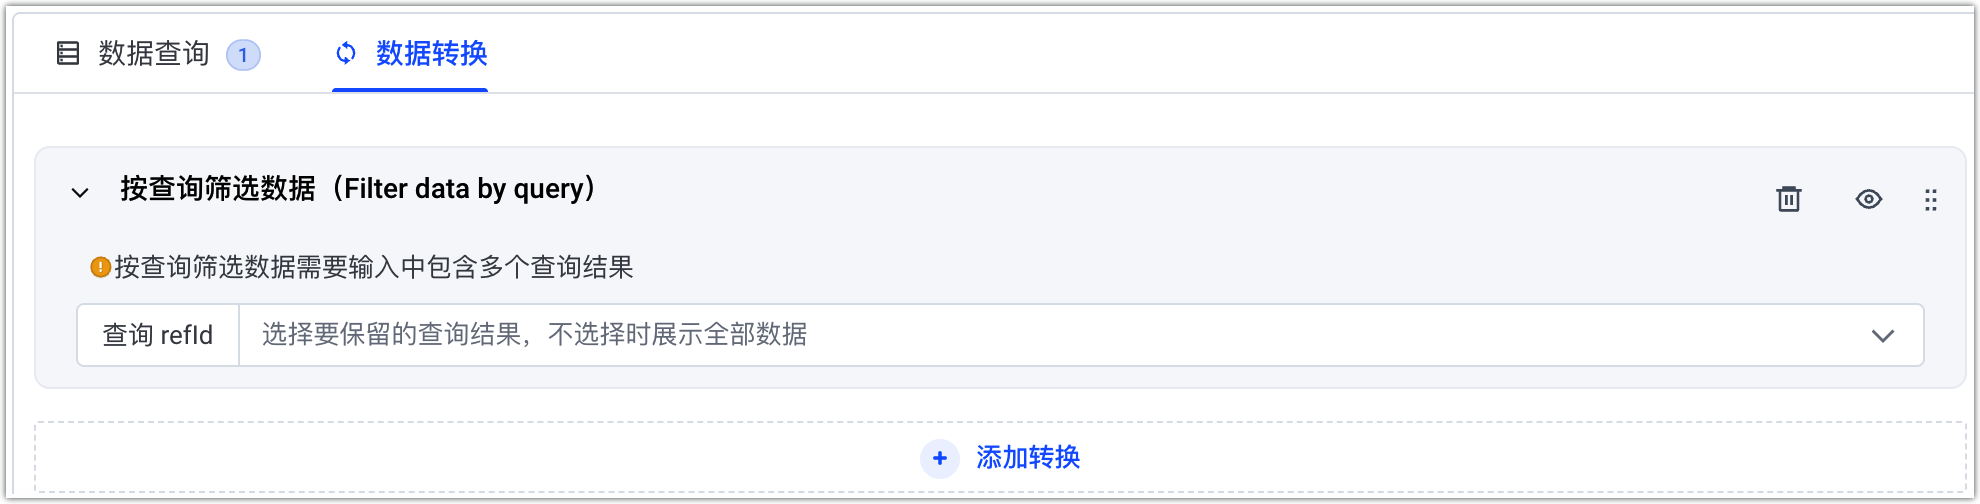
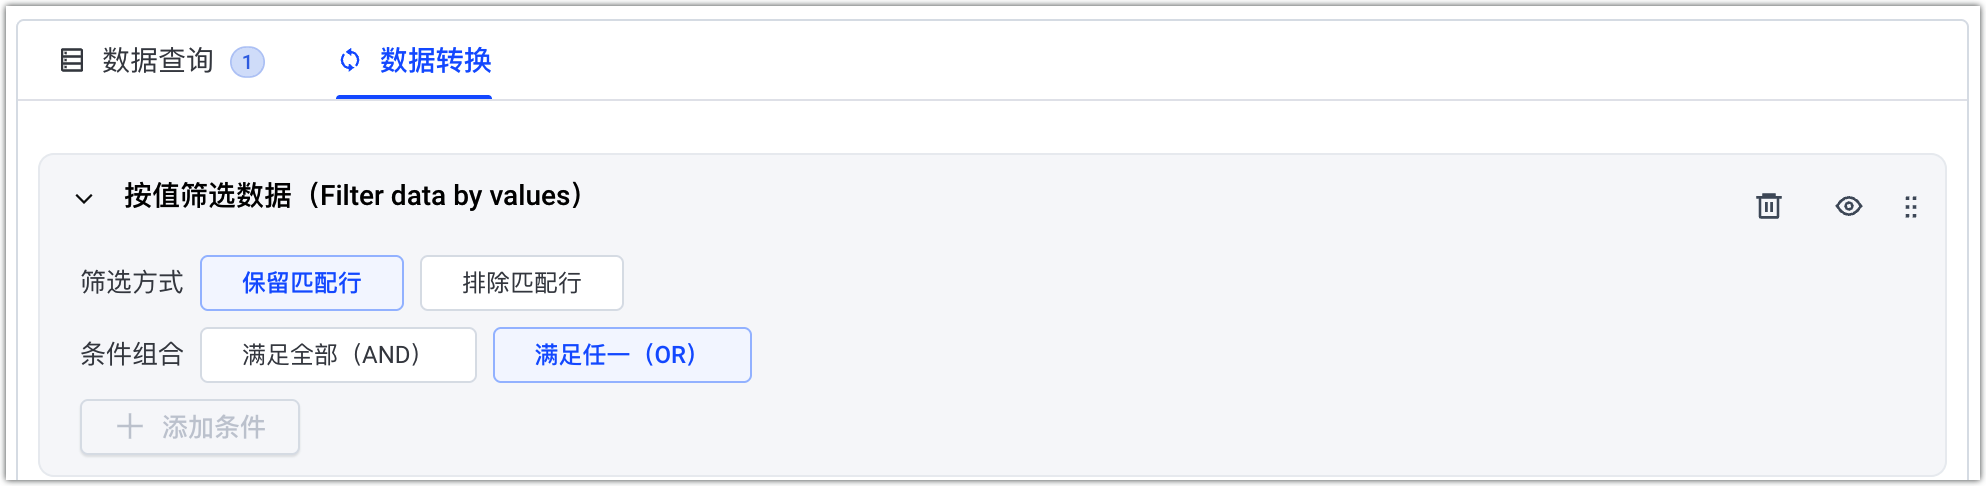
按值筛选数据(Filter data by values)
根据字段值筛选数据行,支持保留或排除符合条件的数据,适用于聚焦特定数据范围的可视化场景。单击 + 添加条件 新增筛选规则,多条规则之间的逻辑关系通过 条件组合 配置决定。
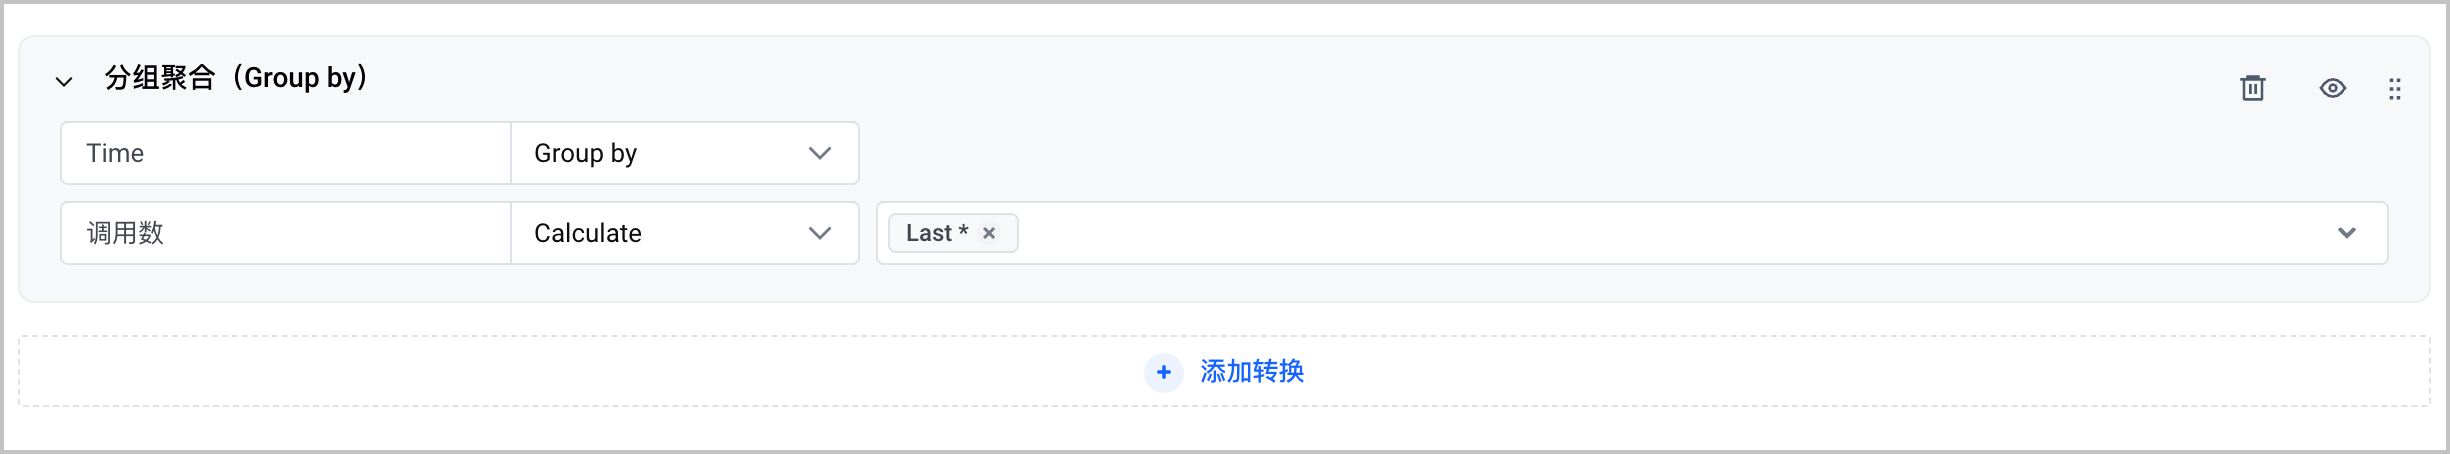
分组聚合(Group by)
按指定维度字段对数据分组,再对每组数据执行聚合计算(例如:求和、均值、分位数、最大最小等),最终将每组输出一行结果。常用于多维度指标拆分、时间粒度聚合、分层统计等场景。
分组转矩阵(Grouping to matrix)
通过 3 个指定维度,将一维扁平化的多行原始指标数据字段重组为二维矩阵透视表,实现双维度交叉对比可视化。
一个字段作为列维度,一个字段作为行维度,另一个字段作为单元格中的展示值。转换完成后,原本按行展开的数据会被转换为更适合横向对比和交叉分析的表格形式,适用于二维分类展示场景。
说明
仅存在单个 frame 时,分组转矩阵生效。
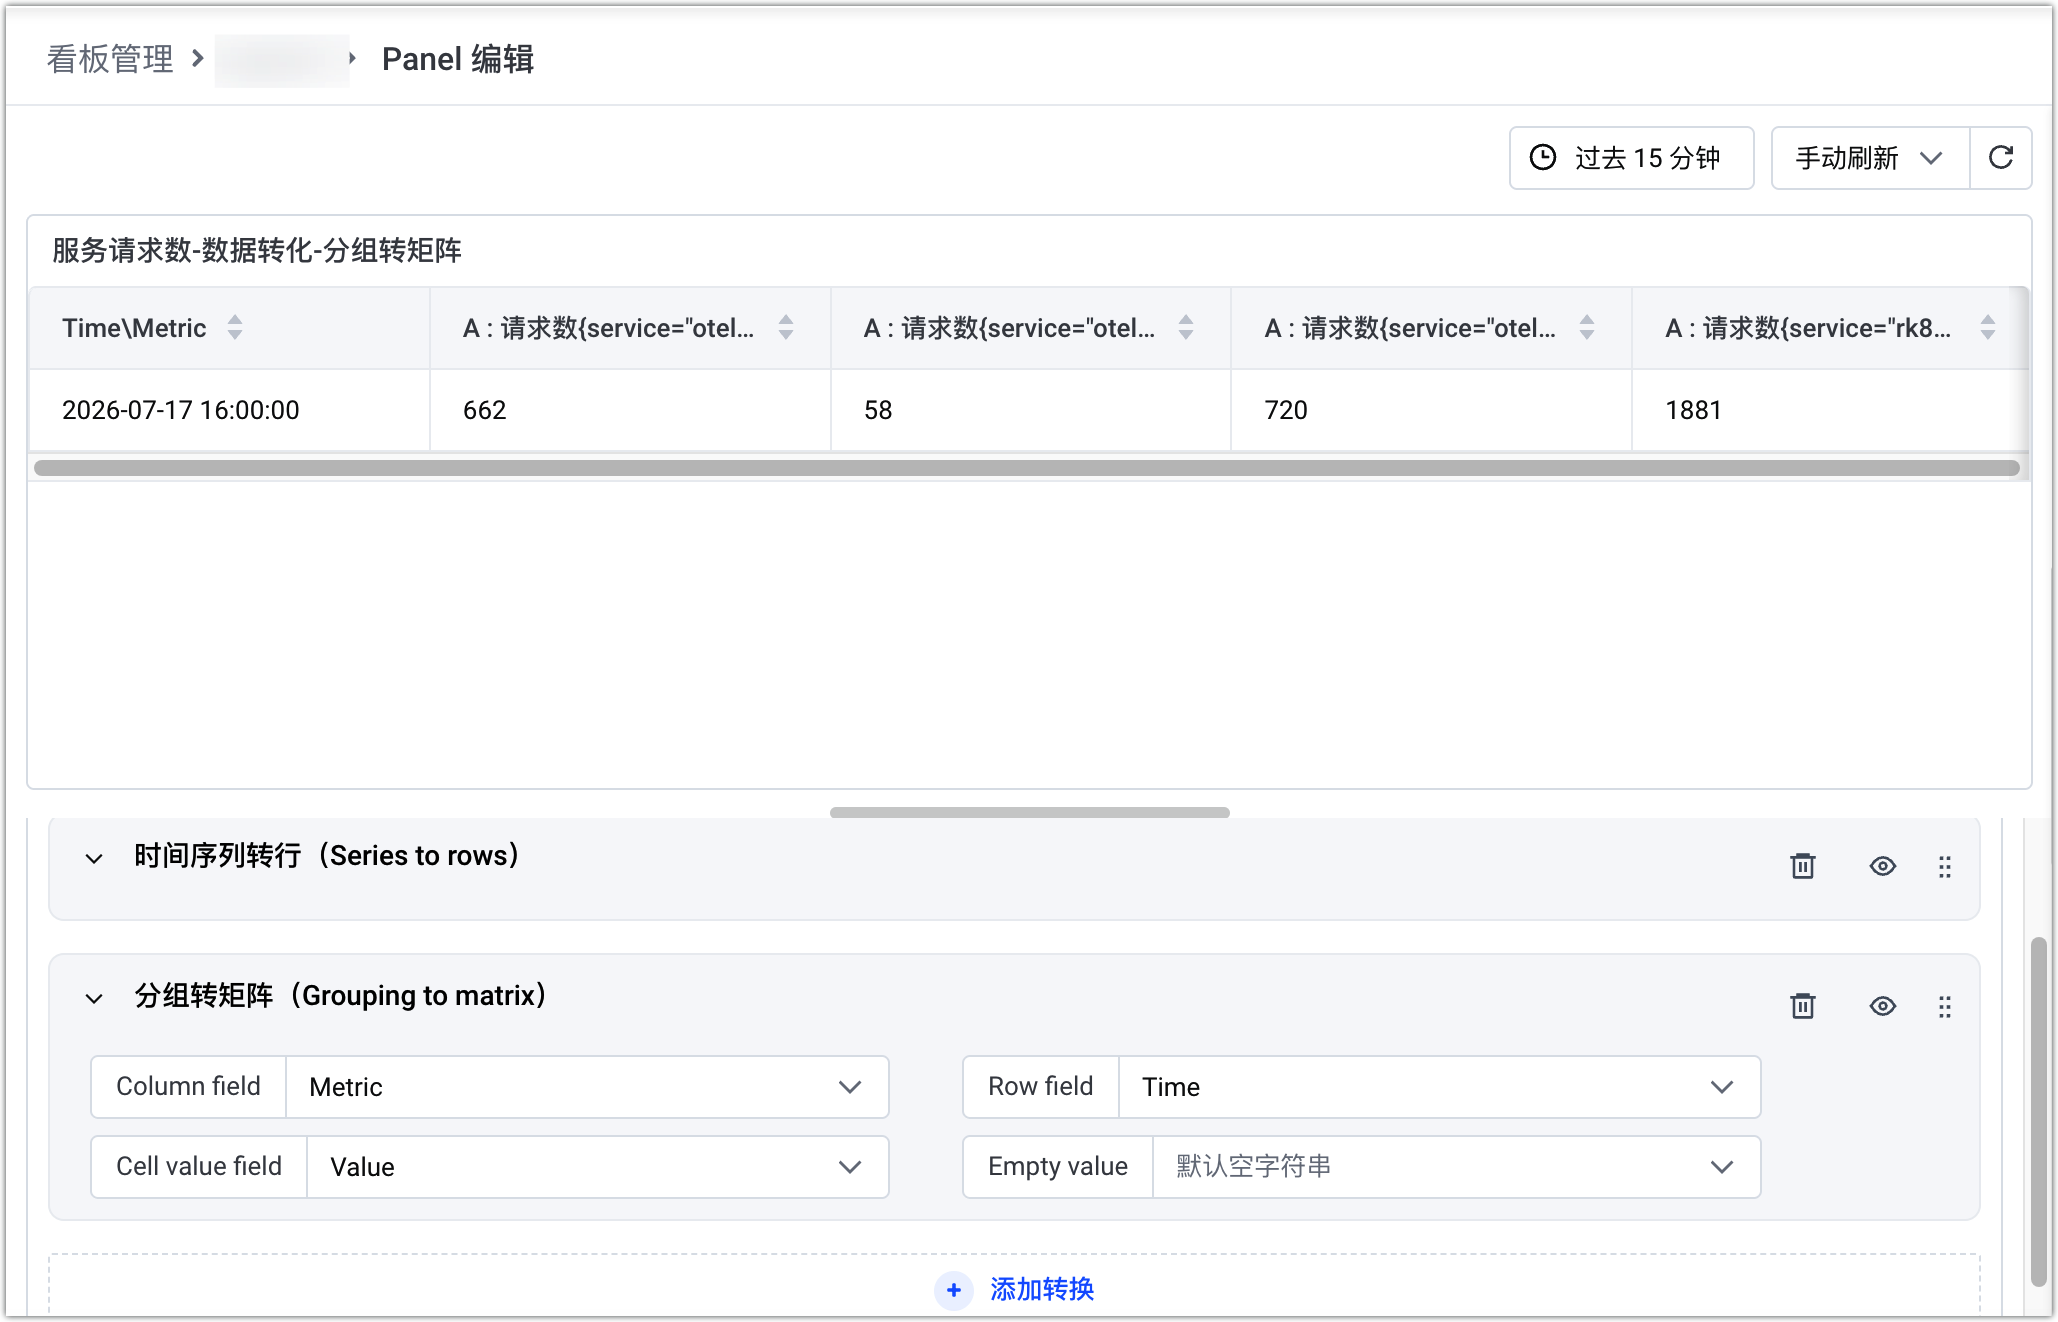
以下示例以“Pod 实例”为行维度,“协议类型”为列维度,“接收流量 KB/s”为单元格值,展示原始平铺数据经分组转矩阵转换后的数据。
原始平铺数据:
Pod 实例(行维度) | 协议类型(列维度) | 接收流量 KB/s(单元格值) |
o11y-agent-01 | grpc | 31.2 |
o11y-agent-01 | http | 0.3 |
o11y-agent-02 | grpc | 30.8 |
o11y-agent-02 | http | 0.1 |
分组转矩阵后的数据:
Pod 实例 \ 协议 | grpc | http |
o11y-agent-01 | 31.2 | 0.3 |
o11y-agent-02 | 30.8 | 0.1 |
字段重组(Organize fields)
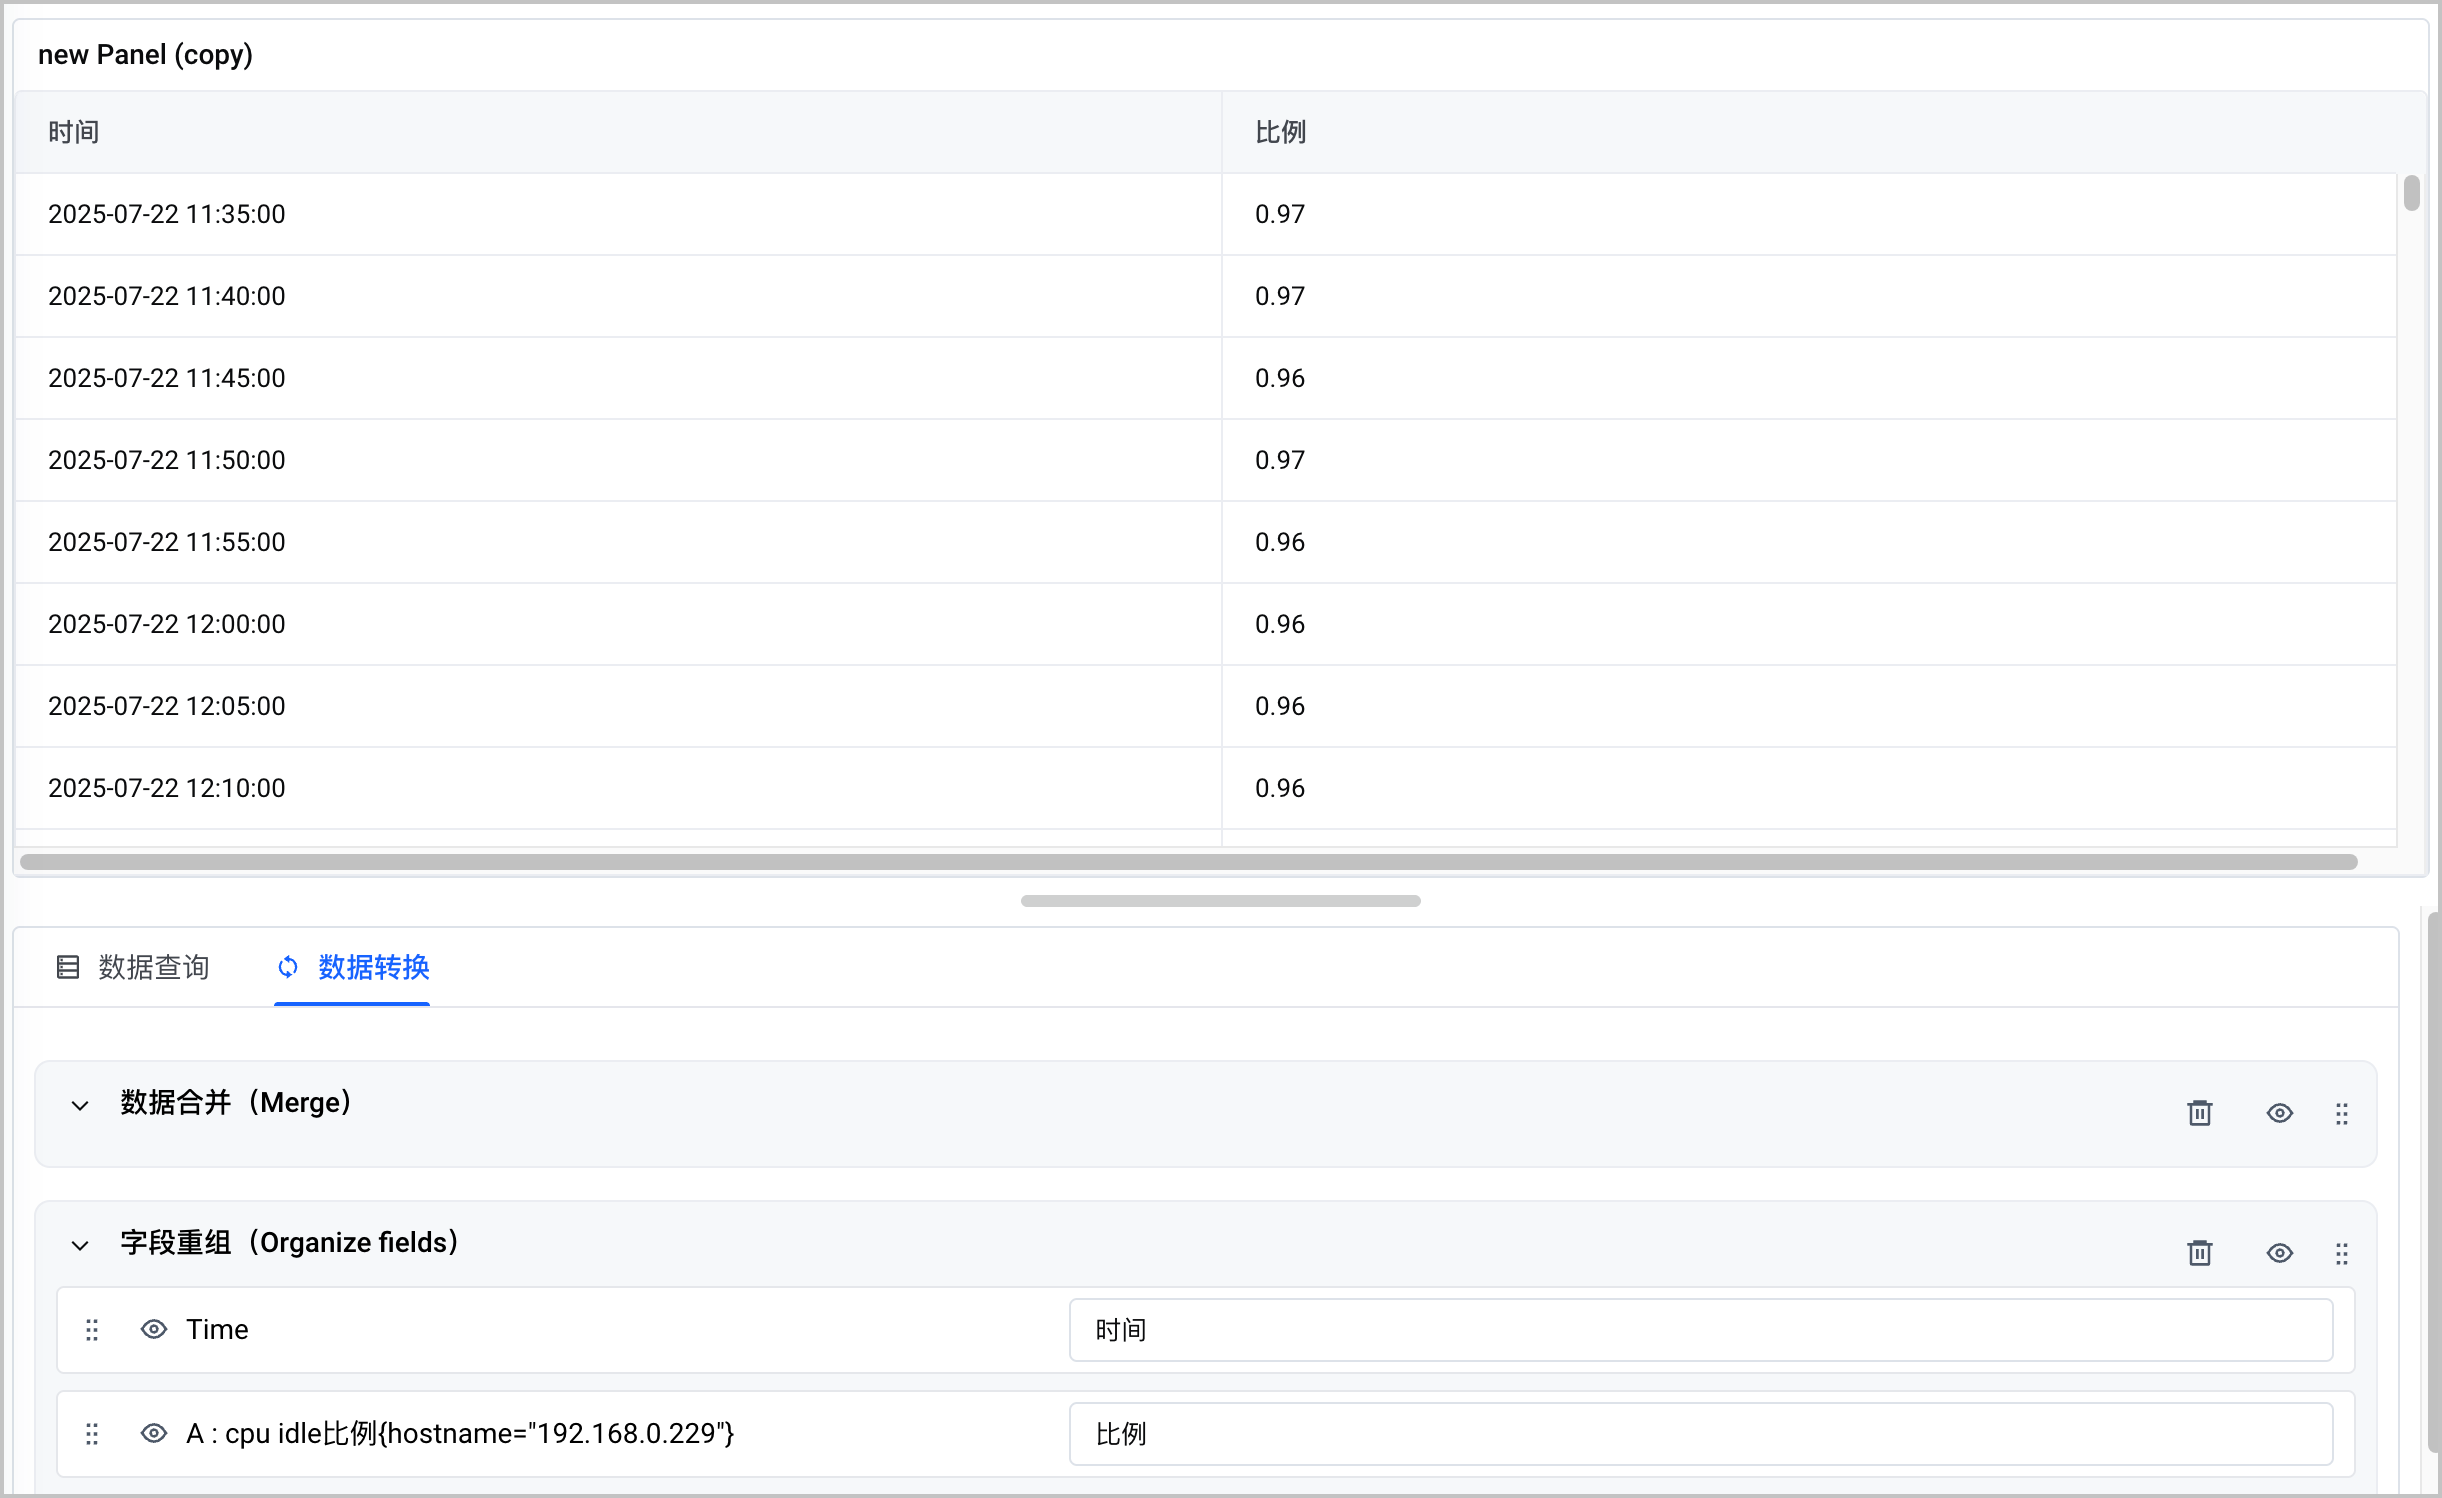
通过字段重组可对表格的列进行重命名、列排序和列隐藏。例如:将 Time 隐藏,将 cluster 重命名为集群,通过拖拽调整列排序。
说明
字段重组仅在单个 frame 时生效,可以考虑先进行数据合并。
时间序列转行(Series to rows)
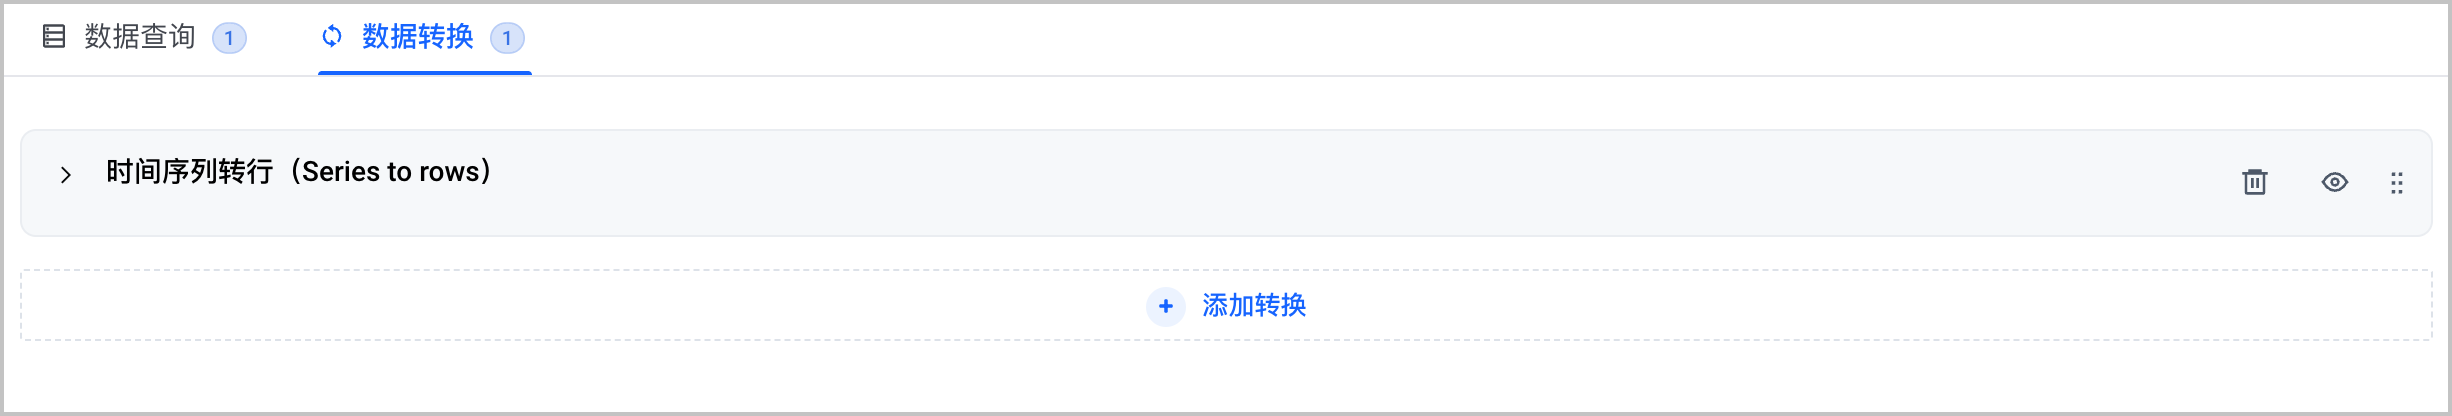
将多个序列合并为一个序列,并为每个值追加一列指标名称。常用于多指标统一可视化、统一多序列数据格式、多维度时序数据归一化等场景。
注意
仅存在单个 frame 时,数据转行无法生效。
限制行数(Limit)
用于限制展示的数据行数,适用于数据预览、分页查看或减少单次加载数据量等场景。设置后,系统将按指定行数返回结果。未设置行数限制时,默认展示 10 行数据。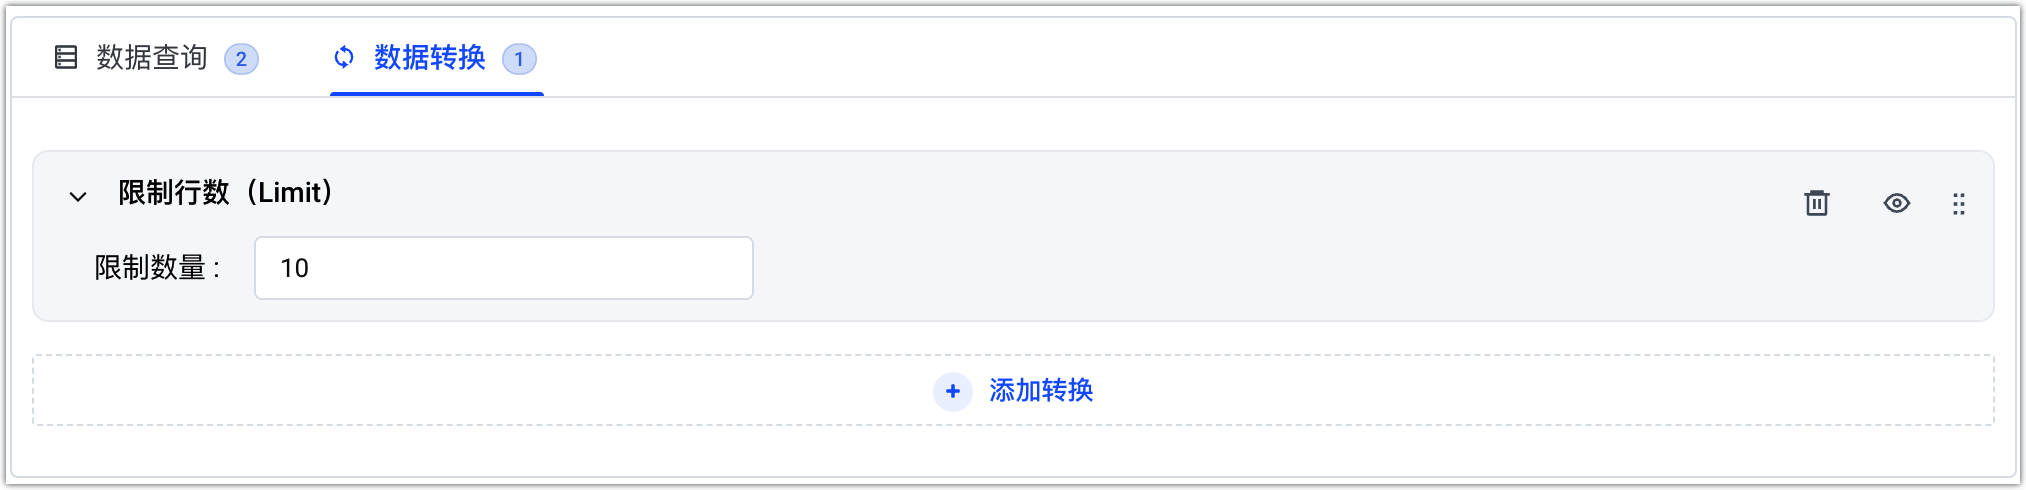
最近更新时间:2026.10.13 15:53:07
这个页面对您有帮助吗?
有用
有用
无用
无用