飞连
飞连


- 文档首页
 飞连管理员指南安全 Web 网关AI 安全防护AI 防护日志审计
 复制全文
 下载 pdf
 文档反馈
 问问助手
AI 访问安全的防护日志是 AI 防护策略执行后的结果记录。系统仅记录策略命中范围内的 AI 交互行为,并将其转化为可审计的日志数据。通过详尽的日志回放与深度溯源,管理员可以核实策略处置是否符合预期,并基于实际业务场景对防护规则进行持续调优。
操作入口
- 登录飞连管理后台。
- 在左侧导航栏,选择安全 Web 网关 > AI 访问安全 > 防护日志。系统将日志按资产类型进行分类展示,管理员可切换页签进行针对性审计。
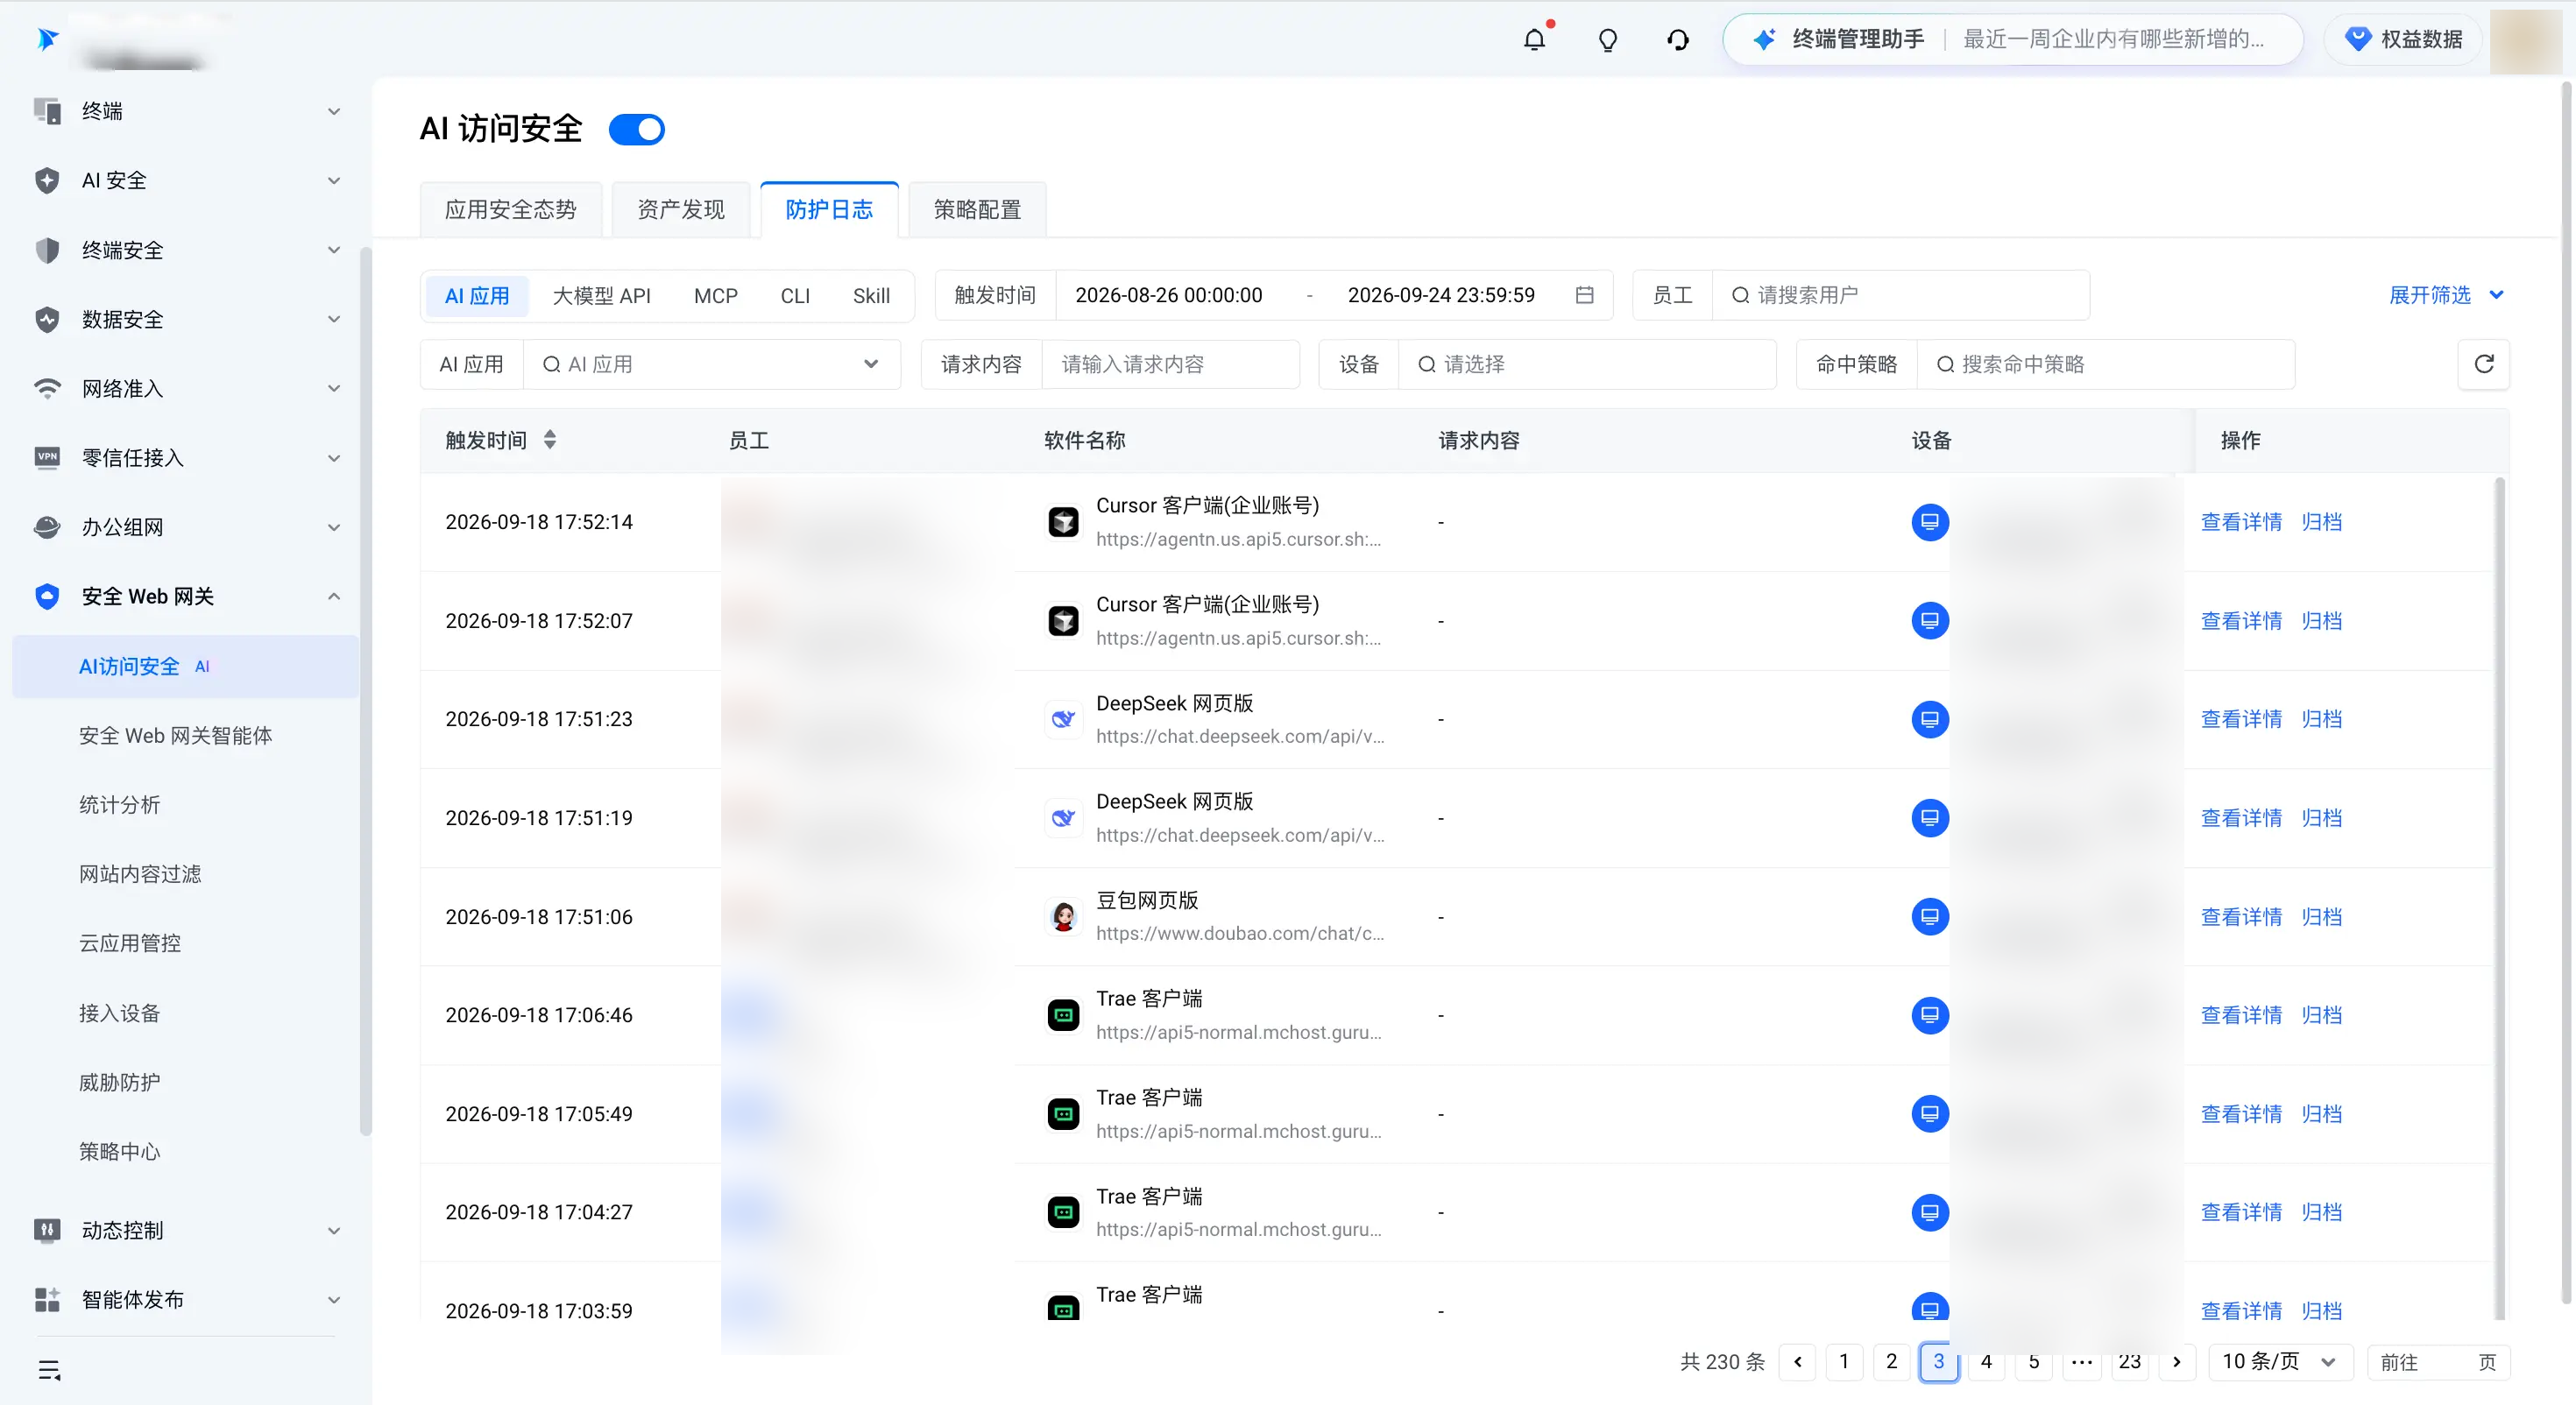
AI 应用/大模型 API 日志
分别侧重于网页端对话(如 ChatGPT、豆包)与程序化接口调用(如 OpenAI API、Anthropic)。通过详尽的交互记录,帮助管理员识别语义风险与影子 API 风险。
核心字段
除触发时间、员工、设备等基础字段外,可重点关注以下字段,以评估安全风险。
- 请求内容:用户发送给 AI 的原始 Prompt 明文内容或 API 调用中的 Payload 数据。仅在对应策略开启了 AI 会话内容审计开关时,系统才记录并展示具体文本内容。
- 命中策略:触发该条日志的具体防护规则名称。点击可快速跳转查询策略详细配置。
- 检测分类:由语义引擎识别出的具体风险类型(如角色扮演、目标劫持等)。
- 执行动作:展示该次行为是被“允许(观察)”还是被“拦截”。
- 模型提供商(大模型 API):展示被调用的模型提供商名称与 URL。管理员还可通过页面顶部的模型提供商以及模型提供商来源类型(官方、中转站、自建、未知)对日志进行精准过滤。
详情溯源
点击操作栏的查看详情可进入详情页进行深度取证,实现从“行为发现”到“内容判定”的审计闭环。
- 事件信息:集中展示触发 URL、模型提供商、模型名称、执行动作及检测分类。同时提供详细的日志记录(含客户端 IP、POST 路径等),点击查看详情可查阅原始报文,完成底层网络取证。
- 上下文溯源:基于安全审计记录还原的对话上下文。管理员可以回放完整的对话交互过程,辅助分析是否存在基于长上下文记忆的越狱或提权攻击。该功能仅在对应策略开启了 AI 会话内容审计开关时生效。
- 主体画像:关联展示发起请求的员工基本信息(姓名、部门、账号状态)与终端设备信息(OS、IP、设备 ID),确保风险可精准定位至具体的人员和设备。
日志归档
针对已完成审计或无需再关注的记录,可点击日志列表页操作栏的归档。归档后的日志将不再在列表和详情中展示,该操作会记录管理员审计日志,确保操作合规。
MCP 日志
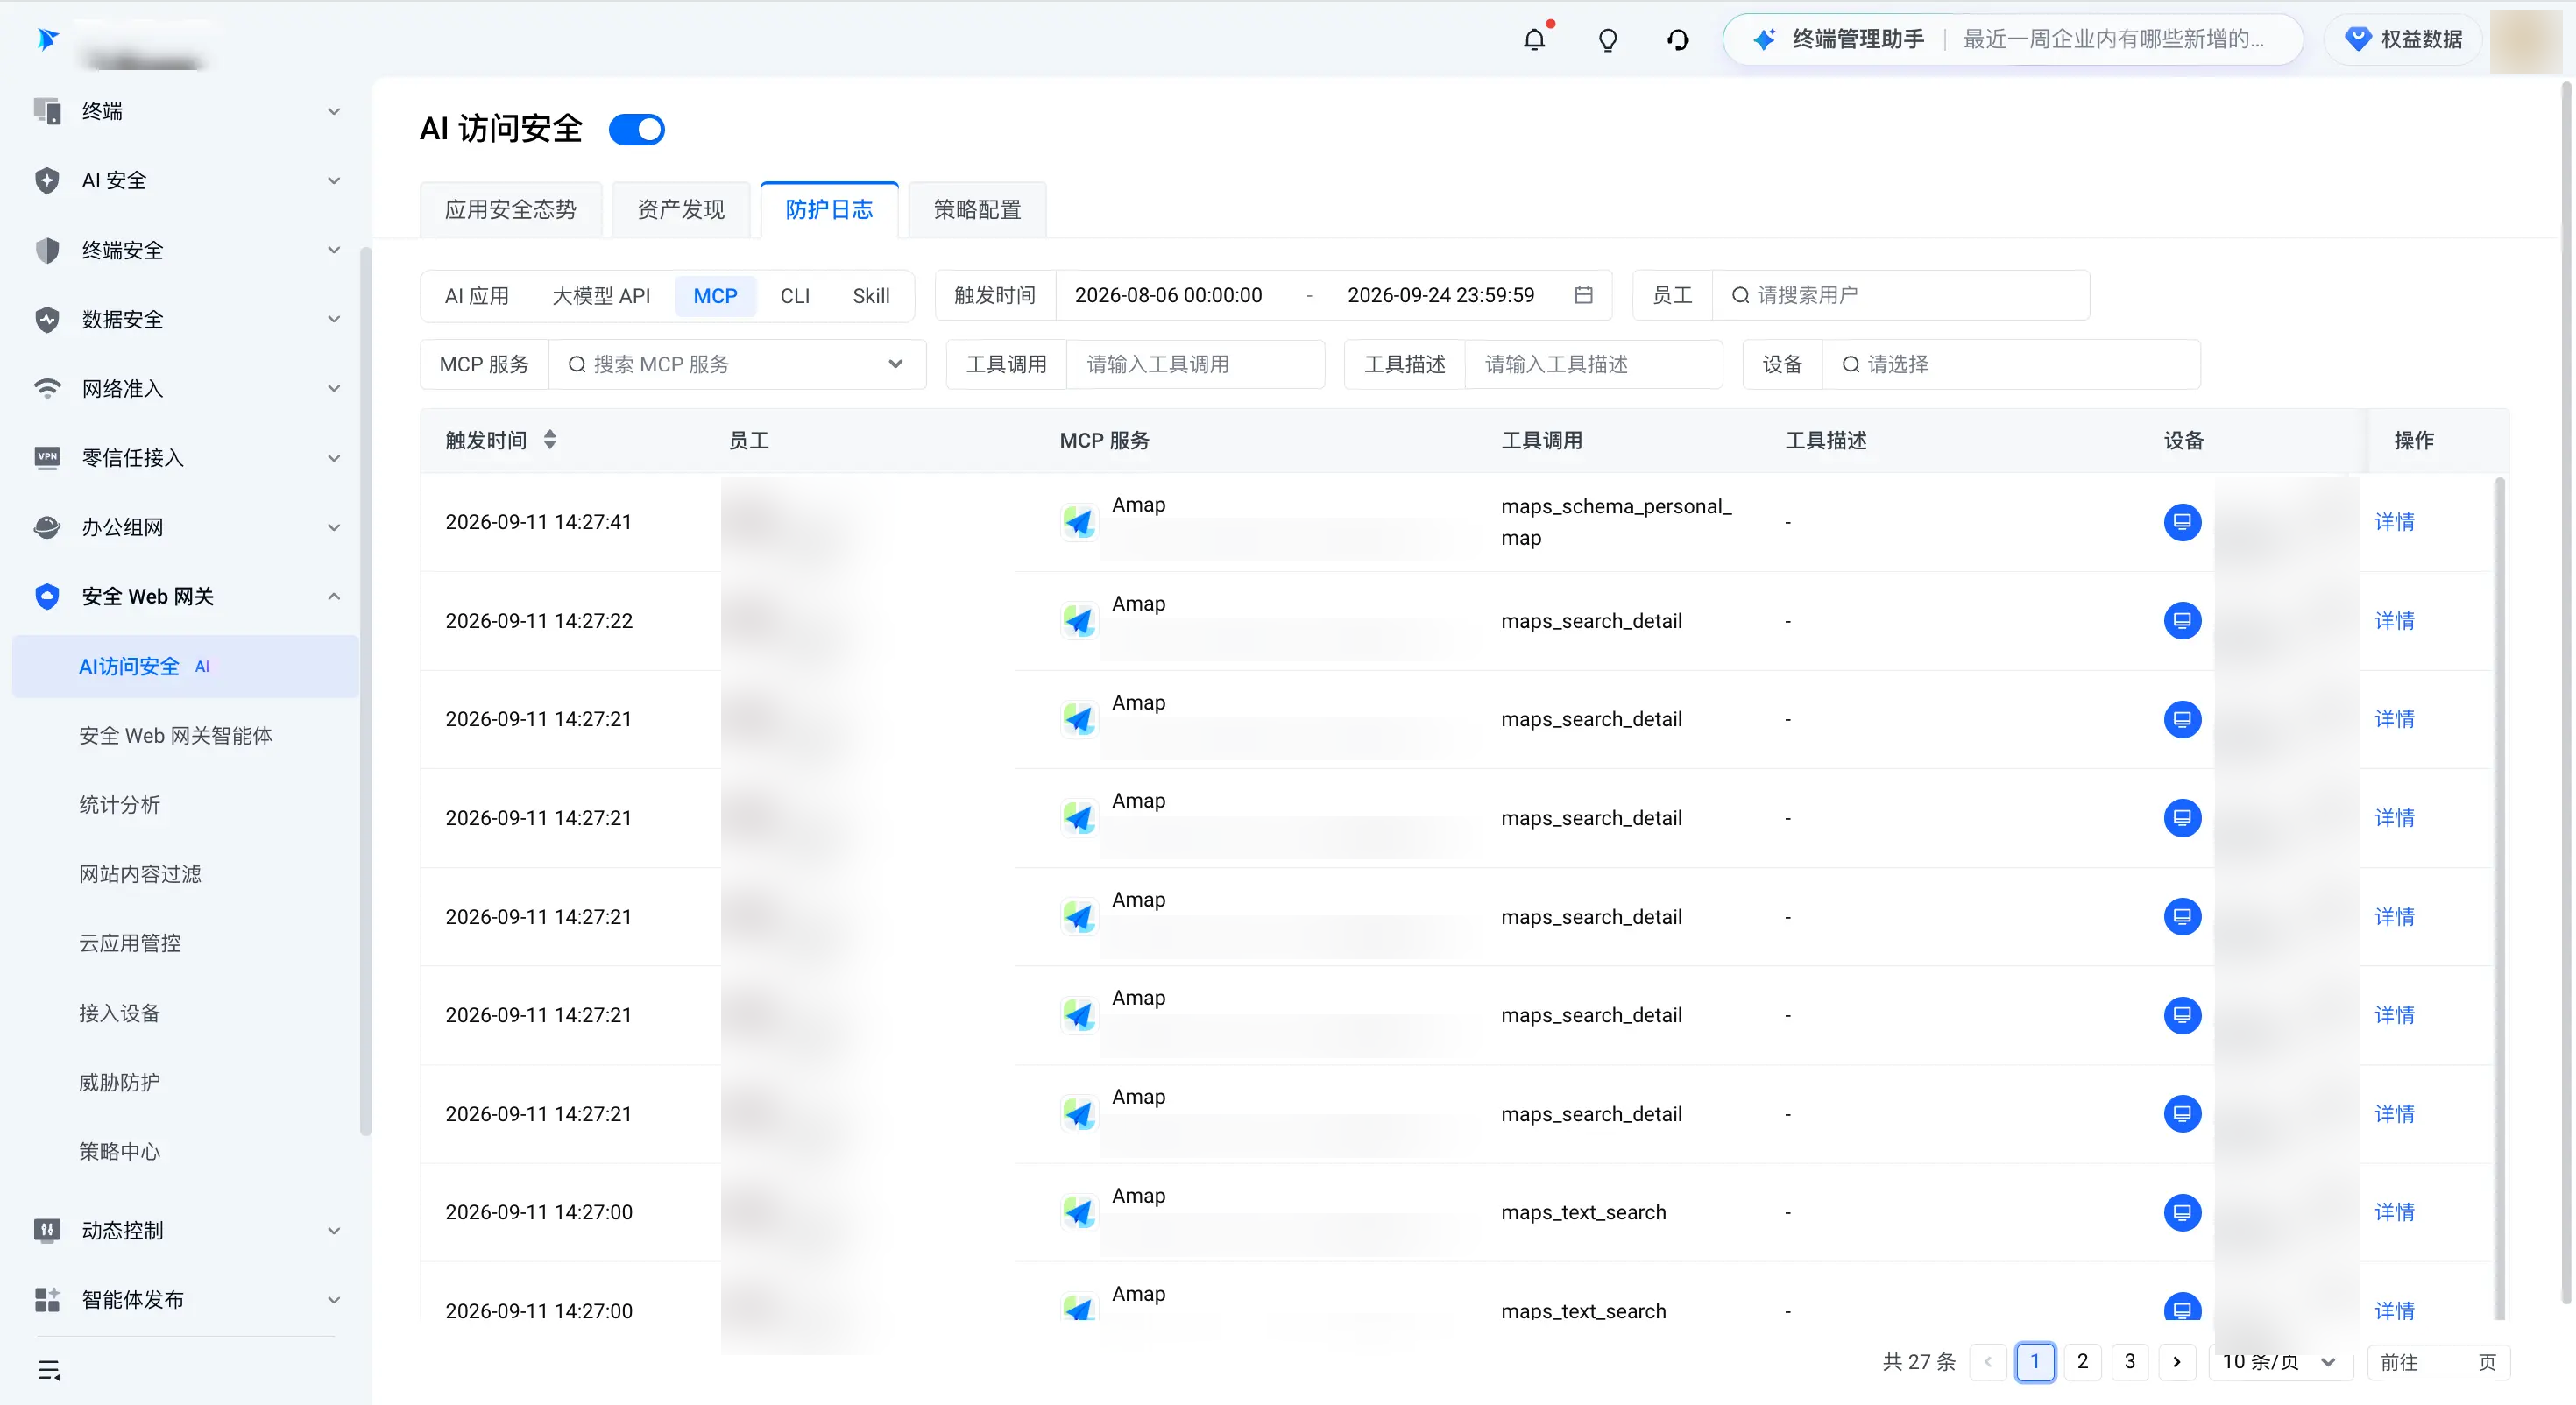
针对模型上下文协议(Model Context Protocol)服务的专项审计。通过记录 AI 应用与外部 Server 间的工具调用明细,系统帮助管理员将 MCP 这一隐蔽的第三方插件调用行为纳入合规视野,突破 Agent 自动化执行过程中的审计盲区。
核心字段
除触发时间、员工、设备等基础字段外,可重点关注以下字段,以量化评估安全风险。
- MCP 服务:被识别到的外部 MCP Server(如 Amap、Lark Docs 等)。将鼠标悬浮于名称上可查看其通信 URL。通过该字段,管理员可盘点企业内活跃的第三方工具接入点,识别潜在的供应链风险。
- 工具调用:本次交互调用的具体原子工具(Tool)名称(如
fetch-doc)。 - 工具描述:系统解析出的该工具功能定义,辅助管理员快速理解业务动作意图。
详情溯源
点击操作栏的详情,可进入事件详情页进行深度取证,实现从“行为发现”到“内容判定”的审计闭环。
- 事件信息:展示触发 URL、员工主体画像、终端设备信息以及详细日志记录入口。点击查看详情可查阅原始请求报文,完成底层网络取证。
- 工具调用信息:展示本次调用的请求参数(JSON)。通过查看明文参数,管理员可以精准判定交互内容的合规性。
CLI 日志
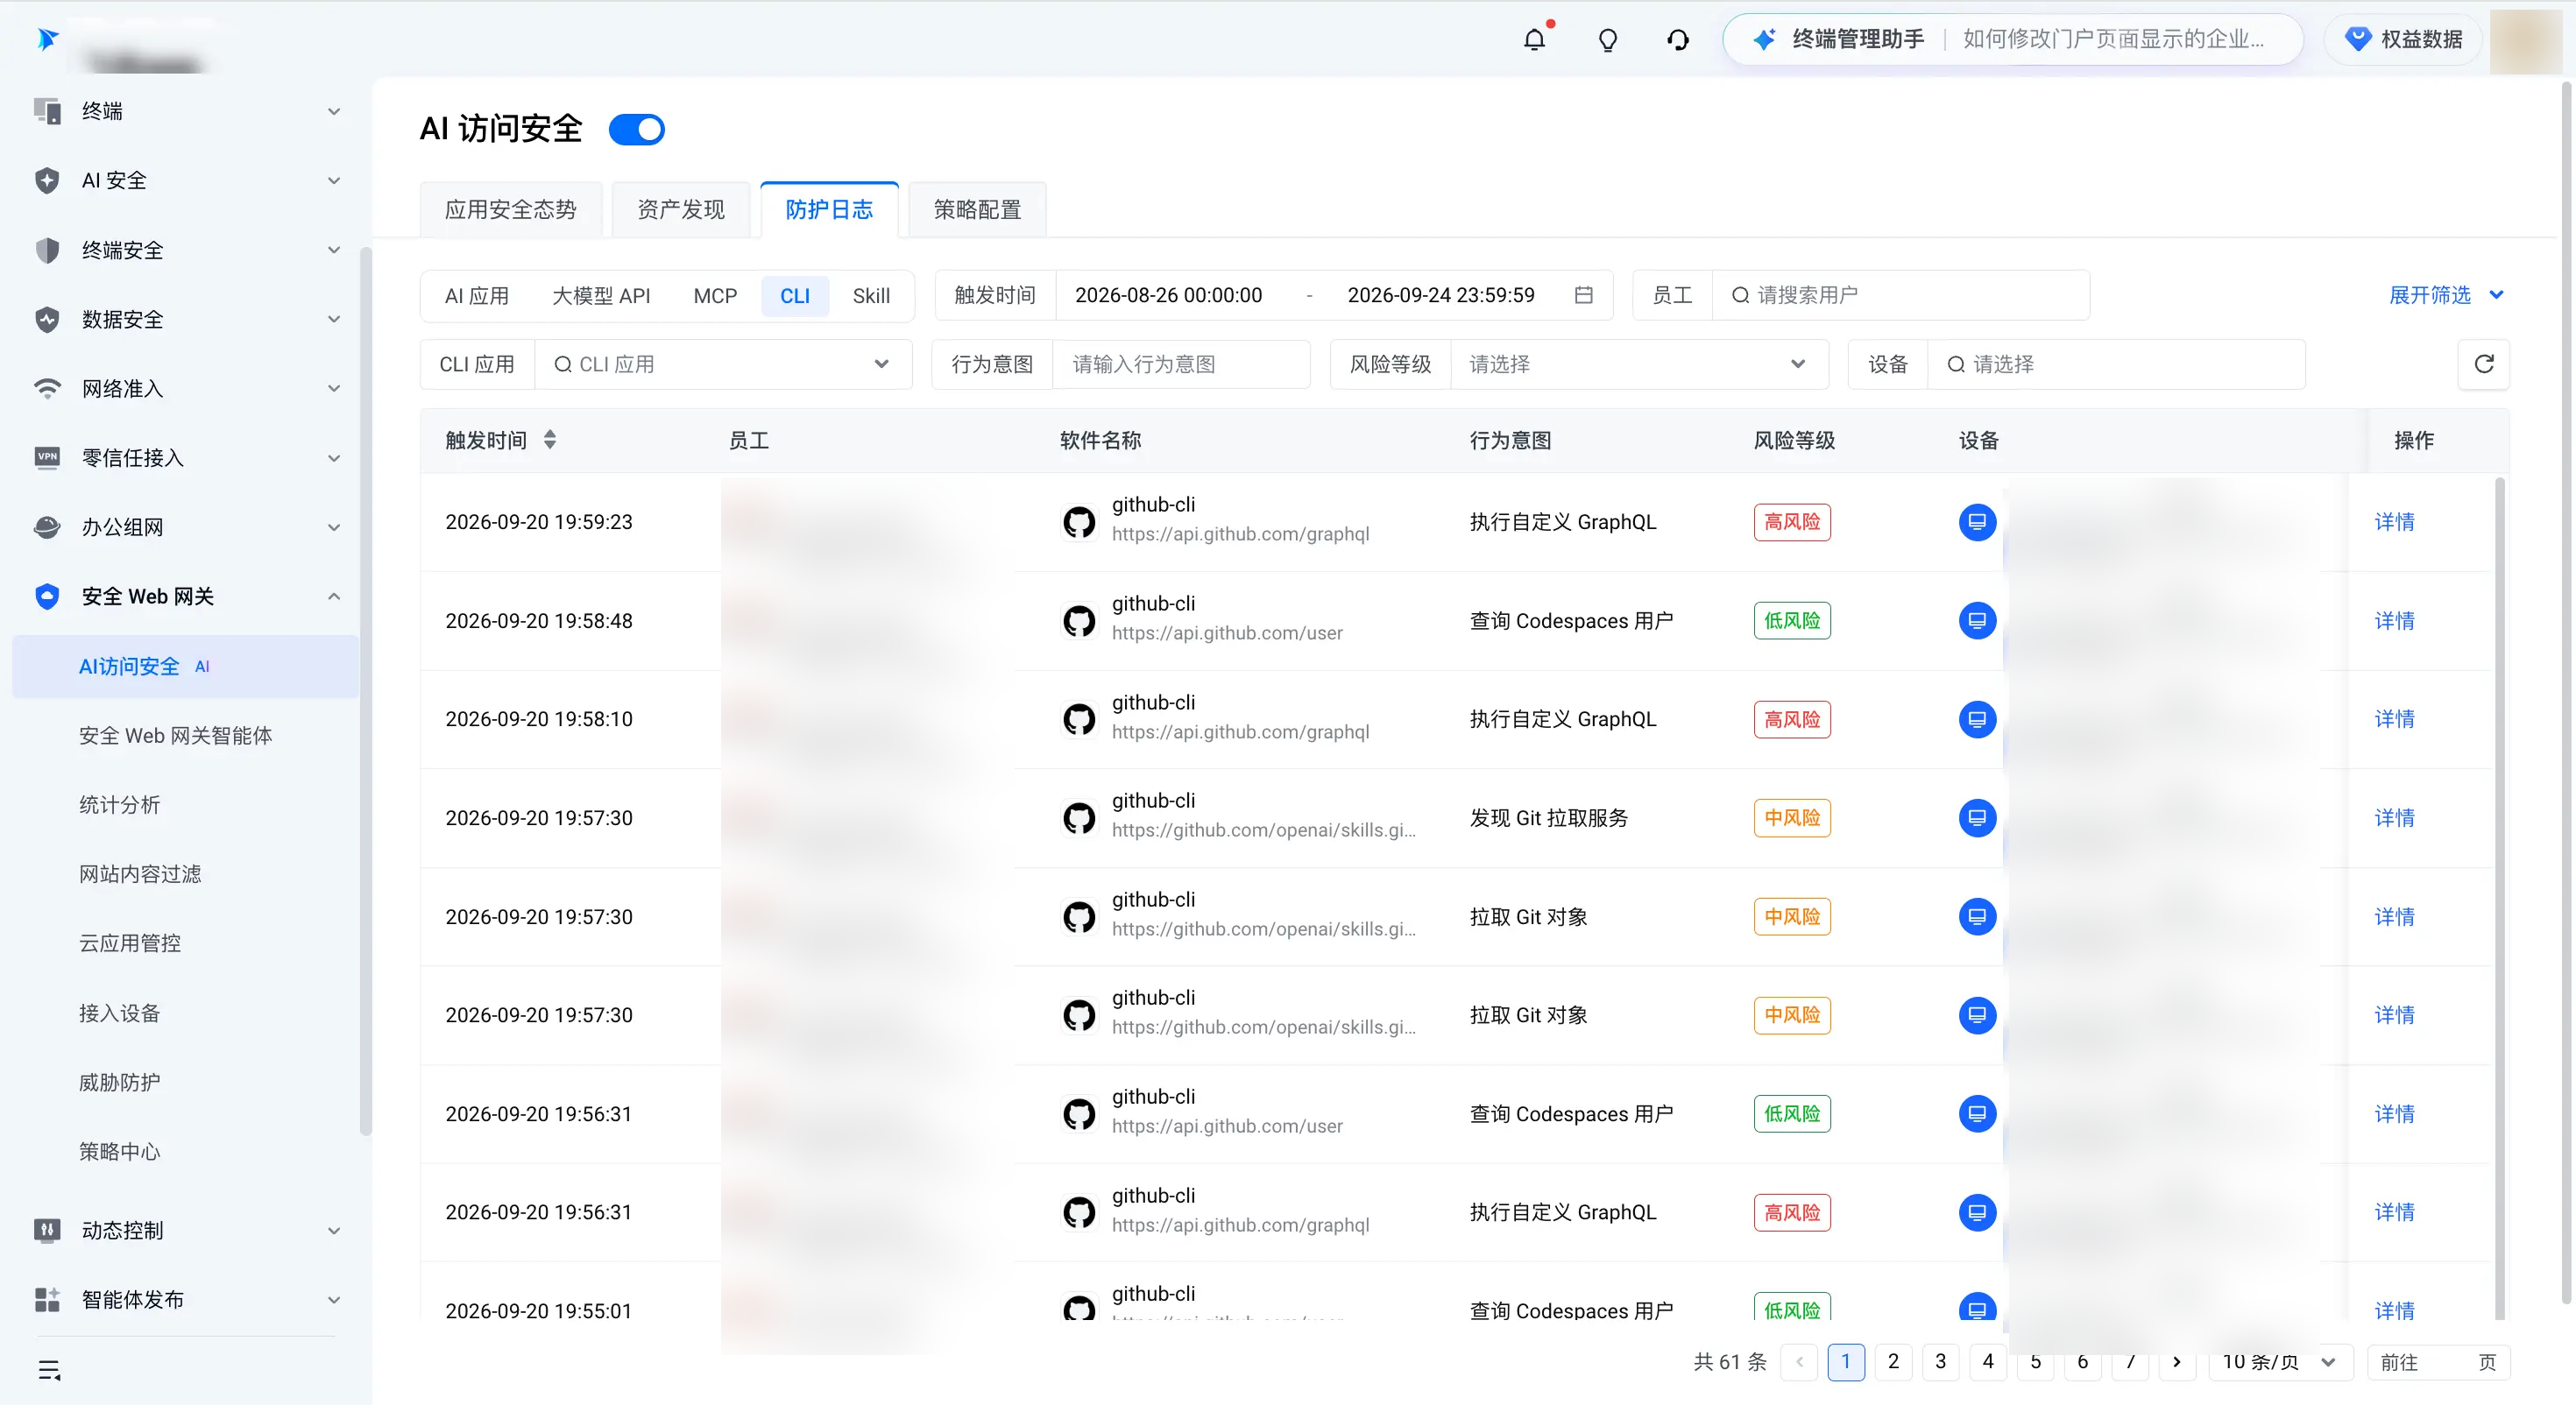
针对开发者命令行工具(如 github-cli、lark-cli 等)的专项审计。系统提供了精细化的 API 使用明细,实现了从“工具可见”到“行为可见”,管理员不仅能看到是哪个 CLI 工具在运行,还能直观了解其具体的业务动作,突破了命令行工具调用的“黑盒”审计盲区。
核心字段
除触发时间、员工、设备、执行动作等基础字段外,可重点关注以下核心字段,以量化评估安全风险。
- 应用名称、行为意图:识别出的具体 CLI 工具。将鼠标悬浮于名称上可即时查看请求的完整 URL。
- 行为意图:系统自动研判的调用目的(如:调用自定义 API、执行 Git 拉取等),辅助管理员理解开发者的具体业务动作,识别潜在的违规逻辑。
- 风险等级:系统基于行为特征自动定级(高/中/低),作为排查优先级的重要依据。若系统预设的等级不符合企业实际业务场景,管理员可前往资产发现 > CLI 页面,在对应工具的详情页中手动调整该行为的敏感等级。
- 命中策略:该次行为匹配到的具体防护规则。单击策略名称可直接跳转至策略配置页,方便管理员核实规则细节或快速调优。
详情溯源
针对任一高风险或可疑记录,可点击操作栏的详情,查看事件细节。
- 触发事件信息:集中呈现触发 URL、命中策略、意图识别及风险分级等判定依据,明确“为什么被拦截/观察”。
- 详细日志记录:展示客户端 IP、完整 URL、User-Agent 等网络层参数。点击查看详情可查看原始报文,管理员可调阅最底层的请求/响应数据,完成深度取证或复杂网络排查。
- 主体画像:关联展示发起请求的员工基本信息(姓名、部门、账号状态)与终端设备信息(OS、IP、设备 ID),确保风险可精准定位至具体的人员和设备。
Skill 日志
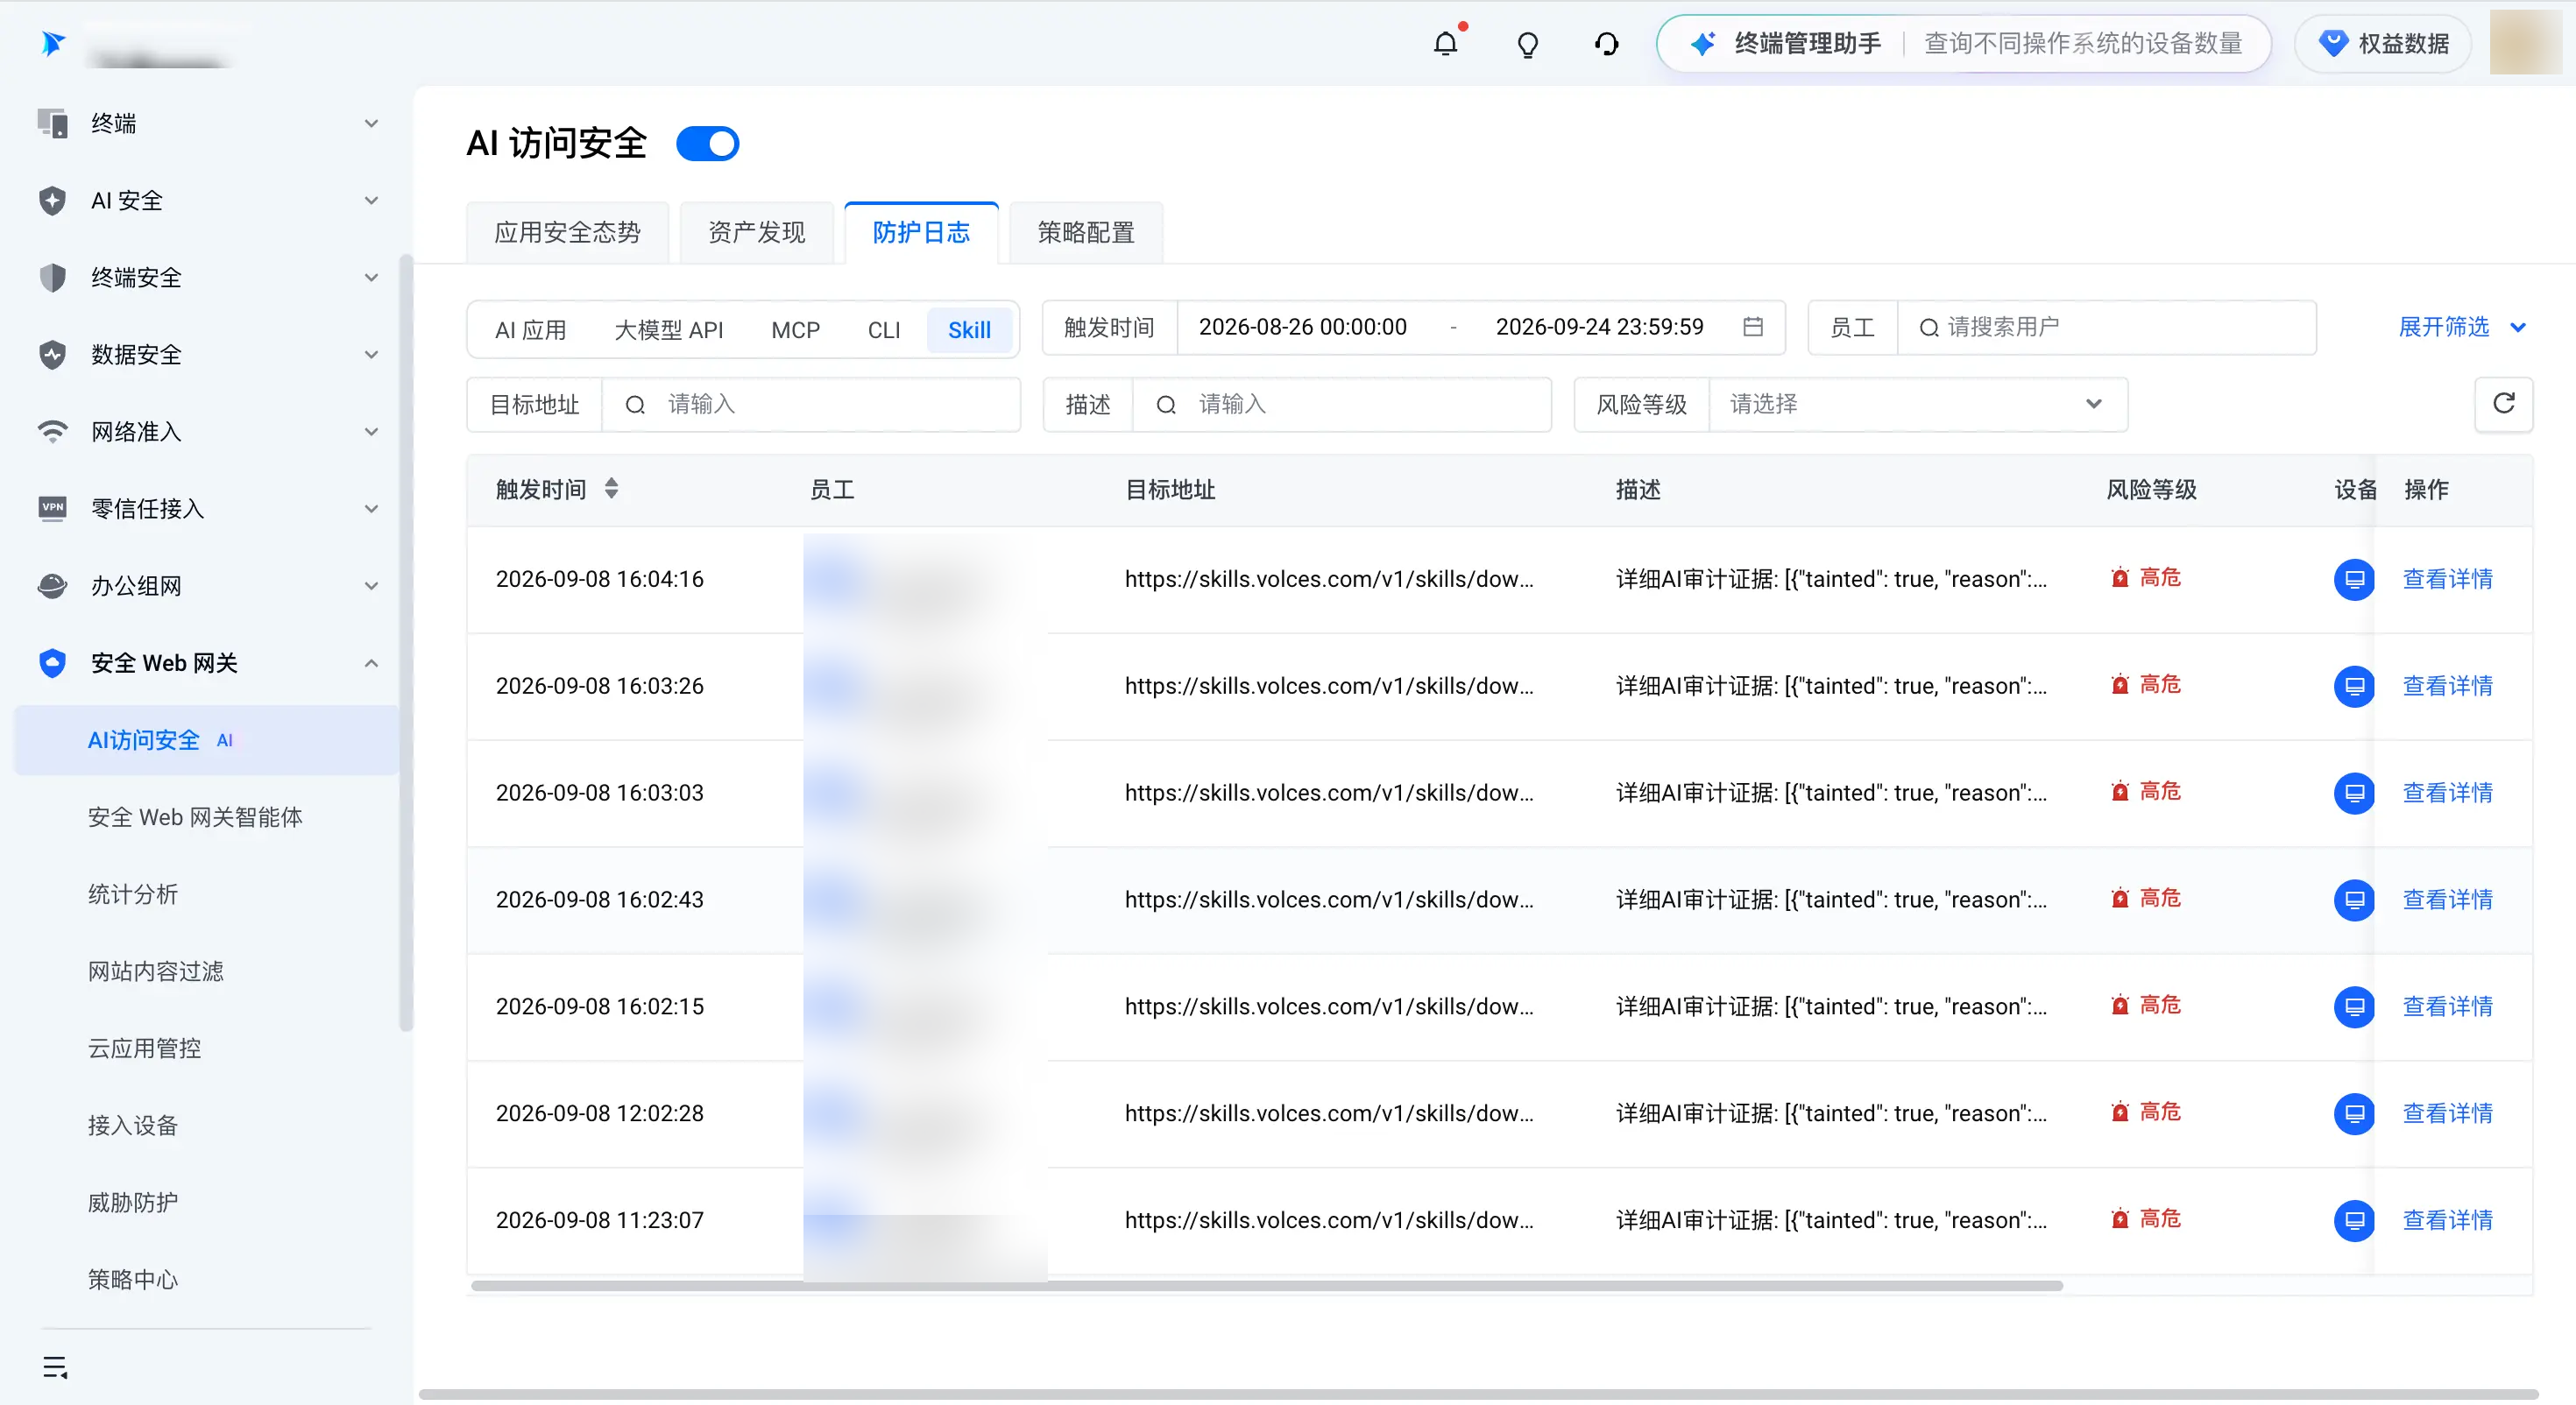
针对智能体技能(Skill)下载链路的专项审计记录。通过识别下载源的风险特征,帮助管理员精准定位高风险下载行为,防范 AI 供应链投毒风险。
核心字段
除触发时间、员工、设备等基础字段外,管理员可重点关注以下字段以量化评估安全风险。
- 目标地址:发起 Skill 下载请求的完整 URL。管理员可据此盘点企业内活跃的第三方 Skill 市场或非常规下载渠道,识别“影子 Skill”资产。
- 描述:由威胁情报引擎提供的判定依据。高风险记录通常会展示具体的威胁背景(如:ClawHub 第三方市场、Typosquatting 仿冒包等),帮助管理员理解风险的物理含义。
- 风险等级:系统基于情报库自动判定的等级(高危/中危/低危),可作为排查优先级的关键参考信息。
- 执行动作:直观展示该次风险行为是被“拦截”还是被“允许”,用于评估现有防护策略的有效性。
详情溯源
针对任一高风险或可疑记录,管理员可点击操作栏的查看详情进入详情页。该页面通过聚合多维数据,为管理员提供完整的“风险画像”与“证据链”,实现从发现风险到精准定位的审计闭环。
- 触发事件信息:集中展示事件 ID、目标地址、执行动作及风险分级,明确“为什么被拦截/允许”。
- 详细日志记录:展示原始的网络请求明细,包含客户端 IP、请求方法、完整路径等。管理员可据此进行底层的网络取证,核实下载行为的物理真实性。
- 主体画像:关联展示发起请求的员工身份信息(姓名、部门、账号状态等)与终端设备信息(OS、公网 IP、设备 ID 等),确保风险可精准追踪至具体的人员和资产。